2.0 对 mapping 做了一批"消除歧义"的收紧:同一索引内不同 type 的同名字段必须有相同映射,冲突的映射会让 Elasticsearch 无法启动;字段不能再按短名引用;类型名前缀不再用来区分字段;字段名不允许包含点号;类型名不能以点号开头、不能超过 255 字符。另外动态新增字段必须先由 master 确认映射后才能继续写入。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
为什么要收紧
2.0 迁移文档开篇就说明了动机(migrate_2_0/mapping.asciidoc @ v2.4.6):
A number of changes have been made to mappings to remove ambiguity and to ensure that conflicting mappings cannot be created.
核心的一句是:动态新增的字段,其映射必须先被 master 节点确认,索引才能继续:
One major change is that dynamically added fields must have their mapping confirmed by the master node before indexing continues. This is to avoid a problem where different shards in the same index dynamically add different mappings for the same field. These conflicting mappings can silently return incorrect results and can lead to index corruption.
问题场景是:同一个索引的不同分片各自动态添加字段,结果给同一个字段推导出不同的映射。这种冲突会静默返回错误结果,甚至导致索引损坏。2.0 用"master 确认"避免这种冲突,代价是频繁新增字段时写入变慢。文档明确说这是安全优先于性能的取舍:
This change can make indexing slower when frequently adding many new fields. We are looking at ways of optimising this process but we chose safety over performance for this extreme use case.
冲突映射:不启动
同一索引里、不同 type 下的同名字段,映射必须一致。唯一例外是 copy_to、dynamic、enabled、ignore_above、include_in_all、properties 这几个参数,它们允许按字段各自设置。
下面这种 mapping 会让 Elasticsearch 起不来:
PUT my_index
{

  "mappings": {

    "type_one": {

      "properties": {

        "name": {
    "type": "string" }
      }
    },
    "type_two": {

      "properties": {

        "name": {
    "type": "string", "analyzer": "english" }
      }
    }
  }
}
两个 name 一个没分析器、一个用 english,属于冲突。官方的处理方式是:
Elasticsearch will not start in the presence of conflicting field mappings. These indices must be deleted or reindexed using a new mapping.
同时 put mapping API 的 ignore_conflicts 选项被移除——冲突不能忽略了,只能重建索引。
这条是 1.x 升 2.x 时"升完起不来"的风险点:升级前要检查 mapping,把冲突字段统一(通常是重命名其中一个,或者统一分析器)。
字段不能再用短名引用
1.x 里字段可以按短名引用,2.0 起必须用完整路径:
PUT my_index
{

  "mappings": {

    "my_type": {

      "properties": {

        "title": {
    "type": "string" },
        "name": {

          "properties": {

            "title": {
    "type": "string" },
            "first":  {
    "type": "string" },
            "last":   {
    "type": "string" }
          }
        }
      }
    }
  }
}
上面的两个 title 分别叫 title 和 name.title。1.x 里用短名 title 引用会歧义——到底指哪个?2.0 要求写全路径。
类型名前缀不再用于区分字段
1.x 里还有一种消歧方式:在字段名前加类型名。2.0 去掉了它,理由是它本身有歧义(类型名可能和字段名混淆),而且不是所有地方都支持(比如聚合就不支持)。
1.x 的写法:
GET my_index/_search
{

  "query": {

    "match": {
    "my_type.some_field": "quick brown fox" }
  }
}
2.0 改成类型放在 URL 里、字段名不带前缀:
GET my_index/my_type/_search
{

  "query": {

    "match": {
    "some_field": "quick brown fox" }
  }
}
如果确实要按 _type 过滤,除了 URL 里指定,也可以显式加一个 filter。
字段名不能含点号
1.x 允许创建名字里带点的字段,于是 foo.bar 这个引用既可能指向"名叫 foo.bar 的字段",也可能指向"foo 对象下的 bar 字段",两者无法区分。2.0 直接禁止创建带点号的字段名。
配套的一条放宽:类型名现在可以包含点号,但不能以点号开头(唯一例外是特殊的 .percolator 类型)。因为类型名已经不再用于区分字段,1.x 那条"类型名含点号就告警"的限制就没必要了。
点号字段名要改成 object 嵌套:
{
    "foo": {
    "properties": {
    "bar": {
    "type": "text" } } } }
文档里如果真有 "foo.bar" 这种 key,动态映射会碰上这条限制,建议在写入端就把点号 key 转成嵌套对象。
类型名长度与类型删除
- 类型名不得超过 255 字符。升级前创建的索引里如果有超长类型名,仍能继续使用,但新索引里不能再创建。
- 2.0 起类型(type)不再能单独删除。要删只能删整个索引,或者把数据 reindex 到新索引。
升级 2.0 前的 mapping 自查
- 拉全量 mapping,逐个索引检查同名字段在不同 type 下的定义是否一致(重点看
type、analyzer、index、format等); - 查询模板里搜有没有
类型名.字段名的前缀写法,改成 URL 指定类型 + 裸字段名; - 搜有没有带点号的字段名,改成 object 嵌套(
foo: { properties: { bar: ... } }); - 检查类型名是否以点号开头、是否超过 255 字符;
- 如果业务频繁动态新增字段,评估 master 确认带来的写入延迟,必要时提前在 mapping 里预定义字段。
这批收紧里需要留意的是 master 确认
五条收紧里,四条是建索引或建 mapping 时报错,第一次执行就会发现,好排查。需要留意的是第五条:动态新增字段要先经 master 确认。
它不改变任何写法,只让写入变慢,而且文档限定的场景是频繁新增大量字段。日志是典型:新字段不断出现,每个新字段都要走一次 master 确认。它不报错,只表现为写入变慢,排查时容易先怀疑磁盘、分片、GC。
日志类索引在 2.0 之后建议预定义 mapping,不要靠动态映射;或者在写入端做字段收敛,把未知字段统一写进同一个 object 或字符串字段。文档说"safety over performance",方向没错,但代价落在写入侧,要自己接住。
这批收紧整体上是对的。"同名字段在不同 type 下映射不一致"这种问题,静默返回错误结果比直接不让启动危险得多:前者你不知道自己错了,后者你立刻知道。2.0 选择让集群起不来,是把隐性隐患换成显性故障,赞成这个取舍。
自查命令
curl -s 'localhost:9200/_all/_mapping' > /tmp/mappings.json
python3 - <<'EOF'
import json, collections
m = json.load(open('/tmp/mappings.json'))
for idx, body in m.items():
    seen = collections.defaultdict(set)
    for tname, tdef in (body.get('mappings') or {}).items():
        def walk(props, prefix=''):
            for f, d in (props or {}).items():
                path = prefix + f
                seen[path].add(str(d.get('type')) or ('object' if 'properties' in d else ''))
                walk(d.get('properties'), path + '.')
        walk(tdef.get('properties'))
    for path, types in seen.items():
        if len(types) > 1:
            print(idx, path, types)
EOF
这段脚本把"同名但类型不一致"的字段列出来,逐个改一致再升级,比人肉看 mapping 快也准。
迁移文档里还有几项会让旧 mapping 或旧查询行为变化
前面几节只覆盖了文档开头那一批。同一份迁移文档(mapping.asciidoc)后半部分还有几项,和 mapping 的写法、查询结果直接相关。
日期格式。 此前 date 字段会先尝试把值当 Unix 毫秒时间戳解析,再用定义的 format,所以 yyyyMMdd 这类格式永远不会生效,因为值会被当成时间戳,见第 287–298 行。2.0 新增 epoch_millis 和 epoch_second 两种格式,只有用了这两种格式的字段才能解析时间戳,它们不能用在 dynamic template 里,因为无法与 long 值区分。
默认日期格式从 date_optional_time 改成 strict_date_optional_time,要求 4 位年、2 位月和日(时分秒可选 2 位)。动态新增的日期字段默认格式是 strict_date_optional_time||epoch_millis,见第 300–316 行。写入端如果送来 2015-1-1 这类不补零的日期,需要先验证是否还能解析。
布尔字段的聚合输出。 布尔字段原来用字符串 fielddata,F 表示 false、T 表示 true;2.0 改成数字 fielddata,0/1 表示。文档列出受影响的 API 响应会返回 0/1 而不是 F/T,见第 323–353 行。解析聚合 key 的客户端代码要检查。
analyzer 设置。 index_analyzer 被移除,统一用 analyzer;只设置 analyzer 时,索引和搜索都用它,要在搜索时用不同的分析器,同时写 analyzer 和 search_analyzer。类型级的 index_analyzer、search_analyzer、analyzer 设置也被移除,因为不能再按类型名选择字段;_analyzer 元字段(给每个文档指定分析器)同样移除,在旧索引上被忽略,见第 272–285 行。
元字段配置收窄。 _id、_type、_index 的配置不能再改;_routing 只能标记为必填;_field_names 只能禁用;_size 只能启用;_boost 和 _analyzer 被移除。更重要的是元字段不能再写在文档体里,必须用查询字符串参数传,例如路由要写成 PUT my_index/my_type/1?routing=bar,见第 187–258 行。1.x 里靠 _routing.path 从文档字段提取路由的写法,升级后要改到写入端显式传参。
_timestamp 和 _ttl 弃用。 在 2.x 内仍可用,文档建议用普通 date 字段显式赋值代替 _timestamp;现有的 _ttl 将来会被新实现替换,语义可能不同,见第 260–270 行。
其他被移除或改名的参数。 position_offset_gap 改名为 position_increment_gap,2.0 新建索引默认值是 100,旧索引继续用 0,目的是避免短语查询在同一字段的不同值之间匹配,见第 431–442 行。copy_to 写在 multi field 里从 2.0 起被忽略,2.1 或 2.0.1 之后创建这样的 mapping 会抛异常,见第 444–449 行。index_name、path、compress、compress_threshold、字段级 postings 与 doc values codec 也被移除;codec 设置在 2.0 之前创建的索引上被忽略,在之后创建的索引上会导致 mapping 解析失败,见第 411–422 行。
升级前把这几项和前面五条一起过一遍:日期格式和布尔聚合影响查询结果,元字段和 analyzer 设置影响写入和建索引,是否会碰到取决于旧 mapping 里实际用了什么,要逐个索引核对。
动态映射的写入代价
文档只说"会变慢",没说慢多少、什么时候明显,本文也没有实测,所以不给具体阈值。能确定的是影响跟新增字段的频率有关:索引里的字段基本固定时,这条收紧不会带来额外的确认。
如果索引会持续出现新字段,预定义 mapping 或收敛字段,比事后优化 master 确认有效。具体到每天新增多少字段开始有影响,要在自己的测试环境里测。
升级前把 mapping 导出存档
一旦 2.0 因为冲突拒绝启动,要改的是当前的 mapping,而手上的旧 mapping 导出能直接告诉你哪些字段曾经不一致、当初为什么那么定义。回滚时也要用到。
curl -s 'localhost:9200/_all/_mapping' | python3 -m json.tool > /tmp/mapping_before_upgrade.json
这条命令要在升级窗口前跑。另外把"每天新增字段数"纳入监控:这个指标平时没人看,但它能反映动态映射是否失控。
在 7.17.29 上跑一遍
冲突的 mapping 与正常的 mapping 更新,放一起对照。
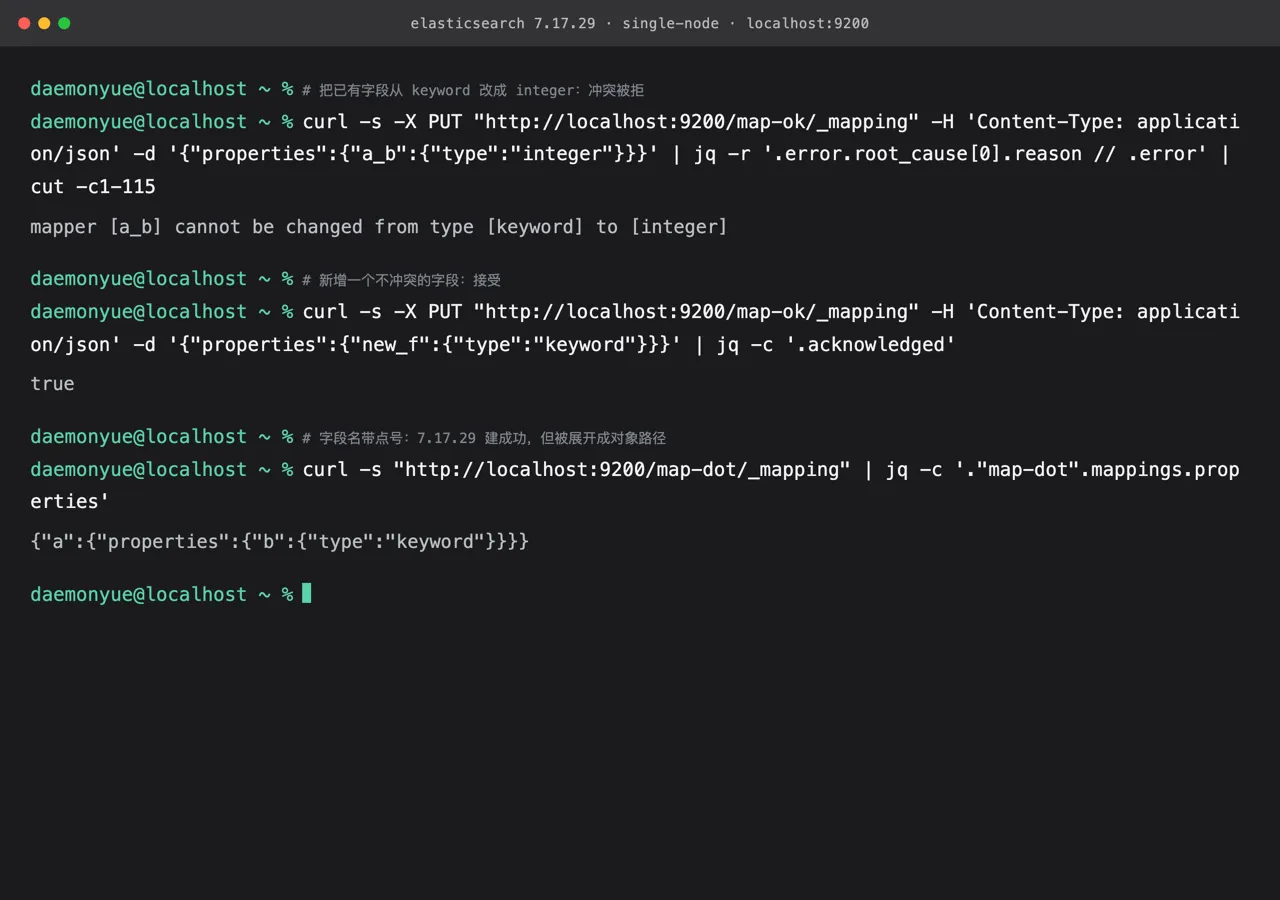
图 1:7.17.29 单节点实例的实测输出。把已有字段 a_b 从 keyword 改成 integer 报 mapper [a_b] cannot be changed from type [keyword] to [integer];新增一个不冲突的字段被接受;字段名带点号能建,并被展开成 a.properties.b 的对象路径。
curl -s -X PUT 'http://localhost:9200/map-ok/_mapping' -H 'Content-Type: application/json' -d '{"properties":{"a_b":{"type":"integer"}}}' \
  | jq -r '.error.root_cause[0].reason'
# mapper [a_b] cannot be changed from type [keyword] to [integer]
curl -s -X PUT 'http://localhost:9200/map-ok/_mapping' -H 'Content-Type: application/json' -d '{"properties":{"new_f":{"type":"keyword"}}}' \
  | jq -c '.acknowledged'
# true
curl -s 'http://localhost:9200/map-dot/_mapping' | jq -c '."map-dot".mappings.properties'
# {"a":{"properties":{"b":{"type":"keyword"}}}}
图 1 把「冲突的 mapping 不能创建」落到了具体报错:改已有字段类型被拒,新增字段正常。另有一条与正文不同:字段名带点号在 7.17.29 能建,而且被展开成对象路径,不再报错。本机没有 2.x 二进制,2.0 当年「冲突 mapping 让集群起不来」的启动期检查未复现。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 1.x / 2.x 二进制;
验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测。
短名字段引用、类型名长度、动态字段需 master 确认等条目未逐个测。
写在最后
2.0 的 mapping 收紧,四条是显性报错(好查),一条是隐性变慢(难查)。升级前把冲突字段找出来,同时把日志索引的动态映射收敛掉。
动态映射收敛的做法:关掉动态映射,或者配好 dynamic_templates 把类型固定住。文档描述的冲突来源是不同分片各自给同一个字段推导出不同映射,日志类索引的字段不固定,最容易出现这种情况。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。「在 7.17.29 上跑一遍」里已实际验证:改已有字段类型报mapper [a_b] cannot be changed from type [keyword] to [integer],新增字段被接受;字段名带点号能建且被展开成a.properties.b(与正文所述 2.0 行为不同,后续版本放开了点号)。本机无 2.x 二进制,启动期冲突检查未复现。