ES 9.1 引入 Failure Store,把 ingest 失败或 mapping 冲突的文档存下来,9.2 起对日志流默认开启。本文讲怎么开、怎么查,以及升级后写坏文档的响应码从 400 变成 201 这个大坑。
说明
实测环境:本地另起一个 Elasticsearch 9.4.2 单节点实例(官方 tar 包,端口 9200,独立 path.data),安全特性与机器学习均关闭;实验产生的索引与 data stream 都在这台实例上。文末「在 9.4.2 上跑一遍」里的命令与响应均取自该实例。
一批文档写进去,一半失败
做过日志接入的人大概都遇到过这种情况:一批文档写进去,bulk 响应里带着一堆 ingest 报错或字段类型冲突,然后这些文档就没了——很多客户端根本处理不了这些错误,拿不到能重试的"坏文档",只能丢掉。
偏偏对可观测性、安全这类场景来说,写不进去的文档往往恰恰是最该看的信号。9.1 引入的 failure store 就是接这个的。
官方怎么描述这个痛点
9.1 highlights 里这段话写得很清楚(1548–1625 行 @ v9.3.0):
Documents that encountered ingest pipeline failures or mapping conflicts would previously be returned to the client as errors in the bulk and index operations. Many client applications are not equipped to respond to these failures. This leads to the failed documents often being dropped by the client which cannot hold the broken documents indefinitely. In many end user workloads, these failed documents represent events that could be critical signals for observability or security use cases.
简单说:客户端扛不住这些错误 → 坏文档被丢 → 但那些坏文档可能正是关键信号。
failure store 的做法是:data stream 额外维护一套"失败存储",接收因为可预防的配置错误而写不进去的文档,连同失败时间、错误信息、原始文档一起存下来。它有自己的 mapping 和访问方式,本质上是一组独立的 backing index。
怎么开
新建 data stream 时,在模板里配 data_stream_options:
PUT _index_template/my-template
{
  "index_patterns": ["logs-test-*"],
  "data_stream": {},
  "template": {
    "data_stream_options": {
      "failure_store": {
        "enabled": true
      }
    }
  }
}
已有的 data stream 用 _options 端点开:
PUT _data_stream/logs-test-apache/_options
{
  "failure_store": {
    "enabled": "true"
  }
}
(两个示例都来自官方 9.1 highlights。)
怎么查
用一个新语法,选择器 ::failures:
POST logs-test-apache::failures/_search
这个选择器可以跟普通索引模式混着用,官方给了几种写法:
POST logs-*::failures/_search
POST logs-*,logs-*::failures/_search
POST *::failures/_search
ES|QL 里也能用:
FROM my_data_stream*::failures
要注意:失败文档默认不会出现在正常查询里,因为它们存在不同的索引上,得显式用 ::failures 去查。
9.2 起对日志流默认开启,这里有个大坑
9.2 把 failure store 变成了默认:匹配 logs-*-* 的新 logs data stream 默认开启(9.2.0 highlights @ v9.3.0)。
真正要命的是下面这句:
Note: With the failure store enabled, the http response code clients receive when indexing invalid documents will change from
400 Bad Requestto201 Created, with an additional response attribute"failure_store" : "used".
写入非法文档时,HTTP 响应码从 400 变成 201,多一个 "failure_store": "used" 属性。
如果客户端、采集端或者监控是靠 HTTP 状态码判断"写成功/写失败"的,升级之后它会认为这些坏文档写成功了。错误率会突然变得很好看,实际上数据都进了 failure store。
这一点必须提前改:判断逻辑要去看响应体里的 "failure_store": "used",不能只看状态码。
9.2 里 OTel 和 APM 的 data stream 也默认开启了 failure store(PR #131395、#131296)。
9.4 起跨集群搜索也支持
9.4 补了一条:Failure Stores in Cross Cluster Search(PR #139316,9.4.0 features @ v9.5.0)。
也就是说,跨集群查询现在能一并查到 failure store 里的数据了。
不是什么错误都收
有个边界要说清楚。在 9.3.5 和 9.4.1 的修复里有一条:"Update failure store redirect logic to exclude backpressure exceptions"(PR #148154,见 9.3.5 和 9.4.1 的发布说明)。
反压(backpressure)导致的异常不再被重定向到 failure store。 这是对的——集群忙不过来不是"文档有问题",把这种失败存进 failure store 只会越堆越多。
所以 failure store 收的是可预防的配置类错误:ingest pipeline 异常、mapping 冲突这类。
| 项 | 结论 | |
|---|---|---|
| 版本 | 9.1 引入;9.2 对 logs-*-* 默认开启 |
|
| 存什么 | ingest 失败或 mapping 冲突的文档 + 失败时间 + 错误信息 + 原始文档 | |
| 怎么查 | ::failures 选择器,支持与普通索引模式混用,ES\ |
QL 也支持 |
| 响应码变化 | 9.2 起写坏文档返回 201 而不是 400,带 "failure_store": "used" |
|
| 跨集群 | 9.4 起支持 CCS 查询 failure store | |
| 不收什么 | 反压类异常(9.3.5 / 9.4.1 起) |
关掉默认开启之前想清楚
9.2 起 logs-*-* 默认开启,如果写入链路还没准备好,可能会想把它关掉。要分情况:
该关的情况:写入端明确依赖 400 判断成败,而且短期内改不了。这种情况下让它返回 201 确实是危险的——静默的成功比明确的失败糟。
不该关的情况:只是觉得"多了个索引占空间"。failure store 里存的是本来会丢的文档,它占的空间换的是可排查性,这个交换通常是划算的。真觉得占空间,更好的做法是给它配生命周期,让老数据自动清掉。
判断是优先改写入端的判定逻辑,而不是关掉 failure store。理由很简单:关掉之后失败文档就真的没了,而改判定逻辑是一次性的成本。只有确实来不及改的时候,才把关闭当成临时措施。
还有一点容易忽略:这个默认只作用于 logs-*-* 数据流。其它命名的索引不受影响,所以排查时先确认自己的数据流是不是匹配这个模式。
在 9.4.2 上跑一遍
响应码那处变化直接造两条 data stream 就能看出来:一个开 failure store,一个不开,写同一条坏文档。
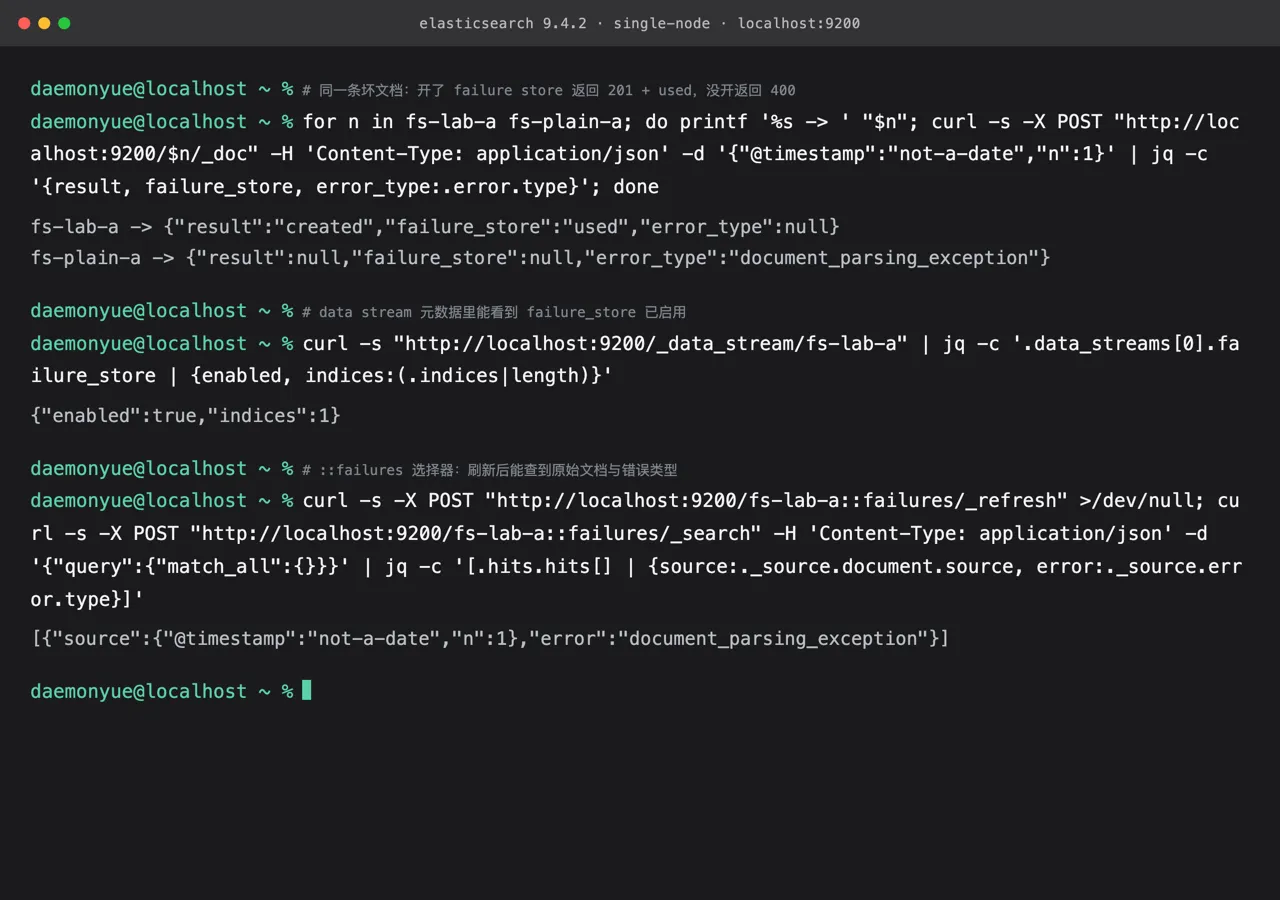
图 1:9.4.2 单节点实例的实测输出。开 failure store 的 fs-lab-a 返回 201 且响应体带 failure_store: used,未开的 fs-plain-a 返回 400 + document_parsing_exception;_data_stream 元数据里 failure_store.enabled=true;::failures 选择器刷新后能取回原始文档与错误类型。
for n in fs-lab-a fs-plain-a; do printf '%s -> ' "$n"; \
  curl -s -X POST "http://localhost:9200/$n/_doc" \
    -H 'Content-Type: application/json' -d '{"@timestamp":"not-a-date","n":1}' \
    | jq -c '{result, failure_store, error_type:.error.type}'; done
# fs-lab-a -> {"result":"created","failure_store":"used","error_type":null}
# fs-plain-a -> {"result":null,"failure_store":null,"error_type":"document_parsing_exception"}
curl -s 'http://localhost:9200/_data_stream/fs-lab-a' \
  | jq -c '.data_streams[0].failure_store | {enabled, indices:(.indices|length)}'
# {"enabled":true,"indices":1}
curl -s -X POST 'http://localhost:9200/fs-lab-a::failures/_refresh' >/dev/null
curl -s -X POST 'http://localhost:9200/fs-lab-a::failures/_search' \
  -H 'Content-Type: application/json' -d '{"query":{"match_all":{}}}' \
  | jq -c '[.hits.hits[] | {source:._source.document.source, error:._source.error.type}]'
# [{"source":{"@timestamp":"not-a-date","n":1},"error":"document_parsing_exception"}]
图 1 把正文那条「201 而不是 400」的引用落到了本机:状态码确实变了,响应体多出 failure_store: used,坏文档连同错误类型一起存进 .fs-... 索引,::failures 刷新后可查。只判断 2xx 的客户端会把这条失败当成成功。
边界:
- 图 1 出自 9.4.2 单节点实例,只造了日期格式冲突这一种失败;ingest pipeline 异常、反压异常未测;
- 跨集群搜索 failure store 需要第二个集群,本机没有;
logs-*-*有内置模板会与自建模板冲突,实验用的是自定义前缀fs-lab-*/fs-plain-*。
写在最后
建议:如果是 9.2 之后升上来的,可以去查一遍现有的 failure store 有没有东西——POST logs-*::failures/_search。有些系统之前就有偶发的 ingest 错误或 mapping 冲突,这时候能看到。第二件事是检查写入端的成功判定逻辑。
为什么第二件事同样重要:failure store 解决的是"失败了能查到",但它不改变"写入端以为成功了"这件事。如果代码用 bulk 请求、只看整体返回码不看逐条 items 的错误,那失败文档照样是被当作成功的——只是现在有地方能查到了。
正确的做法是遍历 items 检查每条的 status 和 error。这个改动不大,但它是从"发现失败"到"感知失败"的分界。
所以:failure store 是补救措施,不是根治。它把"完全不知道丢了"变成"事后能查到",这已经是不小的进步;但要真正解决,还是要让写入端对失败有反应——重试、告警、或者至少记日志。
判断优先级的标准:这条改动让失败从"不可见"变成"可见"了吗? 是 → 它就值得做,哪怕不能根治。可观测性从来都是第一步,不是最后一步。
参考
- 9.1.0 highlights @ v9.3.0
- 9.2.0 highlights @ v9.3.0
- 9.4.0 features(CCS 支持)@ v9.5.0
- PR #148154(反压异常不重定向)
本文对照 Elasticsearch
v9.3.0、v9.5.0标签的官方发布说明核对,示例取自官方 highlights 原文。「在 9.4.2 上跑一遍」里已实际建两条 data stream 并写入同一条坏文档:开启 failure store 返回 201 +failure_store: used,未开启返回 400;::failures刷新后取回原始文档与document_parsing_exception。pipeline 异常与反压异常、跨集群 failure store 未实测。