1.0 起注册查询存在业务索引的
.percolator类型里,匹配请求按业务 type 解析文档,响应返回_index与_id。本文按固定标签核对这套写法,并给出从 0.90 搬过来的顺序与核对方法。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
本文讨论 1.0 的历史实现,不表示当前云服务支持这些旧接口。示例用于准备隔离的旧版本验证环境,不得在生产集群执行。文末实测小节里的命令与响应取自本机 7.17.29 实例;1.0 当年的执行过程无实例可对照。
1.0 改了什么
Percolator 文档标注 added[1.0.0.Beta1],说明这一形态从 1.0 开始。
核心变化是查询的存储位置。文档写明:percolate 查询以特定格式存为文档,位于任意索引下名为 .percolator 的保留 type 中,查询体放在顶层 query 字段下,见第 71–72 行。
对比 0.90:那是一个集群级的 _percolator 索引,业务索引名以 type 表示,见0.90 percolator 那篇。1.0 之后规则跟着业务索引走,管理边界更清楚。
响应格式也变了。1.0 返回 total 与 matches 数组,每项包含 _index 与 _id,见第 45–63 行。0.90 的 {"ok":true,"matches":["kuku"]} 只有名字,且 ok 字段在 1.0 已被移除。
注册、匹配、注销
文档给出的示例使用三个请求。以下是 1.0 的旧式 REST 写法,需要通过受控 HTTP 客户端发送:
curl -XPUT 'localhost:9200/my-index/.percolator/1' -d '{
    "query" : {
        "match" : { "message" : "bonsai tree" }
    }
}'

curl -XGET 'localhost:9200/my-index/message/_percolate' -d '{
    "doc" : { "message" : "A new bonsai tree in the office" }
}'

curl -XDELETE localhost:9200/my-index/.percolator/1
注册路径 my-index/.percolator/1 中,my-index 是业务索引,.percolator 是保留 type,1 是规则 ID。
匹配路径 my-index/message/_percolate 里的 message 是业务 type,用于解析请求体中的 doc。规则存储用的是 .percolator type,文档解析用的是业务 type,两者作用不同,不能混写成一个路径。
注销就是删除那篇文档,见第 146–151 行。
文档还说明 percolator 与大部分特性是实时的:查询一旦索引就能立即使用,见第 15–16 行。这比“写入后需要刷新”的假设更明确,但实际行为仍应在目标版本上确认。
mapping 会影响查询解析
文档专门说明可以为注册查询关联一个 mapping type,用于控制 range query、shape filter 等依赖 mapping 的查询如何构造。原因是 percolate 查询被索引到 .percolator type,而依赖 mapping 的查询若没有正确的字段类型,行为会不符合预期,见第 100–104 行。
示例是在注册文档中加 "type" : "tweet",让 range 查询按 tweet 类型里 created_at 的设置解析,见第 106–123 行。
因此搬迁与新建规则时,显式声明字段 mapping 是必要的,不能只依赖字段名的自动解析。文档也提示多 type 场景下自动解析可能产生意外行为。
.percolator type 自身也有 mapping,默认不索引 query 字段、只存储它,可以通过 update mapping 修改,见第 125–144 行。
从 0.90 搬过来,身份是第一位
0.90 的旧实现里,_percolator 索引的 type 表示业务索引名,规则 ID 只是 _id。不同业务索引可以有相同的规则 ID。
搬迁到 1.0 时,规则要进入各自业务索引的 .percolator type。如果只导出 _id 与查询体,就会丢失归属;如果两个业务索引里存在同名规则,直接写入还可能互相覆盖。
建议的搬迁顺序是:
- 冻结规则写入,或准备可重放的变更记录,避免搬迁期间产生新规则。
- 导出完整身份:原业务索引名(即旧
_percolator的 type)、规则_id、查询体、以及附加的元数据字段。 - 建立“旧身份 → 新地址”的映射表,明确每条规则写入哪个业务索引、使用什么 ID。
- 在目标索引上确认 mapping,特别是 range、shape 等依赖字段类型的查询。
- 逐条写入,并检查每一条的写入结果。
- 按身份集合、查询内容、数量三层核对。
- 用正例、负例、临界值验证匹配行为。
- 保留源数据与映射表,业务观察通过后再单独决定清理。
第 5 步要逐条确认结果。批量请求整体成功不代表每一条都成功,失败项必须单独记录并重放。
数量一致也不能证明内容一致。若使用了覆盖写入,重复 ID 会让旧内容被替换,条数仍然对得上。因此第 6 步必须比对查询内容,而不只是计数。
不提供自动删除脚本,也不按数量判断
本文不给出删除源索引的命令,也不建议“数目对上就删”。清理应是迁移、核对、业务观察都完成之后的独立动作,并且需要确认目标归属后再执行。
原因很简单:删除是不可逆的,而数量一致是最弱的证据。把两者绑定,等于用最弱的证据触发最不可逆的操作。
如果确实要清理,应先保留一份可恢复的导出,并确认没有写入流量再执行。删除后也要重新验证业务功能,确认没有规则被遗漏。
元数据字段与筛选的边界
注册文档里除了 query,还可以放任意字段,文档给出的例子是 priority,见第 85–97 行。这些字段用于后续筛选要执行哪些规则。
但筛选有边界:过滤只能作用于元数据字段,因为 query 字段默认不被索引,见第 221–223 行。若业务需要按查询内容筛选,就得先修改 .percolator 的 mapping,让 query 被索引,并接受相应的索引开销。
设计元数据字段时要注意类型稳定。多个业务写入同一个字段名但类型不同,可能引起 mapping 冲突,进而影响筛选结果。字段名与类型应在规则写入前约定好。
元数据字段同样不是权限机制。 用 priority 或租户字段限定执行范围,前提是服务端按调用身份决定过滤条件。客户端可任意构造的过滤条件,不能用来隔离租户。
percolate 请求的几个选项
文档在 Percolate api 一节列出了可用选项。请求体中的 doc 是要匹配的文档,见第 162 行;它也支持 percolate 已存在的文档,此时不需要 doc。
size 控制返回的最大匹配数量,默认不限制,见第 192 行。规则较多时应显式设置,避免一次返回过多结果。
排序有约束:文档说明只有部分排序字段可用,其他字段会抛异常,且使用排序时 size 与 query 是必需的,见第 197 行。启用排序前应先确认目标版本支持哪些字段。
高亮也可用,但需要 size,并且性能取决于被高亮的匹配数量,见第 205–207 行。匹配数量大时高亮的开销也随之增加,应控制范围。
失败与部分结果要能区分
应用不应把“没有命中”和“请求失败”混为一谈。前者是 matches 为空且请求成功,后者应通过响应的失败信息与分片状态识别。
文档示例的响应里有 _shards 段,包含 total、successful、failed,见第 49–55 行。检查这个字段能发现部分分片未参与的情况。
因此调用方应至少检查三部分:响应是否成功、分片是否有失败、以及 matches 的内容。只看 total 是否为零,会漏掉执行不完整的情况。
重试策略也要定义。规则匹配通常是幂等的,重试不会改变结果;但如果请求同时包含注册或删除动作,就要考虑重复执行的后果。
准备一组能验证归属的数据
下面按文档写法整理,供隔离的 v1.0.0 环境验证。旧版本没有现代 Dev Tools 配套,需要通过受控 HTTP 客户端发送对应方法、路径与 JSON。
先建两个业务索引,各自声明一个字段,再分别注册同名规则:
curl -XPUT localhost:9200/news-100 -d '{
  "mappings": {
    "article": { "properties": { "title": { "type": "string" } } }
  }
}'

curl -XPUT localhost:9200/logs-100 -d '{
  "mappings": {
    "entry": { "properties": { "message": { "type": "string" } } }
  }
}'

curl -XPUT 'localhost:9200/news-100/.percolator/1' -d '{
    "query" : { "match" : { "title" : "bonsai tree" } },
    "priority" : "high"
}'

curl -XPUT 'localhost:9200/logs-100/.percolator/1' -d '{
    "query" : { "match" : { "message" : "bonsai tree" } },
    "priority" : "low"
}'
两个索引里都有 ID 为 1 的规则,但字段与优先级不同。这样可以验证规则是否按索引隔离。
再分别发起匹配,注意请求路径里的业务 type 与前面 mapping 中声明的一致:
curl -XGET 'localhost:9200/news-100/article/_percolate' -d '{
    "doc" : { "title" : "A new bonsai tree in the office" }
}'

curl -XGET 'localhost:9200/logs-100/entry/_percolate' -d '{
    "doc" : { "message" : "A new bonsai tree in the office" }
}'
预期检查项是:两个请求各自返回自己索引里的规则,响应 matches 中带有 _index 与 _id。两者 ID 相同但 _index 不同,这正说明身份必须由索引名与 ID 共同确定。
随后验证元数据筛选:在请求里加上 filter,只匹配 priority 为 high 的规则,见第 227–236 行。观察 news-100 是否命中、logs-100 是否不命中。
最后做注销验证:删除其中一条规则后重新请求,确认它不再返回。再准备一份字段不匹配的文档,确认 matches 为空,并区分“没有命中”与“请求失败”。
切换之后的回退要考虑规则状态
回退不只是把流量切回旧环境。切换到新实现之后,规则可能被新增、修改或删除,这些变化需要回放到旧环境才能保持一致。
只保留旧索引不够。旧索引里是切换前的状态,不包含切换后的变更。因此需要在切换期间记录规则变更,并在回退时按记录反向应用。
回退演练应包含:停止新环境的写入、按记录回放变更到旧环境、验证规则数量与内容、再用同一批文档验证匹配结果。演练应在切换前完成一次,而不是故障时才第一次执行。
也要提前定义回退的触发条件与决策人。规则匹配错误、延迟过高、写入失败都可以作为触发条件,但每个条件都需要可观测的数据支撑,而不是凭感觉判断。
老代码与新写法的对照
| 项目 | 0.90 | 1.0 |
|---|---|---|
| 规则存储 | 集群级 _percolator 索引 |
业务索引内的 .percolator type |
| 归属表示 | _percolator 的 type |
索引名本身 |
| 匹配路径 | 业务索引/业务type/_percolate |
同为 业务索引/业务type/_percolate |
| 响应 | ok 与规则名列表 |
total 与含 _index、_id 的列表 |
| 注销 | 删除文档 | 删除文档 |
| 附加字段 | 可用于筛选 | 可用于筛选,query 默认不索引 |
路径看起来相似,但存储位置与响应结构不同。迁移时最容易出错的是把 0.90 的响应解析逻辑直接沿用,导致读不到 _index 与 _id。
另一处是归属。0.90 靠 type 区分业务索引,1.0 靠索引名。搬迁脚本若只搬运 _id,规则就会失去归属。
后续形态与本文边界
更晚的版本继续调整了 percolator 的实现形态,不在本文核对范围。本文只说明 1.0 这一代的结构与搬迁要点。
专用索引的取舍
把规则放在业务索引里,规则与数据一起管理,mapping 天然一致;代价是规则的容量与副本数受业务索引设置影响。
放在专用索引里,可以单独设置主分片与副本数,适合规则数量大或需要独立扩容的场景;代价是必须把业务索引的 mapping 同步维护一份,否则查询会被错误解析,见第 210–216 行。
选择哪一种取决于规则规模与运维方式,本文不给未实测的建议。若选专用索引,应把 mapping 同步纳入发布流程,并在每次业务 mapping 变更时同步检查。
上线前的验收清单
| 检查项 | 要确认什么 |
|---|---|
| 身份完整 | 是否记录了索引名与规则 ID 的组合 |
| ID 冲突 | 不同业务索引的同名规则是否互相覆盖 |
| mapping 一致 | range、shape 等依赖类型查询能否正确解析 |
| 元数据字段 | 字段类型是否稳定,筛选是否只作用于元数据 |
| 筛选边界 | query 默认不索引是否影响业务筛选 |
| 响应解析 | 是否读取 _index、_id 与 _shards |
| 注销生效 | 删除后是否不再返回 |
| 回退演练 | 切换后的规则变更能否回放到旧环境 |
清单里每一项都应有对应的验证数据。只确认“能注册、能匹配”是最低要求,不足以支撑切换。
在 7.17.29 上跑一遍
.percolator 保留 type 与现在的做法,各发一次。
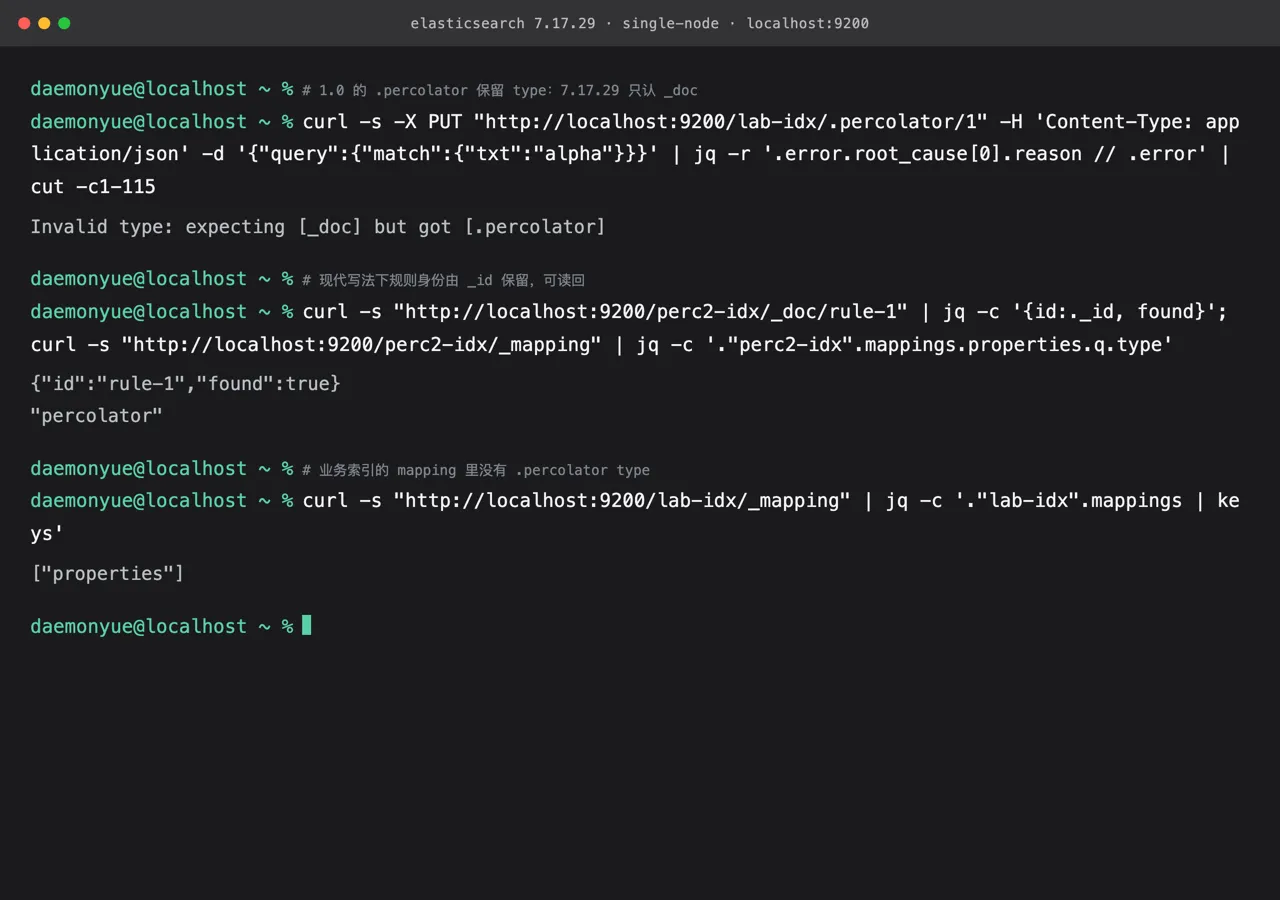
图 1:7.17.29 单节点实例的实测输出。PUT /lab-idx/.percolator/1 报 Invalid type: expecting [_doc] but got [.percolator];现代写法用 percolator 字段类型,规则 _id=rule-1 可读回;业务索引的 mapping 只有 properties,没有 type 层。
curl -s -X PUT 'http://localhost:9200/lab-idx/.percolator/1' -H 'Content-Type: application/json' -d '{"query":{"match":{"txt":"alpha"}}}' \
  | jq -r '.error.root_cause[0].reason'
# Invalid type: expecting [_doc] but got [.percolator]
curl -s 'http://localhost:9200/perc2-idx/_doc/rule-1' | jq -c '{id:._id, found}'
# {"id":"rule-1","found":true}
curl -s 'http://localhost:9200/perc2-idx/_mapping' | jq -c '."perc2-idx".mappings.properties.q.type'
# "percolator"
curl -s 'http://localhost:9200/lab-idx/_mapping' | jq -c '."lab-idx".mappings | keys'
# ["properties"]
图 1 说明 1.0 那套「业务索引下的 .percolator type」已经不在:7.17.29 只认 _doc。现在规则身份由文档 _id 保留,rule-1 注册后能原样读回;业务索引的 mapping 里也没有任何 type 层。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 1.x / 2.x 二进制;
验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测。
实时性与筛选行为未测;1.0 当年的注册与匹配流程无实例可对照。
写在最后
1.0 把 percolator 从集群级特殊索引改成索引内的 .percolator 类型,规则随业务索引管理,响应也给出了索引名与 ID。这是搬迁时最关键的两点:身份要保留完整,mapping 要显式确认。
搬迁顺序应按冻结、导出、映射、逐条写入、三层核对、行为验证来走,清理留到最后单独决定。这样即使出现问题,也有可回溯的依据。
参考
- Percolator @ v1.0.0
- 0.90 的 percolator 实现
本文逐节核对了固定标签文档,引文取自该文档。「在 7.17.29 上跑一遍」里已实际验证
.percolator保留 type 报Invalid type: expecting [_doc] but got [.percolator];现代percolator字段写法下规则_id=rule-1可原样读回,业务索引 mapping 只有properties。本机无 1.0 二进制,实时性与筛选行为未实测。