一、前言
用过ChatGPT、豆包这类大模型的朋友,大概率都遇到过两个致命问题:一是模型幻觉,明明不懂的内容硬编,输出看似通顺实则错误的信息;二是知识滞后,模型训练数据有时间边界,最新的行业政策、技术进展、实时热点完全无法应答。
我们刚开始学习RAG时,只会简单的本地文档检索,一遇到实时性、外网场景就束手无策。要么代码只能跑通,无法落地生产;要么依赖国外工具,没有适配国内中文环境;要么不懂工程优化,出现调用成本高、检索噪音多、响应慢等问题。今天我们就结合实际,一起探索联网RAG技术,掌握可落地的联网检索增强方案。
二. RAG核心基础原理
1. 传统大模型的核心短板
常规大模型的能力上限,完全取决于训练数据集,存在三个无法规避的核心缺陷,这也是RAG技术诞生的核心原因。
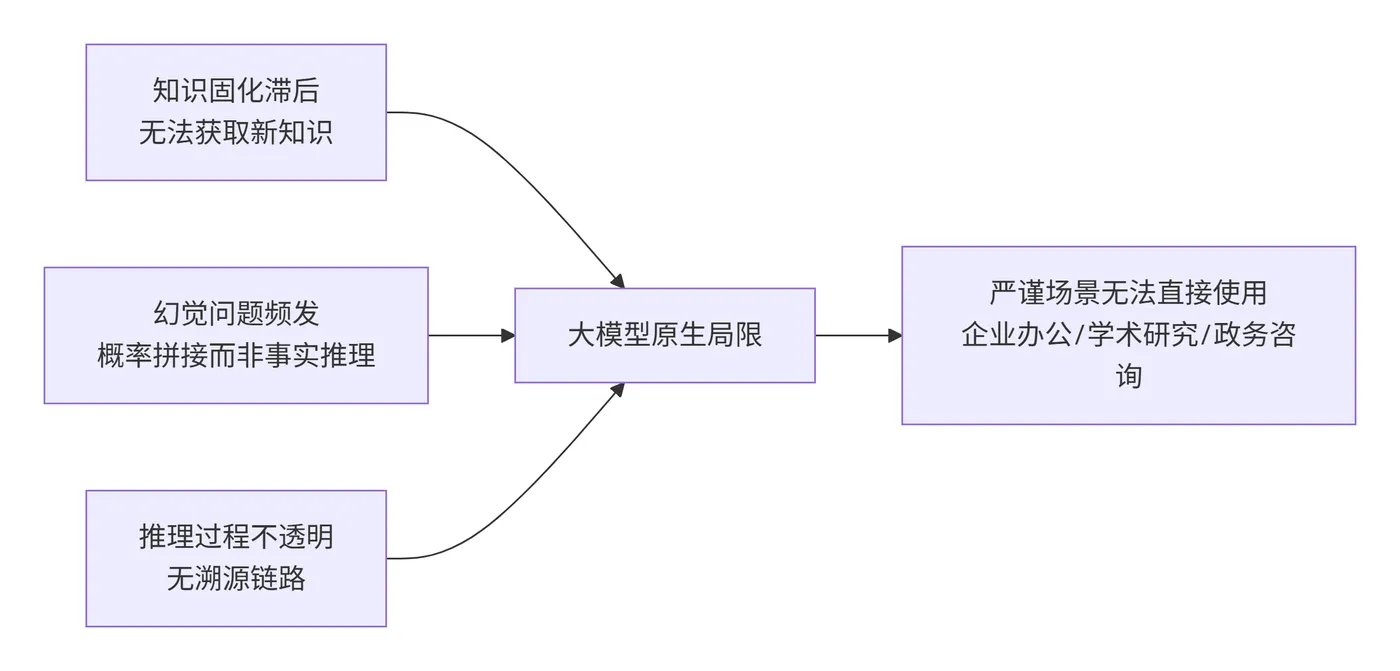
知识固化滞后:
- 模型训练完成后,无法自主获取后续新增的知识,比如2026年的新技术、新政策、新学术成果,原生模型完全无法认知。
- 就像参考的arxiv2023年RAG综述论文所述,传统LLM存在严重的知识更新壁垒。
幻觉问题频发:
- 大模型的生成逻辑是基于概率拼接文本,而非基于事实推理。
- 面对陌生领域、细分专业问题时,会自主编造数据、论文、结论,普通人很难分辨真假,在企业办公、学术研究、政务咨询等严谨场景完全无法使用。
推理过程不透明:
- 原生大模型的输出没有溯源链路,用户无法知道答案的依据来源;
- 一旦出现错误,无法快速定位问题,不符合企业级应用的合规、可追溯要求。
2. 联网RAG的核心优势
检索增强生成(RAG)的核心逻辑,是“外部检索+模型生成”的双向协同,完美弥补了原生大模型的所有短板,也是目前主流的大模型落地方案。结合权威RAG综述的核心观点,其核心优势分为三点。
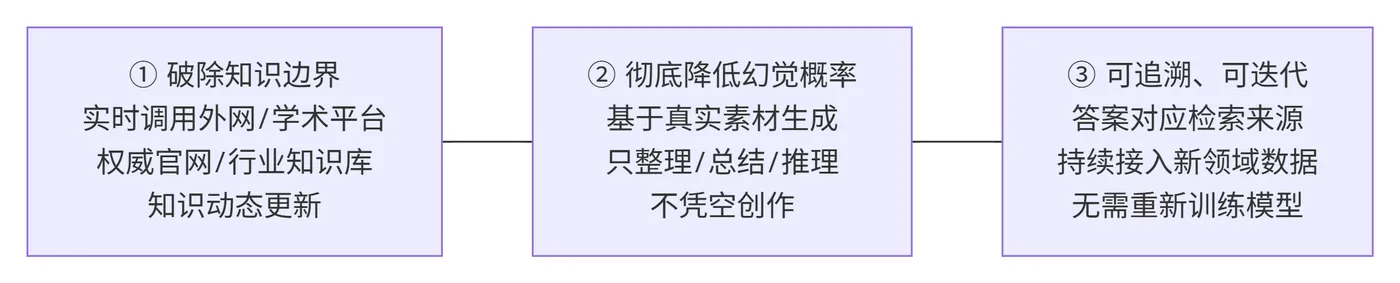
- 第一,破除知识边界。RAG不依赖模型固有知识,可实时调用外网数据库、学术平台、权威官网、行业知识库,实现知识的动态更新,完美适配时效性、专业性场景。
- 第二,彻底降低幻觉概率。所有生成内容均基于检索到的真实素材,模型只负责整理、总结、推理,不再凭空创作,大幅提升回答的准确性与可信度。
- 第三,可追溯、可迭代。每一条答案都对应具体的检索来源,方便校验纠错,同时可以持续接入新的领域数据,让模型能力持续迭代,无需重新训练微调模型,极大降低落地成本。
3. RAG技术迭代脉络
3.1 朴素RAG:Naive RAG

- 最基础的版本,逻辑简单:用户提问→关键词检索文档→截取片段喂给模型→生成答案。
- 优点是上手简单、成本极低;
- 缺点是检索精度差、噪音多,无法处理复杂语义问题。
3.2 进阶RAG:Advanced RAG

- 优化了检索逻辑,增加了query改写、文档分块、相似度匹配、简单重排等能力;
- 解决了朴素RAG语义匹配不准的问题,适合大部分通用场景。
3.3 模块化RAG:Modular RAG

- 也是目前行业主流方案,将检索、增强、生成、重排、打分拆分为独立模块;
- 可单独优化、灵活替换,支持混合检索、私有化部署、自定义规则,适配企业复杂生产场景。
三. 联网检索核心工具
1. Tavily工具核心定位
要实现高质量联网RAG,核心是拥有稳定、精准、低噪音的检索工具,而Tavily是目前适配大模型最好的联网检索SDK,专门为AI问答、RAG检索、Agent智能体场景设计,区别于普通的搜索引擎的搜索。
- 普通搜索引擎返回结果杂乱,包含广告、导航、冗余内容,需要人工二次清洗;
- 而Tavily内置文本清洗、内容汇总、可信度打分、域名过滤、时效性筛选能力,输出的内容可直接喂给大模型,是开箱即用的AI检索工具。
2. Tavily最简环境部署
首先完成基础环境搭建,安装官方SDK,全程无复杂配置,一条命令即可完成。需要注意的是,密钥严禁硬编码在代码中,统一通过环境变量读取,规避安全风险,这是生产环境的基础规范。
#安装官方依赖库
pip install tavily-python
安装完成后,配置环境变量存储Tavily密钥,Windows、Mac、Linux系统均可通用,配置后永久生效,无需重复设置。后续所有调用都会自动读取密钥,简洁且安全。
3. 全参数搜索应用实践
实现Tavily搜索API生产级完整写法的示例脚本:通过环境变量读取密钥,调用时全量配置 search_depth(深度检索)、include_answer(内置智能汇总可直接喂LLM)、域名白/黑名单、时间窗口等参数,最后格式化输出汇总答案与逐条结果(含可信度分数、链接、摘要),是构建 RAG/Agent检索链路的标准参考模板。
# 导入依赖
import os
from tavily import TavilyClient
# 初始化客户端(环境变量读取密钥,规避硬编码风险)
client = TavilyClient(api_key=os.getenv("TAVILY_API_KEY"))
# 生产级全参数检索调用
result = client.search(
    query="2026 年大模型 RAG 检索增强生成有哪些新进展",  # 核心查询语句
    search_depth="advanced",  # 检索深度:basic快速检索,advanced深度抓取正文
    max_results=5,  # 返回结果数量,生产建议3-5条,平衡精度与token消耗
    include_answer=True,  # 开启内置汇总,直接生成可喂给LLM的精简上下文
    include_raw_content=False,  # 关闭原始HTML,仅保留清洗后文本,减少冗余
    include_domains=["arxiv.org", "zhihu.com", "github.com"],  # 限定权威域名检索
    exclude_domains=["csdn.net"],  # 拉黑低质量站点,过滤噪音
    topic="general",  # 检索类型:general通用、news实时新闻
    days=30,  # 时间窗口,仅检索近30天内容,适配时效性场景
)
# 打印Tavily内置汇总答案,可直接作为LLM上下文
print("=== Tavily 智能汇总答案 ===")
print(result["answer"])
# 逐条输出检索详情,包含分数、来源、摘要
print("\n=== 权威检索结果详情 ===")
for i, item in enumerate(result["results"], 1):
    print(f"\n[{i}] 标题:{item['title']}")
    print(f"    链接:{item['url']}")
    print(f"    可信度分数:{item['score']:.2f}")
    print(f"    内容摘要:{item['content'][:200]}...")

输出结果:
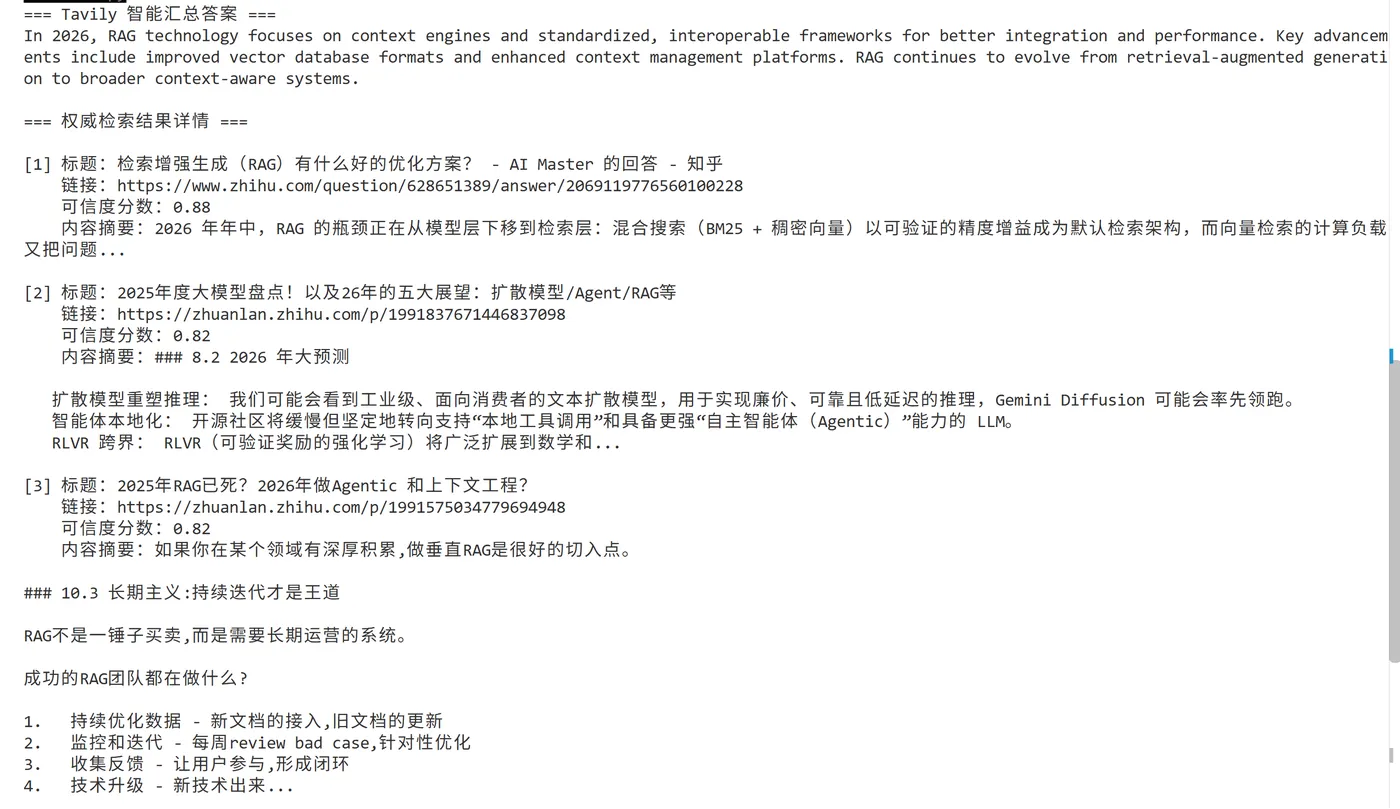
4. 核心参数深度解读
拆解5个最核心的高频参数,了解透生产配置逻辑:
include_answer:开启后Tavily会通过内置小模型,将多条检索结果自动整合为一段通顺、精准的上下文,省去开发者手动汇总、拼接内容的步骤,大幅简化RAG流程。
include_domains/exclude_domains:这是垂直领域检索的核心。比如学术场景只限定arxiv、知网,技术场景限定github、官方文档,从源头过滤垃圾信息,比检索后人工过滤效率提升10倍以上。
score可信度分数:Tavily会对每条检索结果打分(0-1分),生产环境中建议直接丢弃0.5分以下的内容,可过滤80%以上的噪音数据,大幅降低模型幻觉概率。
search_depth:日常问答用basic快速检索,毫秒级响应;学术调研、深度内容分析用advanced,完整抓取网页正文,保证信息完整性。
topic与days:查询新闻、赛事、股价等实时信息时,切换topic="news",搭配days时间窗口,精准召回近期内容,解决模型知识滞后问题。
5. Extract精准正文抽取
· 除了主动搜索,Tavily还有一个极易被忽略的核心接口:Extract。该接口不做全网搜索,只针对已有URL进行正文清洗,剔除广告、导航、页脚、弹窗等冗余内容,适合离线知识库构建、学术论文解析场景。
比如我们拿到arxiv的RAG综述论文链接,无需手动爬取、清洗,一行代码即可获取纯净正文,适配本地向量库入库场景。
from tavily import TavilyClient
# 初始化客户端
client = TavilyClient(api_key=os.getenv("TAVILY_API_KEY"))
# 批量解析多个权威URL
resp = client.extract(urls=[
    "https://arxiv.org/abs/2312.10997",
    "https://www.tavily.com/documentation/api"
])
# 遍历输出纯净正文
for item in resp["results"]:
    print("检索链接:", item["url"])
    print("纯净正文长度:", len(item["raw_content"]))
    print("正文预览:", item["raw_content"][:300], "...\n")

该接口的核心使用场景:已有固定权威链接、批量清洗网页内容、离线构建RAG知识库、替代Trafilatura手动爬取方案,大幅降低开发成本。
四. 自动化联网RAG框架集成
1. LangChain Agent自动检索实战
单纯的Tavily调用需要手动触发检索,而结合LangChain框架,可以实现智能Agent自动检索:模型自主判断问题是否需要联网,未知时效性、专业问题自动调用搜索,已知常识直接作答,无需开发者写大量if-else判断,是目前联网Agent的最小核心骨架。
以下示例基于LangChain 1.x create_agent的自动联网检索智能体:底层用腾讯混元hy3驱动,Tavily封装为搜索工具并显式传入API Key;系统提示词强制“时效性问题必须先查证再回答,禁止编造”;用户提问RAG最新进展后,Agent自主决策调用工具检索、汇总证据并给出最终回答,是Agentic Search的最小可运行范式。
import os
from langchain_openai import ChatOpenAI
from langchain_community.tools.tavily_search import TavilySearchResults
from langchain.agents import create_agent
# 1. 初始化大模型(腾讯混元,OpenAI 兼容协议,从环境变量读取密钥)
llm = ChatOpenAI(
    model="hy3-preview",
    api_key=os.environ.get("TENCENT_API_KEY", "sk-*"),
    base_url="https://tokenhub.tencentmaas.com/v1",
    temperature=0,
    max_tokens=1024,
)
# 2. 封装Tavily为Agent专属工具
#    工具类只认环境变量 TAVILY_API_KEY,或参数 tavily_api_key(优先显式传参,更直观)
tools = [
    TavilySearchResults(
        max_results=3,
        search_depth="advanced",
        tavily_api_key=os.environ.get("TAVILY_API_KEY", "tvly-dev-**"),
    )
]
# 3. 组装智能Agent(langchain 1.x 新 API:create_agent,内部基于 LangGraph)
#    系统提示词通过 system_prompt 传入,替代旧版 ChatPromptTemplate + agent_scratchpad
agent = create_agent(
    model=llm,
    tools=tools,
    system_prompt="你是专业智能助手,遇到时效性、未知事实类问题,必须调用搜索工具查证后再回答,禁止编造信息。",
)
# 4. 测试实时性问题,触发自动联网检索
result = agent.invoke(
    {"messages": [{"role": "user", "content": "2026年大模型RAG领域最新研究成果有哪些?"}]}
)
# 5. 输出最终回答(最后一条 AI 消息)
print("\n===== 最终回答 =====")
print(result["messages"][-1].content)

运行输出:
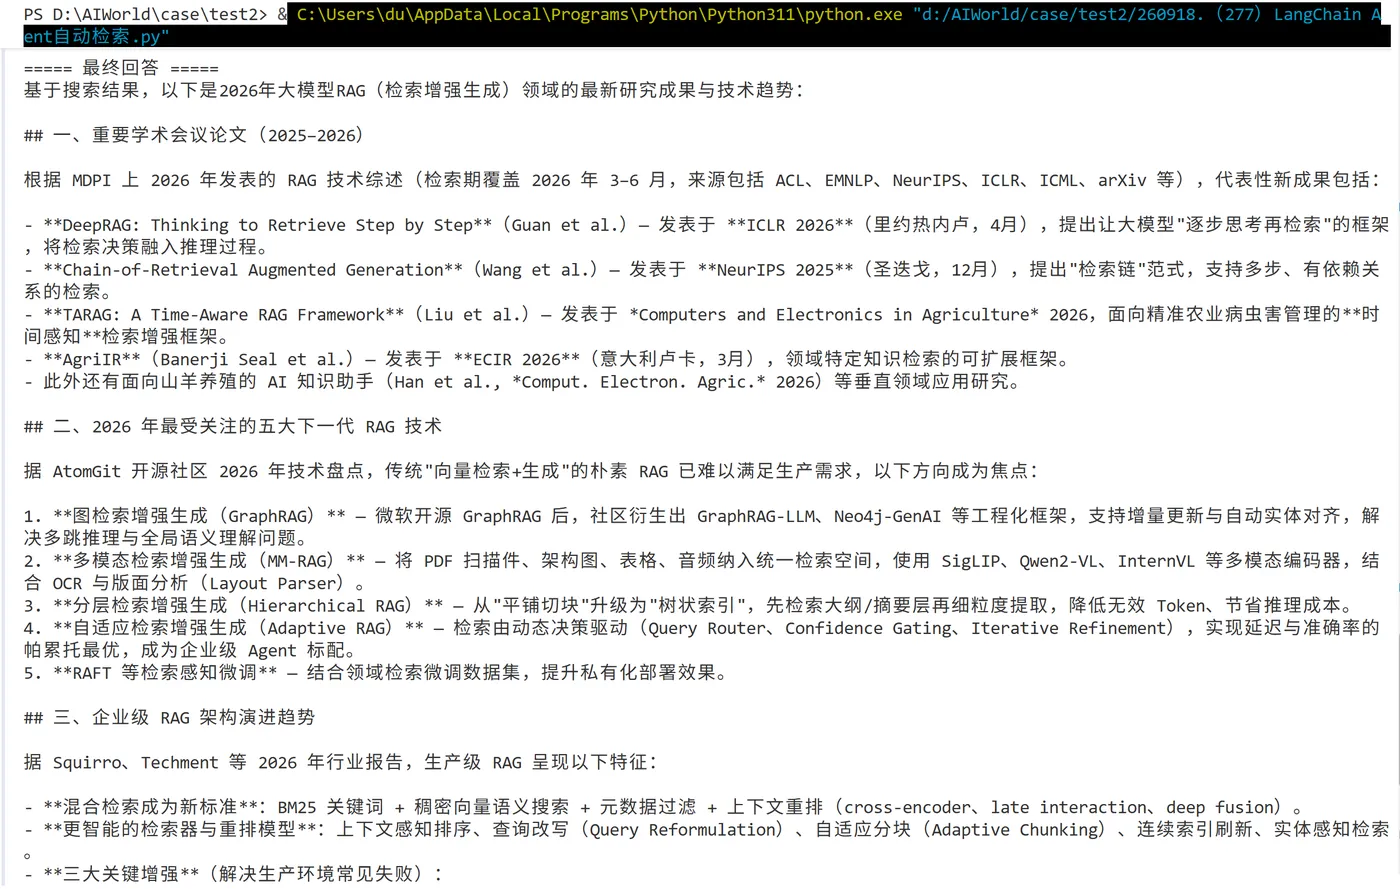
开启verbose模式后,可清晰看到Agent完整思考链路:首先判断问题具备时效性、超出模型固有知识范围,随后自动调用Tavily检索,获取权威结果后整理输出,全程自动化、无需人工干预。
2. LlamaIndex本地+联网混合检索
实际企业场景中,RAG需要同时兼顾本地私有知识库和外网公开知识,比如公司内部制度、私有数据查本地向量库,行业公开资讯、前沿技术查外网。LlamaIndex框架可快速实现双数据源混合检索。
# 安装依赖
# pip install llama-index llama-index-tools-tavily
from llama_index.core import VectorStoreIndex, Document
from llama_index.tools.tavily_reasoning.base import TavilyToolSpec
from llama_index.core.agent import FunctionCallingAgent
from llama_index.llms.openai import OpenAI
# 1. 构建本地私有知识库示例
local_docs = [Document(text="公司2026年出差报销制度:住宿上限500元/晚,交通实报实销")]
local_index = VectorStoreIndex.from_documents(local_docs)
local_query_engine = local_index.as_query_engine()
# 2. 初始化外网Tavily检索工具
tavily_tool = TavilyToolSpec(api_key=os.getenv("TAVILY_API_KEY")).to_tool_list()
# 3. 组装双数据源智能Agent
agent = FunctionCallingAgent.from_tools(
    [*tavily_tool, local_query_engine.as_tool()],
    llm=OpenAI(model="gpt-4o-mini"),
    verbose=True,
)
# 4. 混合场景测试:本地私有数据+外网公开数据
agent.chat("公司出差住宿标准是多少?对比2026年北京酒店均价水平如何?")

该Agent可自主拆分问题、匹配数据源:前半段本地制度问题调取私有向量库,后半段行业均价问题自动联网检索,完美适配企业混合知识场景,是商业化RAG项目的常用架构。
五. 中文私有化替代方案
1. SearXNG+Trafilatura应用
很多企业存在数据安全合规要求,禁止使用境外SaaS工具、禁止数据出内网,此时需要自建中文检索服务。最成熟的开源方案是“SearXNG搜索引擎+Trafilatura正文抽取”,完全私有化部署、零调用费用、支持多中文搜索引擎聚合。
# 安装依赖
# pip install searxng-python trafilatura requests
import requests
import trafilatura
# 本地SearXNG服务地址(Docker一键部署)
SEARXNG_URL = "http://localhost:8080/search"
def searx_search(query: str, num_results: int = 5):
    """聚合百度、必应、搜狗多源中文检索"""
    resp = requests.get(
        SEARXNG_URL,
        params={"q": query, "format": "json", "language": "zh"},
        timeout=10,
    )
    return resp.json().get("results", [])[:num_results]
def extract_text(url: str) -> str:
    """中文网页精准正文清洗"""
    downloaded = trafilatura.fetch_url(url)
    if not downloaded:
        return ""
    return trafilatura.extract(
        downloaded,
        include_links=False,
        include_images=False,
        favor_recall=True  # 适配中文长文本抽取
    ) or ""
def my_tavily_like_search(query: str):
    """自建迷你中文检索工具,复刻Tavily核心能力"""
    results = searx_search(query)
    for item in results:
        item["content"] = extract_text(item["url"])
    # 过滤空内容噪音
    return [r for r in results if r["content"]]
# 实战调用
for r in my_tavily_like_search("RAG大模型最新综述论文"):
    print(f"标题:{r['title']}\n链接:{r['url']}\n摘要:{r['content'][:200]}\n")

该方案核心优势:完全本地化、无第三方接口依赖、可自由切换中文搜索源,数据全程不出内网,满足国企、政务、金融等合规严格的场景。唯一代价是需要自行处理反爬、超时、结果去重等细节。
2. 开源中文Tavily完整骨架
想要完全复刻Tavily“query改写-检索-抽取-重排-打分”的完整链路,可以基于OpenWebSearch开源思路,搭配BGE重排模型,搭建专属中文检索框架,适配个性化业务需求。
from typing import List, Dict
class ChineseWebSearcher:
    """最小可运行中文联网检索骨架"""
    def __init__(self, llm_client, reranker):
        self.llm = llm_client       # 大模型用于查询改写
        self.reranker = reranker   # BGE重排模型用于结果打分
    def rewrite_query(self, user_question: str) -> List[str]:
        """将自然语言拆解为精准检索关键词"""
        prompt = f"将以下问题改写为3个适配搜索引擎的关键词组合:\n{user_question}"
        return self.llm.chat(prompt).split("\n")
    def rerank(self, query: str, docs: List[Dict]) -> List[Dict]:
        """基于BGE模型重排打分,过滤无效结果"""
        pairs = [(query, d["content"]) for d in docs]
        scores = self.reranker.compute_score(pairs)
        for d, s in zip(docs, scores):
            d["score"] = s
        return sorted(docs, key=lambda x: x["score"], reverse=True)
    def run(self, question: str, top_k: int = 5) -> List[Dict]:
        """完整检索链路执行"""
        queries = self.rewrite_query(question)
        all_docs = []
        # 多子查询并行检索
        for q in queries:
            all_docs.extend(self.search(q))
        # 结果去重
        seen = set()
        deduped_docs = []
        for doc in all_docs:
            if doc["url"] not in seen:
                seen.add(doc["url"])
                deduped_docs.append(doc)
        # 重排筛选
        return self.rerank(question, deduped_docs)[:top_k]

该骨架可自由对接搜索接口,搭配开源重排模型,完全实现自主可控的中文检索能力,适合深度定制化RAG项目开发。
六. RAG应用实践优化
1. 混合检索核心架构
生产环境中,单一的本地检索或联网检索都存在缺陷:纯本地检索知识滞后,纯联网检索成本高、速度慢。标准方案是本地向量库优先+联网搜索兜底的混合RAG架构,同时叠加缓存、降级、降噪策略,兼顾性能、成本、准确率。
import hashlib
import time
class HybridRAG:
    """生产级混合检索RAG架构"""
    def __init__(self, vector_store, search_client, score_threshold=0.7):
        self.vs = vector_store         # 本地私有向量库
        self.search = search_client    # 联网检索客户端
        self.threshold = score_threshold  # 本地匹配分数阈值
        self._cache = {}               # 内存缓存
    def _cache_key(self, q: str) -> str:
        """生成查询唯一缓存key"""
        return hashlib.md5(q.encode()).hexdigest()
    def retrieve(self, question: str):
        # 1. 优先读取缓存,减少重复调用
        key = self._cache_key(question)
        if key in self._cache and time.time() - self._cache[key][0] < 600:
            return self._cache[key][1]
        # 2. 优先检索本地私有知识库
        local_hits = self.vs.similarity_search_with_score(question, k=5)
        best_score = local_hits[0][1] if local_hits else 0
        context = []
        # 3. 本地匹配度足够,直接复用本地结果,节省联网成本
        if best_score >= self.threshold:
            context = [doc.page_content for doc, _ in local_hits]
        else:
            # 4. 本地知识不足,联网检索兜底
            web_hits = self.search.search(
                question, max_results=3, search_depth="advanced"
            )["results"]
            # 过滤低分噪音数据
            context = [h["content"] for h in web_hits if h["score"] >= 0.5]
            # 本地+外网内容互补,提升回答完整性
            context += [doc.page_content for doc, _ in local_hits[:2]]
        # 5. 写入缓存,10分钟有效期
        self._cache[key] = (time.time(), context)
        return context
# 架构调用示例
# hybrid = HybridRAG(vector_store=my_vector_db, search_client=TavilyClient(...))
# context = hybrid.retrieve("2026杭州购房政策变化")

2. 实践优化核心说明
阈值降级策略:
- 设置本地向量库匹配分数阈值,本地知识足够精准时,完全不调用外网搜索接口。
- 实测可减少60%以上的联网调用量,大幅降低API付费成本,同时提升响应速度。
缓存优化:
- 对10分钟内的重复查询做内存缓存,高频通用问题无需重复检索、重复计算,减少接口损耗;
- 提升用户体验,生产环境可替换为Redis实现持久化缓存。
低分过滤降噪:
- 强制过滤0.5分以下的检索结果,剔除低质、无关、虚假内容,从数据源层面减少模型幻觉,让RAG回答精度大幅提升。
3. 应用场景选型实践
- 如果是快速原型开发、个人demo、新手学习,优先选择Tavily SDK+LangChain Agent组合,30行代码即可搭建完整联网RAG,开发效率最高、无需复杂配置,快速验证业务想法。
- 如果是国企、政务、金融等合规严格场景,数据禁止出内网,采用SearXNG+Trafilatura自建私有化检索方案,完全本地化部署,满足数据安全要求。
- 如果是深度定制化、开源项目、自主可控需求,基于OpenWebSearch架构搭建专属中文检索框架,自由替换模块、自定义规则,适配个性化业务。
所有正式生产项目,统一搭配“本地向量库+外网检索”混合RAG架构,叠加缓存、降噪、降级策略,兼顾精度、速度、成本、稳定性。
七、总结
总的来说,RAG不是纸上谈兵的概念,而是一套可以逐层落地的工程方案。通常刚接触RAG,只知道本地文档向量检索,一碰到实时信息、时效性问题就卡壳,而联网检索正好补上这块短板,用来解决大模型知识滞后、容易幻觉两大痛点。
从Tavily基础调用、全参数实战,再到LangChain、LlamaIndex框架集成,实现Agent自动判断何时联网搜索。最有价值的是混合RAG工程方案,采用本地向量优先、联网搜索兜底的思路,搭配缓存、分数阈值过滤,既能省下大量搜索API费用,还能减少无效噪音,降低幻觉。做RAG除了盯着模型本身,还有检索质量、结果降噪、成本管控,往往才是项目能否稳定上线的关键。