
3 月 2 日,Databricks 发了一篇测评博客,标题起得毫不遮掩,Spark 流处理 API,不需要第二个引擎。
数字更直白。
92%,放在任何两个成熟引擎的对比里都是个夸张的数字。
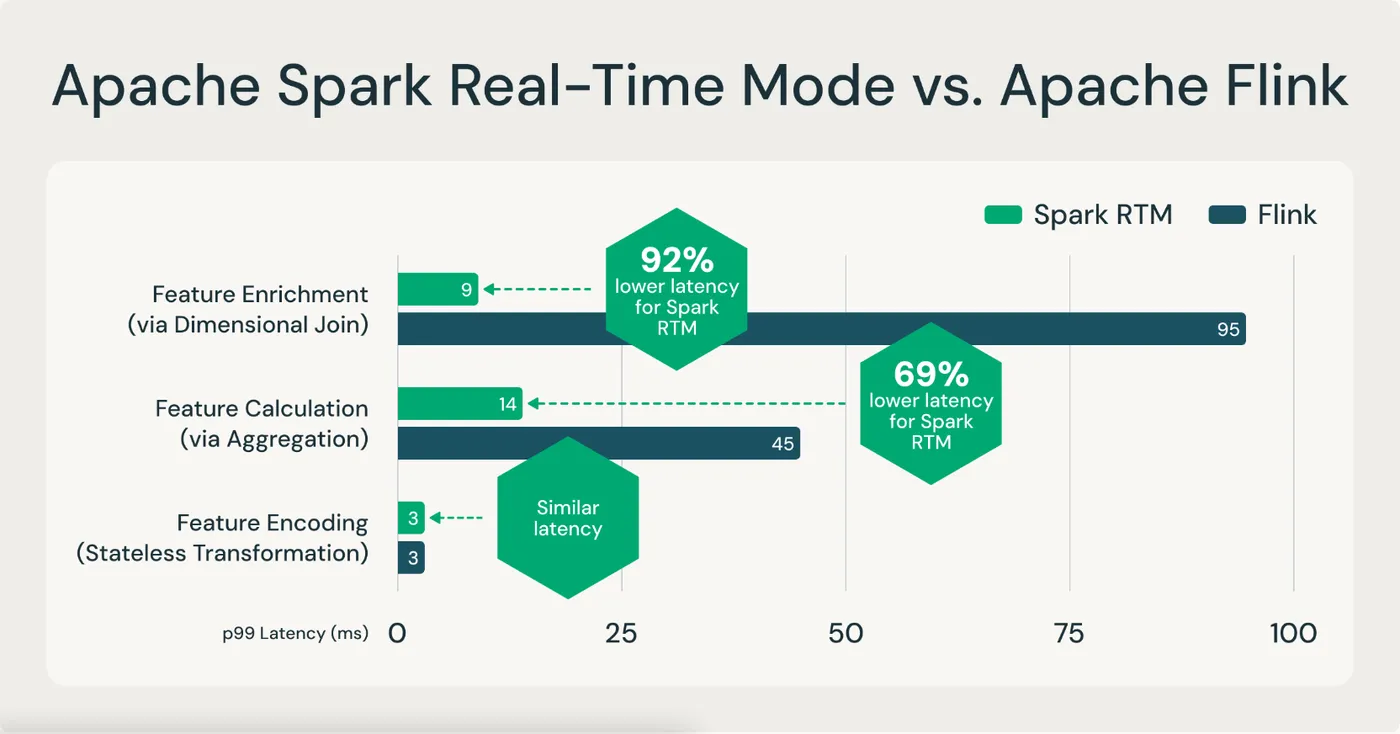
三个生产里最常见的实时特征计算场景,特征编码、特征 enrichment、特征聚合,Spark 的 Real-Time Mode 对比 Flink,最高快了 92%。
测的三个场景挑得很贼,都是生产里出镜率最高的特征计算活。
特征编码是无状态转换,数据进来改个格式就出去;特征 enrichment 是流和一张静态维表做 join;特征聚合是 GroupBy 加 Count 那一族。
这三个活有个共同点,单条逻辑简单、状态规模可控、对延迟极度敏感,正好是毫秒级架构最舒服的射程。
射程之外的,两大引擎自己会打招呼,轮不到看客着急。
金融风控、实时推荐、广告归因,全是这三类的变体。
Databricks 的说法是这三类代表了大多数低延迟 ETL 的样子,话不完全中听,但确实不好反驳。
为什么单引擎能快出这么多,从架构上猜,账在搬运那一层。
组合方案里数据要在两个系统之间倒手,每次倒手都是序列化、传输加一致性对账;单引擎内一路同样的内存格式到底,这几道税全免了。
再看一眼措辞,原话是 up to 92% faster,最高快 92%。
绝对值其实也画在了图里,p99 口径,join 场景 9 毫秒对 95 毫秒,聚合 14 毫秒对 45 毫秒,无状态转换两边都是 3 毫秒,快 92% 说的就是 join 这一档。
场景是 Databricks 挑的,数字是它自己跑的,这两点带着看,剩下的部分反而经得起抠。
我不怀疑 Databricks 造假的动机,但挑自己最顺的场景出数字,是所有厂商的肌肉记忆,Flink 阵营哪天反击,大概率也是这个打法。
厂商对比图的正确用法从来不是背结论,是把它的测试条件抄下来,换成自己的数据再跑一遍。
先把话说清楚,这是 Databricks 自己测的,数据集和查询全部开源在他们的 latency-benchmarks 仓库里,不服可以自己拉下来跑一遍。
仓库里数据集规模、查询写法都摊在明面上,想复测的人不用对着黑盒猜。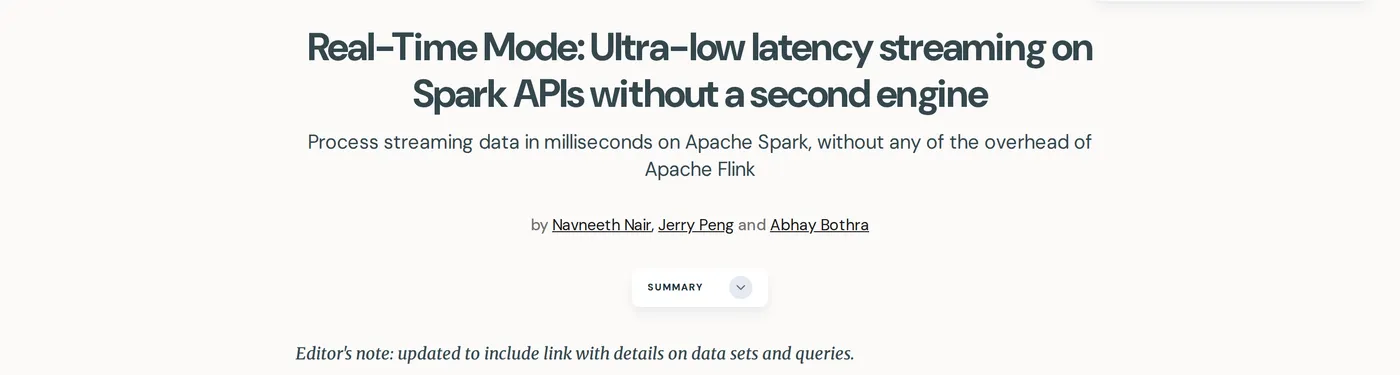
说道说道这个 Real-Time Mode 是什么。
官方名字缩写 RTM,实时模式,是 Structured Streaming 的一种新触发方式。
名字里的 Real-Time 别太较真,业界对实时的定义从秒级到毫秒级一直在漂,Databricks 这里指的是毫秒到亚秒这一档。
以前的 Spark 流处理是微批,数据攒一批处理一批,这个机制好控制,但延迟有个底,压到几百毫秒就很难再往下走了。
底在哪,攒批本身。
一个微批从启动到出结果要过五道门,攒数据、跑计划、调度任务、shuffle 落盘、提交状态,每一道门都有等待。
有人会问,把批配小一点不就快了。
配小可以,调度和提交的固定开销不跟着缩,批小到某个点,系统大部分算力花在开销上而不是数据上,这条路社区走了很多年,走到头了。
说句公道话,微批不是纯包袱,攒着批让优化器一次看清一大批数据的全貌,执行计划好做,吞吐效率高,这是它统治十年的本钱。
每一条数据都得等批次凑齐、等上一批跑完、等 shuffle 落盘再拉起来,一环一环全是等待。
这套机制的痛,运维过微批作业的人都懂。
RTM 把批打碎,数据逐条推着走,端到端延迟压进毫秒级,官方文档的说法是最低能到 5 毫秒左右。
毫秒这个数字对风控、推荐、反作弊这些场景不是锦上添花,是能不能上线的门槛。
顺便说一句,延迟不是白打下来的,逐条推的管道比攒批复杂得多,这也是为什么这套东西从 2025 年 8 月官宣到 4.3 转正,走了大半年。
慢工出的不只是细活,是转正的底气。
顺便说一句,超低延迟这条路 Spark 不是没试过,早年的 Continuous Processing 就是干这个的实验,卡在算子限制和语义取舍上一直没成气候。
RTM 换了个思路,不再追求教科书式的纯流模型,先把延迟打下来,语义和生态慢慢补。
微批和纯流之争吵了十年,本质是两种世界观,Spark 把流看成批的特例,Flink 把批看成流的特例,两边都活在自己最舒服的场景里,谁也没到过对方的主场赢一场。
RTM 是 Spark 第一次带着完整武装去打 Flink 的主场。
这玩意也不是凭空冒出来的。
2025 年 8 月 Databricks 官宣的 public preview,4.1 进开源版的时候还是挂着一身实验性标签的 API。
真正的转折在 4.3。
我把 4.3.0 的变更单翻了一遍,1101 个 JIRA 单里,流处理这条线给了 RTM 一整套转正礼包。
顺手报个数,1101 单里 SQL 组件占了 508 张,PySpark 116 张,Structured Streaming 挂了 57 张,流处理在这一版里的戏份不轻。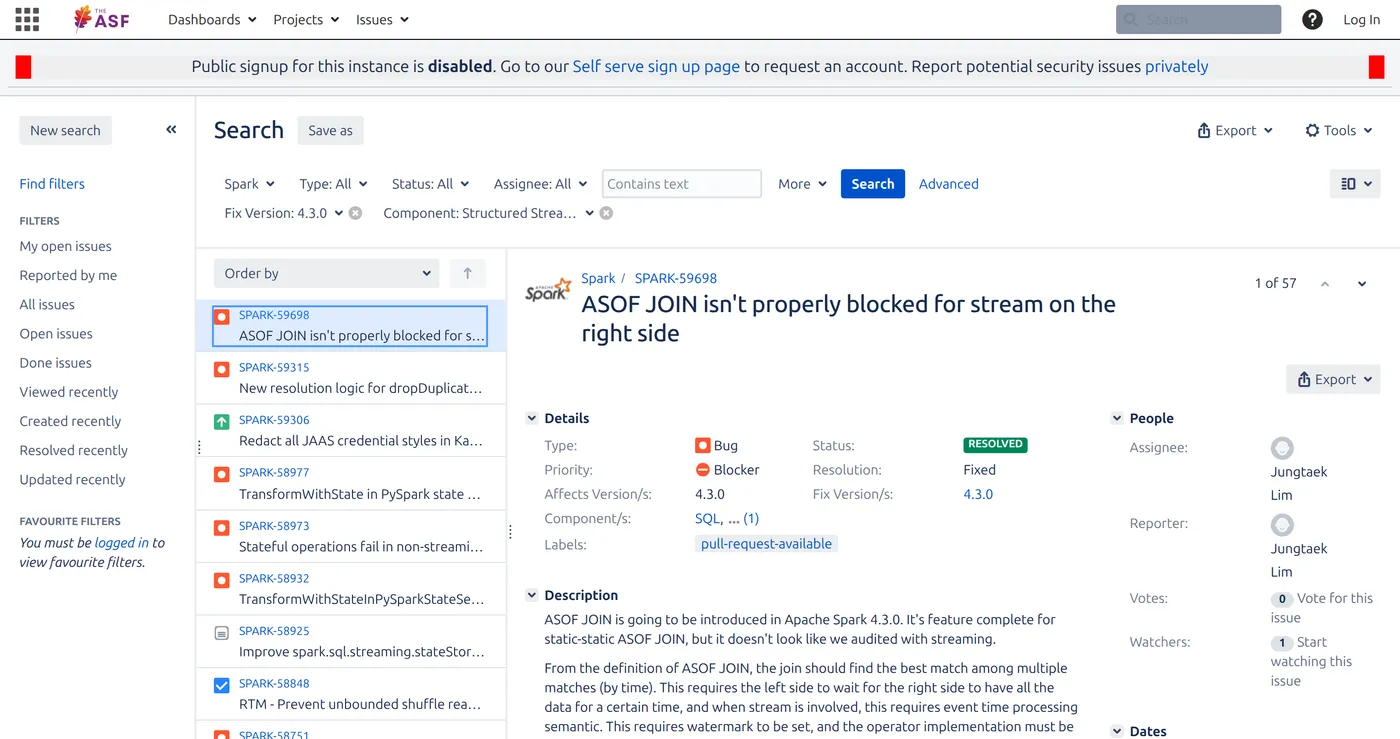
一张张翻下来,RTM 相关的单子几乎没有凑数的,从协议到文档到测试,是一条完整的产品线在收尾。
SPARK-57281,把 Real-time Mode 触发 API 上的实验性注解摘了,状态 RESOLVED,进 4.3.0。
API 承诺稳定性,这个动作等于官方宣布,RTM 不是玩具了。
配套动作是一整套的,有状态和无状态两份官方文档都写了,配置默认值定稿了,无状态模式的基准测试也补了。
这张单的父任务编号是 SPARK-53736,Real-time Mode 在 Structured Streaming 里的 Scala 无状态支持,从提案到转正,一整条线走得有头有尾。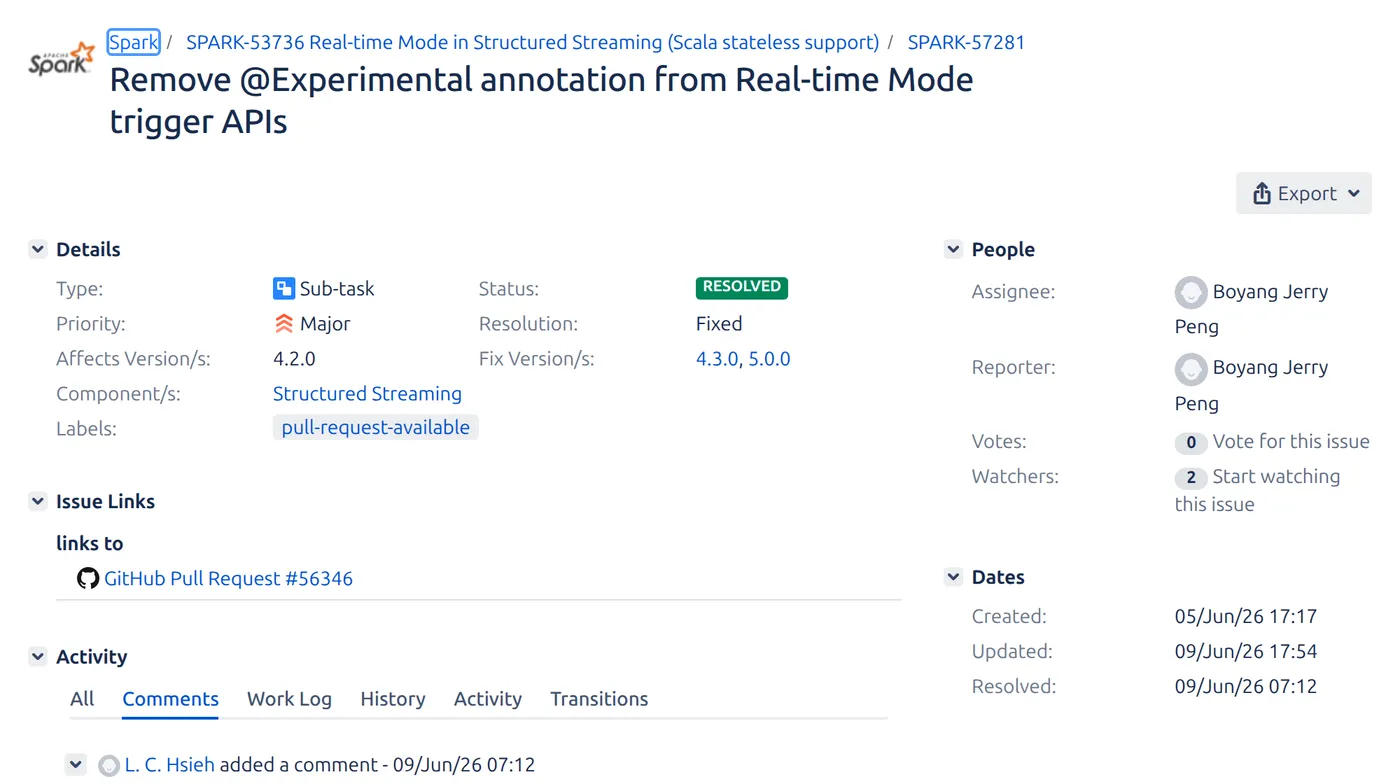
更狠的是有状态能力全补齐了。
SPARK-57228,transformWithState 进 RTM,这是 Spark 任意有状态处理的招牌算子。
对写代码的人最友好的一条,微批下写的有状态逻辑,理论上换个触发器就能跑,迁移的故事从重写变成了切换。
SPARK-58635,流式聚合进 RTM。
transformWithState 这算子本身是 4.0 才带来的新一代任意有状态处理,老 API 写起来痛苦得多,两代的差距很多人还没换过来,RTM 直接把新的这代拉进了毫秒档。
SPARK-58508,pipelined shuffle 激活,专门撑有状态查询。
三张单合起来看,RTM 从只能跑无状态查询的半成品,长出了任意有状态处理和流式聚合两颗牙。
最重的一块是新写的 StreamingShuffle,从传输协议到端到端测试一共七张单。
线上格式单独定协议,shuffle 管理器兼顾新旧两种模式,写端和读端各配了一套 Netty 处理器,连接用共享的传输层省开销,各分区进度有专门的输出跟踪器协调,最后端到端测试兜底。
PySpark 侧也没被丢下,修复单里出现了 state server 的字样,修的是守护进程误报崩溃和端口泄漏这类出生期的病。
连 shuffle reader 等连接等不到头的边角都有一张专门的收尾单。
为什么要重写,老 shuffle 是为批设计的,一批写完落盘、下一批再拉,批与批之间的等待它不在乎。
RTM 要逐条推,shuffle 就得跟着改成持续传输的流式管道,等不起一个批次的间隙。
还有一张容易被略过的单,异步进度跟踪。
把「记录我处理到哪了」从关键路径上挪出去,进度落盘失败之后的熔断逻辑也单独修了一张单。
低延迟系统最怕的局部变慢,多半就藏在同步的进度落盘里。
这类单子在 release notes 里最不起眼,在生产里最救命。
这种单子不出彩,但它是延迟数字能站住的前提。
从这批变更单倒推 RTM 的做法,大致能拼出一张图。
查询执行还是那套 Spark 引擎,触发器换成连续推进,批的边界被拆掉。
状态访问继续走 RocksDB,但加上了资源准入和写反压,防止低延迟把存储压垮。
shuffle 从批间落盘改成持续推流,专用的新通道管低延迟传输,进度记录异步化不挡主路径。
每一块单拎出来都是常规操作,拼在一起才是毫秒级的完整链路。
说明一句,这张拼图是我从变更单倒推的,官方还没放出 RTM 的开源设计文档,细节以 GA 后的文档为准。
毫秒级、有状态、专用 shuffle,这三样拼在一起,Spark 流处理的面目全变了。
这已经不是给微批打补丁的量级,是把流处理的底层管道换了一轮。
Databricks 在博客里有句话,原话是「we have removed the need for a second system」。
翻译过来,以前低延迟场景的标准架构是两套引擎并存,Spark 管批,Flink 管实时,现在第二套可以撤了。
人家图都没藏着,副标题写的就是 without any of the overhead of Apache Flink。
截图就贴在这,这句不是我转述的劲,是它自己写的。
第二引擎这件事的由来要往前数很多年,微批的延迟底加上实时场景的硬需求,行业默认了一慢一快两套引擎并存的架构,代价是两份运维、两套监控、一条总对不齐的数据链。
Databricks 打的正是这笔账。
为什么挑这个时间点出手,说说我的看法。
实时特征计算是 AI 应用头顶的水龙头,这块市场以前默认归 Flink,Databricks 卖云平台,多一个引擎就多一份运维摩擦和销售阻力。
把 RTM 做进 Spark 统一引擎,对客户是少养一套系统,对它是把流计算的预算收回自家平台。
开源同步推进是它的社区打法,先在开源站住,产品化顺理成章,这套打法它用过很多次。
开源进度也决定这场仗的成色,自家产品再快,社区只认开源版的 GA 和文档,这也是为什么 4.3 变更单里每一张转正单,都比博客里的数字更值得盯。
Flink 党先别急着骂,你们的理由我全都认。
十几年的生产验证,exactly-once 语义打磨到牙齿,事件时间语义是教科书级的,这些不是 Spark 发两篇博客能追平的。
而且 92% 这个数字要看清楚测试范围,三个特征计算场景是 Databricks 挑的,大状态作业、复杂窗口、端到端 exactly-once 这些 Flink 的腹地,博客一个字没测。
没测不等于不能测,等于还没轮到,这是两张不同的判决书。
这些没测的地方,恰好大半是 Flink 的家底。
checkpoint 机制打磨了十年,两阶段提交把 exactly-once 送达做成了默认承诺,事件时间和 watermark 的语义是教科书级的地基,RocksDB 后端扛着 TB 级状态跑了无数生产作业,SQL、CEP、PyFlink 的生态各有各的用户。
这些不是发两篇博客能追平的东西,是时间垒起来的护城河。
站在 Flink 用户的角度,这场仗还送了个意外收获,以前选 Flink 要自己论证为什么不用 Spark 批,现在轮到 Spark 论证为什么可以不用 Flink,攻守之势的日常体感完全不同。
Flink 身后还站着几家深度投入的大厂和一整个生态,反击不会缺弹药。
他们手里最大的牌叫生产惯性,没人会因为一篇博客,去重写一条跑得好好的管道。
开源版的 4.3 还在 RC 阶段,RTM 在开源侧的真实成色,得等 GA 之后拿真作业验证。
还有一层距离要自己量,Databricks 的博客通篇在讲自家产品的能力,OSS 版 4.3 里 RTM 的完成度、参数面、文档齐整度,得等 GA 后拿源码和文档对一遍才知道。
调优经验也要从零攒,社区里关于 RTM 的生产排障贴现在几乎搜不到,出了问题,答案只能自己蹚。
时间线也值得盯一眼,rc1 已经躺了二十多天没见到 rc2,GA 不是明天的事。
Databricks 的 92% 和开源用户手里的 92% 之间,还隔着这段距离。
变更单里还散着一层质量活。
dropDuplicates 的状态清理改成了增量式,去重键的解析收敛到统一规则,有状态算子的输出和状态 schema 强制校验空性,RocksDB 快照加载失败时报出可用版本号。
单看每张都不大,堆在一起是同一种味道,给转正护航。
Databricks 在广告归因的场景里给了自己的实测口径,RTM 配上 transformWithState 做有状态的归因管道,P99 延迟依 workload 不同,从个位数毫秒到三百毫秒上下。
区间跨度这么大,是负载轻重不同使然,这个规律放在哪台引擎上都成立。
这篇博客的柱状图里还有一组更直观的对照,同一个广告归因作业,RTM 平均 144 毫秒、P99 202 毫秒,微批模式平均 2,479 毫秒、P99 8,174 毫秒,P99 差了 40 倍。
注意这组对比的对象是微批,不是 Flink,它说明的是另一件事,留在微批上的理由,已经撑不住延迟诉求了。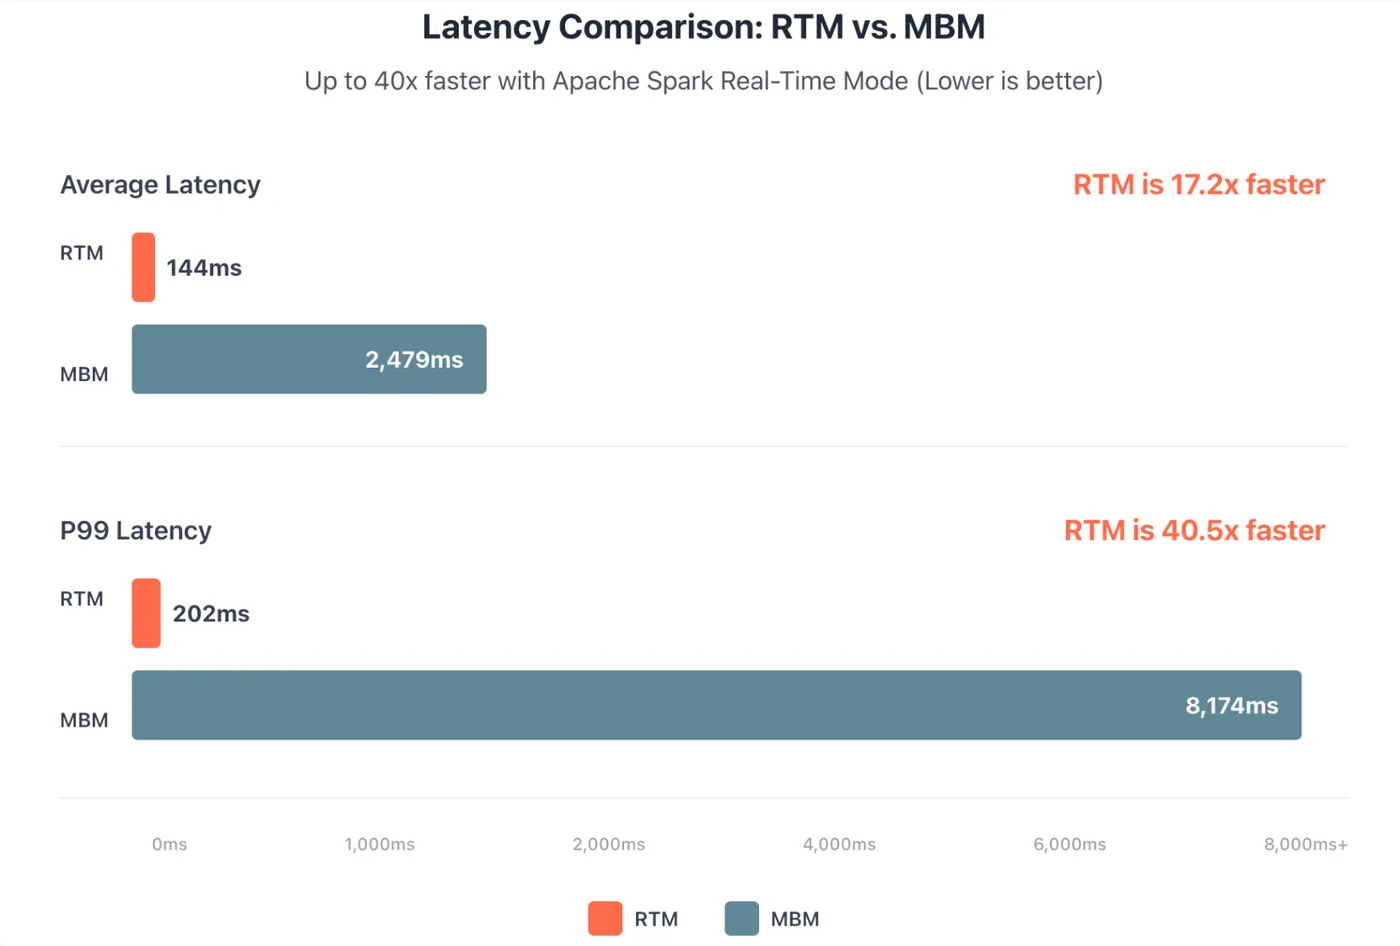
博客里还引了个客户案例,DraftKings,做欺诈检测的,原话是这类系统对速度的要求极端到没边,换了 RTM 之后更新能在两百毫秒内到位。
客户案例听一半就行,但方向和前两个信号是一致的。
厂商的案例集从来只放赢的,这不妨碍它证明一件事,这类架构在生产里已经跑起来了。
但我还是觉得,选型的天平动了。
动的幅度不算大,方向很明确。
广告归因、实时特征、风控指标这类活, join 一张维表、聚合几个指标再写出去,以前的标准答案是再养一个 Flink 集群外加一支会养 Flink 的团队。
现在这题变成,还有什么理由必须用 Flink。
落到动作上,我分三类说。
纯 Spark 栈的团队,等 4.3 GA 就行,API 是你们已经会的,换个触发器就能试,试错成本约等于零。
已经在用 Flink 而且跑得稳的,别动,跑得好好的系统不值得为一张对比图搬家,但新需求立项的时候,把两边都放进算账表。
搬家的成本从来不是 API 那一层,是部署、升级、监控和人才的一整圈。
正要上低延迟场景的新项目,两个都做 POC,用自己真实的 workload,别信任何人包括我的判断。
过去十年大家用 Lambda、Kappa 这些架构在批和流之间来回找平衡,每多一套架构就多一倍对账的活,低延迟统一引擎是这个行业憋了很久的愿望。
顺着这个思路再想一步,下一个被统一的,就是消息队列和计算引擎之间那条搬运通道。
后面盯三个信号就够了,4.3 正式版什么时候 GA,GA 之后官方文档里 RTM 章节的完整度,第一波跑大状态作业的公开实测有没有人放出来。
三个信号凑齐之前,所有结论都是半成品,包括这篇。
包括标题里那句流计算要变天,也是半成品。
半成品不丢人,写下来就是为了等数据来修。
这个转变对围着 Spark 转的团队是好消息,对 Flink 阵营,是一次打到家门口的进攻。
这一仗最狠的地方不是 92% 这个数字,是 Spark 把「低延迟必须第二引擎」这个默认假设拆了。
假设一拆,后面全是连锁反应。
Flink 不会死,远不会。
十年里攒下的家底,够它体面地打很多年。
但低延迟这三个字,从此不再是它独占的招牌。
变天不是说 Flink 明天就没人用,是说选型的默认答案开始松动,默认答案一松,往后每年的份额都会重新分一次。
十年前 Spark 干过同样的事,把 MapReduce 送进了教科书。
历史不重复,但会押韵。
祝大家,流式愉快。


