
Paimon 做了一件别的湖格式不太敢做的事,它把 RocksDB 那套 LSM 树整个搬进了湖里。
湖仓格式都绕不开同一道难题,数据文件落盘就不能改,可业务天天在改。
Iceberg 的答案是治理和写拆开,重写文件是一套班子,记删除是另一套,想跑得你自己排班。
Delta 的答案是三段分管,写时攒一波,写后小合,离线大合,每段各付各的账。
Paimon 谁的路线都没抄,它回头看了眼单机存储的老祖宗,把 update 和 delete 直接焊进了写路径。
这篇拆的就是这笔账,把 LSM 搬进湖里,得的到底是什么,失的又藏在哪。
先看 LSM 树在 Paimon 里长什么样。
有主键的表,每个 bucket 底下是一棵独立的 LSM 树,官方文档把 bucket 称作读写的最小存储单元,桶数一划,并行度的天花板就定了。
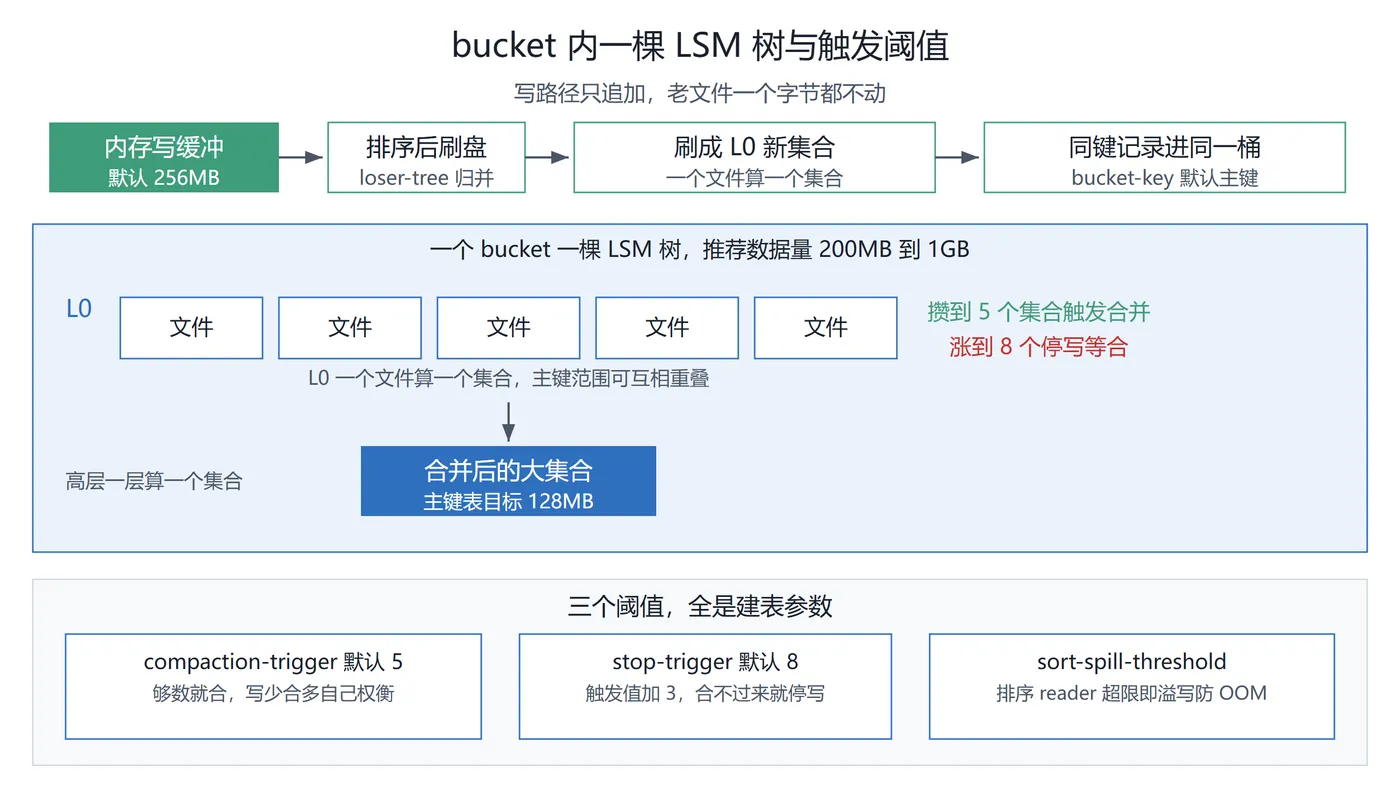
树的入口是内存写缓冲,默认 256 MB,攒满就整体排一次序,刷成一到多个文件。
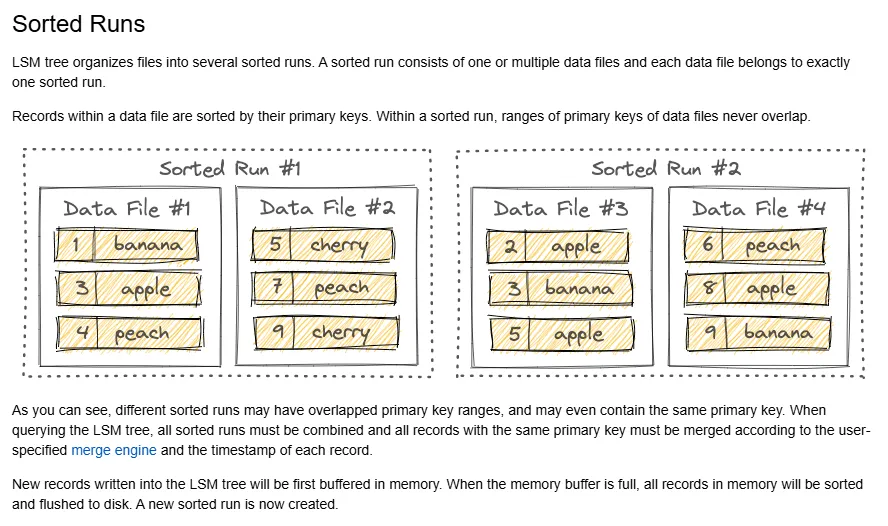
这批文件组成一个新的有序集合,文档叫它 sorted run,一个集合一到多个文件,每个文件只属于一个集合。
集合内部,文件按主键排序,主键范围互不重叠,集合和集合之间就随便叠了,同一个键活在几个集合里都算正常。
读的麻烦正出在这,查询必须把所有集合合在一起看,同一个主键按 merge engine 和时间戳当场决出胜负,主键表的 merge engine 默认 deduplicate,翻译过来就是留下最新那条。
集合一多,这场合并贵到离谱,compaction 那页的原话是查询性能变差,甚至直接把内存读爆。
管这件事的机制叫 compaction,把几个小有序集合成一个大的,策略文档点名牌,跟 RocksDB 的 universal compaction 类似,一套单机存储的老方子,搬进湖仓接着用。
得的头一笔,是写路径变成纯追加。
新记录进内存排序落盘,老文件一个字节都不动,磁盘看见的全是顺序写,写吞吐怎么都掉不下去。
桶内还能再省一道,bucket-key 默认就用主键,同键记录落进同一个桶,写初始化要啃的历史文件也就有界。
第二笔,读永远有界。
集合数量被 compaction 盯着,读端要合并的份数就有上限,写入量再涨,读延迟也不会跟着无限漂移,这对流式表是要命的优点。
层数也能定,num-levels 一配,整棵树的层数就钉死了,L0 永远是最年轻那层,compaction.force-up-level-0 一开,候选集合里永远带上 L0,合得更勤也换得更狠。
连元数据清单都搭了便车,manifest 自己也有全量合阈值,阈值默认 16 MB,超过就合,规划查询时啃的清单也跟着瘦身。
第三笔最漂亮,一次 compaction 同时干三份活。
compaction 那页列了它解决的四件事,减 L0 文件,产 changelog,产删除向量,管各种过期,changelog 是流读端要的增量,删除向量是行级删除的账,一份算力三处开花。
多路归并的排序引擎默认是 loser-tree,文档说它比堆排序比较次数少,合得越多,这笔细账省得越明显。
changelog 也不是白捡的,producer 有四种摘法,默认 none 不产,input 在刷内存时双写一份,full-compaction 靠全量合产出,lookup 在提交前查一次 LSM 补出来,四种摘法对应四种写开销,要哪口增量自己点。
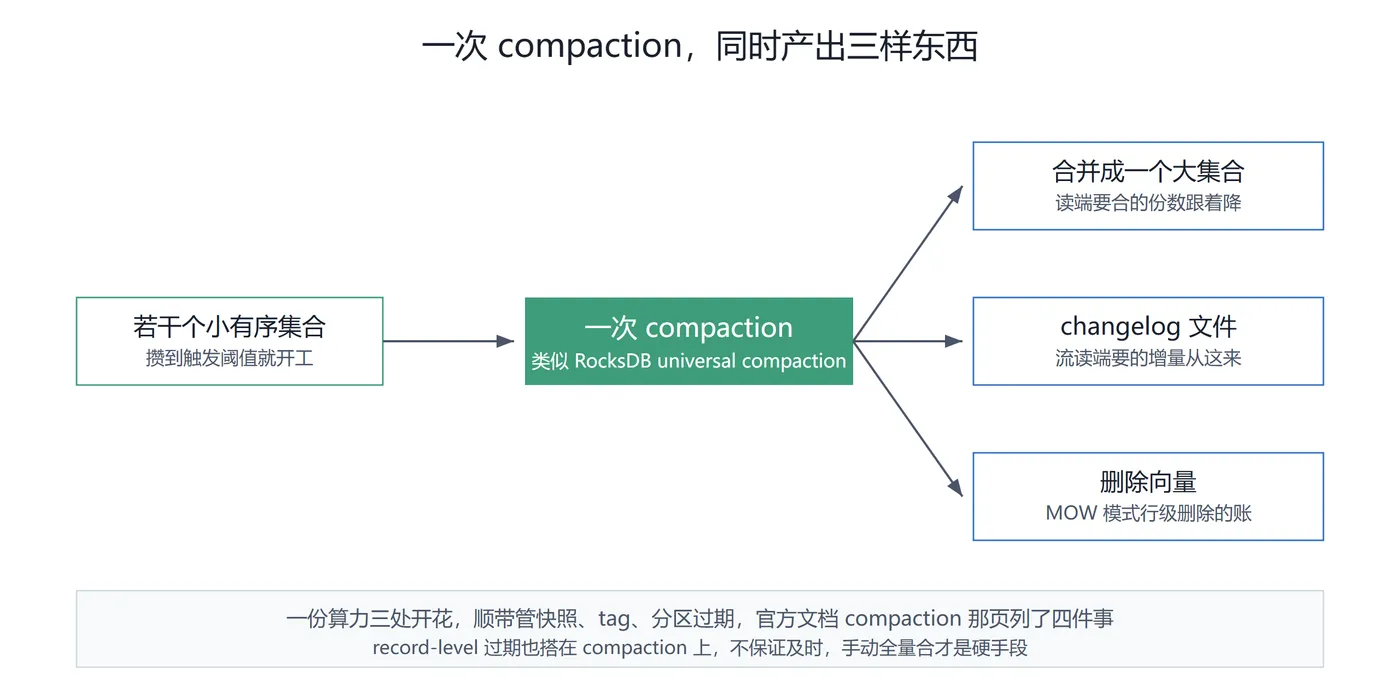
第四笔在 MOW 模式上,开了删除向量的主键表,写的时候顺手查一次 LSM,生成删除向量文件,读的时候按向量过滤,等于把合并提前做完,读性能一点不伤,文档把它定成主键表的推荐默认。
失的头一笔,是写快不长久,一半看合。
文档有句原话很扎心,写性能几乎总被 compaction 影响,所以调它至关重要,合并吃的是 CPU 和磁盘 IO,花的全是写线程自己的预算。
高峰期写抖一下,根子多半就在这,后台线程正合得欢。
第二笔,阈值的负担全压在调参上。
默认攒到 5 个集合触发一次合并,注意 L0 是一个文件算一个集合,高层是一层算一个集合,涨到 8 个停止写入,这个 8 是触发值加 3 推出来的。
想把高峰的写彻底放开,文档给了激进配方,停止阈值拉到 int 上限,溢写阈值给 10,再把 lookup 等待关掉,高峰多攒文件,低峰再慢慢合。
代价文档也摆明了,停止阈值越大写越顺,读的时候吃内存和 CPU 越多,怕 OOM 还有个 sort-spill-threshold 兜底。
目标文件大小也不是无脑大,主键表默认 128 MB,append 表 256 MB,而写缓冲已经 256 MB 了,这两个数是一根绳上的两头,缓存给大了落盘集合就少,合的压力跟着小。
第三笔,读侧的税默认模式下交得不少。
MOR 是主键表的默认模式,只做小合并,读的时候所有文件多路归并,一棵树还只能单线程读,读并行直接受限。
更坑的是非主键列,文档明说不能拿它做数据跳过,一跳过新数据就没了,读出来的是旧数据,错得静悄悄。
每桶 200MB 到 1GB 的推荐区间,本质是拿桶数换读并发,桶小了小文件淹过来,桶大了单树读不动。
嫌读得慢还有折中,配一个定期全量合间隔,再从 read-optimized 系统表查,要的快,还是旧一点的数,自己挑。
第四笔,每条捷径都有价。
想读最好就走 COW,每次写全量合并,文档自己评的写性能 very bad,写放大吓人。
想读写都凑合就走 MOW,可 L0 文件要 compaction 之后才可见,异步一开,新鲜度就打折。
想全量合省心,full-compaction.delta-commits 只能同步跑,桶少的时候能把 Flink 的 checkpoint 熬到超时,那道默认线是 10 分钟。
record-level 过期也搭在 compaction 上,文档直说不保证及时,真要卡死过期时点,手动全量合才是硬手段。
多写几个作业也有限制,同一个分区同时只许一个 compaction 作业干活,另一个直接报错,这是文档写的硬规矩。
连文件格式都留着后门,真要把 compaction 性能榨到极致,可以把 L0 L1 两层的格式换成 AVRO 行存,代价是分析查询变慢、压缩率下降,这笔账文档自己都说清是 tradeoff。
出路还是有的,官方留好了门。
写侧嫌合得碍事,write-only 一开,compaction 和快照过期全跳过,另起专职作业去合,写侧从此不暂停,多写者冲突也不再发生。
专职作业现成,Flink SQL 一句 sys.compact,或者 action jar 一个 compact,流模式持续盯着按需合,批模式一把全合,连历史分区都有专门伺候的,partition_idle_time 一配,闲着没人写的分区直接全量合一遍,小文件连根清。
所以 Paimon 这笔账的本质,是把治理从排班表里拽出来,焊死在了写路径上。
Iceberg 的账是算力和排班你付,Delta 的账是三处开关各付各的,Paimon 的账建表那天一次签清,阈值、目标大小、写合比例全在参数里,事后每动一次都是改合同。
我的判断很简单,流式不停、主键更新密的那类表,用 Paimon 是划算的,写入不停,治理就不能停,停下来攒的就是读延迟。
批量定点写、读优先的形态,手动挡和分段刀更省心,犯不上把每次写都绑进一台合并不休的发动机里。
这几页文档我来回翻了三遍,最值得存的是三个位置,有序集合和写缓冲在 primary-key-table 的 overview 页,触发和停写阈值在 configurations 页那两行,三种模式的代价评级在 table-mode 页,配着这篇看正好。
祝大家,写不抖,读不爆。

