GREEN是最健康的状态,说明所有的分片包括副本都可用。
集群状态为什么会异常?
想知道这个,我们首先需要了解一下集群的几种状态。
Elasticsearch 集群健康状态分为三种:
- GREEN
- YELLOW
- RED
GREEN是最健康的状态,说明所有的分片包括副本都可用。这种情况Elasticsearch集群所有的主分片和副本分片都已分配,Elasticsearch集群是100%可用的。
那么,集群状态在什么情况下发生RED和YELLOW呢?
YELLOW:主分片可用,但是副本分片不可用。这种情况Elasticsearch集群所有的主分片已经分配了,但至少还有一个副本是未分配的。不会有数据丢失,所以搜索结果依然是完整的。不过,集群高可用性在某种程度上会被弱化。可以把yellow想象成一个需要关注的warnning,该情况不影响索引读写,一般会自动恢复。
RED:存在不可用的主分片。此时执行查询虽然部分数据仍然可以查到,但实际上已经影响到索引读写,需要重点关注。这种情况Elasticsearch集群至少一个主分片(以及它的全部副本)都在缺失中。这意味着索引已缺少数据,搜索只能返回部分数据,而分配到这个分片上的请求都返回异常。
查看集群状态
使用kibana开发工具,查看集群状态:
GET /_cluster/health
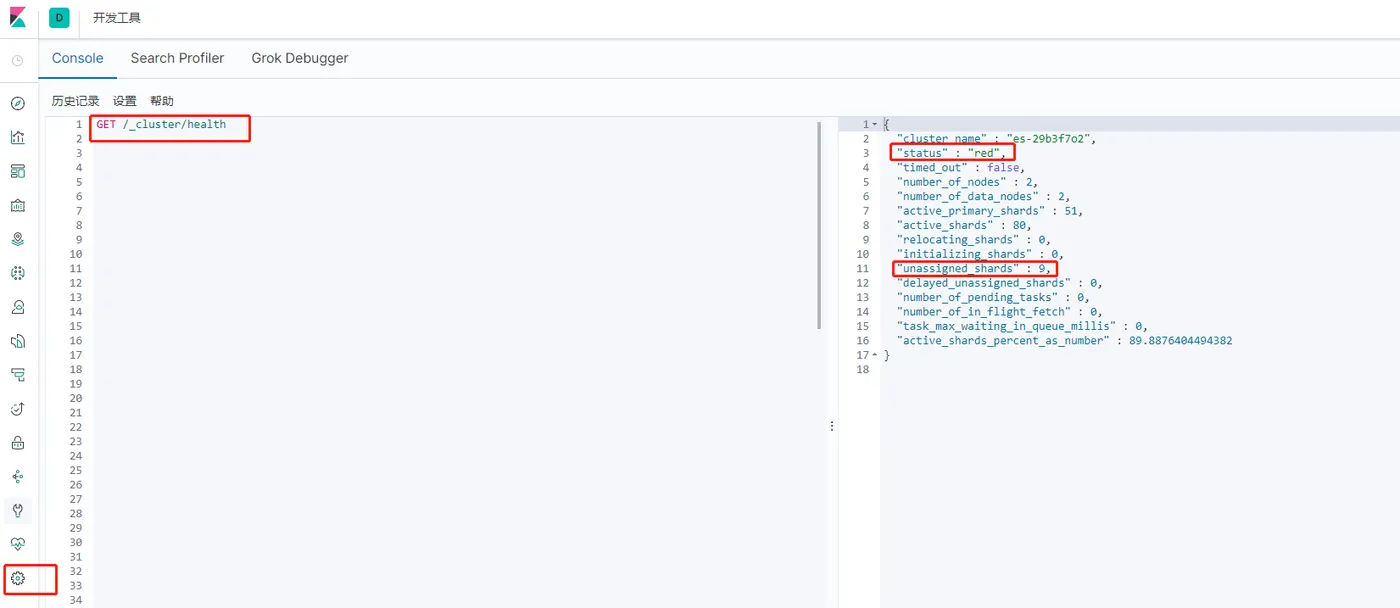
这里可以看到,当前集群状态为red,有9个未分配的分片
ES健康接口返回内容官方解释
| 指标 | 含义 |
|---|---|
| cluster_name | 集群的名称 |
| status | 集群的运行状况,基于其主要和副本分片的状态。状态为:– green所有分片均已分配。– yellow所有主分片均已分配,但未分配一个或多个副本分片。如果群集中的某个节点发生故障,则在修复该节点之前,某些数据可能不可用。– red未分配一个或多个主分片,因此某些数据不可用。在集群启动期间,这可能会短暂发生,因为已分配了主要分片。 |
| timed_out | 如果false响应在timeout参数指定的时间段内返回(30s默认情况下) |
| number_of_nodes | 集群中的节点数 |
| number_of_data_nodes | 作为专用数据节点的节点数 |
| active_primary_shards | 活动主分区的数量 |
| active_shards | 活动主分区和副本分区的总数 |
| relocating_shards | 正在重定位的分片的数量 |
| initializing_shards | 正在初始化的分片数 |
| unassigned_shards | 未分配的分片数 |
| delayed_unassigned_shards | 其分配因超时设置而延迟的分片数 |
| number_of_pending_tasks | 尚未执行的集群级别更改的数量 |
| number_of_in_flight_fetch | 未完成的访存数量 |
| task_max_waiting_in_queue_millis | 自最早的初始化任务等待执行以来的时间(以毫秒为单位) |
| active_shards_percent_as_number | 群集中活动碎片的比率,以百分比表示 |
问题分析
当集群状态异常时,需要重点关注unassigned_shards没有正常分配的分片,这里举例说明其中一种场景。
找到异常索引
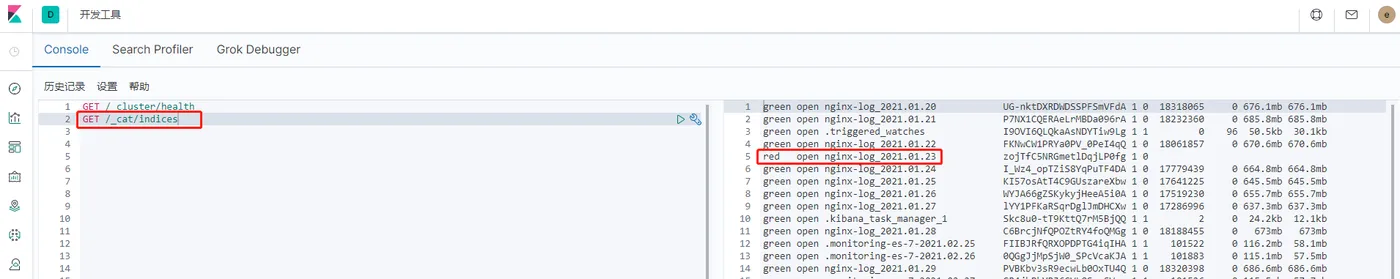
查看索引情况,并根据返回找到状态异常的索引
GET /_cat/indices
查看详细的异常信息
GET /_cluster/allocation/explain
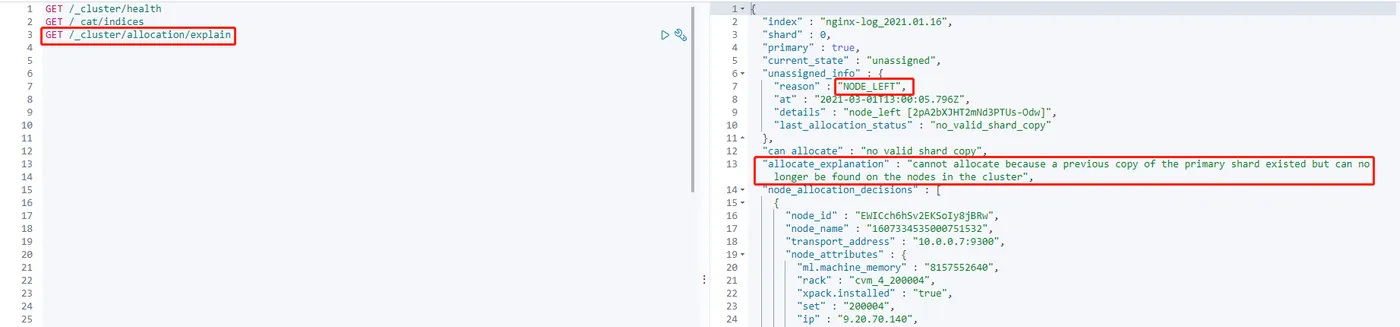
这里通过异常信息可以看出:
- 主分片当前处于未分配状态(
current_state),发生这个问题的原因是因为分配了该分片的节点已从集群中离开(unassigned_info.reason); - 发生了上诉问题之后,分片无法自动分配分片的原因是集群中没有该分片的可用副本(
can_allocate); - 同时也给出了更详细的信息(
allocate_explanation)
这种情况发生的原因是因为集群有节点下线,导致主分片已没有任何可用的分片数据,当前唯一能做的事就是等待节点恢复并重新加入集群。
注:某些极端场景,比如单副本集群的分片发生了损坏,或是文件系统故障导致该节点被永久移除,而此时只能接受数据丢失的事实,并通过reroute commends来重新分配空的主分片。
分片未分配(unassigned_info.reason)的所有可能
| reason | 原因 |
|---|---|
| INDEX_CREATED | 索引创建,由于API创建索引而未分配的 |
| CLUSTER_RECOVERED | 集群恢复,由于整个集群恢复而未分配 |
| INDEX_REOPENED | 索引重新打开 |
| DANGLING_INDEX_IMPORTED | 导入危险的索引 |
| NEW_INDEX_RESTORED | 重新恢复一个新索引 |
| EXISTING_INDEX_RESTORED | 重新恢复一个已关闭的索引 |
| REPLICA_ADDED | 添加副本 |
| ALLOCATION_FAILED | 分配分片失败 |
| NODE_LEFT | 集群中节点丢失 |
| REROUTE_CANCELLED | reroute命令取消 |
| REINITIALIZED | 重新初始化 |
| REALLOCATED_REPLICA | 重新分配副本 |
可以通过上诉分析方式初步判断集群产生未分配分片的原因,一般都可以在allocation explain api中得到想要的答案。
小结
可见,集群状态和分片是否分配有直接关系。所以遇到集群状态异常时,直接分析分片没有分配的原因即可,对症下药,从根本解决问题。