实时计算 Flink版产品使用问题之处理Kafka数据顺序时,怎么确保事件的顺序性

简介: 实时计算Flink版作为一种强大的流处理和批处理统一的计算框架,广泛应用于各种需要实时数据处理和分析的场景。实时计算Flink版通常结合SQL接口、DataStream API、以及与上下游数据源和存储系统的丰富连接器,提供了一套全面的解决方案,以应对各种实时计算需求。其低延迟、高吞吐、容错性强的特点,使其成为众多企业和组织实时数据处理首选的技术平台。以下是实时计算Flink版的一些典型使用合集。

问题一:Flink CDC里从kafka消费的时候顺序会乱,这时候就无法区分顺序了,这种情况有办法处理吗?

Flink CDC里从kafka消费的时候顺序会乱,这时候就无法区分顺序了,这种情况有办法处理吗?flink开窗排序可以解决,但遇到两个操作时间在同一时刻的咋办呢,有其它字段可以作标识区分吗?flink cdc到kafka是顺序的,但如果其中一条消息出现失败后重试,不会出现顺序问题嘛?如果从savepoint来重启,可能还会有重复数据吧,这时下游应该要去重取最新的offset吧?


参考答案:

我是flink的重启机制是no restart,发送失败不进行重试就只能充save point重来。在一个flink stream的window内,同一个表同一个id的数据,自己写逻辑合并,这样同一个id的消息就只有一条。下游消费重复数据,还是顺序消费的,最终数据一致。


关于本问题的更多回答可点击进行查看:

https://developer.aliyun.com/ask/599290


问题二:Flink CDC里同一条记录短时间i,d,u,cdc到kafka是有序的,之后乱序怎么解决?

Flink CDC里同一条记录短时间i,d,u,cdc到kafka是有序的,但从kafka消费时候会乱序。这个我也遇到目前只是设置kafka分区数为1或者放入kafka时候按记录主键分区解决。看资料说用flink水印来解决乱序问题,但我没测成功,有没有人玩过这种解决方式呢?


参考答案:

我们是按记录主键分区。


关于本问题的更多回答可点击进行查看:

https://developer.aliyun.com/ask/599289


问题三:Flink cdc整库同步的时候,有状态过期时间吗?

Flink cdc整库同步的时候,有状态过期时间吗?


参考答案:

Flink CDC在进行整库同步时,本身没有状态过期时间的设定。状态过期时间通常是指数据在系统中保留的时间长度,超过这个时间的数据将被认为过期并可能被清除。

在Flink CDC中,状态的维护主要与checkpoint和savepoint机制有关,这些机制用于保证作业的状态一致性和容错性。Flink CDC通过捕获源数据库的变更日志(如MySQL的binlog)来实现数据的实时同步,而这些变更日志的保留时间通常由源数据库的配置决定。

此外,Flink CDC支持两种模式:日志型和查询型。日志型模式依赖于数据库的日志(如binlog),而查询型模式则通过执行查询来获取变更数据。在使用日志型模式时,如果源数据库的日志保留时间设置得过短,可能会导致Flink CDC作业无法处理已经过期的日志文件。因此,为了避免这种情况,可以在源数据库中增加binlog的保留时间,例如设置为保留7天。

综上所述,Flink CDC整库同步时的状态维护主要依赖于源数据库的日志保留策略和Flink自身的checkpoint机制。为了确保数据不会因为日志过期而丢失,需要合理配置源数据库的日志保留时间。


关于本问题的更多回答可点击进行查看:

https://developer.aliyun.com/ask/599288


问题四:Flink CDC里mysql-cdc同步到kafka中,对同一条数据多次操作,怎么区分先后?

Flink CDC里mysql-cdc同步到kafka中,对同一条数据多次操作,op_ts字段可能会一样,如何区分先后顺序呢?同一条数据在短时间内有i、d、u操作,操作时间读取过来也是同一个,这咋区分哪个前哪个后呢?


参考答案:

我是自己解析之后按照主键分区,顺便合并同一个id的数据。cdc解析出来的数据本来就是顺序的,不需要根据操作时间判断先后。


关于本问题的更多回答可点击进行查看:

https://developer.aliyun.com/ask/599287


问题五:Flink CDC3.0 有使用的嘛?

Flink CDC3.0 有使用的嘛? 同步starrocks 不支持的字段类型,发生failover后,任务会一直卡住也不失败是什么情况?


参考答案:

Flink CDC 3.0版本确实有用户使用,并且它支持实时同步MySQL数据至StarRocks。

关于任务在发生failover后卡住的情况,这可能与多种因素有关,包括但不限于以下几点:

  1. 任务配置问题:检查任务的配置是否正确,特别是与故障转移(failover)相关的配置。
  2. 资源限制:确保任务有足够的资源执行,例如CPU、内存和网络带宽。
  3. 依赖服务状态:确认 StarRocks 和其他依赖服务的状态是否正常,因为服务不可用可能导致任务卡住。
  4. 版本兼容性:检查 Flink CDC 和 StarRocks 的版本是否兼容,以及是否存在已知的bug或限制。
  5. 监控日志分析:查看 Flink 和 StarRocks 的监控日志,分析任务卡住的详细原因。
  6. 社区支持:如果问题依然无法解决,建议咨询 Flink CDC 社区或 StarRocks 社区,以获得专业的帮助和支持。

综上所述,Flink CDC 3.0 是有能力实时同步 MySQL 数据至 StarRocks 的,但在实际操作中可能会遇到各种问题。对于任务卡住的问题,需要综合考虑多方面的因素,并通过逐步排查来定位和解决问题。


关于本问题的更多回答可点击进行查看:

https://developer.aliyun.com/ask/599286

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
相关文章
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1750 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
消息中间件 存储 传感器
698 0
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
本文整理自阿里云的高级技术专家、Apache Flink PMC 成员李麟老师在 Flink Forward Asia 2025 新加坡[1]站 —— 实时 AI 专场中的分享。将带来关于 Flink 2.1 版本中 SQL 在实时数据处理和 AI 方面进展的话题。
773 0
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
简介:本文整理自阿里云高级技术专家李麟在Flink Forward Asia 2025新加坡站的分享,介绍了Flink 2.1 SQL在实时数据处理与AI融合方面的关键进展,包括AI函数集成、Join优化及未来发展方向,助力构建高效实时AI管道。
1506 43
|
SQL 关系型数据库 Apache
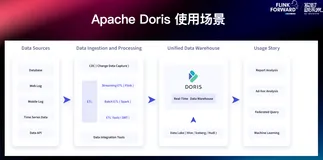
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
本文将深入解析 Flink-Doris-Connector 三大典型场景中的设计与实现,并结合 Flink CDC 详细介绍了整库同步的解决方案,助力构建更加高效、稳定的实时数据处理体系。
4248 0
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
|
存储 消息中间件 搜索推荐
京东零售基于Flink的推荐系统智能数据体系
摘要:本文整理自京东零售技术专家张颖老师,在 Flink Forward Asia 2024 生产实践(二)专场中的分享,介绍了基于Flink构建的推荐系统数据,以及Flink智能体系带来的智能服务功能。内容分为以下六个部分: 推荐系统架构 索引 样本 特征 可解释 指标 Tips:关注「公众号」回复 FFA 2024 查看会后资料~
918 1
京东零售基于Flink的推荐系统智能数据体系
|
消息中间件 SQL 关系型数据库
Flink CDC + Kafka 加速业务实时化
Flink CDC 是一种支持流批一体的分布式数据集成工具,通过 YAML 配置实现数据传输过程中的路由与转换操作。它已从单一数据源的 CDC 数据流发展为完整的数据同步解决方案,支持 MySQL、Kafka 等多种数据源和目标端(如 Delta Lake、Iceberg)。其核心功能包括多样化数据输入链路、Schema Evolution、Transform 和 Routing 模块,以及丰富的监控指标。相比传统 SQL 和 DataStream 作业,Flink CDC 提供更灵活的 Schema 变更控制和原始 binlog 同步能力。
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink 双引擎实战:手把手带你搭建分布式实时分析平台!
465 11
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
在数字化转型中,企业亟需从海量数据中快速提取价值并转化为业务增长动力。5月15日19:00-21:00,阿里云三位技术专家将讲解Kafka与Flink的强强联合方案,帮助企业零门槛构建分布式实时分析平台。此组合广泛应用于实时风控、用户行为追踪等场景,具备高吞吐、弹性扩缩容及亚秒级响应优势。直播适合初学者、开发者和数据工程师,参与还有机会领取定制好礼!扫描海报二维码或点击链接预约直播:[https://developer.aliyun.com/live/255088](https://developer.aliyun.com/live/255088)
877 35
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
|
存储 消息中间件 Kafka
基于 Flink 的中国电信星海时空数据多引擎实时改造
本文整理自中国电信集团大数据架构师李新虎老师在Flink Forward Asia 2024的分享,围绕星海时空智能系统展开,涵盖四个核心部分:时空数据现状、实时场景多引擎化、典型应用及未来展望。系统日处理8000亿条数据,具备亚米级定位能力,通过Flink多引擎架构解决数据膨胀与响应时效等问题,优化资源利用并提升计算效率。应用场景包括运动状态识别、个体行为分析和群智感知,未来将推进湖仓一体改造与三维时空服务体系建设,助力数字化转型与智慧城市建设。
1301 3
基于 Flink 的中国电信星海时空数据多引擎实时改造

相关产品

  • 实时计算 Flink版