一、Buffer Pool 原理
缓冲池是InnoDB存储引擎中一块连续的内存区域,用于缓存磁盘上的数据页和索引页。由于内存访问速度远快于磁盘访问,因此将经常访问的数据和索引加载到缓冲池中,可以显著提高数据库的读写性能。缓冲池的工作原理主要基于“时间局部性”和“空间局部性”原则,即最近访问过的数据在未来很可能再次被访问,且一个数据项被访问时,与其相邻的数据项也很可能被访问。
二、Buffer Pool 组成
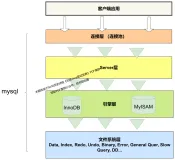
下图是mysql官网原图,其展示了Buffer Pool在innodb引擎架构的组成

缓冲池中的组件详解
在MySQL的InnoDB存储引擎中,缓冲池(Buffer Pool)是一个关键的内存结构,用于缓存数据和索引,以减少对物理磁盘的I/O操作。以下是缓冲池中一些重要组件的详细解释:
1. 索引页(Index Pages)
索引页存储了InnoDB表的索引结构,包括主键索引(聚集索引)和辅助索引(非聚集索引)。这些索引页被加载到缓冲池中,以加速对表中数据的查找和访问。当执行查询操作时,InnoDB会首先检查所需的索引页是否已经在缓冲池中,如果在,则直接从缓冲池中读取,这称为缓冲池命中;如果不在,则需要从磁盘加载到缓冲池中,这称为缓冲池未命中。
2. 数据页(Data Pages)
数据页存储了InnoDB表的实际数据行。在InnoDB中,数据是按页存储的,每个数据页通常包含多行数据。当需要读取或修改表中的数据时,相关的数据页会被加载到缓冲池中。通过将数据页缓存在内存中,InnoDB可以快速地读取和修改数据,而无需每次都从磁盘加载。
3. Undo页(Undo Pages)
Undo页存储了旧版本的数据,用于支持事务的ACID属性中的隔离性(Isolation)和持久性(Durability)。当执行一个事务时,对数据的修改不会立即生效,而是先记录在Undo页中。如果其他事务需要读取被修改的数据,它可以通过Undo页来获取数据修改前的版本,从而实现多版本并发控制(MVCC)。此外,如果事务失败或回滚,Undo页中的数据可以用于恢复数据到事务开始前的状态。
4. 插入缓存(Insert Buffer)
插入缓存是InnoDB中用于优化非聚集索引插入操作的一种机制。当向一个包含非聚集索引的表中插入数据时,如果相关的索引页不在缓冲池中,InnoDB不会立即将索引键插入到索引页中,而是将其存储在插入缓存中。当相关的索引页被加载到缓冲池时,插入缓存中的索引键会被合并并插入到索引页中。这样可以减少磁盘I/O操作,并提高插入操作的性能。
需要注意的是,插入缓存只适用于非唯一索引的插入操作,并且在某些情况下,如缓冲池足够大或表很小,插入缓存可能不会被使用。
5. 自适应哈希索引(Adaptive Hash Index)
自适应哈希索引是InnoDB存储引擎的一个特性,用于自动根据访问模式创建哈希索引。当某些索引值被频繁访问时,InnoDB会将这些索引值存储在自适应哈希索引中,以加速对这些值的查找。自适应哈希索引是完全自动的,不需要用户手动创建或维护。当哈希索引不再被频繁使用时,InnoDB会自动删除它们以释放内存。
6. InnoDB的锁信息(Lock Information)
InnoDB存储引擎使用锁来确保并发访问时的数据一致性和完整性。在缓冲池中,InnoDB会维护锁信息,以跟踪哪些数据页或行被锁定,以及锁的类型(如共享锁或排他锁)。这些锁信息对于实现事务的隔离性和并发控制至关重要。当事务尝试访问被其他事务锁定的数据时,它会根据锁的类型和事务的隔离级别来决定是等待锁释放还是立即返回错误。
总之,缓冲池中的这些组件共同协作,以提供高效的数据访问和事务处理能力。通过合理地配置和管理缓冲池的大小和组件使用,可以进一步优化MySQL的性能和响应速度。 
三、Buffer Pool初始化过程
当MySQL数据库服务器启动时,InnoDB存储引擎会进行一系列的初始化操作,其中就包括Buffer Pool的初始化。其初始化过程的主要流程如下:
- 1. 内存空间分配:
InnoDB首先会根据配置参数为Buffer Pool申请一片连续的内存空间。这片内存空间的大小是可配置的,并且会根据数据库的工作负载和硬件资源进行调整。 - 2. 缓存页划分:
申请到的内存空间会被划分为多个固定大小的页,这些页在Buffer Pool中被称为缓存页(或缓冲页)。在MySQL中,默认的页大小是16KB,但这个值也可以在创建数据库时指定为其他大小(如4KB、8KB、32KB等)。 - 3. 控制结构创建:
对于每个缓存页,InnoDB会创建一个控制结构(或称为控制块、描述符)。这个控制结构存储了缓存页的元数据信息,用于管理缓存页的状态和生命周期。 - 4. 链表初始化:
InnoDB会使用多种链表来管理Buffer Pool中的缓存页,如LRU链表(用于管理缓存页的访问顺序和淘汰策略)和free链表(用于管理空闲的缓存页)。在初始化阶段,这些链表也会被创建并准备好。
- 5. 缓存页状态设置:
初始化完成后,所有的缓存页都处于空闲状态,即它们不包含任何有效的数据。这些空闲的缓存页会被加入到free链表中,等待后续的数据加载操作。 - 6. 数据加载:
当数据库开始执行增删改查(CRUD)操作时,InnoDB会根据需要加载磁盘上的数据页到Buffer Pool中的空闲缓存页里。加载数据页时,InnoDB会检查请求的数据页是否已经在Buffer Pool中(即缓存命中),如果不在,就会从磁盘读取数据页并将其放入一个空闲的缓存页中。
- 7. 动态管理:
随着数据库的运行,Buffer Pool中的缓存页会根据访问模式和负载情况动态地变化。频繁访问的数据页会被保留在Buffer Pool中,而长时间未被访问的数据页可能会被淘汰以腾出空间给新的数据页。
通过这样的初始化和管理过程,InnoDB Buffer Pool能够有效地缓存数据库中的热点数据,减少磁盘I/O操作,从而提高数据库的整体性能。在实际应用中,数据库管理员可以根据工作负载和性能要求来调整Buffer Pool的大小和其他相关参数,以达到最优的性能表现。
四、buffer pool的控制块
Buffer Pool的控制块是InnoDB存储引擎中用于管理缓存页的重要结构。为了更好地管理缓存页,InnoDB为每一个缓存的数据页都创建了一个单独的区域,即控制块。这个控制块用于记录数据页的元数据信息,主要包括以下几个方面:

- 1. 数据页所属表空间编号:
控制块记录了数据页所属的表空间的编号,这是定位数据页在数据库中的重要信息。 - 2. 数据页编号:
每个数据页都有一个唯一的编号,控制块中记录了该数据页的编号,以便在需要时能够准确地找到它。 - 3. 缓存页在Buffer Pool中的地址:
控制块中记录了缓存页在Buffer Pool中的地址,这使得InnoDB能够快速定位到缓存页的位置。 - 4. 链表节点信息:
由于Buffer Pool中有多个链表用于管理缓存页(如LRU链表、free链表、flush链表),控制块中包含了缓存页在这些链表中的节点信息,以便进行链表操作。 - 5. 锁信息:
如果缓存页被锁定,控制块中会记录相关的锁信息,包括锁的类型、持有者等,以确保并发访问时的数据一致性。
控制块与缓存页是一一对应的,它们都被存放在Buffer Pool中。每个控制块的大小通常占缓存页的5%左右,约为800字节(当缓存页大小为默认的16KB时)。在MySQL服务器启动时,会完成Buffer Pool的初始化过程,申请的内存空间会被划分为若干的控制块和缓存页。此时的控制块记录着对应的缓存页地址,而缓存页则是空数据的状态。
通过控制块,InnoDB能够高效地管理Buffer Pool中的缓存页,实现快速的数据访问和事务处理。
五、Buffer Pool中的三个链表详解
在MySQL的InnoDB存储引擎中,Buffer Pool是一个用于缓存数据和索引的内存区域,以减少对磁盘的I/O操作。为了更好地管理这个内存区域中的缓存页,InnoDB使用了三个重要的链表:LRU链表、free链表和flush链表。以下是这三个链表的详细解释:
1. LRU链表(Least Recently Used)
LRU链表是Buffer Pool中最主要的链表,用于管理缓存页的访问顺序和淘汰策略。其名称“Least Recently Used”意味着最近最少使用的页会被淘汰。但实际上,InnoDB的LRU算法是一个改进的版本,它分为两部分:年轻代(young sublist)和老年代(old sublist)。


年轻代:新加载到Buffer Pool的页首先会被放在年轻代中。如果一个页在年轻代中短时间内被多次访问,它会被认为是“热”页,并被提升到老年代。
老年代:老年代中存放的是被认为是“热”页的缓存页,这些页在最近的一段时间内被频繁访问。当Buffer Pool需要空间来加载新的页时,会从老年代中淘汰页。
这种分代的策略可以确保“热”页在Buffer Pool中保持更长的时间,从而提高缓存的命中率。
2. free链表
free链表用于管理Buffer Pool中当前未被使用的空闲页。当一个页被从LRU链表或其他链表中移除时,它会被加入到free链表中。当需要加载新的页到Buffer Pool时,InnoDB会首先从free链表中获取空闲页。如果free链表为空,InnoDB则需要从LRU链表中淘汰页来腾出空间。

3. flush链表
flush链表用于管理那些被修改过(即脏页)并且需要被刷新到磁盘上的缓存页。当一个事务提交或Buffer Pool中的空闲空间不足时,InnoDB会选择一些脏页加入到flush链表中,并在适当的时机将它们刷新到磁盘上。flush链表确保了脏页能够按照一定的顺序和优先级被刷新,从而保证了数据的持久性和一致性。

总结,这三个链表在Buffer Pool中扮演了不同的角色:
LRU链表:管理缓存页的访问顺序和淘汰策略,确保“热”页能够被长时间缓存。
free链表:管理未被使用的空闲页,为加载新页提供空间。
flush链表:管理需要被刷新到磁盘的脏页,保证数据的持久性和一致性。
通过这三个链表的使用和协作,InnoDB能够高效地管理Buffer Pool中的缓存页,提高数据库的性能和响应速度。
六、Buffer Pool在数据库增删改查操作中的原理

1. 数据加载与缓存
当执行增删改查操作时,数据库系统首先会检查所需的数据页是否已经在Buffer Pool中。如果数据页不在Buffer Pool中(即缓存未命中),系统会从磁盘上读取相应的数据页,并将其加载到Buffer Pool的一个空闲缓存页中。这个过程涉及到将数据从磁盘读取到内存,由于内存访问速度远快于磁盘,因此通过缓存可以大大提高数据访问速度。
2. 数据修改
对于增、删、改操作,数据库系统会在Buffer Pool中对应的缓存页上直接进行修改,而不是立即写回磁盘。这是因为内存中的修改操作速度非常快,可以显著提高数据库的处理能力。修改后的缓存页会被标记为“脏页”(dirty page),意味着它们的内容与磁盘上的数据不同步。
3. 写入磁盘
脏页不会立即写回磁盘,而是会在适当的时候由后台进程异步地刷新到磁盘上。这种延迟写回的策略可以减少磁盘I/O操作,提高系统性能。但是,为了保证数据的持久性和一致性,在某些情况下(如事务提交时),数据库系统会强制将脏页写回磁盘。
4. 缓存替换策略
由于Buffer Pool的大小是有限的,当所有的缓存页都被使用时,需要有一种策略来决定哪些数据应该被替换或淘汰。最常见的策略是最近最少使用(LRU)算法,它根据缓存页的使用频率来决定哪些页应该被淘汰。但是,数据库系统通常会对标准的LRU算法进行一些改进,以适应其特定的访问模式和性能要求。
5. 并发控制
在多用户并发访问数据库时,Buffer Pool还需要提供适当的并发控制机制,以确保数据的一致性和完整性。这通常涉及到使用锁和其他同步机制来协调不同用户之间的访问。
6. 恢复与故障处理
为了防止系统故障导致的数据丢失,数据库系统通常还会使用日志(如redo log)来记录对数据的修改。这样,在系统崩溃后,可以通过重放日志来恢复数据到一致的状态。Buffer Pool中的脏页也会在恢复过程中被重新构建。
通过以上原理,Buffer Pool在数据库增删改查操作中扮演了关键角色,它通过缓存和延迟写回等策略大大提高了数据库的性能和可扩展性。
结语
MySQL的缓冲池是一个高度优化的内存区域,它通过缓存热点数据和索引,减少了磁盘I/O操作,大大提高了数据库的性能。缓冲池的设计和实现涉及多个复杂的算法和数据结构,如LRU算法、预读机制等。了解缓冲池的工作原理和组成部分,对于优化MySQL的性能、解决性能问题具有重要的指导意义。通过图文并茂的方式,我们可以更加直观地理解缓冲池在数据操作中的核心作用。