前言
MySQL 调优是必备的技能,从系统层面来看,MySQL 基于磁盘交互,是它的瓶颈所在,大量依赖于可靠性、持久化操作,都需要经过 DB,基于它能有调优能力,能最大化提升自己的竞争力;该博文会从以下几方面来对 MySQL 调优作系统的介绍
- 数据建模方案及数据类型优化
- 索引优化
- 大数据量查询优化
- 海量数据解耦优化处理
数据建模方案、数据类型优化
存储引擎选择
存储引擎的选择是经常会被忽视的问题,因为在绝大部分场景下,都不需要指定存储引擎,直接会使用 MySQL 默认的存储引擎:InnoDB
若不作任何设置的话,默认的存储引擎就是 InnoDB,但也可以通过修改配置文件的方式进行修改操作,如:在 /etc/my.cnf 文件追加内容
[mysqld]
default-storage-engine=InnoDB
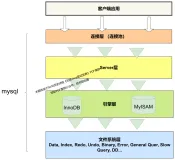
可以通过以上配置写上存储引擎类型,MySQL 支持的存储引擎如下:

之前在介绍 performance_schema 时,它本身就是一种存储引擎,但是在日常工作中 InnoDB、MyISAM 用的最多,它们两者的区别如下:
| MyISAM | InnoDB | |
| 索引类型 | 非聚簇索引 | 聚簇索引 |
| 支持事务 | 否 | 是 |
| 支持表锁 | 是 | 是 |
| 支持行锁 | 否 | 是 |
| 支持外键 | 否 | 是 |
| 支持全文索引 | 是 | 是(5.6 后支持) |
| 适合操作类型 | 大量 SELECT | 大量 Insert、Delete、Update |
- 索引类型:数据、索引文件放在一起的叫做聚簇索引,数据、索引文件不放在一起的叫做非聚簇索引,InnoDB 存储引擎中既有聚簇索引也有非聚簇索引,而 MyISAM 只有非聚簇索引
- 支持事务:MyISAM 不支持事务,InnoDB 支持事务
- 支持表、行锁:MyISAM 默认情况下只支持表锁、不支持行锁,但 InnoDB 它既支持表锁也支持行锁,这其中就牵扯到一个锁粒度问题,在进行加锁控制时,肯定是粒度越小越好;粒度越小,锁定的数据范围越小,即并行度越高,效率越高。所以一般在实际代码开发中,进行事务操作时,会把大事务以编程式事务的方式去进行处理,能够精确控制,小事务使用声明式事务处理即可.
- 支持外键:MyISAM 不支持外键,InnoDB 支持外键
- 支持全文索引:MyISAM 支持,InnoDB 5.6 版本之后才支持,全文索引很好理解,举例说明如下:
假设,数据库中有一张文章表,里面存在一个列
content,代表内容的意思,若在当前表里需要检索出包含 java 关键字的文章,此时可以利用全文索引的方式来进行分词操作,但是在企业里面一般情况下不会使用全文索引处理,当涉及到分词操作时会选择使用 ES.
- 适合操作类型:MyISAM 支持大量查询操作, InnoDB 适合操作大量 Insert、Update、Delete 操作
合理使用范式、反范式
范式:会遵循第三范式原则设计表结构,不会产生多的冗余列,即都会进行 Join 表查询;反范式:在表中新增冗余列避免多查一张表,现在的主流设计都是 范式+反范式 设计结合使用
范式优点如下:
- 范式化的更新通常比反范式更快
- 当数据模型较好的范式化后,很少或没有重复的数据
- 范式化的数据比较小,可以放在内存中,操作比较快
范式的缺点:必须要进行
表关联查询
反范式优点如下:
- 所有的数据都在同一张表中,可以避免关联
- 可以设计有效的索引
当然反范式也有缺点,表内
冗余的字段较多,删除数据时会造成表有些有用的信息丢失
总结:在企业中为了能够更好的提高整个项目的运行效率,一般情况下范式、反范式是要配合使用的,或者说是混合使用的
- 在一个网站实例中,网站允许用户发送消息,并且一些用户是付费用户;若想要查看付费用户最近 10 条信息,在 user、message 表中都存储在用户类型(account_type)而不用完全的反范式化;这避免了完全反范式化的插入、删除问题,因为即使没有消息时也不会丢失用户的信息;这样也不会把 user_message 表搞太大,有利于高效地获取数据
- 从父表冗余一些字段数据到子表的理由是排序的需要
- 若缓存衍生值也是有用的,若需要显示每个用户发了多少消息(类似论坛的)可以每次执行一个昂贵的子查询来计算并显示它,也可以在 user 表建一个 num_message 字段,当用户发送消息时更新这个值即可.
字符集选择
一般在设置字符集时都是默认给它指定 utf-8,若你要存储中文时,不建议设置成 utf-8,因为中文支持的字节数可能是 2 个、3 个、4 个,而 utf-8 只支持 3 个字节存储,因此在进行插入 emoji 表情,如:😊 就会有问题,报错内容 > Incorrect string value: '\xF0\x9F\x91\x87' for column
因此,建议在进行设置时最好设置成 utf8mb4 指定 column 字符集,同时不同的编码格式还有以下特性:
- 纯拉丁字符能表示的内容,没必要选择
latin1之外的其他字符编码,因为这会节省大量的存储空间 - 若我们可以确定不需要存放多种语言,就没有必要非要使用 utf8 或其他 Unicode 字符串类型,这会造成大量的存储空间浪费
- MySQL 数据类型可以精确到字段,所以当我们需要大型数据库中存放多字节数据时,可以通过
对不同表不同字段使用不同的数据类型来较大程度减少数据存储量,进而降低 IO 操作次数并提高缓存命中率
一般在实际开发过程中,会指定字符列字符集:CHARACTER SET utf8mb4,字符排序规则:COLLATE utf8mb4_general_ci
出现两表关联时,若表中的列字符集或排序规则不一致时,就会出现错误
Illegal mix of collations (utf8mb4_unicode_ci,IMPLICIT) and (utf8mb4_general_ci,IMPLICIT) for operation '=',此时可以在 join on 字段后面指定 >COLLATE utf8mb4_unicode_ci来完成 SQL 的正确执行,但这种方式会难免降低 SQL 执行效率,从而在表设计时指定好字符集、字符排序规则是一件很重要的事情!
主键选择
代理主键与事物无关的,无意义的数字序列
自然主键时事物属性中一个自然的唯一标识
举例说明:若要存储用户信息,要设置一个唯一标识,可以设置一个无意义的 id,也可以直接使用身份证号,身份证号就是一个自然主键,普通 ID 就是一个代理主键
推荐大家采用代理主键,原因如下:
- 不与业务耦合,因此更容易维护一点
- 设计通用的键策略,能够减少需要编写的源码数量,减少系统的总体维护成本
适当数据冗余
适当的数据冗余,表示数据可能存储多份,详细说明如下:
- 若被频繁引用只能通过 Join 两张表或更多大表的方式才能获取到独立的小字段内容信息
- 由于每次 Join 仅仅只是为了小字段的值,Join 到的记录又不大,会造成大量不必要产生的 IO,完全可以通过
空间换时间的方式来进行优化;不过,冗余的同时需要确保数据的一致性不会被破坏,确保更新基础表的同时冗余字段也要被更新
举例说明:
一张 4 百万的会员表,它以
会员手机号或系统生成的唯一值来区分用户,此时还有一张 4 百万的会员等级表(一个会员对应一个等级)此时需求若要查询出前 100 条会员的基础信息以及其对应的等级信息,即使,100 条已经限制了,但它仍然会扫描 Join 大量的数据,会造成数据库查询效率极速下降;若此时【等级 id、等级名称】冗余到会员表中,那么 SQL 只需要查询一张表即可,同时搭配上 LIMIT 关键字,可谓天作之合,唯一的缺陷就是在更新会员等级表信息的同时需要更新会员表冗余的等级字段信息
select m.id,m.name,m.phone,ml.level_id,ml.level_name
from member m
left join member_level ml on ml.phone=m.phone
limit 100
举例说明:
一张活动基本表,一张活动参与记录表,而活动表的信息一旦创建好以后,它的活动名称就不能再进行变更,此时,可以在活动参与表中直接
冗余活动名称,后续在 C 端用户查询活动的参与信息时就不需要再通过活动 id 去关联查询活动基本表的活动名称字段。
适当拆分
适当拆分 > 反例:指的不是分库分表中的垂直拆分、水平拆分,垂直拆分指的是按照业务来进行切分,有 N 张表可以把不同的表放到不同的物理服务器上,这样做的话,不同的查询请求会被分散到不同的物理服务器上去,减少单台服务器的压力;水平拆分指的是将数据按照某一个范围放入到不同的物理服务器上,此处说的适当拆分并不是指的这两个方面
适当拆分 > 正例:当表中存在类似于 TEXT 或 Blob 类型的字段,大部分访问这张表的查询并不需要这种类型字段,那么就该义无反顾的将其拆分到另外的独立表中,以减少常用数据所占用的存储空间,这样做的明显好处:每个数据块中可存储的数据条数将大大增加,既减少了物理 IO 交互次数,同时也能大大提高内存中的缓存命中率。
比如:一张表中里面有 100 多个字段,但这 100 多个字段可能常用的也就 10、20、30 个,有剩下好几十个字段可能压根用不到,但这些字段又占用了较大的存储空间,此时可以把这些
不常用的数据拆分出来;若需要查询了,就可做关联查询,若不需要查询了,就不需要做关联查询
该点业务量比较大或者表数据字段比较多时是必须要做的,这样操作会带来查询效率成倍数的提升!
数据类型优化
更小更好
首先第一点通常是更小更好,在我们进行数据存储时,可以选择任意的类型进行存储,比如:整型 > 可以使用 int、tinyint,还可以使用 bigint,我们应当尽量使用存储数据的正确数据类型,更小的数据类型通常更快;因为越小的数据类型占用越少的磁盘空间、内存,而且处理时需要的 CPU 周期也比较少,但是要正确评估需要存储的一个数据范围
比如:
1、一般的名称、描述可以基于产品给出的 PRD 文档描述,最大长度不可超过多少长度,那么就可以设置长度为这个最大数
2、状态枚举类型:尽量使用 tinyint 来存储,
tinyint(1)代表一个字节,足以存储逻辑删除 > 0、1,若存在多种状态,根据状态的最大数量计算好它需要多少字节再设置即可,弊端:枚举类型值使用字符串的方式去存储,是一种很不明智的行为,虽然能提高数据的可读性,但浪费了数据库的存储空间,最大可能又会数据的误操作3、对接第三方接口,当我们要存储这些第三方返回的信息时,第三方对应的接口文档也有描述
最大长度,根据字段的数据类型选择合适的长度