《Apache Flink 案例集(2022版)》——4.云原生——斗鱼-Apache Flink 在斗鱼的应用与实践(上) https://developer.aliyun.com/article/1228038
生产实践
搭建平台的过程中,斗鱼也遇到了不少的挑战。
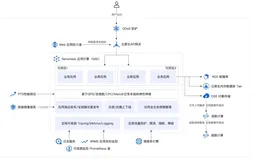
第一个挑战是 Flink on K8s 集群的部署资源问题。方案上斗鱼使用 Standalone Kubernetes 部署,实际是在 K8s 的集群中,创建了两个实例组。一个实例组用来运行 JM 进程,另一个实例组用来运行 TM 进程。两个实例组之间,通过设置 HA 的集群 id 相同来实现绑定。
JobManager实例组运行多个Pod时,除其中一个作为Master节点外,其他的Pod都将以StandBy的身份运行;
TaskManager实例组运行多个Pod时,每一个Pod都将注册到JobManager上,作为一个作业执行器存在。

为了使资源充分隔离,依托于 K8s 的能力,生产部署时斗鱼采取一个作业创建一个 Flink 集群的方式。由于K8s创建一个Pod时,需要指定 CPU 和内存的设置,而 Flink 集群启动的时候需要在Flink配置文件指定JobManager和TaskManager的资源配置,因此在这个方案中遇到的挑战就是如何统一设置 K8s 实例资源与 Flink 集群资源。
为了解决这个问题,斗鱼改造了 Flink 镜像启动脚本 entrypoint,在脚本中增加了两个操作:
第一是拉取作业定义,以获取作业的运行配置;
第二是替换 flink-conf 文件 memory size 配置。

值得注意的是,在Flink社区最新的Native Kubenates方案中这个问题已经通过参数化配置解决了。

平台遇到的第二个挑战是如何去监控每个作业的运行状态。方案上,斗鱼将每个作业抽象成一条消息,存放在基于 ZK 开发的消息队列中。并且在消息队列虚化了 5 个状态,Accept、Running、Failed、Cancel 以及 Finish。
每个状态都有一个独立的线程池去监控消费。比如 Running 状态,线程池从消息队列中获取一条作业消息,从中解析 Flink 集群信息,获取 FlinkUI 域名,通过 K8s 的 Nginx Ingress,使用域名去访问 Flink JM Pod,从而获取运行作业的状态。当获取作业状态还是 Running 时,将重入队到队尾,否则将移动到对应状态队列下。

平台遇到的第三个挑战是如何读取Hive表以及如何使用Hive UDF。斗鱼将一个 FlinkSQL 的提交拆分成三个部分:作业组装、上下文初始化和 SQL 执行。其中作业组装实现了两种方式:
第一个是 SDK GET,通过 SDK 封装的方法,请求平台的服务层,去获取作业定义;
第二个是 FILE GET,直接读取当前机器,指定路径下的 SQL 文件,生成作业定义。第二个方式主要是方便本地不依赖平台服务,可快速调试引擎。
上下文初始化部分也分为两个过程:
一个是调优参数的设置,类似常用HiveSQL的Set命令
另一个是 Catalog初始化,Flink集群与Hive的集成就是在这个环节实现的
以Hive为例,在Catalog注入之前,平台元数据管理模块有一个Catalog初始化的过程,预先将 Catalog 的创建语句存储起来。当一个Flink作业提交时,选择需要注入的Catalog,创建Catalog并注册到Flink的上下文中,从而实现Catalog的元素注入。

随着任务的增加,对于新手来说,在平台上开发 Flink 作业,从 SQL 编写到上线,往往需要改写数十个版本。缺少快速试错的能力是平台面临的第四个挑战,因此斗鱼设计开发了实时监控、实时调试功能。
在架构方面,斗鱼引入了 Flink Gateway Server 对 Flink 集群接口二次分装。包含语法校验、SQL 提交、SQL 状态检查、SQL 停止、SQL mock 等功能。将 Flink 集群和网关服务的日志统一收集。通过预启动 Flink 集群,缩短作业启动时间,达到快速调试的能力。
实时调试主要分为四个步骤,即 SQL 解析、规则校验、执行计划,和物理执行。SQL mock 就是改写了原有的 SQL 解析过程。根据 SQL 解析后得到 Node 数,分析 SQL 的血缘关系,去判断 Source 来源表和 Sink 目的表。动态的将 Source 表改写为 dataGen 的数据源,和 Sink 表改写成 console 的数据源。动态修改 Source 和 Sink 表的配置实现数据源mock的好处是线上开发 SQL 可直接用于调试,不需要修改,并且也不用担心会产生脏数据,可快速验证 SQL 逻辑是否符合预期。

平台面临的最后一个挑战是Flink作业的监控告警。斗鱼使用自定义Metrics Reporter,将监控指标上报到Kafka集群,继而使用Flink任务去消费Kafka里的Metrics信息,完成如聚合、补充链路维度等操作,处理后的数据再推送到 Push Gateway,写入Prometheus中。最后监控大盘基于Grafana绘制。斗鱼的监控大盘分为资源监控,稳定性监控,Kafka 监控和 CPU 内存监控。
未来规划
Flink 让实时计算更加简单,斗鱼在搭建实时计算平台过程中也并非一帆风顺。对于实时计算平台未来的发展,斗鱼有三个展望: 、
第一个是 Flink 的动态扩缩容,实现平台自动化调整 Flink 作业资源,解决业务数据突增引起的问题;
第二个是简化实时数仓开发模型,降低实时数仓开发门槛,在企业内将实时数仓真正大规模推广使用; 最后一个是完善实时数据质量监控体系,实现实时数据质量可验证与可追溯。