【新智元导读】近日,DeepMind提出了一种基于概率帧预测的图像建模和视觉任务的通用框架——Transframer。
AI又进阶了?
而且是一张图生成连贯30秒视频的那种。

emm....这质量是不是有点太糊了

要知道这只是从单个图像(第一帧)生成的,而且没有任何显示的几何信息。
这是DeepMind最近提出的一种基于概率帧预测的图像建模和视觉任务的通用框架——Transframer。
简单讲,就是用Transframer来预测任意帧的概率。
这些帧可以以一个或者多个带标注的上下文帧为条件,既可以是先前的视频帧、时间标记或者摄像机标记的视图场景。
Transframer架构
先来看看这个神奇的Transframer的架构是怎么运作的。

论文地址就贴在下面了,感兴趣的童鞋可以看看~https://arxiv.org/abs/2203.09494
为了估计目标图像上的预测分布,我们需要一个能够生产多样化、高质量输出的表达生成模型。
尽管DC Transformer在单个图像域上的结果可以满足需求,但并非以我们需要的多图像文本集 {(In,an)}n 为条件。
因此,我们对DC Transformer进行了扩展,以启用图像和注释条件预测。
我们替换了DC Transformer 的Vision-Transformer风格的编码器,该编码器使用多帧 U-Net 架构对单个DCT图像进行操作,用于处理一组带注释的帧以及部分隐藏的目标DCT图像。
下面看看Transframer架构是如何工作的。
(a)Transframer将DCT图像(a1和a2)以及部分隐藏的目标DCT图像(aT)和附加注释作为输入,由多帧U-Net编码器处理。 接下来,U-Net输出通过交叉注意力传递给DC-Transformer解码器,该解码器则自动回归生成与目标图像的隐藏部分对应的DCT Token序列(绿色字母)。 (b)多帧U-Net block由NF-Net卷积块、多帧自注意力块组成,它们在输入帧之间交换信息和 Transformer式的残差MLP。

再来看看处理图像输入的Multi-Frame U-Net。
U-Net的输入是由N个DCT帧和部分隐藏目标DCT帧组成的序列,注释信息以与每个输入帧相关联的向量的形式提供。
U-Net的核心组件是一个计算块,它首先将一个共享的NF-ResNet 卷积块应用于每个输入帧,然后应用一个Transformer样式的自我注意块来聚合跨帧的信息。(图2 b)
NF-ResNet块由分组卷积和挤压和激发层组成,旨在提高TPU的性能。
下面,图(a)比较了RoboNet (128x128) 和KITTI视频的绝对和残差DCT表征的稀疏性。
由于RoboNet由只有少数运动元素的静态视频组成,因此残差帧表征的稀疏性显著增加。
而KITTI视频通常具有移动摄像头,导致连续帧中几乎所有地方都存在差异。
但在这种情况下,稀疏性小带来的好处也随之弱化。

多视觉任务强者
通过一系列数据集和任务的测试,结果显示Transframer可以应用在多个广泛任务上。
其中就包括视频建模、新视图合成、语义分割、对象识别、深度估计、光流预测等等。

视频建模
通过Transframer在给定一系列输入视频帧的情况下预测下一帧。
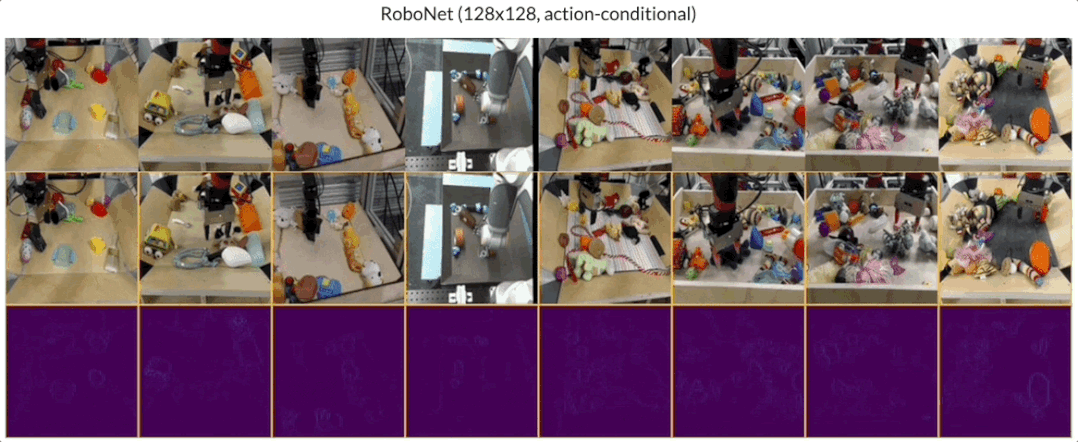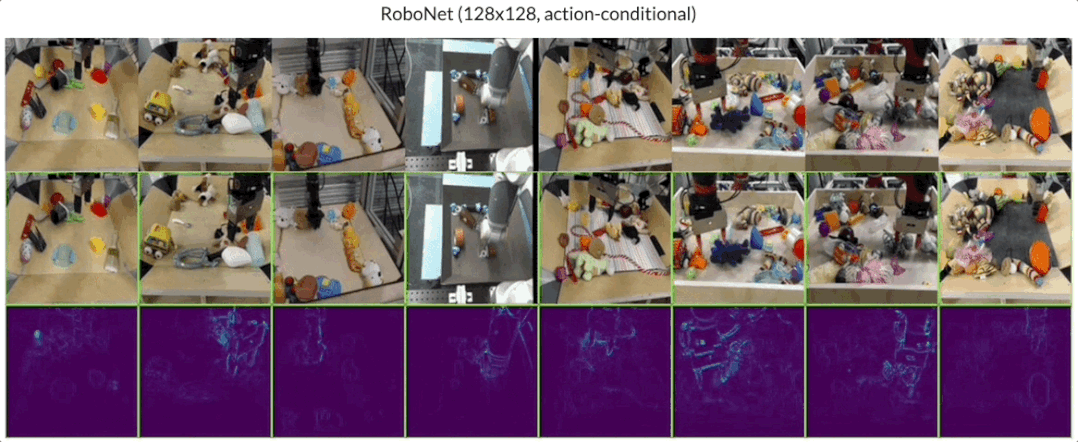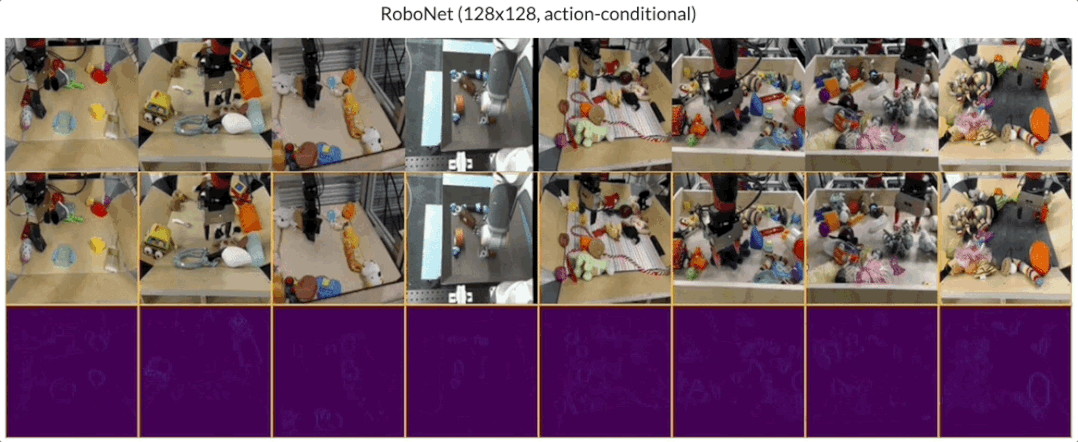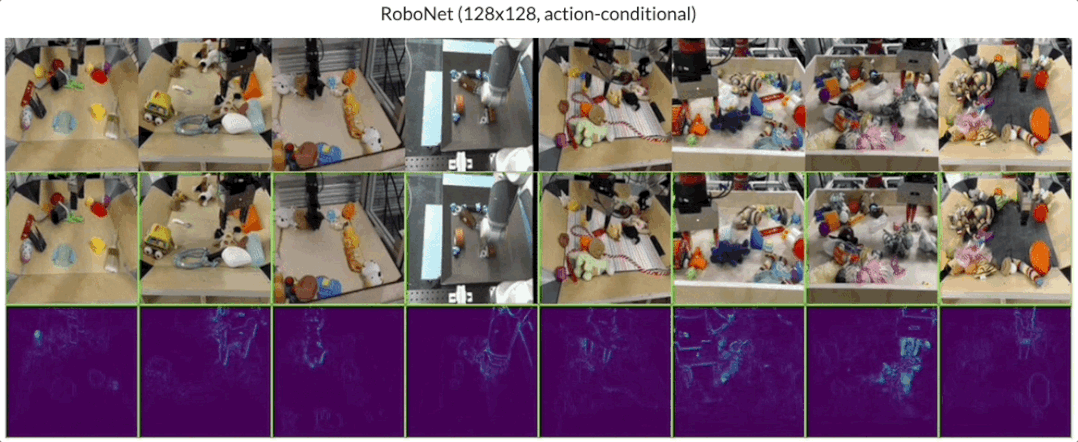
研究人员分别在KITTI和RoboNet两个数据集上,训练了Transframer在视频生成上的性能如何。

对于KITTI,给定5个上下文帧和25采样帧,结果显示,Transframer模型在所有指标上的性能都有所提高,其中LPIPS和FVD的改进是最显而易见的。
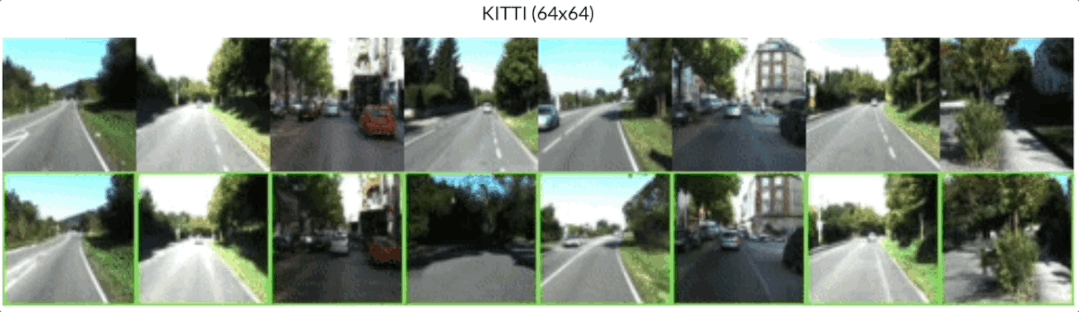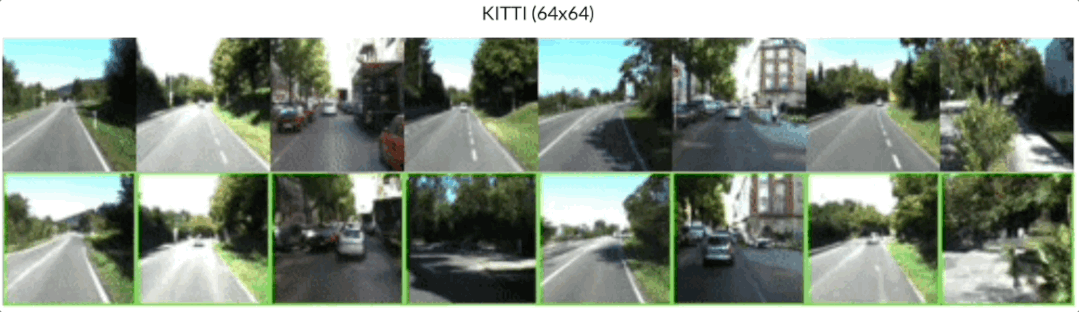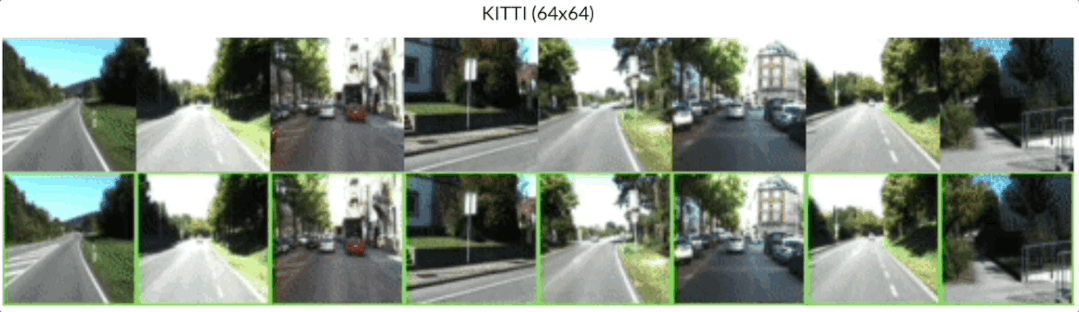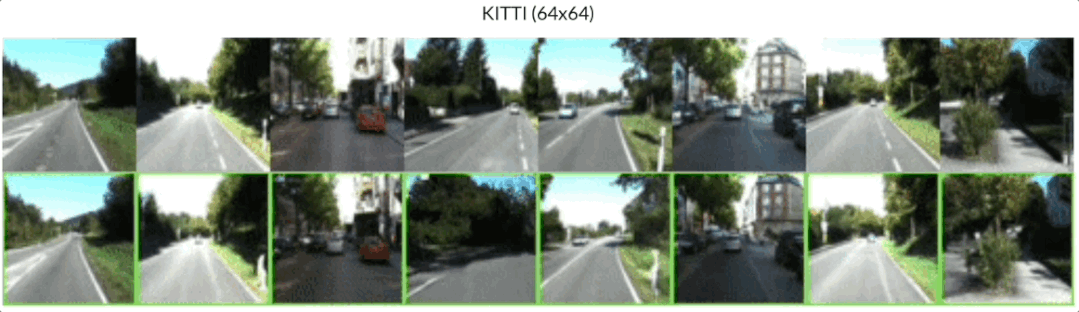
在RoboNet上,研究人员给定2个上下文帧和10个采样帧,分别以64x64 和 128x128 的分辨率进行训练,最终也取得了非常好的结果。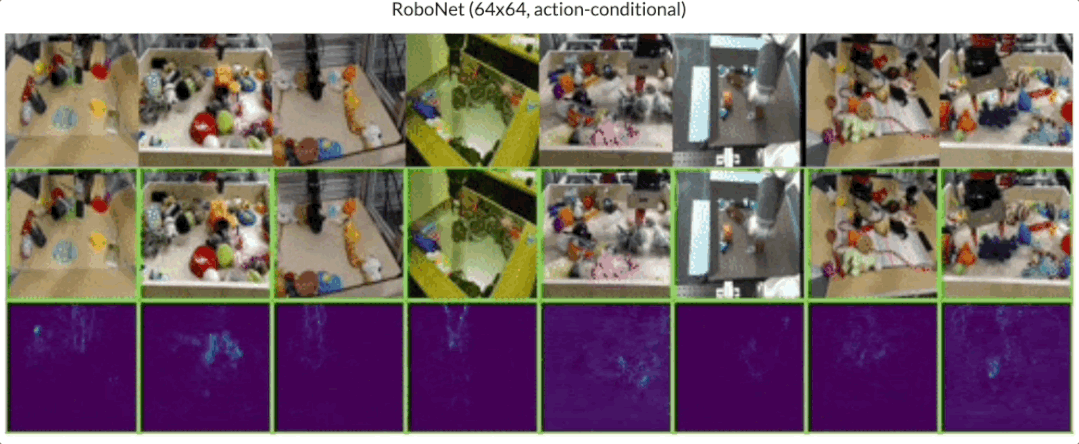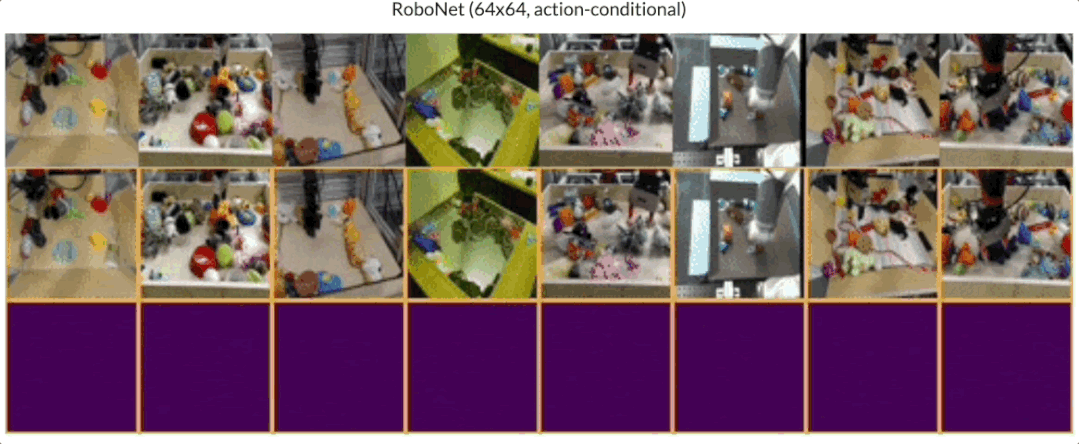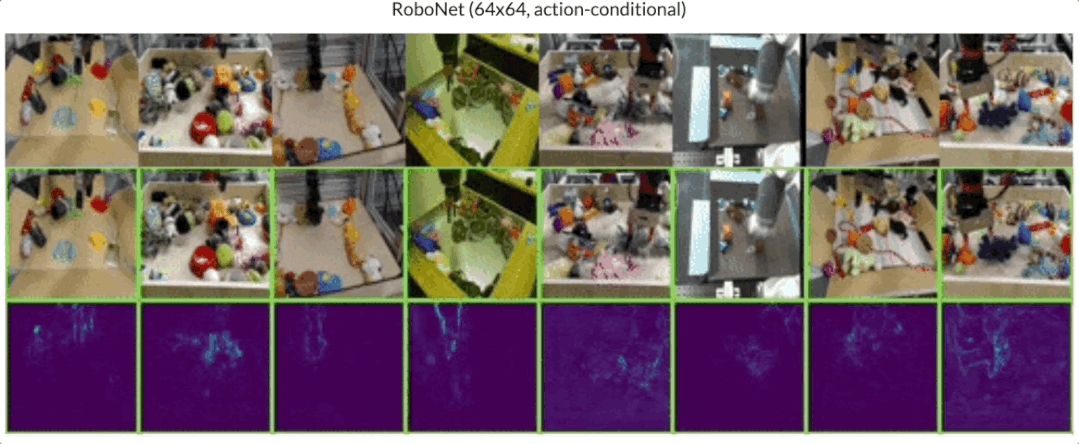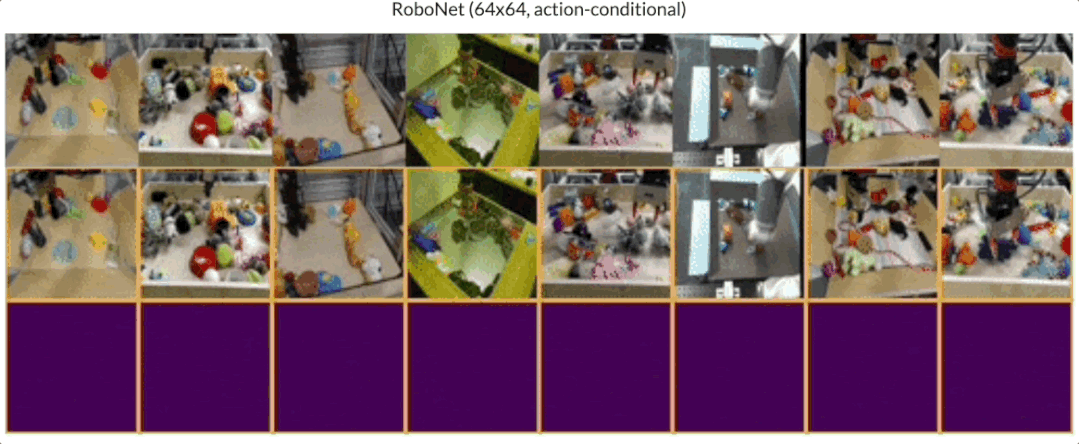
视图合成
在视图合成方面,研究者通过提供相机视图作为表 1(第 3 行)中描述的上下文和目标注释,以及 统一采样多个上下文视图,直到指定的最大值。
通过提供1-2个上下文视图,在ShapeNet 基准上评估模型Transframer,明显优于PixelNeRF和SRN。

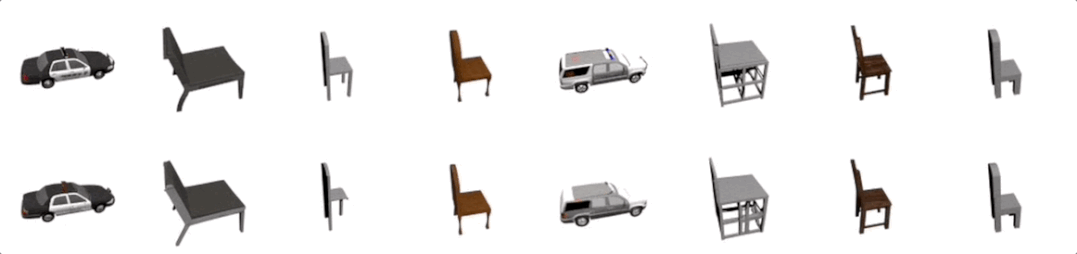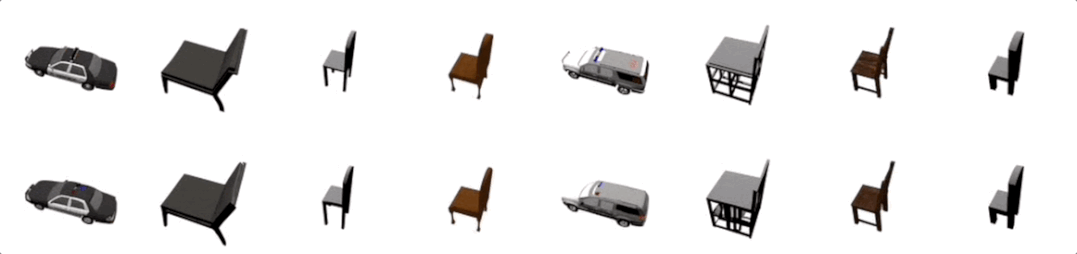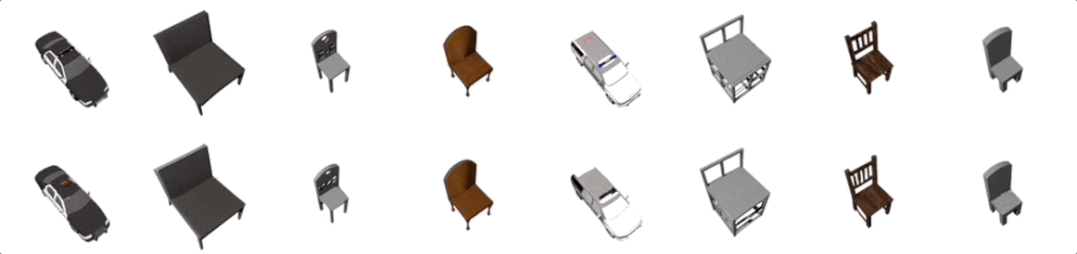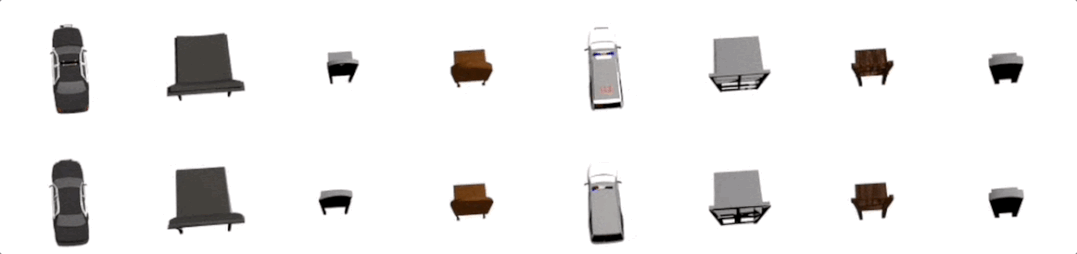
此外在数据集Objectron进行评估后,可以看出当给定单个输入视图时,模型会产生连贯的输出,但会遗漏一些特征,比如交叉的椅子腿。
当给出1个上下文视图,以128×128分辨率合成的视图如下:

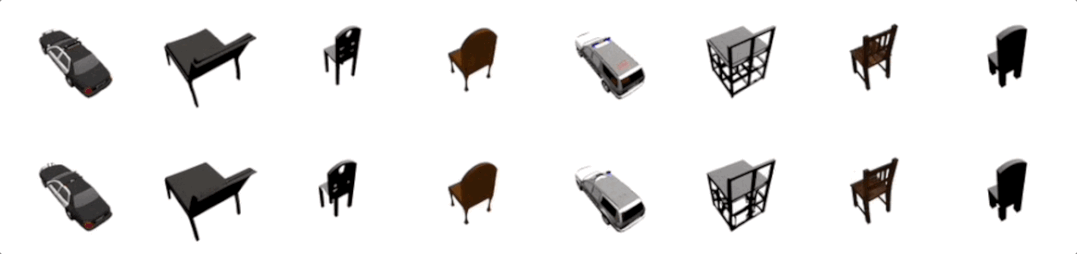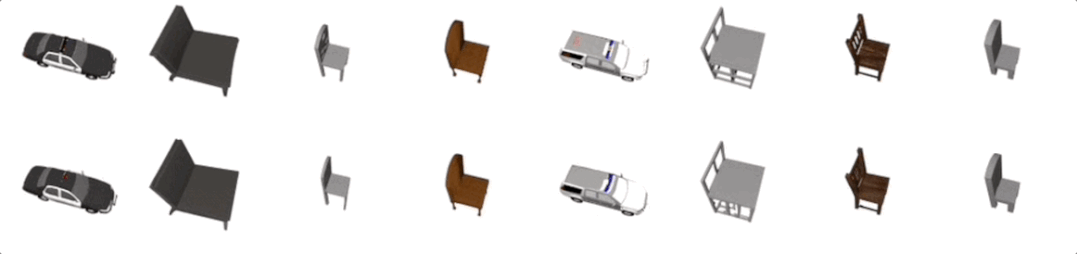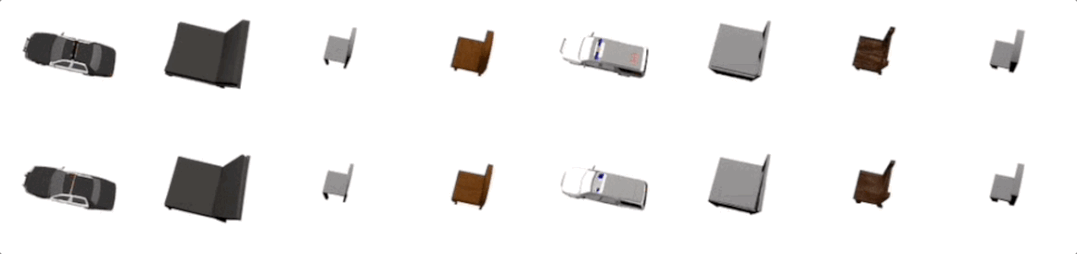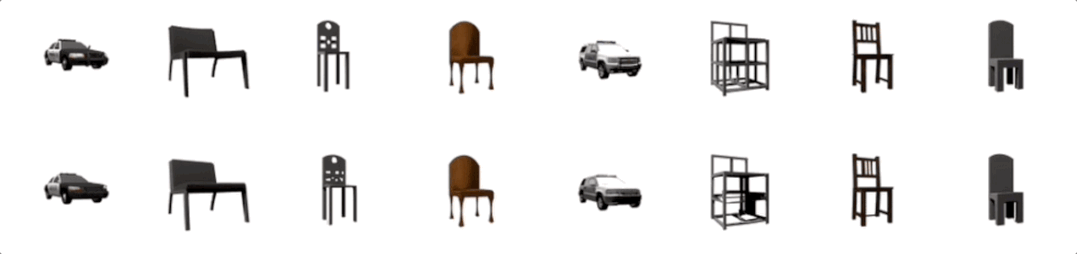
当再给出2个上下文视图,以128×128分辨率合成的视图如下:

多视觉任务
不同的计算机视觉任务通常使用复杂的架构和损失函数来处理。
这里,研究人员在8个不同的任务和数据集上使用相同的损失函数联合训练了Transframer模型。
这8个任务分别是:单个图像的光流预测、对象分类、检测和分割、语义分割(在2个数据集上)、未来帧预测和深度估计。

结果显示,Transframer学会在完全不同的任务中生成不同的样本,在某些任务中,比如 Cityscapes,该模型产生了质量上好的输出。
但是,在未来帧预测和边界框检测等任务上的模型输出质量参差不齐,这表明在此设置中建模更具挑战性。