1 画学习曲线
1.1函数和类调用图
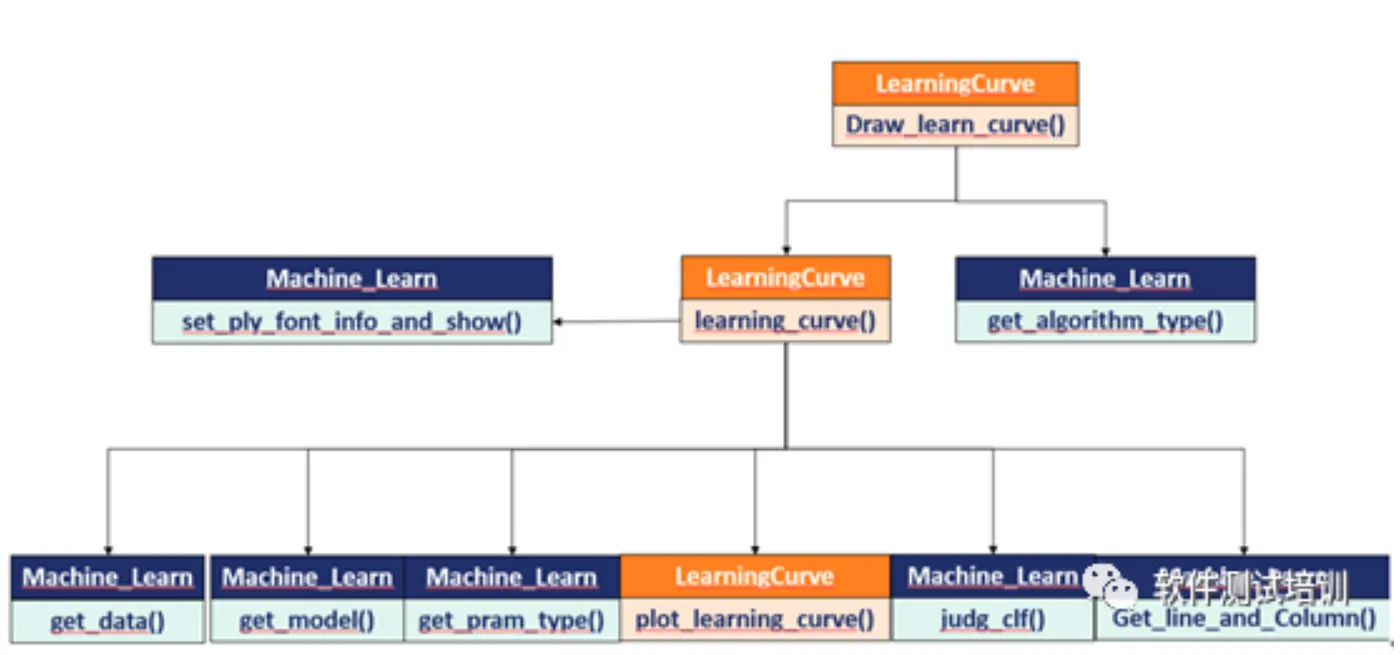
1.2 代码
class LearningCurve:
    def__init__(self,data):
       self.data = data
#定义一个绘制学习曲线的函数
    defplot_learning_curve(self,estimator, title,X,y,ylim=None,cv=None,n_jobs=2,train_sizes=np.linspace(.1,1.0,5)):
if ylim is not None:
           plt.ylim(*ylim)
       plt.xlabel(u"训练样本")
       plt.ylabel(u"得分")
       plt.ylim(0,1.1)
        tarining_sizes,train_scores,test_scores =learning_curve(estimator,X,y,cv=cv,n_jobs=n_jobs,train_sizes=train_sizes)
       train_scores_mean = np.mean(train_scores,axis=1)
       test_scores_mean = np.mean(test_scores,axis=1)
       plt.grid()
       plt.plot(tarining_sizes,train_scores_mean,'o-',label=u"训练得分",c='r')
       plt.plot(tarining_sizes,test_scores_mean,'o-',label=u"交叉验证得分",c='g')
       plt.legend(loc='lower right')
return plt
#画学习曲线
    deflearning_curve(self,model_name,pram,title):
       ML = Machine_Learn()
       mytype = ML.get_pram_type(model_name)
       X,y = ML.get_data(self.data)
       cv = ShuffleSplit(n_splits=100,test_size=0.2,random_state=0)
       mytitle =u"学习曲线("+title+")"
       print(model_name)
if len(pram) == 0:
           plt.figure()
           clf = ML.get_model(model_name)
           self.plot_learning_curve(clf,mytitle,X, y,ylim=(0.9,1.01),cv=cv)
else:
           plt.figure()
           pramdic = eval(pram[0])
            i = 0
           maxj=0
           i,j = ML.Get_line_and_Column(pramdic)
           m =0
for key,values in pramdic.items():
                valuedics =values.split(",")
for valuedic in valuedics:
                    clf =ML.judg_clf(key,mytype,model_name,valuedic)
                    plt.subplot(i,j,m+1)
                   plt.title(key+"="+valuedic)
                   self.plot_learning_curve(clf,mytitle,X, y,ylim=(0.9,1.01),cv=cv)
                   m=m+1
       ML.set_ply_font_info_and_show(title)
#准备画学习曲线
    defDraw_learn_curve(self,scattertype):
       ML = Machine_Learn()
       prams,model_name,title_name = ML.get_algorithm_type(scattertype)
       i = 0
for pram in prams:
           self.learning_curve(model_name[i],pram,title_name[i])
           i = i+1
1.3调用
if __name__=="__main__":
lc = LearningCurve("breast_cancer")
   lc.Draw_learn_curve("Liner")
   lc.Draw_learn_curve("RandomForest")
   lc.Draw_learn_curve("DecisionTree")
   lc.Draw_learn_curve("KNeighbors")
   lc.Draw_learn_curve("Bayes")
   lc.Draw_learn_curve("SVM")
   lc.Draw_learn_curve("Neural_network")
   lc.Draw_learn_curve("Ensemble")
2 结果
本结果数据来源:
sklearn.datasets.load_breast_cancer()
2.1 线性模型
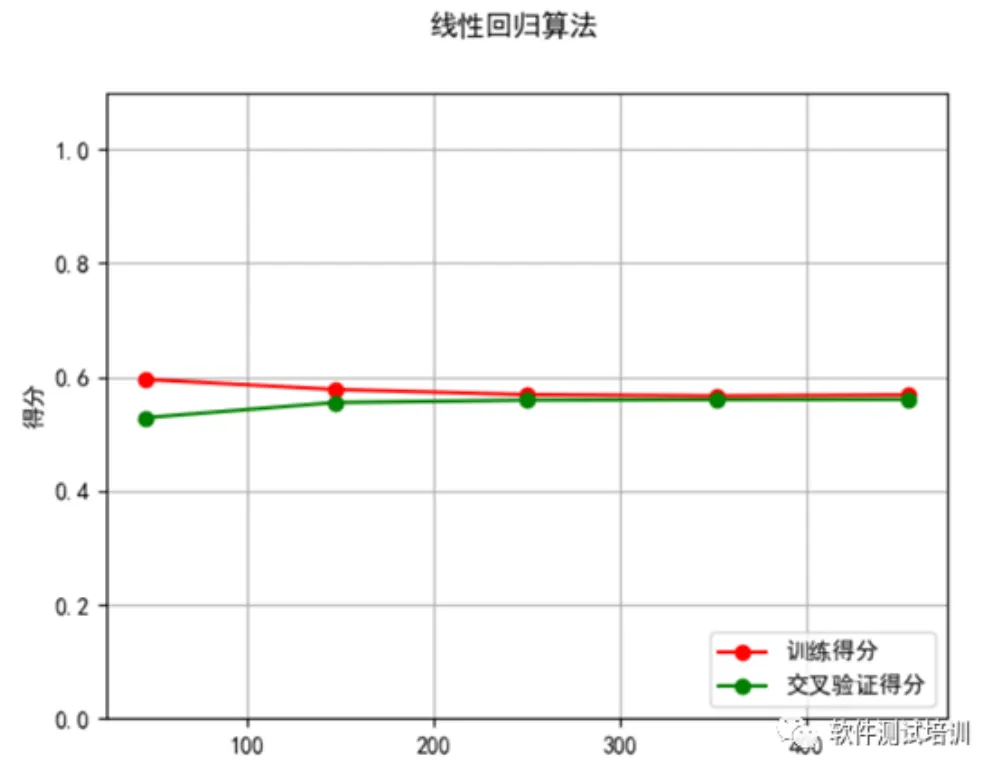
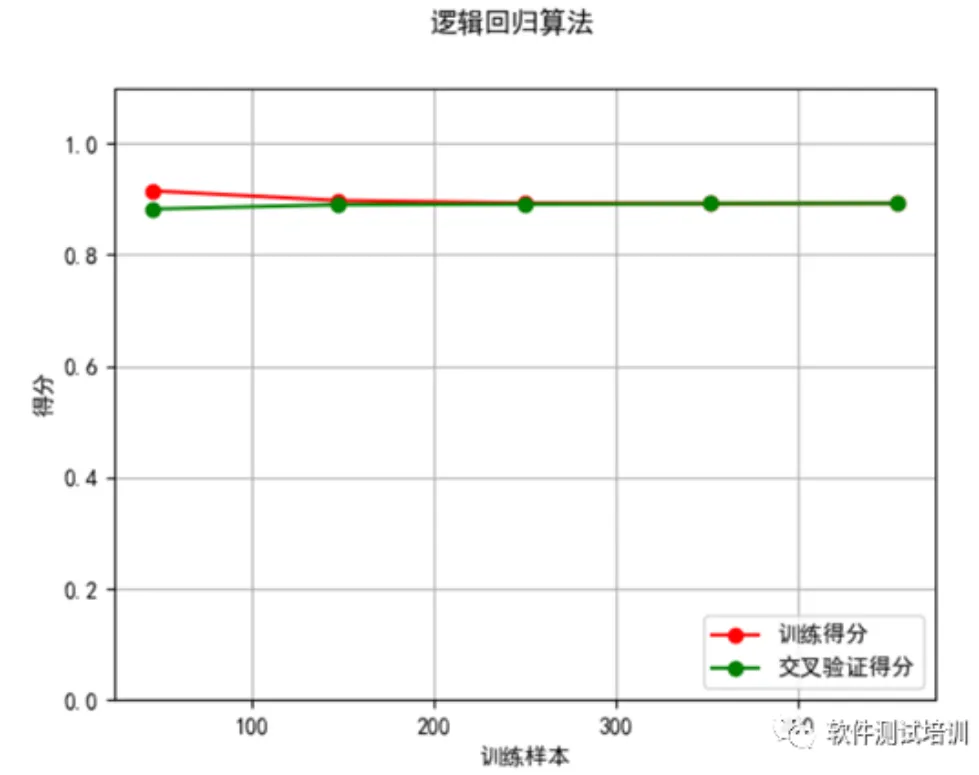
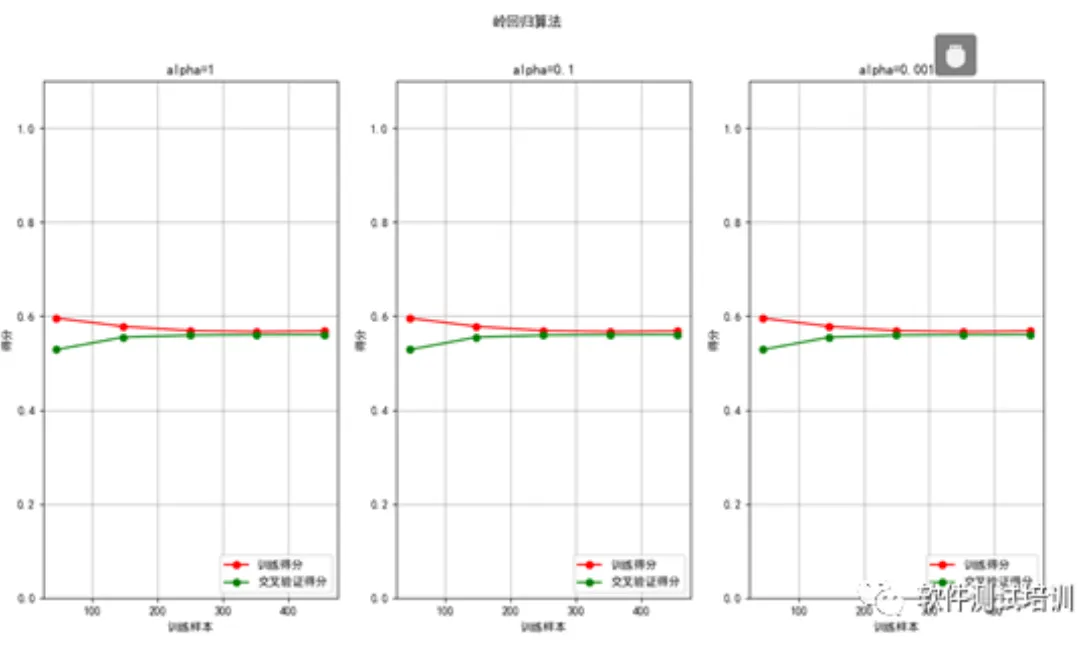
- alpha变化对整体影响不大
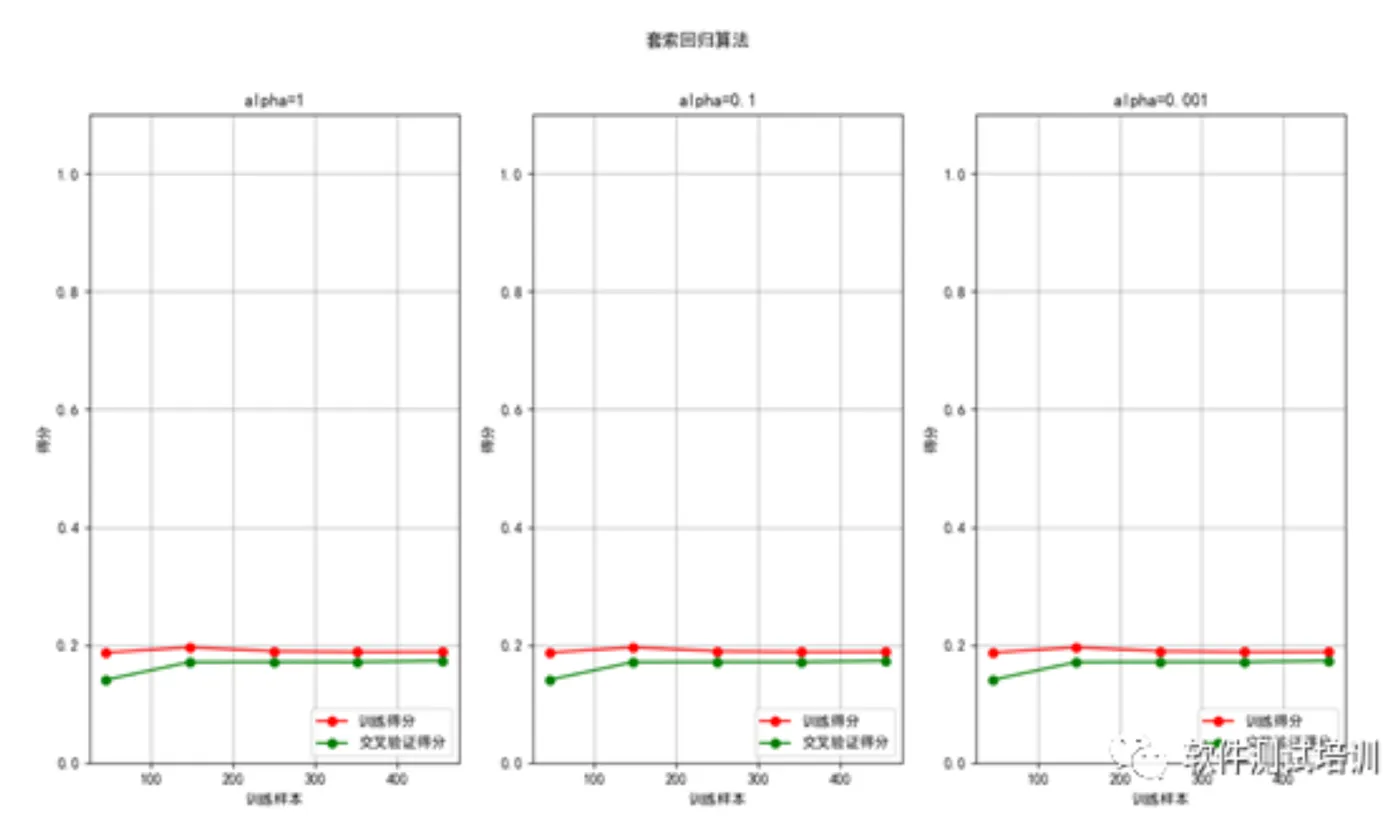
- 套索回归得分很低。
- alpha变化对整体影响不大。
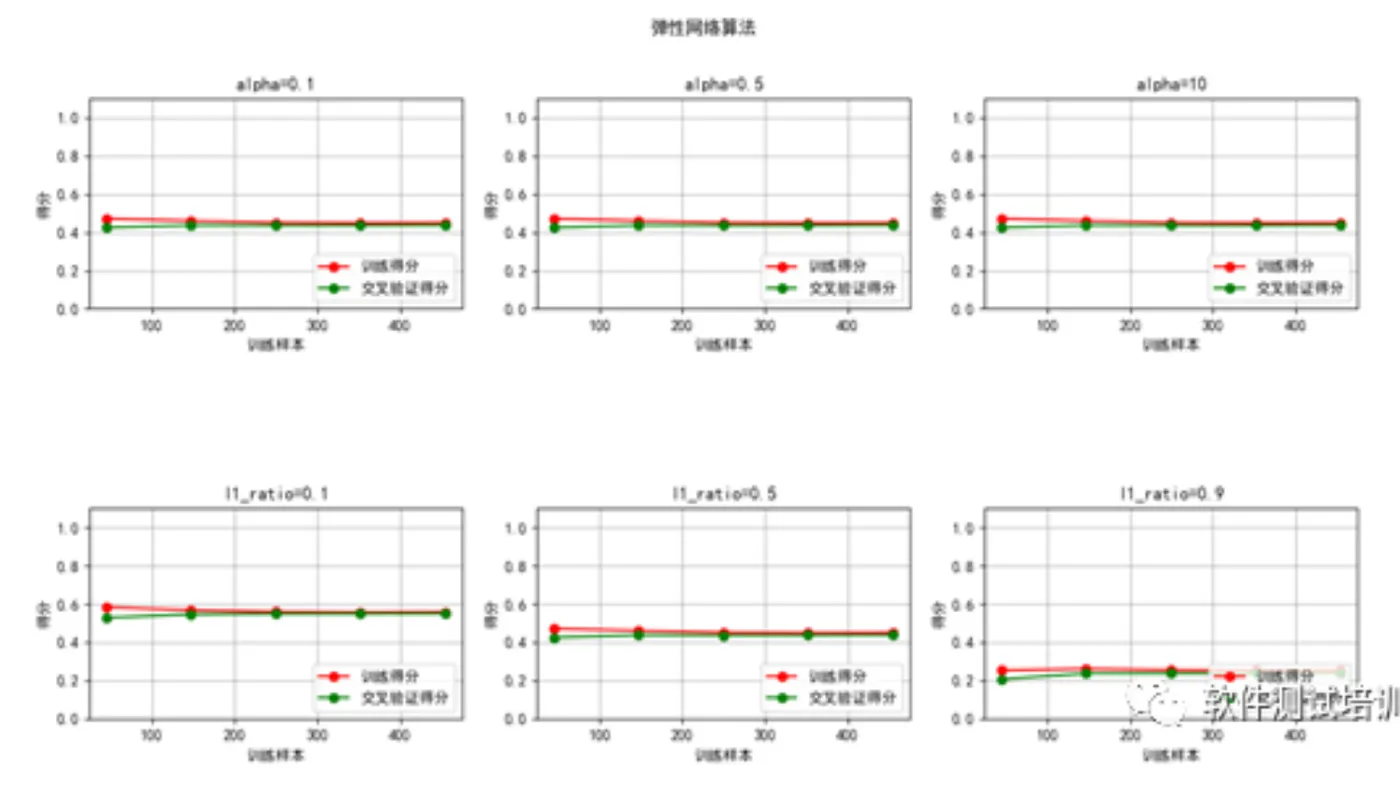
- alpha变化整体训练数据的得分与测试数据的得分影响不大。
- L1_ratio越大,训练数据的得分与测试数据的得分越低。
总体
- alpha变化整体训练数据的得分与测试数据的得分影响不大。
- 逻辑回归比线性回归训练数据的得分与测试数据的得分要高。
- 套索回归、弹性网络训练数据的得分与测试数据的得分相对比线性回归低。
2.2 随机森林
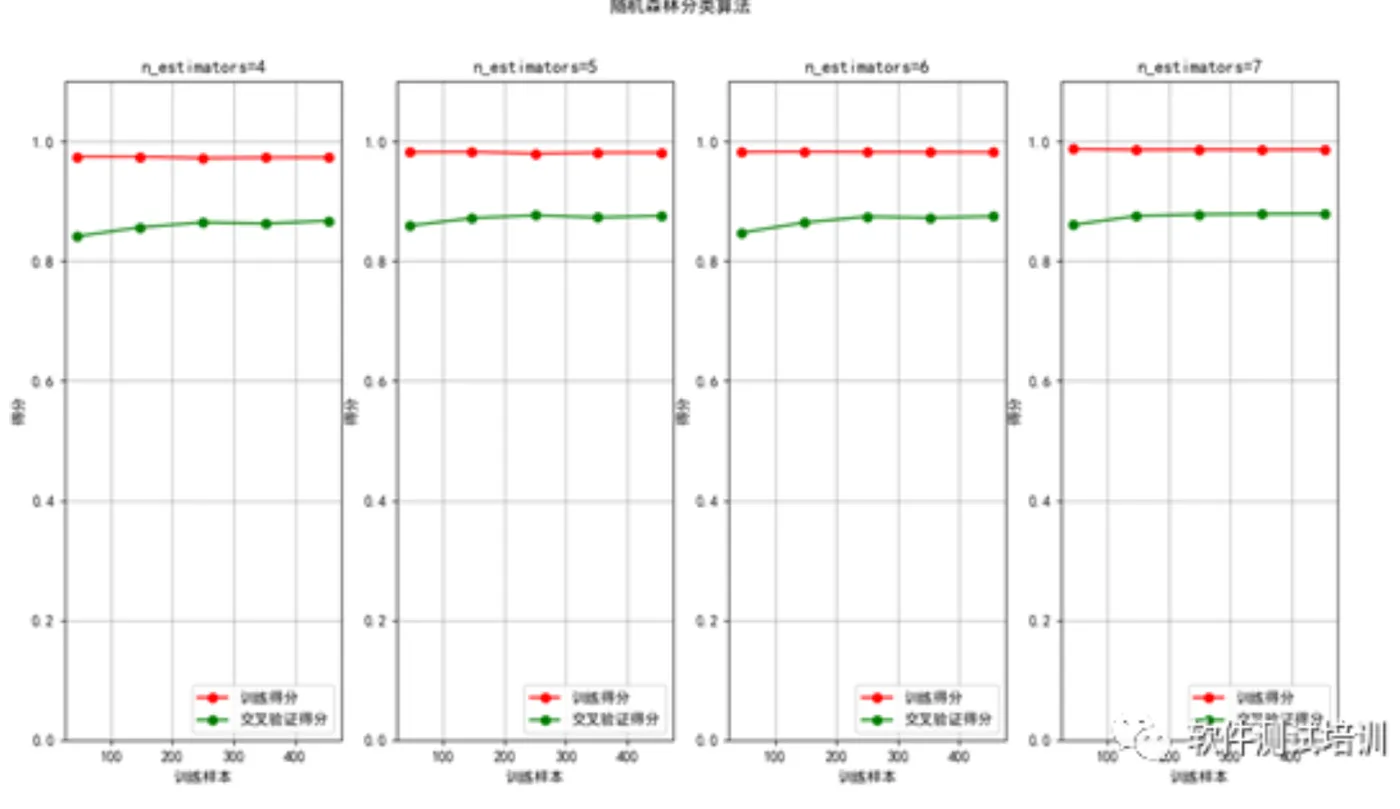
- n_estimators变化对整体训练数据的得分与测试数据的得分影响不大。
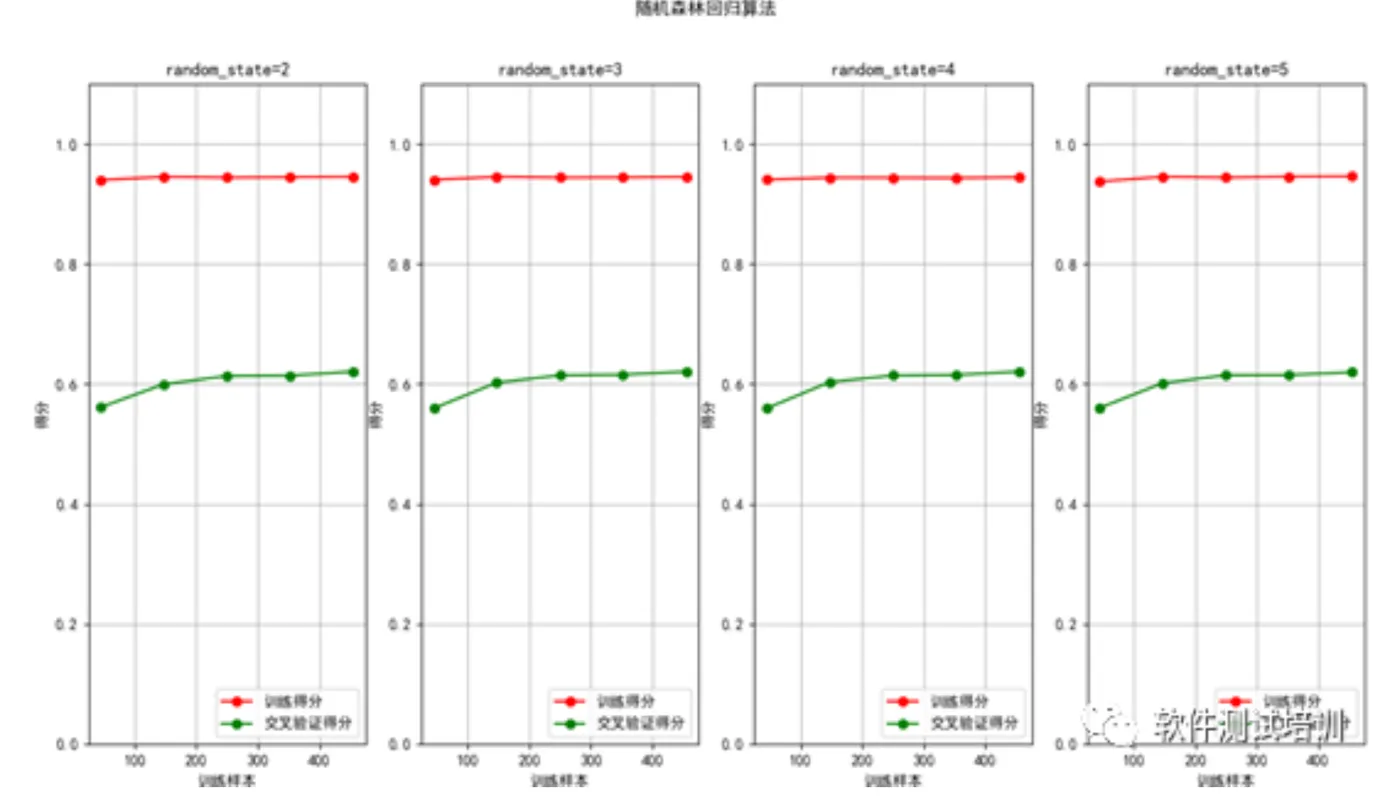
- n_estimators变化对整体训练数据的得分与测试数据的得分影响不大。
总体
- 随机森林算法明显存在过拟合现象。
2.3 决策树
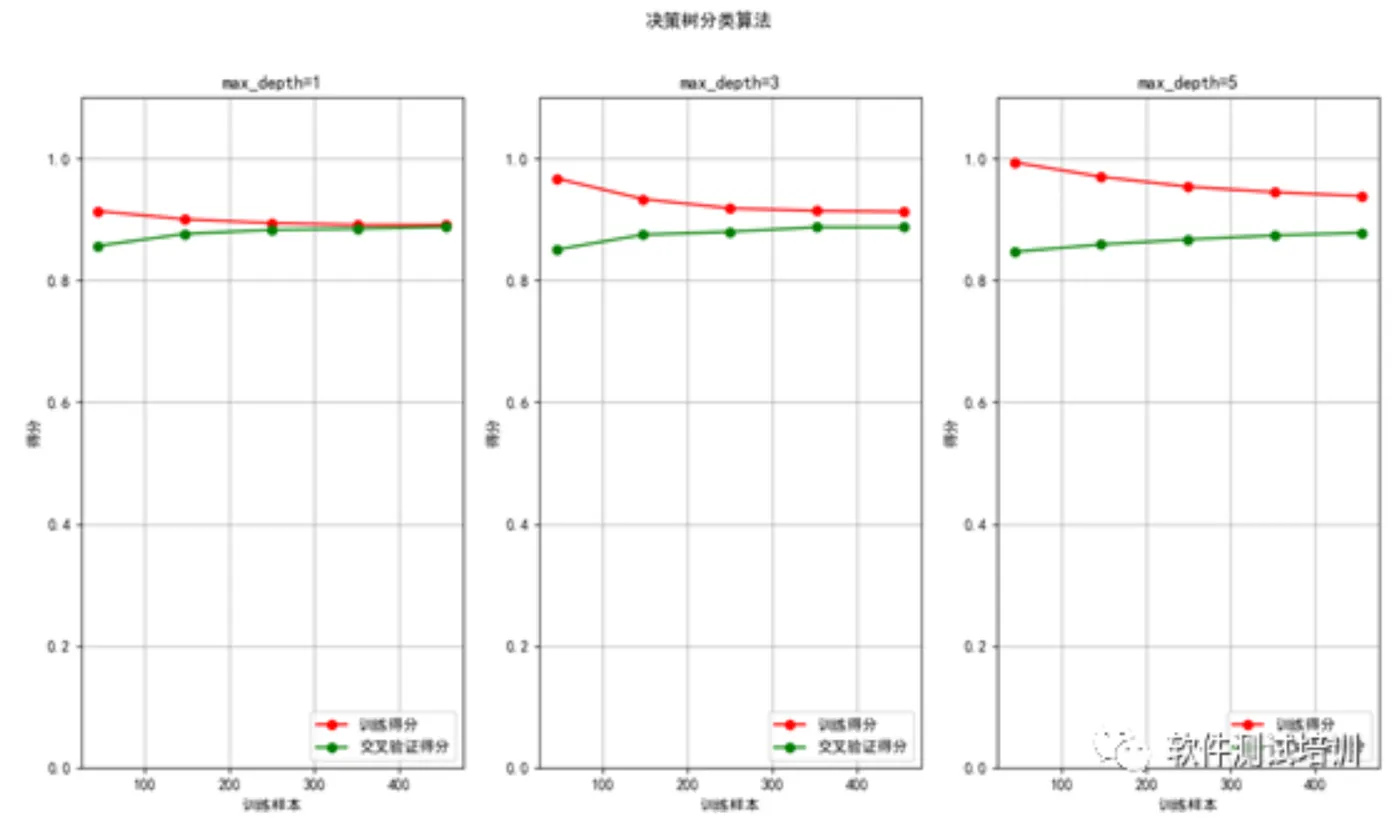
- 开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降。
- max_deep越大,过拟合现象越严重。当训练集数据多了以后,过拟合现象逐步减弱,但数据得分与训练数据相等的速度数据增大而变慢。
- 最后不管max_deep多大,最后训练数据的得分与测试数据的得分基本保持一致。
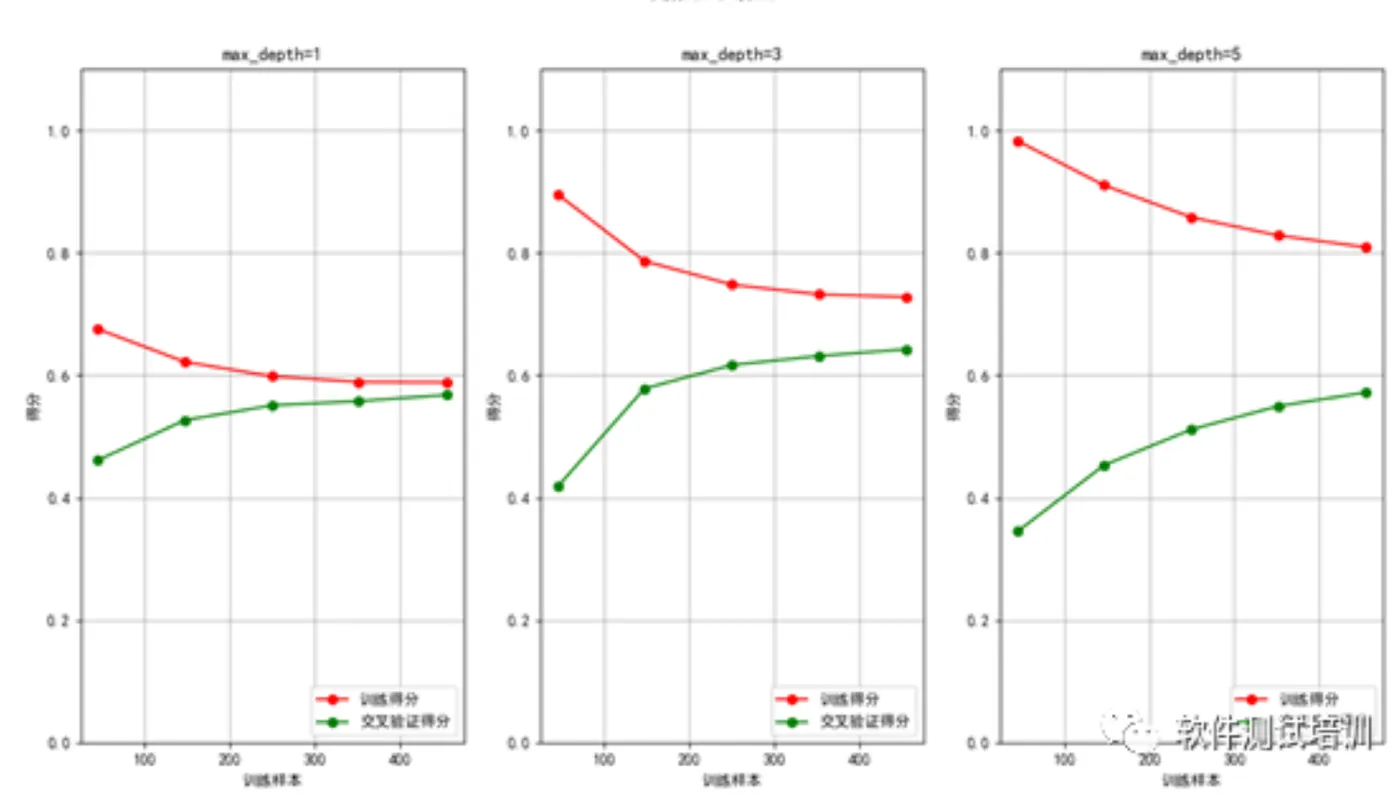
- 开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降。
- max_deep越大,过拟合现象越严重。当训练集数据多了以后,过拟合现象逐步减弱,但数据得分与训练数据差距减少的速度随max_deep的训练集数据增大而变慢。
- max_deep=3和5,数据得分与训练数据没有相等的趋势。
2.4 K邻近算法
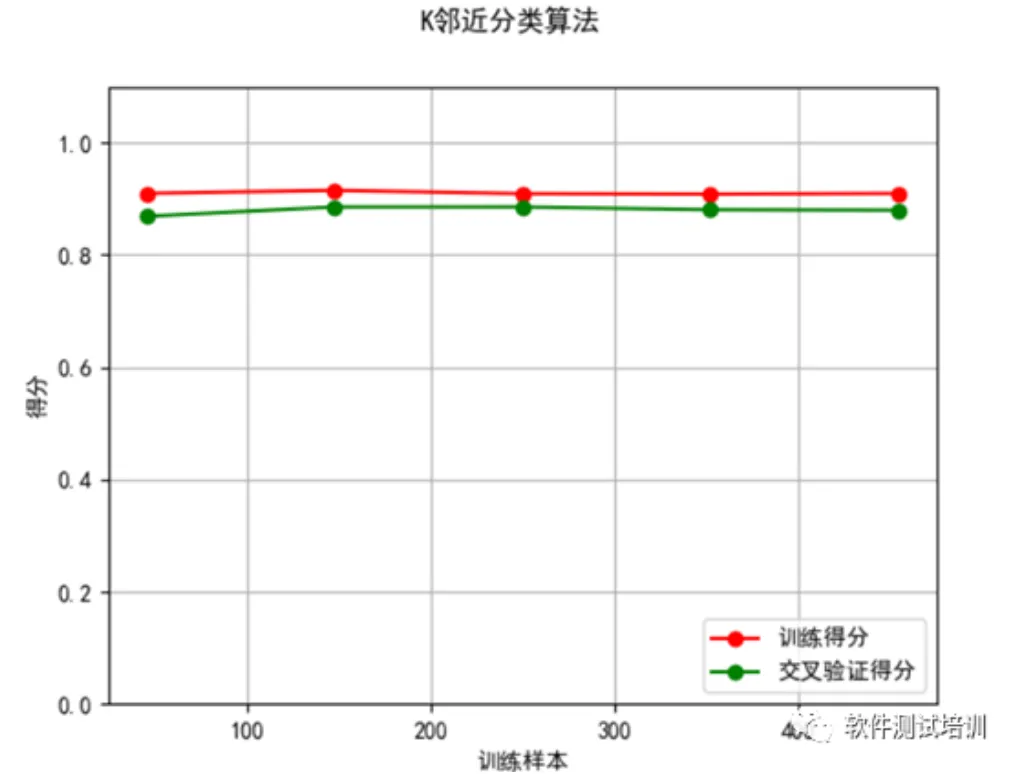
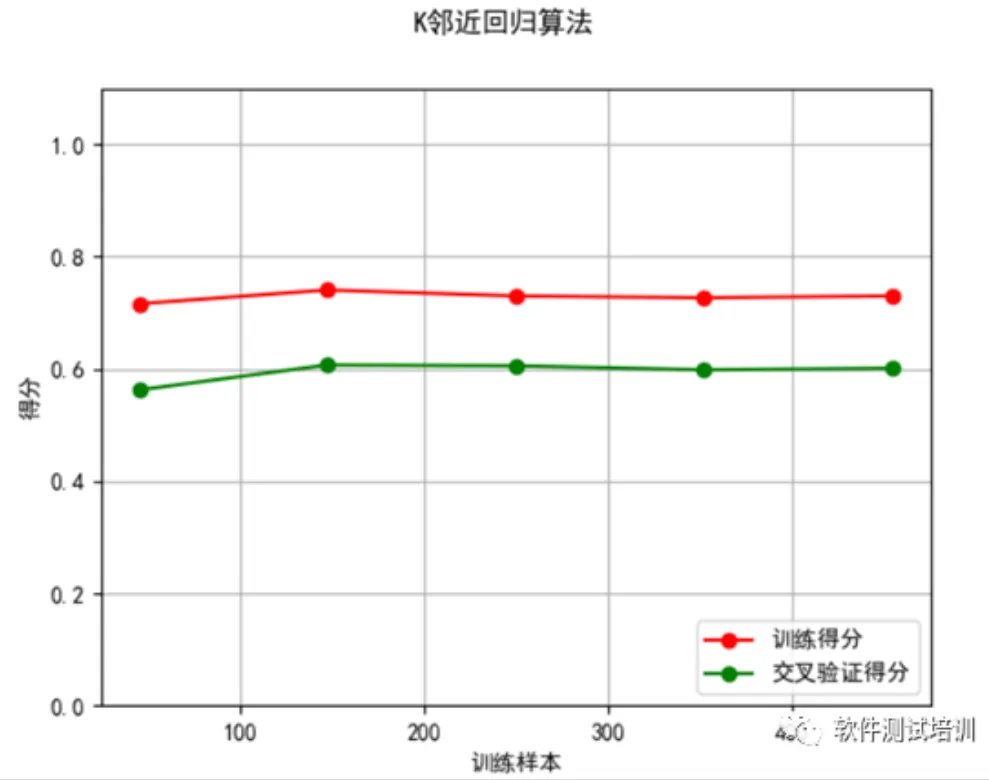
- 整个K邻近算法,存在一定的过拟合现象。K邻近回归算法更为明显。
2.5 贝叶斯算法
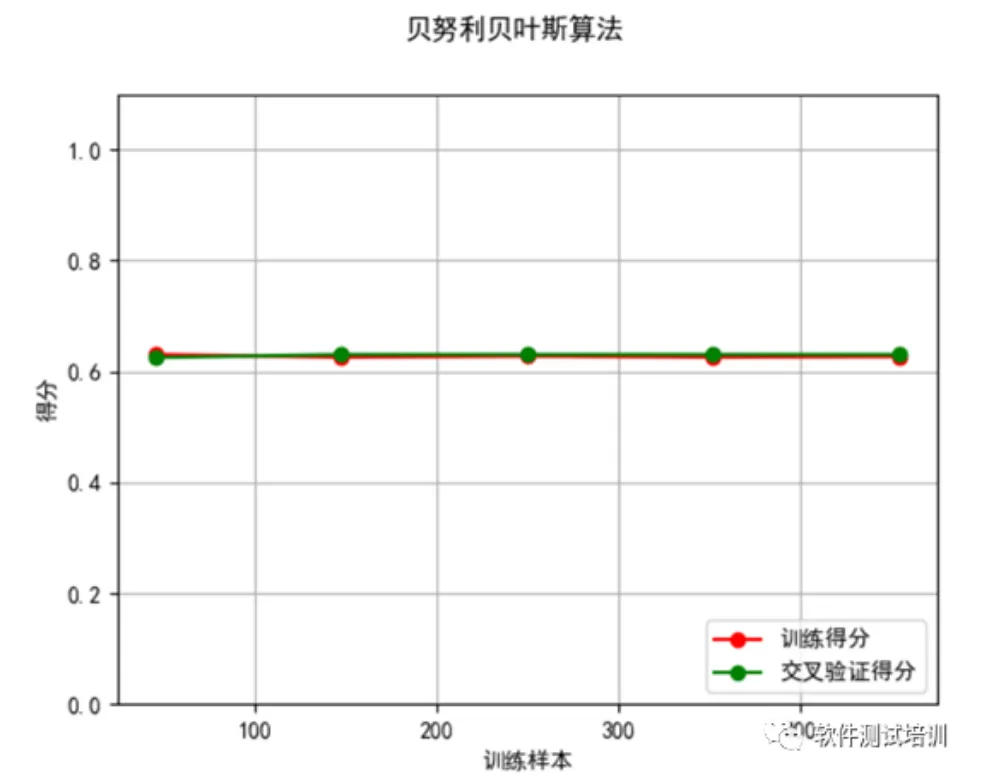
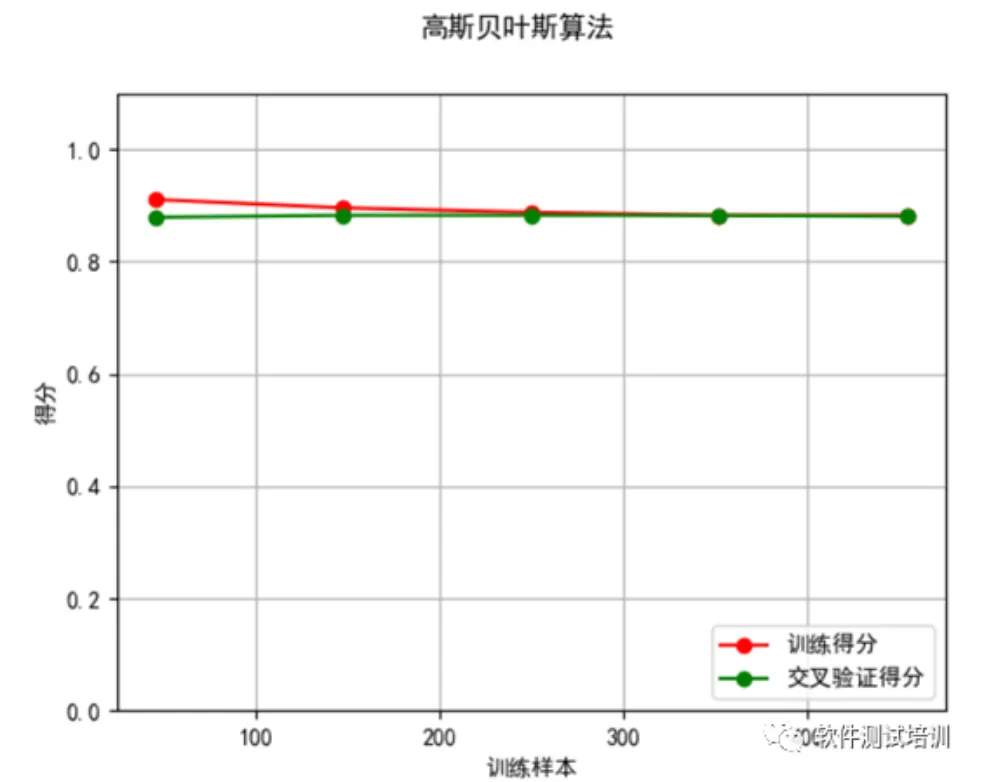
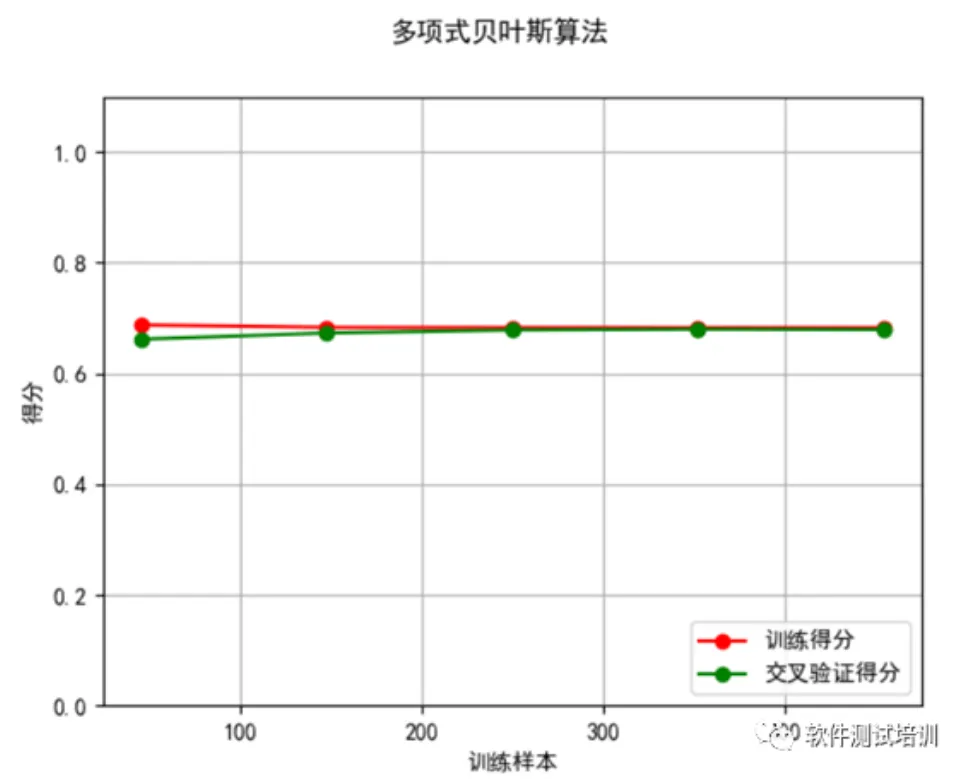
- 高斯贝叶斯算法的得分相对比较高。
- 高斯贝叶斯算法和多项式贝叶斯算法,在训练集少的时候有些过拟合趋势现象,当数据量达到150后,训练数据的得分与测试数据的得分基本保持一致。
2.6 SVM
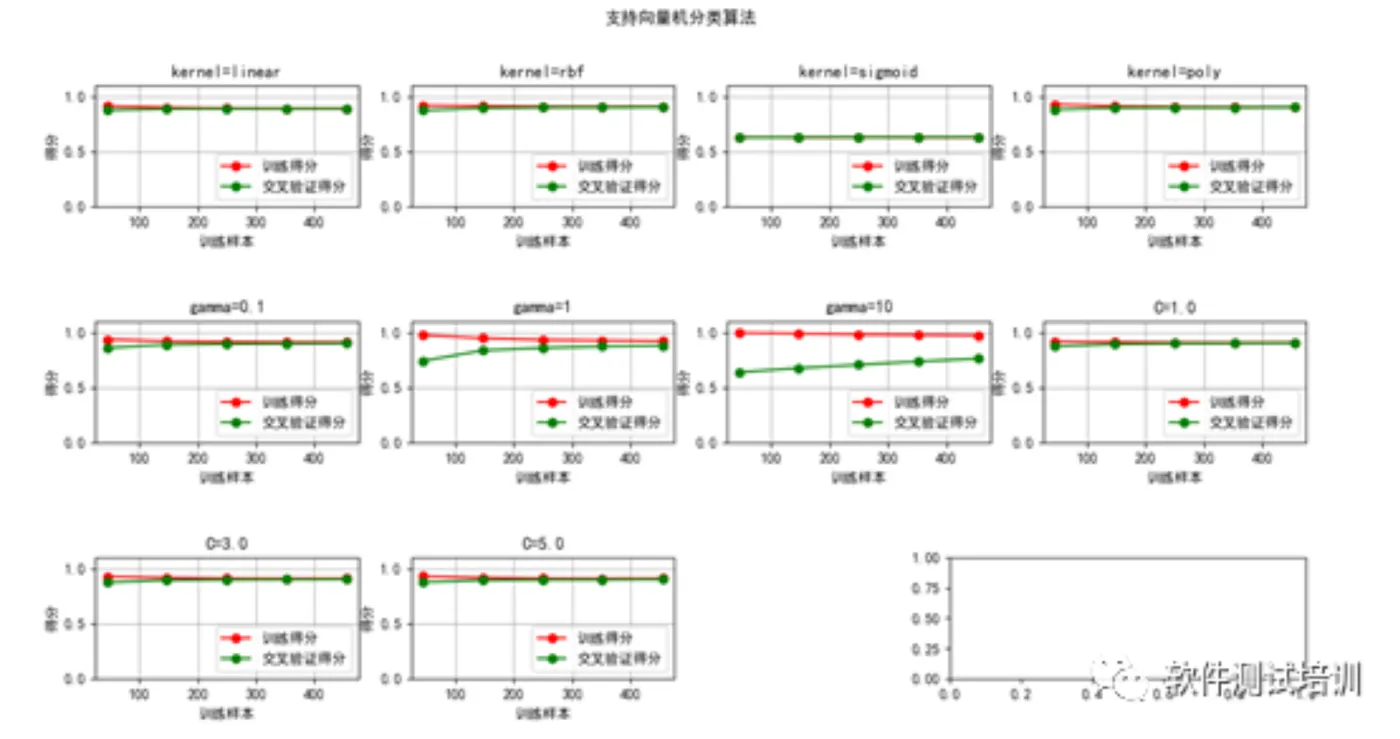
- Kernel=sigmoid时该模型对相应数据没有作用。
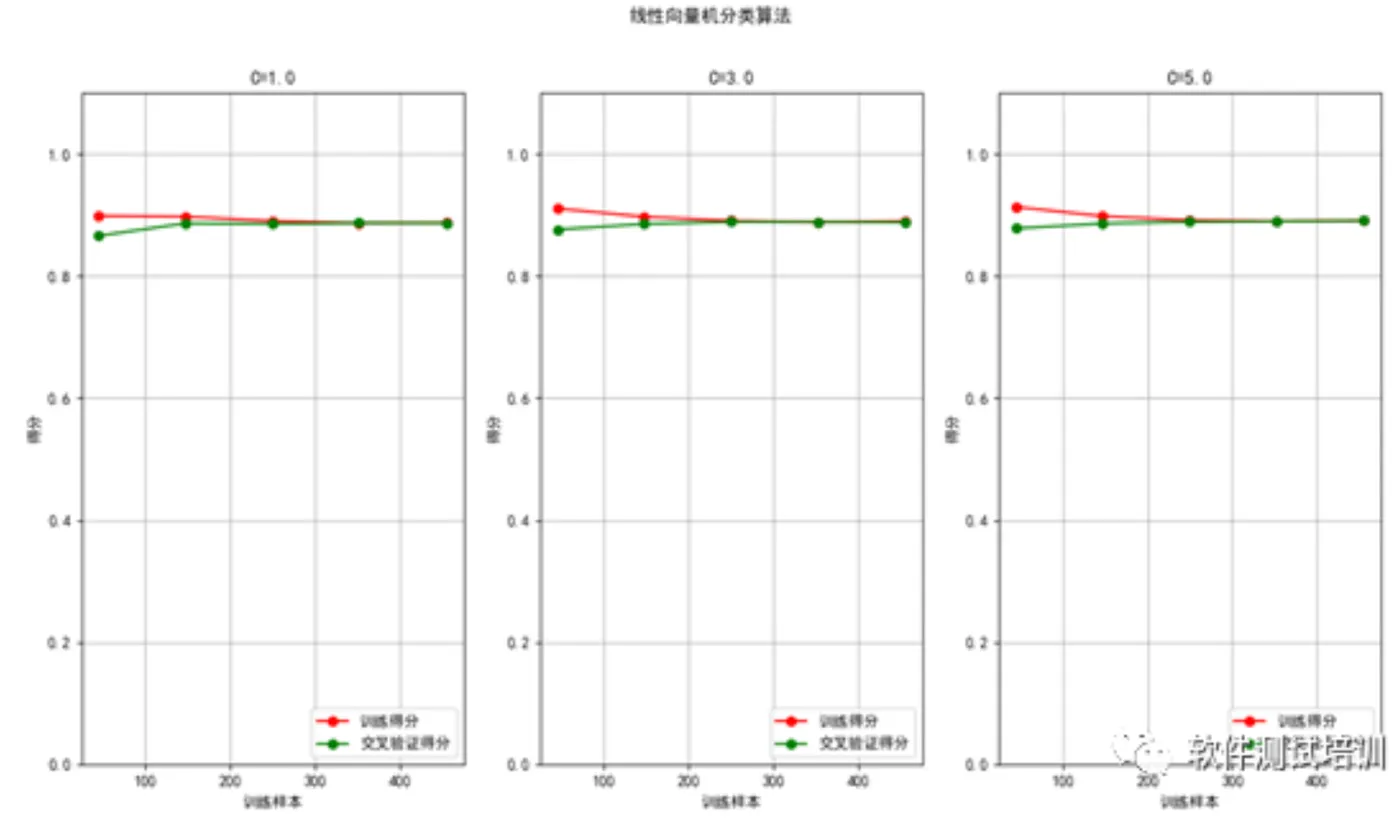
- 除了Kernel=sigmoid,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降,最后得分保持一致。
- Kernel=poly时随着训练数据的增大,测试数据得分和训练数据的得分一起快速下降
- 除了Kernel=sigmoid,训练数据的得分与测试数据的得分基本保持一致。
- 不同的gamma值,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降。
- gamma越大,过拟合现象越严重。当训练数据多了以后,过拟合现象减弱,但过拟合速度随gamma的增大而变慢。
- 不同的C值,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降,最后得分基本一致。基本达到100%。
- 不同的C值对整体的测试数据得分<训练数据得分影响不大。
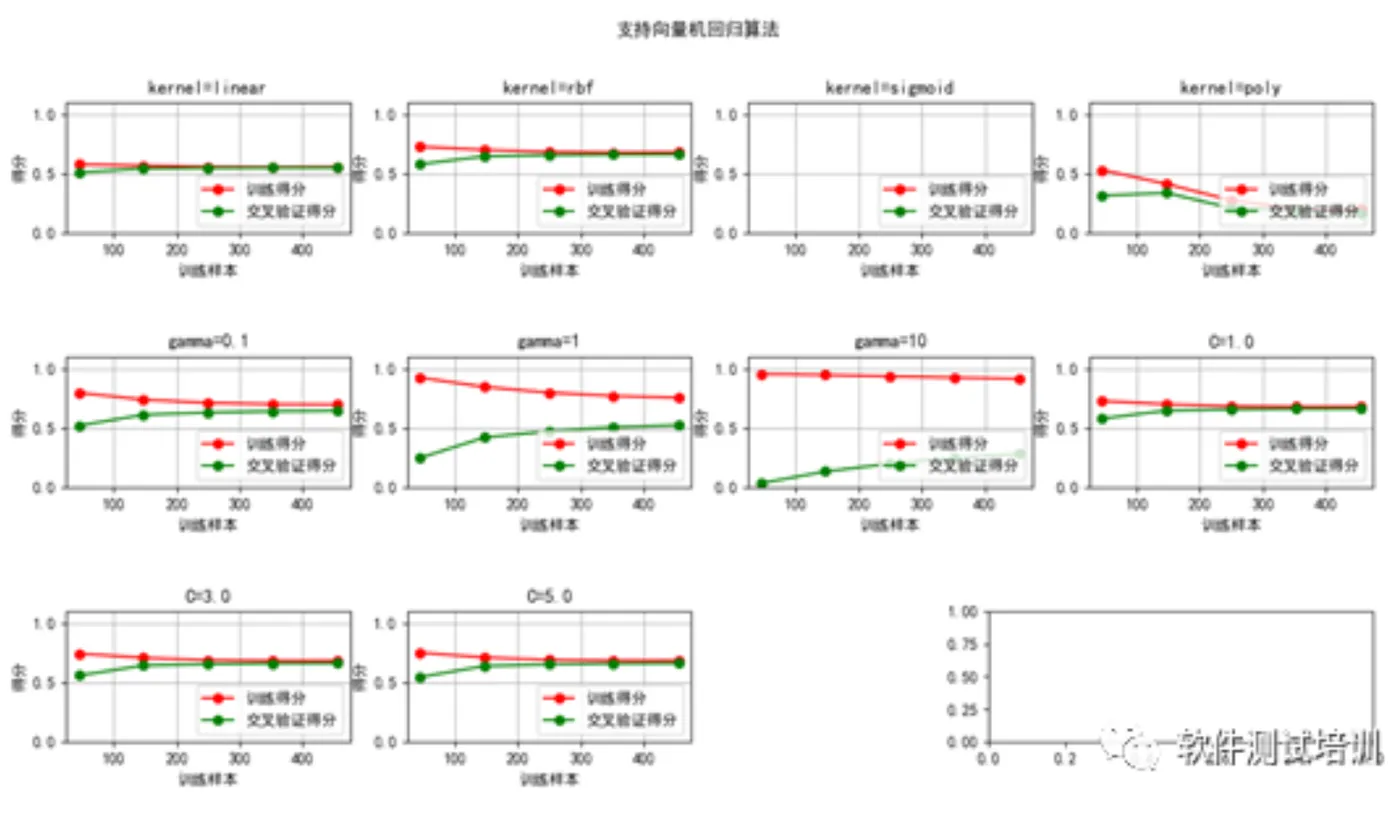
- Kernel=sigmoid时该模型对相应数据没有作用。
- Kernel=poly时,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据和训练数据的得分一起不断下降,但是当训练数据为450的时候,得分保持一致。
- Kernel=linear和rbf的时候,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降,最后得分保持一致。
- Kernel=poly时随着训练数据的增大,测试数据得分和训练数据的得分一起快速下降
- 除了Kernel=sigmoid,训练数据的得分与测试数据的得分基本保持一致。
- 不同的gamma值,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降。
- gamma越大,过拟合现象越严重。当训练数据多了以后,过拟合现象减弱,但过拟合速度随gamma的增大而变慢。
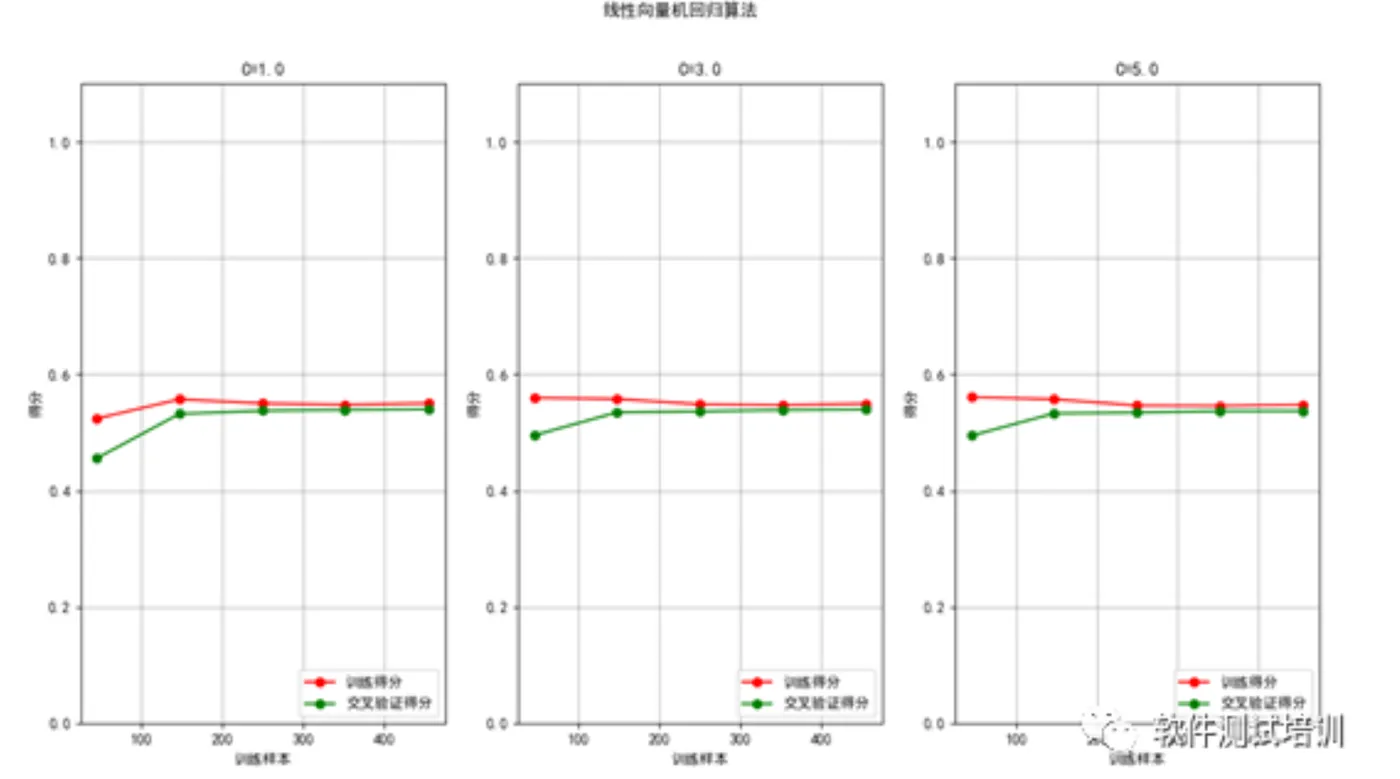
- 不同的C值,开始阶段测试数据得分<训练数据得分。随着训练数据的增加,测试数据得分不断上升,训练数据的得分不断下降,最后得分基本一致。
- 不同的C值对整体的测试数据得分<训练数据得分影响不大。
2.7 神经网络
整体运行速度相当慢
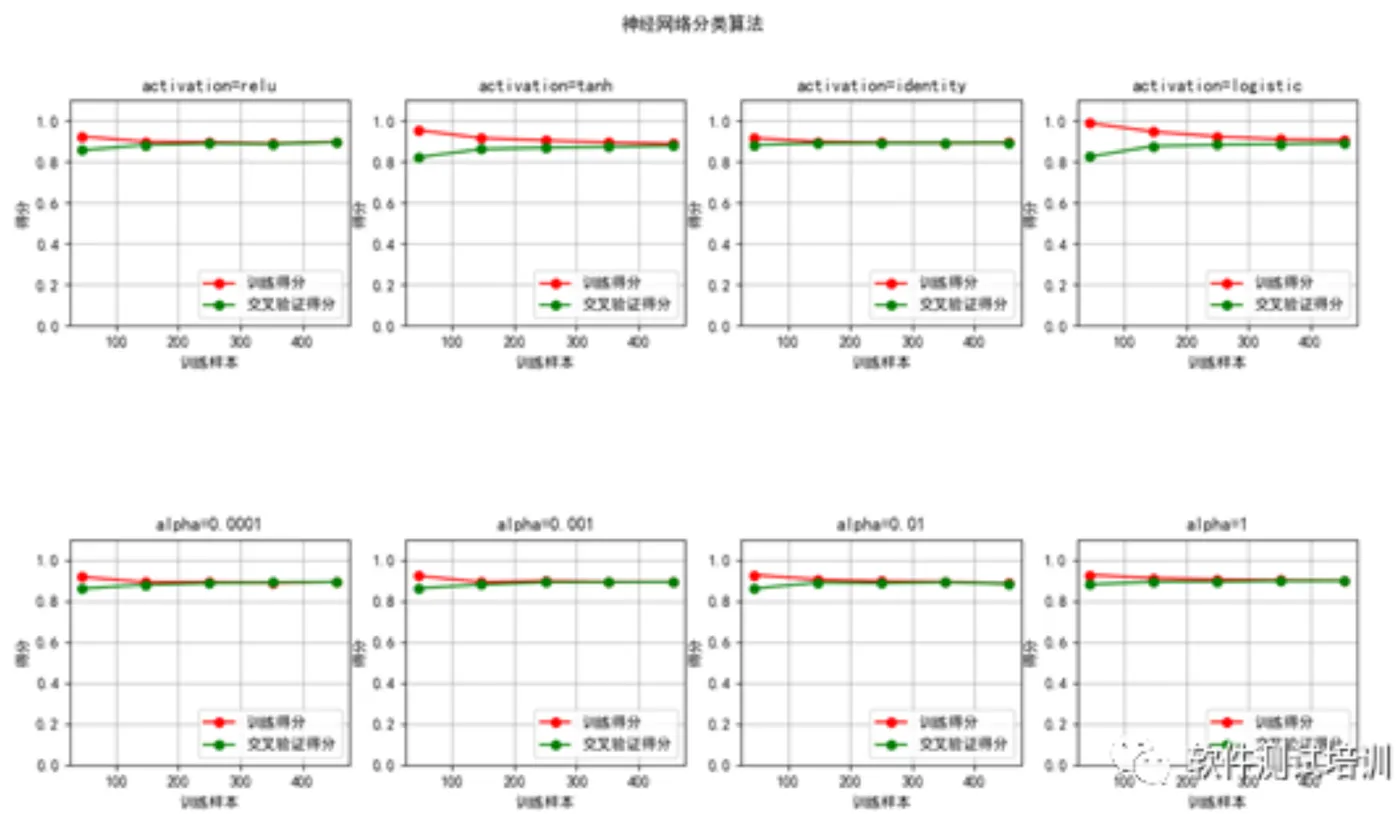
- 数据量少的时候,存在过拟合现象,当数据量增加,过拟合现象逐步消失,训练数据得分与测试数据得分保持一致,并且得分相对比较高。
- activation=relu与activation=identity,在训练集数据为150的时候,训练数据得分与测试数据得分保持一致
- activation=thanh与activation=logistic,训练数据为450左右,训练数据得分与测试数据得分保持一致。
- alpha在训练数据为150左右训练数据得分与测试数据得分保持一致。
- alpha变化对整个系统保持一致。
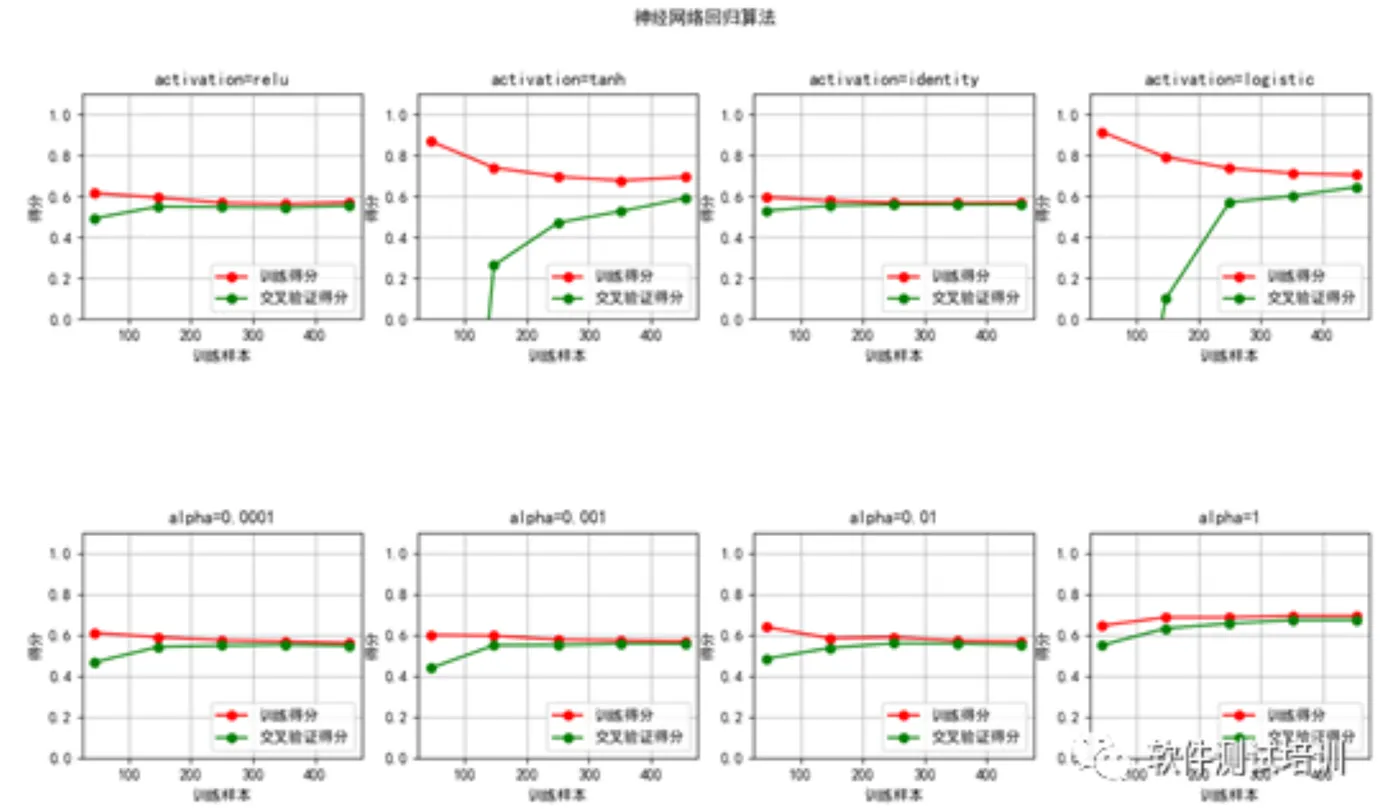
- 数据量少的时候,存在过拟合现象,当数据量增加,过拟合现象逐步消失,训练数据得分与测试数据得分保持一致,并且得分相对比较高。
- activation=relu与activation=identity,在训练集数据为150的时候,训练数据得分与测试数据得分保持一致。
- activation=thanh与activation=logistic在训练数据为150之前测试数据基本没有,训练数据到达450的时候,训练数据得分与测试数据得分基本保持一致。
- 当alpha<1的时候,随着训练样本增加训练数据得分逐步降低,测试数据逐步上升;当alpha为1的时候随着训练样本增加,训练得分和测试得分一起逐步上升,最终达成一致。
2.8 集成学习
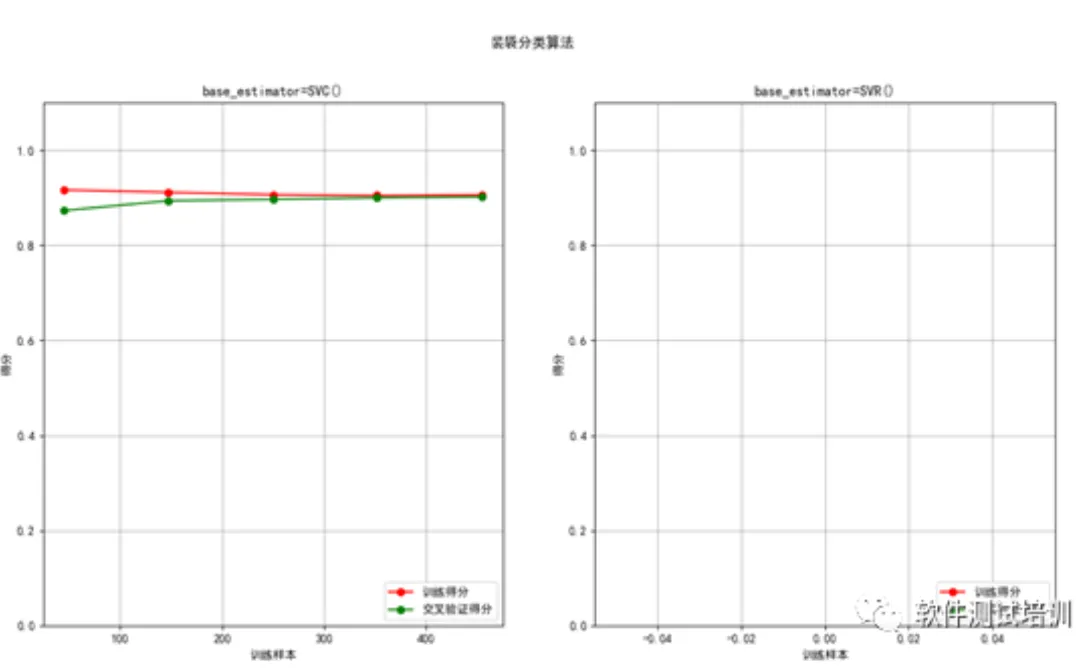
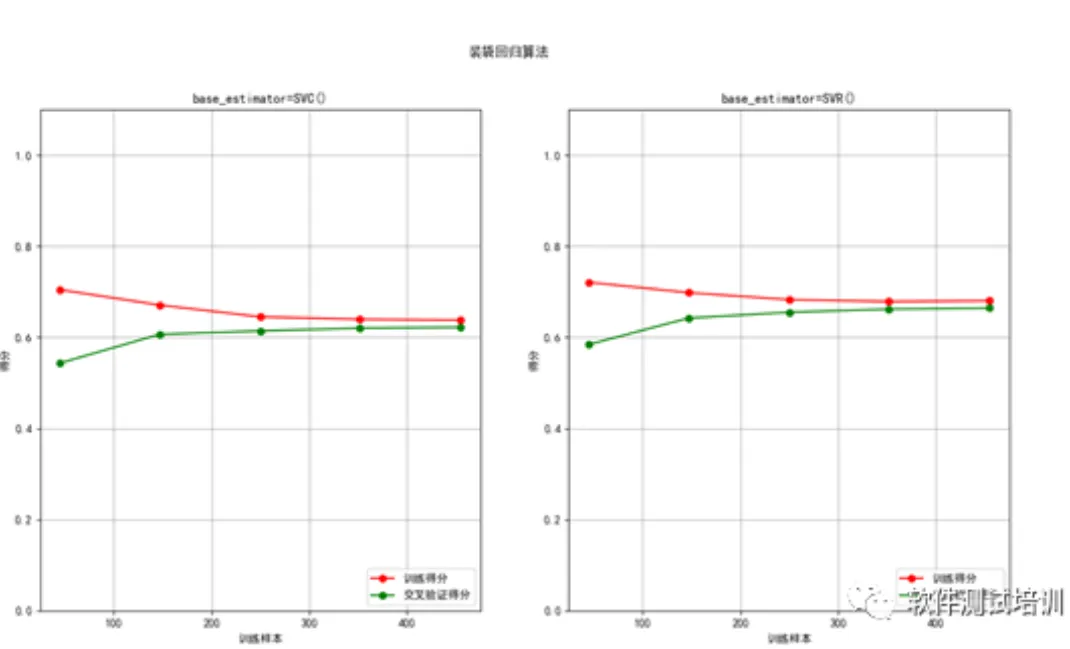
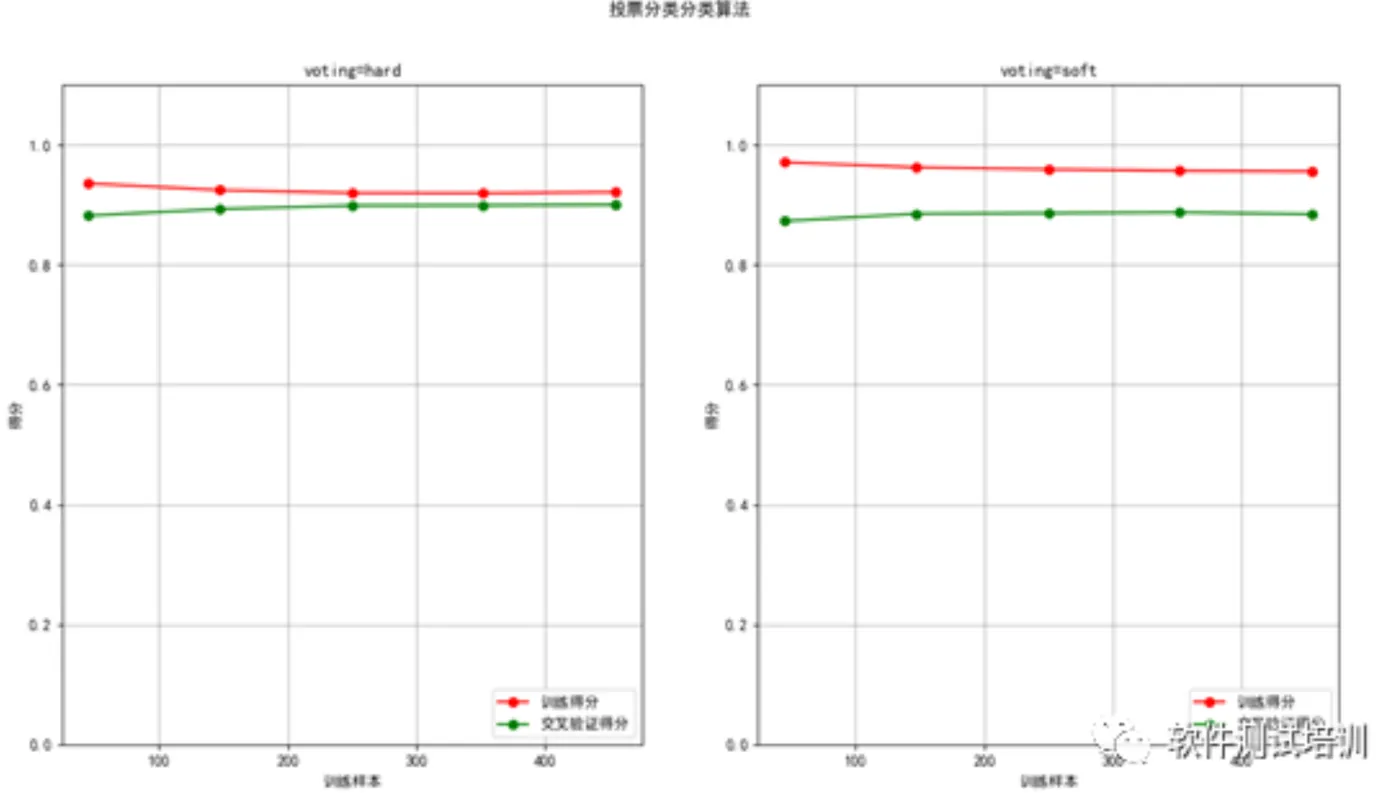
—————————————————————————————————
软件安全测试
https://study.163.com/course/courseMain.htm?courseId=1209779852&share=2&shareId=480000002205486
接口自动化测试
https://study.163.com/course/courseMain.htm?courseId=1209794815&share=2&shareId=480000002205486
DevOps 和Jenkins之DevOps
https://study.163.com/course/courseMain.htm?courseId=1209817844&share=2&shareId=480000002205486
DevOps与Jenkins 2.0之Jenkins
https://study.163.com/course/courseMain.htm?courseId=1209819843&share=2&shareId=480000002205486
Selenium自动化测试
https://study.163.com/course/courseMain.htm?courseId=1209835807&share=2&shareId=480000002205486
性能测试第1季:性能测试基础知识
https://study.163.com/course/courseMain.htm?courseId=1209852815&share=2&shareId=480000002205486
性能测试第2季:LoadRunner12使用
https://study.163.com/course/courseMain.htm?courseId=1209980013&share=2&shareId=480000002205486
性能测试第3季:JMeter工具使用
https://study.163.com/course/courseMain.htm?courseId=1209903814&share=2&shareId=480000002205486
性能测试第4季:监控与调优
https://study.163.com/course/courseMain.htm?courseId=1209959801&share=2&shareId=480000002205486
Django入门
https://study.163.com/course/courseMain.htm?courseId=1210020806&share=2&shareId=480000002205486
啄木鸟顾老师漫谈软件测试
https://study.163.com/course/courseMain.htm?courseId=1209958326&share=2&shareId=480000002205486