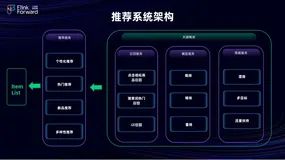
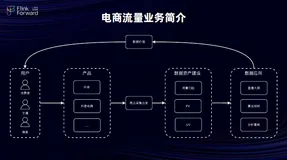
用户打开淘宝 App 时,后台会有两种类型的请求,第一种类型是满足用户诉求的自然推荐,第二种请求是满足用户和商家综合诉求的广告推荐。
例如开淘宝看到某品牌,是因为该品牌使用阿里妈妈营销产品登录后,会圈选人群进行广告投放,被圈选的人会看到该广告。

商家端营销产品的主要目标是服务于广告主,帮助广告主进行人群投放,从而提升经营效果。此类营销产品覆盖的场景非常广泛,包括人群圈选、洞察分析、Lookalike、人群推荐等场景。
这些场景会有OLAP分析、AI算法和实时特征计算的基础能力需求,基于这样一个数据+算法综合能力需求背景下,阿里妈妈自研了Dolphin引擎。

Dolphin引擎是一个分析 AI 一体化的超融合引擎,拥有OLAP 分析计算、 Streaming 流计算、 batch 批量计算和 AI 算法计算能力,这些能力基于SQL 组件和 Index Build 组件构建。
SQL 组件的主要能力是 SQL 转义、路由、负载均衡、联邦查询。 Index Build 组件主要负责智能索引、多级索引等。
Dolphin引擎主要解决两个问题,一个是超大规模场景下使用通用计算方法性能问题;第二个就是降低业务方使用引擎成本,甚至做到对底层引擎无感知。,很多通用引擎并不能直接解决业务的性能问题,因此需要对数据做索引以实现查询优化。另外,Flink Hologres存在一定的学习成本。因此,我们在 Flink 、Hologres之上搭建了这一套业务引擎,让用户使用Flink 、Hologres更简单,甚至对Flink、Hologres引擎的存在无感知。
Dolphin引擎提供了自研索引、智能物化、智能索引选择、异构数据源查询和近似计算几个功能。
智能物化指能够自动将SQL转化为物化视图,无需人工手动操作。实现方式为对业务历史查询 SQL 进行分析,比如哪些广告主对哪些时间周期的数据使用频率更高,可以选择将高频的使用数据进行物化。智能索引会分析 SQL 查询语句,判断条件命中率,推荐不同的索引,推荐目标为让索引对数据查询的过滤量最大。近似计算主要针对大规模数据,计算其近似结果。
目前,我们的业务规模为 2w+ core,每日请求量2亿+,QPS为3000+,支撑百万级广告主、PB 级数据。
另外,Dolphin 引擎是基于 Flink+ Hologres之上搭建的业务引擎,因此能够非常高效地支撑其他业务,很多业务直接对接Dolphin引擎即可直接使用 Flink+ Hologres的能力,使用成本非常低,对外支撑了阿里集团内 10 家-> + U ,支持人群圈选、洞察分析的能力。

我们对底层引擎的要求为高性能、可扩展。如果底层引擎性能不高,上层再做优化时效果会打折扣;同时,底层引擎要足够可扩展,上层才能基于底层引擎做更多改进和扩展,承接新的业务场景。而Flink和 Hologres能够满足以上两个需求。
实时引擎Flink支持低延迟,支持自动调优,且技术稳定成熟。用户在 Dolphin Streaming平台上提交 SQL 时,SQL会被转译为flink SQL,提交给Flink引擎,这里会利用Flink autoscale自动配置调优功能来自动调整,降低可了用户对 Flink 的学习成本和调优维护成本。
Dolphin引擎与 Hologres在过去四年实现了非常多共建成长。19 年,Dolphin引擎与 Hologres共建了 bitmap 计算能力,实现业界公开信息里最大规模、最高性能、最低使用成本的圈人能力;20 年共建了千万级人群中心,实现广告人群统一管理;21 年,Dolphin引擎支撑了算法业务场景,使用Hologres向量计算能力支撑算法业务,主要支撑推荐算法里粗排召回计算环节;22年,支持了算法实时特征开发能力,这里就应用到 Hologres实时写入和点查能力,实现了更高效的实时开发。最终,所有能力整合在一起,形成了超融合一体化引擎能力。

OLAP计算的核心在于解决超大规模问题。广告场景拥有整个集团的所有数据,为了让广告主有更好的用户体验,需要支持更复杂的计算和更快的速度。我们面临的业务挑战有单SQL几十张表join、单表最高万亿行规模、单表基数最高百万级和万级标签日更新。
这里有两张表,分别是用户基础表(性别年龄)和用户店铺表(用户、店铺类型),需要查询 20、 30 岁且逛过某品牌的用户数量。如果数据量很少,通用引擎可以很快得出结果。但如果SQL涉及join的表有几十张,而且还可能存在万亿级表,此类情况下通用计算引擎无法完成计算,因此我们共建了一套 bitmap 计算方案。
方案的查询流程为:用户输入逻辑执行 SQL ,Dolphin引擎将用户逻辑执行 SQL 转译为物理执行 SQL ,然后传递给 Holo Master执行。
方案的索引构建流程为:MaxCompute将标签数据进行预处理,然后将它构建为bitmap 索引,再接入到 Hologres集群里,即可实现的 bitmap 查询。
Bitmap查询拥有更好的性能和存储, QPS 200+,平均百毫秒查询性能,达到了用户交互式分析的需求。

Open API 可直接以服务接口调用的形式调用 Flink 提交作业、暂停作业等。为了降低用户的学习成本,提升开发效率,Dolphin使用OpenAPI 做了丰富的实践,开发了一套 Dolphin Streaming实时开发平台。
DolphinStreaming将 Hologres和Flink 做了封装,对用户暴露更简单的开发接口Dolphin SQL 。用户提交 Dolphin SQL 只需像使用数据库一样开发实时作业,使用数据库时直接创建一张表再写入,无需再考虑存储、配置认证信息、token信息等。
用户在阿里妈妈交互式研发平台上提交 Dolphin SQL ,通过 Dolphin Streaming 进行处理,做 SQL 解析,转译元数据管理,将 SQL 通过 OpenAPI发送给 Flink,拉起作业做执行。执行完后,数据会写到 Hologres,然后通过Dolphin SQL将写入 Hologres的特征直接查询出来,整个流程非常顺滑和简单。
demo1:计算用户最近50条行为序列
用户最近 50 条行为序列是算法序列模型里常用的特征,一般需要开发行为序列特征,如果用Dolphin Streaming 开发,只需简单三步:
第一步,定义数据源表。Biztype可直接填写为tt ,tt 是阿里的实时数据源。这里如果要写Flink SQL,则需要登入tt管理平台,查询topic并订阅subID。
第二步,定义输出表。Biztype=feature 代表写入到 Hologres,然后填好 PK 参数即可。
第三,定义计算逻辑。SQL 执行完之后,数据源源不断地写入,通过 select user_id, product_id from ** where user _id=**即可查询用户特征。
demo2:实时Debug功能。
在实时开发时,经常需要查看上游数据源,以往的方式通常需要定义一个print输出源,然后定义输入源和执行逻辑,将数据写到标准输出,再通过查看日志才能获取到上游数据源。而我们实现了更简单的方式。
通过 create table 形式注册一张表以后,执行 select user_id from某表,结果即直接展示表的明细。

广告主在使用营销平台时,面对如何推广、通过何种推广渠道等常常束手无策。我们从算法角度为广告主解决了问题。通过广告主点击某些信息、某些点位时,判断其意向,结合意向和广告主本身商家店铺和宝贝信息,为其推荐更能提升经营效果的宝贝以及效果更优的渠道。
基于以上需求,我们开发了一套用于捕获用户实时行为特征的作业。通过 Flink 计算商家实时行为日志,存储到 Hologres之后,在线模型直接读取特征,通过实时特征提升模型的推荐效果。
该方案主要使用了 Flink 实时计算、Hologres实时写入以及行表的点查能力,使整体开发效率提升三倍以上。

算法里万物皆可向量表示,尤其是在推荐算法和召回流程中,经常使用向量召回获取Top K 相似对象,这里使用到Hologres的向量召回能力。
Lookalike是广告产品的重要能力,核心是基于种子人群特征选择相似人群,为店铺拉新。原理为针对已经在店铺有过行为的用户,分析其特征,寻找与之特征相似的用户,将宝贝推广给此类用户。
基于向量的Lookalike算法实现过程如下:
第一步,广告主圈种子人群。
第二步,基于种子人群计算中心向量,再通过中心向量从整体用户里召回Top K相似的用户。
传统算法下,Dolphin会使用没有向量召回能力的传统数据库,将数据导入到数据库中。先由Dolphin查询数据库,计算种子人群中心向量。然后通过Faiss将Top K 向量查出。传统方案整体运维和管理成本较高,因此我们对其进行了升级。直接使用 Dolphin 调用 Hologres,因为Hologres能够同时支持数据库功能和向量功能,简化了计算流程。

基于 Hologres的向量召回能力,我们开发了实时向量召回,用户直接输入 SQL 即可调用底层 Hologres,Dolphin封装了容灾和负载均衡等重要能力。简单地填入参数即可完成批量向量召回的计算。

基于 Flink+ Hologres 的强大能力,我们得以建设更贴近业务领域的Dolphin引擎,主要包括基于 bitmap 的高性能 OLAP 计算、更简单灵活的实时开发能力以及基于Hologres强大的 AI 向量召回能力。
未来,我们会在智能化、一体化方面继续探索,不断提升用户体验。
Q&A
Q:优化后的向量召回也是基于Faiss做的吗?
A:不是,是基于阿里自研的向量召回库Proxima。
Q:Proxima性能相较于Faiss更优吗?
A:整体上proxima性能更好,在这里选择Hologres不是因为proxima性能,而是Hologres技术方案架构更简单,运维管理成本更低。