

【视觉智能产品速递——人物动漫化能力上新】
VIAPI—人物动漫化!新增风格版本发布。 产品功能:人物动漫化——输入一张人物图像,生成其二次元卡通形象,返回卡通化后的结果图像。 🔥🔥🔥 本次更新风格:国风工笔画、港漫风
让梦境绘入现实--AIGC人像绘画
在光怪陆离的梦境中,我们可以摆脱客观事实的约束,对自己的外在形象进行天马行空的畅想,有人化身威风凛凛的将军驰骋疆场,又有人化身亭亭玉立的公主正襟危坐,然而这些翩若惊鸿婉若游龙的美好瞬间却总是会随着一声闹钟的响声化为泡影。难道梦境中的自己总是不能被带回到现实之中吗?AIGC技术的快速发展使得这一点成为可能。
多种模态控制的背景生成技术
在保持输入主体不变的情况下生成背景的需求广泛存在,可用于海报生成、商品换背景多种场景。本文介绍一种使用扩散模型生成背景的技术,背景生成内容可接受图像、文字prompt和图像边缘edge等3中不同的引导方式,这些引导方式可以组合使用,灵活的控制生成背景的内容。该模型具有很好的通用性,对主体内容无限制,适用各种不同的图像主体,例如各类商品、动物甚至人像等。
FaceChain应用生态爆发?无限可能的人物应用等你加入探索!
在过去的不到一个月,FaceChain开源项目从无到有,成功突破了相关技术瓶颈,GitHub获得了超过4.6K star,为未来的应用发展奠定了坚实的基础。 本文将介绍我们已经实现的一些核心功能、,以及未来一些场景的设想。文章末尾,诚邀有意向有能力的开发者加入我们!
本地生活技术雷达——生成式AI(Generative AI)在阿里本地生活的应用与思考
本地生活技术雷达是由本地生活技术中心战略管理&PMO团队开展的,定期扫描和评估新兴技术的战略研究工作。目的是对技术趋势进行前瞻性预判,提出新技术布局建议,在技术驱动业务创新和业务增长、践行社会责任等方面有一些实质性探索。 本篇尝试探讨 1)理解AI范式——从分析型(Analytical AI)到生成式(Generative AI)的拐点在2022年,其对人类社会以及商业模式的长期影响; 2)生成式AI(文生文、文生图、图生图等)在本地业务目前场景的应用和未来的方向。 欢迎技术、产品、运营、战略、管理层、国内国际等各种视角的指点和碰撞!
【OpenVI—AI热点日报】9月13日
AI热点日报隆重推出! 我们汇集了最新的AI热点信息、最新论文和观点,为您提供最前沿的AI领域资讯。 (往期链接请在子社区查看官方博文哦~)

【阿里云OpenVI-视觉生产系列之图片上色】照片真实感上色算法DDColor ICCV2023论文深入解读
图像上色是老照片修复的一个关键步骤,本文介绍发表在 ICCV 2023 上的最新上色论文 DDColor
AIGC玩转卡通化技术实践
伴随着持续不断的AIGC浪潮,越来越多的AI生成玩法正在被广大爱好者定义和提出,图像卡通化(动漫化)基于其还原效果高,风格种类丰富等特点而备受青睐。早在几年前,伴随着GAN网络的兴起,卡通化就曾经风靡一时。而今,伴随着AIGC技术的兴起和不断发展,扩散生成模型为卡通化风格和提供了更多的创意和生成的可能性。本文就将详细介绍达摩院开放视觉团队的卡通化技术实践。

ChatGPT最强专业学习资料集锦
本文旨在整理一份可供参考和学习的专业ChatGPT相关资料,包括ChatGPT相关论文、Github项目、以及当前市场上出现的ChatGPT相关产品等。

【IJCAI 2023】流感知优化之 DAMO-StreamNet 论文解读
传统视频目标检测(Video Object Detection, VOD)是离线(offline)的检测任务,即仅考虑算法的检测精度,未考虑算法的延时。流感知(Streaming Perception)任务作为VOD的一个细分方向,采用流平均精度(Streaming Average Precision, sAP)指标,衡量算法的在线(online)检测能力,即同时衡量算法的精度和延时。本文针对现有的流感知工作在训练方式和模型感受野两方面的不足,提出了DAMO-StreamNet,在保证算法实时性的前提下,实现了SOTA的性能。
AI人像特效之「一键生成N次元虚拟形象」
为了零成本低门槛地提供极致酷炫的人像玩法,我们提出了一套人像风格化通用框架「AI Maleonn」AI 版神笔马良,用于一键生成风格百变的人物虚拟形象,在风格上涵盖手绘、3D、日漫、艺术特效、铅笔画等多种风格,同时可以支持面向小样本的专属风格定制,利用少量目标风格图即可实现快速迁移拓展;在处理维度上,不仅适用于生成头部效果,更支持全图精细化纹理转换,兼容多人场景;在模型鲁棒性上,有效克服了多角度姿态、面部遮挡等各类复杂场景,整体稳定性大大提升。

【视觉智能开放平台】出品智能修图技术—智能转档算法
RAW转档是专业级摄影后期修图的必备环节,旨在将拍摄的RAW图转化为细节丰富,色彩准确的JPG原片,方便修图师基于转档结果进行更为个性化和精细化的美化操作。由于对效果的精准要求和流程的把控需求,目前修图师主要利用专业软件进行人工转档操作。整个过程耗时又费力,极大降低了后期修图的交付效率。为了赋能修图师,提升他们的工作效率,本文提出了一种基于数据驱动,自动转档的技术方案,以实现人工RAW转档的替代。

WordArt Designer:基于用户驱动与大语言模型的艺术字生成
本文介绍了一个基于用户驱动,依赖于大型语言模型(LLMs)的艺术字生成框架WordArt Designer。该系统包含四个关键模块:LLM引擎、SemTypo、Stlytypo和TextTypo模块。由gpt-3.5 turbo驱动的LLM引擎可以解释用户输入,从而将抽象概念转化为具体的设计。SemTypo模块使用语义概念优化字体设计,在艺术转换和可读性之间取得平衡。在SemTypo的基础上,StyTypo模块辅助生成精细的图像。TextTypo模块通过纹理渲染进一步生成创造性纹理字体。
AI局部改图:遮罩为什么容易出黑块,画圈标注加提示词怎么写
GPT Image这类模型的遮罩容易出黑块,改动也会越过边界。本文用一张客厅图片实测另一种做法:在图上画圈、画框做标注,再用一句提示词说明改成什么,并总结提示词的写法。
复杂居家场景下的多宠识别与健康感知:生物特征融合、时序追踪及智能硬件协同
多宠家庭场景下,传统监控设备仅能采集视频画面,难以区分外观相近的宠物个体,容易造成行为数据归属混乱、健康事件错配、联动设备误触发等问题。当前行业已形成一类面向边缘硬件的多模态宠物视觉感知技术路线,通过融合犬只鼻纹、面部关键点等生物特征,结合肢体姿态时序追踪、多帧特征融合等策略,在暗光、局部遮挡、宠物体态随时间变化等复杂居家条件下完成个体识别。这类系统普遍采用端云协同架构,将基础检测、身份比对、轨迹追踪部署在本地设备,在保障实时响应的同时降低原始图像上传带来的隐私风险。
一张图片生成GIF的四种技术路线:裁剪拼帧、序列帧切分、多帧生成模型、视频模型转码
把一张静态图片变成GIF,关键是帧从哪里来。本文按帧的来源分成四条路线:裁剪拼帧、序列帧切分、多帧生成模型直接输出GIF、视频模型生成后转GIF,说明各自的原理、关键参数和适用范围,并附ffmpeg转码参数。
解决密集鸟群统计难题:检测跟踪与密度估计的自适应融合方案
鸟类AI计数面临密集遮挡、小目标漏检与高算力瓶颈。主流方案分两类:目标检测跟踪(YOLO+ByteTrack)适合稀疏场景,可获个体轨迹但易漏检;密度估计(如CSRNet)直接回归密度图,高效精准统计大规模集群,已成为高密度鸟群计数的首选技术。(239字)
端侧AI鸟类识别出海工程建议:规则解耦、区域物种包与合规预检实现
本文围绕合规红线、本地化适配、落地流程展开,介绍将合规策略从固件解耦、独立热更新的端侧预检架构,以及区域物种扩展包、保护拦截率专项验收、端侧轻量化推理等工程方案,为鸟类识别算法、观鸟智能硬件团队提供一套可复用的欧美出海合规与本地化落地路径。
用AI修老照片:一段提示词去划痕、上色,人脸不走样
老照片常见划痕、水渍、发黄,很多还是黑白的。这篇给出一段图生图修复提示词,讲清楚为什么这样写才能让人脸不走样,以及不同的照片各加哪一句。
GPT Image 2.6实测:静态图和2.5差不多,新加的GIF能做表情包
GPT Image 2.6和2.5用同样的提示词对比:静态图差别不大,带字的排版图2.6稍好;新加的GIF功能做表情包够用,但最多16帧,画面会抖。附几条用2.6做GIF的提示词技巧。
浏览器端视频转GIF的实现:canvas抽帧加gif.js编码,10组参数实测GIF体积
在浏览器里用canvas抽帧、gif.js编码,把视频转成GIF。介绍seek抽帧的实现和常见问题,并用同一段5秒视频实测10组参数的GIF体积。
核验留档技术方案:团队交接中的证据选择与复查约束
文件处理核验进入团队交接后,难点是让没有参与操作的人理解材料能说明什么。本文按协作需求、证据选择、记录字段与复查约束,整理一套留档方案,说明页面截图、HAR与处理条件各自的边界;未包含实测数据。
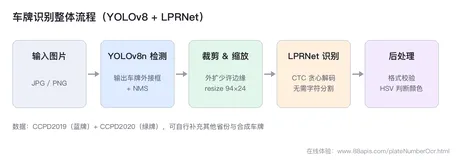
从零实现中文车牌识别:YOLOv8 + LPRNet 训练、ONNX 部署与云端 API 接入实践
本文基于开源的 YOLOv8 和 LPRNet,完整实现一套中文车牌检测与识别流程,内容包括 CCPD 数据集处理、检测模型训练、CTC 字符识别原理、ONNX 推理部署和车牌颜色判断,并对比了自建模型与调用云市场 API 两种落地方式,给出各自适用的场景。文中代码均可直接运行。
AI生成口播数字人越来越方便了
阿里数字人服务:输入文案/录音/照片/PPT,秒生成开口说话的数字人视频。支持克隆形象、照片驱动、PPT讲解三模式,自选模板、背景、字幕与方言,按分钟计费(0.5元起)。所有参数均源自真实技术限制,非宣传口径。(240字)
宠物面部识别鲁棒性优化:多策略融合与边缘部署实践
本文探讨智慧养宠中宠物面部识别的鲁棒性提升策略,聚焦非合作场景下的光照多变、姿态随意等核心挑战。系统梳理数据增强、光照归一化、姿态校正、模型优化、多任务学习等关键技术路径,兼顾精度与边缘部署需求,助力实现“任意角度、任意光照下精准识宠”。
实战复盘:用AI做AI漫剧亏损归因分析,从扒数据到出可视化报告全流程
这是一份用AI完成的AI漫剧亏损归因实战报告:涵盖数据采集、建模分析(Python量化回本门槛)、五重挤压归因、多载体交付(HTML/PDF/Word)及6条可复用运营规律,全程开源可验证。(239字)
技术方案:从HAR线索还原端侧推理会话边界
收到一份HAR记录时,如何还原端侧推理会话的边界?本文按请求方向、响应体积、Timing、Mime Type以及Request Body、Response Body是否可见逐项说明能判断什么、不能判断什么,区分模型资源与用户文件流向,并说明缓存推断需要的处理条件。相关方法为建议流程,未包含实测数据。
高效率办公PDF批量处理:批量合并多文件夹中相同文件名为独立PDF,咕嘎同名文件合并系统应用案例
咕嘎批量合并系统专为办公归档设计,支持跨多级文件夹扫描PDF/图片,按文件名完全相同或关键字自动分组,一键合并为单个PDF。适配合同、发票、课件、图纸等场景,效率提升10倍以上。
想把几个动作片段接起来给 AI 参考,怎么做?
先把各段统一到相同尺寸、帧率和像素格式,再按顺序拼接,核对接点后提取控制素材。本文给出 ffmpeg 命令、时间表与合成素材 CPU 验证。
没有网络的电脑,怎样准备动作提取环境?
先按目标机器的系统、架构、Python 和运行设备准备完整 wheelhouse、两份 ONNX 模型、ffmpeg 与 SHA 清单,再断网安装并分别验收依赖、模型加载和动作输出。本文为固定版本的准备方案。
茶叶采摘点识别 嫩芽图像识别 机器人采茶点识别 AI图像数据集
# 茶叶实例分割数据集 | 项目 | 详情 | | -------- | ---------------------- | | 任务类型 | 实例分割 | | 图片总量 | 13000张 | | 分类数量 | 1类 | | 标注格式 | YOLO txt | |
动作参考换了设置,怎样查清结果为什么不同?
把参考片、提取配置、原始深度、控制片与生成请求关联归档,再用只改一个因素的对照追查结果差异。提供 ReShot 0.5.0 命令与实验记录模板。
Windows 下 YOLO26 的 TensorRT C++ 部署
本文详解Windows下基于TensorRT 10.16的YOLO26 C++部署全流程:涵盖VS2022/CUDA 12.9/OpenCV 4.8.1环境搭建、FP32/FP16/INT8模型导出与Engine序列化、命令行推理及自训练模型部署。实测单帧推理仅约1.4ms,速度较ultralytics Python提升14倍。
给AI视频准备的动作参考抖动、慢半拍,怎么办?
给 AI 视频准备动作参考时,先用同一片段的稳定版与原始版区分关节抖动、动作跟随迟滞和显隐闪烁。本文给出 ReShot 0.5.0 对照命令、动作时点记录表与已有实验的正确读法。
做AI视频时,线稿太乱、主体看不清怎么办?
AI视频线稿杂乱或主体轮廓断裂时,可固定同一参考片和输出设置,分别调整Canny阈值,记录轮廓、干扰线与播放稳定性,选出适合交接的控制素材。
怎么把图片一键转成视频?完整流程与可复用结论
本文详解图片一键转视频的完整方法论:覆盖5大高频场景(活动预热、商品展示、内容复用等),提炼可复用的“五步流程”与“七项质检清单”,总结5条核心结论——强调素材质量决定上限、动效宜缓不宜快、先定渠道再定参数。无需剪辑软件,AI赋能实现“一句话生成动态视频”,大幅提升轻量视频生产效率。(239字)
保洁有没有在 “真干活”?YOLO 行为检测让清洁过程看得见、算得清
该方案基于YOLO模型,专注识别保洁人员“是否正在清洁”这一核心状态(如拖地、扫地、擦拭等),将监控画面转化为可统计的作业时长、频次等客观数据,助力物业实现从“人盯人”到“AI盯行为”的精细化、可追溯管理。
给AI视频准备动作参考时,手脚为什么时有时无?
给 AI 视频提取动作参考时,骨架手脚忽隐忽现应先查原片遮挡、人物检测与关节分数,再比较默认稳定和原始输出。本文给出 ReShot 0.5.0 的对照命令、关键点观察方法及已有实验的适用范围。
给AI视频准备动作参考时,手脚为什么时有时无?
给 AI 视频提取动作参考时,骨架手脚忽隐忽现应先查原片遮挡、人物检测与关节分数,再比较默认稳定和原始输出。本文给出 ReShot 0.5.0 的对照命令、关键点观察方法及已有实验的适用范围。
给AI Agent接入联网搜索:一个可落地的检索流水线
为AI Agent添加联网搜索,远不止调用API:需构建完整检索链路——精准判断搜索必要性、多轮查询改写、结果标准化去重、权威来源排序、正文精读与引用校验,才能确保答案既实时又可靠。(239字)