

Flink Forward Asia 2021 行业实践 2
行业实践专场由字节跳动、网易、蔚来、中原银行、建信金融科技、中信建投等多行业实时计算领域专家详细解读 Flink 在业内的应用与落地,围绕业务场景、业务痛点、面临挑战、如何破局等宝贵实践经验倾囊相授。讲师/嘉宾简介1.《Flink 在能源建设的实践》姚远 - 中南电力设计院工程师、注册测绘师2.《Apache Flink 在蔚来汽车的应用》吴江 - 蔚来汽车大数据部门数据开发,OLAP 平台 tech lead3.《Flink 在字节跳动数据流的实践》刘石伟 - 字节跳动数据平台数据流技术负责人4.《网易游戏基于 Flink 的支付环境全关联分析实践》林佳 - 网易互娱技术中心计费实时平台与 SDK 技术负责人,Apache Flink Contributor

一站式推荐应用与开发实战介绍
如何在1周内搭建一个个性化推荐服务,而且在短时间内迭代效果并取得提升,介绍如何通过平台开发的方式快速上手复杂的推荐场景开发业务。讲师简介讲师:王亚宁花名:栀露头衔:阿里巴巴集团产品专家

SaaS模式云数据仓库 MaxCompute 应用场景实践——基于MaxCompute的实时数据处理实践
MaxCompute通过流式数据高性能写入和秒级别查询能力(查询加速),提供EB级云原生数仓近实时分析能力;高效的实现对变化中的数据进行快速分析及决策辅助。当前Demo基于近实时交互式BI分析/决策辅助场景,实现指标卡近实时BI分析、近实时市场监测、近实时趋势分析、近实时销量拆分功能。讲师简介隆志强 阿里云智能 高级产品专家

如何快速搭建云原生企业级数据湖架构及实践分享
众所周知,数据湖技术在大数据领域炙手可热,随着在云上的广泛部署和应用,其业务价值逐渐获得业界共识。如何快搭建数据湖架构被越来越多的企业探讨。本次演讲主要分享快速搭建云原生企业级数据湖架构及实践分享。讲师简介王震 -- 阿里云计算平台事业部 开源大数据平台 技术专家

Hologres系列课程(五)通过JDBC/COPY实现高性能写入
本次主要介绍在Hologres中通过JDBC/COPY命令写入最佳实践,实现高性能批量写入。讲师简介陈嘉雯(瑚桃),阿里巴巴开发工程师,长期从事Hologers引擎开发工作

Hologres系列课程(十三)Datahub实时写入Hologres最佳实践
本次主要介绍Datahub写入Hologres原理,并实操演示数据从DTS到Datahub再写入Hologres的最佳实践讲师简介胡一博(上唐),阿里巴巴技术专家, 长期从事Hologres数据集成生态开发工作。

开源大数据社区 & 阿里云 E-MapReduce 系列直播 第9期
EMR on ACK是企业级半托管的开源大数据平台,为阿里云E-MapReduce(EMR)提供了一个部署选项,允许您在阿里云容器服务Kubernetes版 (ACK) 上运行开源大数据框架。 目前支持Spark引擎的部署,结合自研的Remote shuffle service(RSS)服务组件,提供用户高稳定、高性价比、灵活的弹性计算服务。RSS解决了计算存储分离和混合架构下的shuffle稳定性和性能问题。本次直播将重点展开RSS的使用和性能展示。讲师介绍吴雪扬(枢木),阿里云高级开发工程师

Elasticsearch生态&技术峰会 —— 技术最前线
分享主题:一、阿里云Elasticsearch云原生内核建设之路二、如何规划和执行威胁狩猎三、基于流式计算平台搭建实时分析应用中 Elasticsearch 的实战分享四、Elasticsearch 基于Pipeline 窗口函数实现实时聚合计算五、基于 Elasticsearch的容器化编排实践六、圆桌论坛:Elasticsearch多场景演进之路及未来探索讲师介绍魏子珺 阿里巴巴技术专家刘征 Elastic社区布道师吴斌 Elastic中文社区副主席李猛 力萌信息数据技术专家白凡 尚德机构资深开发工程师"曾勇 Elastic中文社区创始人&主席吴斌 Elastic中文社区副主席刘征 Elastic社区布道师杨振涛 Elastic深圳社区主席白凡 尚德机构资深开发工程师汪兴 Elastic杭州社区主席"

利用持久内存提速Spark
主要探讨如何在Spark上使用持久内存这一新技术来进一步提速性能。具体会介绍基于Plasma的共享内存方案来提速SQL数据源访问的性能以及利用持久内存扩展Spark现有内存磁盘存储层级来提速RDD cache在迭代式计算中的效果。讲师介绍:纪琨尚,英特尔亚太研发有限公司大数据部门的软件工程师,专注于Spark计算框架上基于Optane PMEM的优化叶宇强,英特尔亚太研发有限公司大数据部门的资深软件工程师,专注于Spark计算框架上基于Optane PMEM的优化

OpenSearch知名客户业务实践分享——趣店
趣店成立于14年3月,并快速在17年上市,在发展如此迅猛的前提下,介绍了开放搜索是如何满足趣店快速膨胀的搜索需求的,其中3天时间从创建到上线、无运维成本 、多种分词方式支持商品搜索,并根据企业特征实现个性化搜索需求等优点,让趣店成为了开放搜索坚实的合作伙伴。讲师介绍:樊庆响-趣店搜索资深技术专家
藏经阁电子书发布会第十期:AI是灵药还是猛兽?
时间:2020年9月2日 19:00-20:00讲师简介:黄博远,阿里云机器学习平台PAI产品负责人。十二年大数据与AI领域技术经验,十年技术管理经验,先后供职于微软、阿里巴巴集团,从是展示广告、搜索广告、电商广告、搜索、云计算等相关领域的技术工作。现任阿里云智能飞天AI平台(PAI)产品负责人、一站式大数据智能研发与治理平台DataWorks产品负责人。主题简介:AI是什么?AI赋予了很多商业业务宝贵的价值,我们日常用的搜索引擎就是应用AI的最大受益者;在电商领域,AI可以做推荐;在金融领域,AI可以做风控等等。对于很多新人来说,AI到底是什么?它似乎涵盖许多很高深的技术,学习AI需要学很多东西,想要抓住AI的风口,学AI甚至想玩转AI,有机会吗?阿里云机器学习平台技术专家给的答案是肯定的。首先,AI(人工智能)是什么呢?AI的本源是一门研究如何用机器来模拟人的智能的技术,让有以下能力:听——语音识别方面看——文字识别、图像识别等方面说——语音合成、人机对话等方面思考——推导数学公式、人机对弈等方面学习以及行动——自动驾驶等整个人工智能技术基本上围绕这些领域展开和迭代。其次,人人都能玩转AI吗?答案也是肯定的。学习AI需要解决算力、算法和数据的问题,加上真实场景来磨练。互联网尤其是移动互联网和换联网的迅猛发展辅助解决海量高质数据的问题;云计算和异构计算的发展辅助解决计算力的问题。而科技发展让整个生产率不断提高的同时不断地降低学习或使用技术的门槛。如同50多年以前,开车是一项非常重要或特殊的技能,司机备受大众敬仰,而今还会有很多人认为会开车的身份很特殊吗?可能不会了,反而是不会开车的人会让人觉得其身份特殊。AI其实也一样,它背后没有什么特别神秘的技术,技术的发展也使其使用和学习门槛在不断地降低。想深入了解AI源于何方、能够解决的典型问题?探讨AI是否能够替代或控制人类的话题?想知道如何像开车、用电脑、用智能手机一样掌握AI的技术?阿里云机器学习平台大神来给你降维讲解,带你了解AI历史,体验AI能力,并为你带来了《阿里云机器学习PAI-DSW入门指南》电子书的发布,带你进入人人都能玩儿AI的时代。教你如何轻松上手并告别纸上谈兵!
TFPark: Distributed TensorFlow in Production on Apache Spark
TFPark是开源AI平台Analytics Zoo中一个模块,它的可以很方便让用户在Spark集群中分布式地进行TensorFlow模型的训练和推断。一方面,TFPark利用Spark将TensorFlow 定义的AI训练或推理任务无缝的嵌入到用户的大数据流水线中,而无需对现有集群做任何修改;另一方面TFPark屏蔽了复杂的分布式系统逻辑,可以将单机开发的AI应用轻松扩展到几十甚至上百节点上。本次分享将介绍TFPark的使用,内部实现以及在生产环境中的实际案例。 讲师简介: 汪洋,英特尔大数据团队的机器学习工程师,专注于分布式机器学习框架和应用。他是Analytics Zoo和BigDL的核心贡献者之一。
飞天大数据产品价值解读 — 全文检索引擎 Elasticsearch
分享人:钱雨欣 阿里云智能 产品经理本次直播将通过在线教育行业的全观测智能监控、试题检索以及新零售行业订单查询加速、数据应用分析等场景案例,为您介绍全文检索引擎 Elasticsearch的核心能力与优势。

飞天大数据产品价值解读 — 最好用的数据湖管理平台 E-MapReduce
分享人:王晓平 阿里云智能 高级产品经理本次直播将为您介绍最好用的数据湖管理平台 E-MapReduce,包含数据湖典型场景、JindoFS,存储加速及数据分层存储方案及部分典型案例。

智能推荐系列公开课——智能推荐内容行业2.0发布
在信息过载、碎片化的时代,个性化推荐成为提升用户浏览/转化率的核心手段之一。而在实际应用中,怎样满足本行业的信息分发需求,精准匹配海量用户偏好,提高运营效率,仍是一个待解之题。此次,阿里巴巴搜索推荐产品团队带来系列公开课,聊聊怎样结合实际场景,嵌入智能推荐,搭建“千人千面”的分发体系,使产品价值最大化。每期20分钟,修炼推荐硬功夫。课程目录第一期推荐场景化构建与业务价值第二期智能推荐在电商的经典打法与实践第三期智能推荐电商行业2.0发布,算法模板再升级第四期7天搭建电商个性化推荐场景和最佳实践第五期0-1激活推荐系统,解锁冷启动难题第六期智能推荐内容行业2.0发布第七期详解内容行业典型案例,直击标题党和推荐时效性第八期智能推荐新闻行业2.0升级与最佳实践第九期智能推荐AIRec功能使用指南第十期课程总结与交流问答加入社群扫码入群,了解更多资讯,获取课程资料
MaxCompute管家详解
本次直播为您介绍MaxCompute管家功能,本功能为用户提供作业信息查看、资源消耗查看(涵盖CU资源和存储资源)、项目查看及调整、配额组增删改查等涉及日常MaxCompute运维能力。讲师介绍婉鱼 阿里云智能 技术专家
智能推荐系列公开课——智能推荐在电商的经典打法与实践
智能推荐在电商的经典打法与实践: 阿里巴巴搜索推荐产品团队带来系列公开课,教你提高运营效率,精准匹配海量用户喜好。
【Elasticsearch入门公开课 】03 | Elasticsearch简介及其发展历史
Elasticsearch 是一款非常强大的开源搜索及分析引擎,在 Search Engine 分类中长期位列第一。而Elasticsearch 除了搜索以外,结合生态 Kibana、Logstash和Beats,Elasticsearch还被广泛运用在大数据近实时分析场景中,包括日志分析、运维监控、信息安全等多个领域。本次入门课程主要帮大家从概念入手,并穿插底层技术讲解及教学实操,让您更深入的了解并如何运用Elasticsearch。为了让更多用户能够跟着教程边学边做,阿里云开发者社区为大家准备了阿里云Elasticsearch 3节点1核2G,1个月的免费实验环境。本节课主要为您讲解产品特征及发展历史公司愿景与商业模式【新用户开通】阿里云Elasticsearch 3节点1核2G免费1个月开通条件:新注册用户付费模式:包年包月服务选择:商业通用版,3节点1核2G版本【讲师简介】阮一鸣,eBay Pronto 平台技术负责人。极客时间《Elasticsearch 核心技术与实战》课程讲师Pronto平台目前管理了eBay 内部上百个Elasticsearch 集群,包括4000多个数据节点。这些集群目前被广泛使用在 eBay 的生产环境中。涵盖了网站搜索,商品推荐,日志管理,风险控制,IT运维,安全监控等多个领域钉钉扫码加入ES交流群,获取课程资料【课程收益】1、从概念到实操,轻松入门2、灵活运用ELK进行搜索与大数据分析3、阿里云开发者社区免费提供云ES(3节点1核2G )1个月免费实战环境课程目录3月03日 周二 19:30——20:30【01 | 课程介绍Elasticsearch核心技术与实战】3月03日 周二 19:45——20:00【02 | 内容综述及学习建议】3月03日 周二 20:00——20:15【03 | Elasticsearch简介及其发展历史】3月03日 周二 20:15——20:30【04 | Elastic Stack家族成员及其应用场景】3月04 周三 19:30——20:00【05 | Elasticsearch的安装与简单配置】3月05日 周四 19:30——20:00【06 | Kibanan的安装与界面快速浏览】3月09日 周一 19:30——20:00【07 | 在Docker容器中运行Elasticsearch Kibana和 Cerebro】3月10日 周二 19:30——20:00【08 | Logstash安装与导入数据】3月11日 周三 19:30——20:00【09 | 基本概念:索引、文档和REST API】3月12日 周四 19:30——20:00【10 | 基本概念:节点、集群、分片及副本】3月16日 周一 19:30——20:00【11 | 文档的基本CRUD与批量操作】3月17日 周二 19:30——20:00【12 | 倒排索引介绍】3月18日 周三 19:30——20:00【13 | 通过Analyzer进行分词】3月19日 周四 19:30——20:00【14 | Search API概览】3月23日 周一 19:30——20:00【15 | URI Search详解】3月24日 周二 19:30——20:00【16 | Request Body与Query DSL简介】3月25日 周三 19:30——20:00【17 | Query String&Simple Query String查询】3月26日 周四 19:30——20:00【18 | Dynamic Mapping和常见字段类型】3月30日 周一 19:30——20:00【19 | 显式Mapping设置与常见参数介绍】3月31日 周二 19:30——20:00【20 | 多字段特性及Mapping中配置自定义Analyzer】4月01日 周三 19:30——20:00【21 | Index Template和Dynamic Template】4月02日 周四 19:30——20:00【22 | Elasticsearch聚合分析简介】4月06日 周一 19:30——20:00【23 | 课程总结】
【Elasticsearch入门公开课 】08 | Logstash安装与导入数据
Elasticsearch 是一款非常强大的开源搜索及分析引擎,在 Search Engine 分类中长期位列第一。而Elasticsearch 除了搜索以外,结合生态 Kibana、Logstash和Beats,Elasticsearch还被广泛运用在大数据近实时分析场景中,包括日志分析、运维监控、信息安全等多个领域。本次入门课程主要帮大家从概念入手,并穿插底层技术讲解及教学实操,让您更深入的了解并如何运用Elasticsearch。为了让更多用户能够跟着教程边学边做,阿里云开发者社区为大家准备了阿里云Elasticsearch 3节点1核2G,1个月的免费实验环境。本节课主要为您讲解产品特征及发展历史公司愿景与商业模式【新用户开通】阿里云Elasticsearch 3节点1核2G免费1个月开通条件:新注册用户付费模式:包年包月服务选择:商业通用版,3节点1核2G版本【讲师简介】阮一鸣,eBay Pronto 平台技术负责人。极客时间《Elasticsearch 核心技术与实战》课程讲师Pronto平台目前管理了eBay 内部上百个Elasticsearch 集群,包括4000多个数据节点。这些集群目前被广泛使用在 eBay 的生产环境中。涵盖了网站搜索,商品推荐,日志管理,风险控制,IT运维,安全监控等多个领域钉钉扫码加入ES交流群,获取课程资料【课程收益】1、从概念到实操,轻松入门2、灵活运用ELK进行搜索与大数据分析3、阿里云开发者社区免费提供云ES(3节点1核2G )1个月免费实战环境课程目录3月03日 周二 19:30——20:30【01 | 课程介绍Elasticsearch核心技术与实战】3月03日 周二 19:45——20:00【02 | 内容综述及学习建议】3月03日 周二 20:00——20:15【03 | Elasticsearch简介及其发展历史】3月03日 周二 20:15——20:30【04 | Elastic Stack家族成员及其应用场景】3月04 周三 19:30——20:00【05 | Elasticsearch的安装与简单配置】3月05日 周四 19:30——20:00【06 | Kibanan的安装与界面快速浏览】3月09日 周一 19:30——20:00【07 | 在Docker容器中运行Elasticsearch Kibana和 Cerebro】3月10日 周二 19:30——20:00【08 | Logstash安装与导入数据】3月11日 周三 19:30——20:00【09 | 基本概念:索引、文档和REST API】3月12日 周四 19:30——20:00【10 | 基本概念:节点、集群、分片及副本】3月16日 周一 19:30——20:00【11 | 文档的基本CRUD与批量操作】3月17日 周二 19:30——20:00【12 | 倒排索引介绍】3月18日 周三 19:30——20:00【13 | 通过Analyzer进行分词】3月19日 周四 19:30——20:00【14 | Search API概览】3月23日 周一 19:30——20:00【15 | URI Search详解】3月24日 周二 19:30——20:00【16 | Request Body与Query DSL简介】3月25日 周三 19:30——20:00【17 | Query String&Simple Query String查询】3月26日 周四 19:30——20:00【18 | Dynamic Mapping和常见字段类型】3月30日 周一 19:30——20:00【19 | 显式Mapping设置与常见参数介绍】3月31日 周二 19:30——20:00【20 | 多字段特性及Mapping中配置自定义Analyzer】4月01日 周三 19:30——20:00【21 | Index Template和Dynamic Template】4月02日 周四 19:30——20:00【22 | Elasticsearch聚合分析简介】4月06日 周一 19:30——20:00【23 | 课程总结】
【Elasticsearch入门公开课 】05 | Elasticsearch的安装与简单配置
Elasticsearch 是一款非常强大的开源搜索及分析引擎,在 Search Engine 分类中长期位列第一。而Elasticsearch 除了搜索以外,结合生态 Kibana、Logstash和Beats,Elasticsearch还被广泛运用在大数据近实时分析场景中,包括日志分析、运维监控、信息安全等多个领域。本次入门课程主要帮大家从概念入手,并穿插底层技术讲解及教学实操,让您更深入的了解并如何运用Elasticsearch。为了让更多用户能够跟着教程边学边做,阿里云开发者社区为大家准备了阿里云Elasticsearch 3节点1核2G,1个月的免费实验环境。本节课主要为您讲解产品特征及发展历史公司愿景与商业模式【新用户开通】阿里云Elasticsearch 3节点1核2G免费1个月开通条件:新注册用户付费模式:包年包月服务选择:商业通用版,3节点1核2G版本【讲师简介】阮一鸣,eBay Pronto 平台技术负责人。极客时间《Elasticsearch 核心技术与实战》课程讲师Pronto平台目前管理了eBay 内部上百个Elasticsearch 集群,包括4000多个数据节点。这些集群目前被广泛使用在 eBay 的生产环境中。涵盖了网站搜索,商品推荐,日志管理,风险控制,IT运维,安全监控等多个领域钉钉扫码加入ES交流群,获取课程资料【课程收益】1、从概念到实操,轻松入门2、灵活运用ELK进行搜索与大数据分析3、阿里云开发者社区免费提供云ES(3节点1核2G )1个月免费实战环境课程目录3月03日 周二 19:30——20:30【01 | 课程介绍Elasticsearch核心技术与实战】3月03日 周二 19:45——20:00【02 | 内容综述及学习建议】3月03日 周二 20:00——20:15【03 | Elasticsearch简介及其发展历史】3月03日 周二 20:15——20:30【04 | Elastic Stack家族成员及其应用场景】3月04 周三 19:30——20:00【05 | Elasticsearch的安装与简单配置】3月05日 周四 19:30——20:00【06 | Kibanan的安装与界面快速浏览】3月09日 周一 19:30——20:00【07 | 在Docker容器中运行Elasticsearch Kibana和 Cerebro】3月10日 周二 19:30——20:00【08 | Logstash安装与导入数据】3月11日 周三 19:30——20:00【09 | 基本概念:索引、文档和REST API】3月12日 周四 19:30——20:00【10 | 基本概念:节点、集群、分片及副本】3月16日 周一 19:30——20:00【11 | 文档的基本CRUD与批量操作】3月17日 周二 19:30——20:00【12 | 倒排索引介绍】3月18日 周三 19:30——20:00【13 | 通过Analyzer进行分词】3月19日 周四 19:30——20:00【14 | Search API概览】3月23日 周一 19:30——20:00【15 | URI Search详解】3月24日 周二 19:30——20:00【16 | Request Body与Query DSL简介】3月25日 周三 19:30——20:00【17 | Query String&Simple Query String查询】3月26日 周四 19:30——20:00【18 | Dynamic Mapping和常见字段类型】3月30日 周一 19:30——20:00【19 | 显式Mapping设置与常见参数介绍】3月31日 周二 19:30——20:00【20 | 多字段特性及Mapping中配置自定义Analyzer】4月01日 周三 19:30——20:00【21 | Index Template和Dynamic Template】4月02日 周四 19:30——20:00【22 | Elasticsearch聚合分析简介】4月06日 周一 19:30——20:00【23 | 课程总结】
基于Flink构建CEP引擎的挑战和实践 | 企业实践专场
企业实践专场企业实践专场将邀请知名企业一线技术专家,分享大数据及人工智能最新技术进展和实践,详细解读Apache Flink在各行业的应用与落地,包括应用场景、业务痛点、面临挑战、如何破局等宝贵经验,并就大数据与人工智能等技术的发展趋势进行探讨和展望。讲师介绍韩鹏,奇安信集团高级总监,网络安全技术专家更多直播信息企业实践专场>>>Apache Flink 在字节跳动的实践与优化 | 企业实践专场Apache Flink在快手实时多维分析场景的应用 | 企业实践专场bilibili 实时平台的架构与实践 | 企业实践专场Apache Flink在滴滴的应用与实践 | 企业实践专场Apache Flink 在网易的实践 | 企业实践专场Apache Flink在中国农业银行的探索和实践 | 企业实践专场基于Apache Flink的爱奇艺实时计算平台建设实践 | 企业实践专场实时计算在贝壳的实践 | 企业实践专场基于Flink构建CEP引擎的挑战和实践 | 企业实践专场
Deep dive into Pyflink & integration with Zeppelin | 开源大数据生态专场
开源大数据生态专场”数据爆炸“时代下如何进行有效地大规模数据处理问题?大量数据处理技术与软件应运而生,形成当前百花齐放的开源大数据生态。本专场将围绕大数据开源生态、技术生态、商业生态探讨当下开源大数据的发展趋势与未来动向,并展现大数据相关技术在一线生产场景的优秀实践。讲师介绍章剑锋Apache Member,阿里巴巴高级技术专家孙金城Apache Flink PMC,阿里巴巴高级技术专家更多直播信息开源大数据生态专场专场>>>YuniKorn 对Flink on K8s 的调度优化 | 开源大数据生态专场流处理基准测试 | 开源大数据生态专场Apache Flink and the Apache Way | 开源大数据生态专场Delivering stream data reliably with Pravega | 开源大数据生态专场Deep dive into Pyflink & integration with Zeppelin | 开源大数据生态专场Apache Flink 与 Apache Hive 的集成 | 开源大数据生态专场趣头条基于 Apache Flink+ClickHouse 构建实时数据分析平台 | 开源大数据生态专场基于 Apache Pulsar 和 Apache Flink 进行批流一体的弹性数据处理 | 开源大数据生态专场The integretion of Apache Flink SQL and Apache Calcite | 开源大数据生态专场
Delivering stream data reliably with Pravega | 开源大数据生态专场
开源大数据生态专场”数据爆炸“时代下如何进行有效地大规模数据处理问题?大量数据处理技术与软件应运而生,形成当前百花齐放的开源大数据生态。本专场将围绕大数据开源生态、技术生态、商业生态探讨当下开源大数据的发展趋势与未来动向,并展现大数据相关技术在一线生产场景的优秀实践。讲师介绍Flavio Junqueira,Apache Member,Apache Zookeeper PMC,Senior Destinguished Engineer at Dell Technologies滕昱,戴尔科技集团 软件开发总监更多直播信息开源大数据生态专场专场>>>YuniKorn 对Flink on K8s 的调度优化 | 开源大数据生态专场流处理基准测试 | 开源大数据生态专场Apache Flink and the Apache Way | 开源大数据生态专场Delivering stream data reliably with Pravega | 开源大数据生态专场Deep dive into Pyflink & integration with Zeppelin | 开源大数据生态专场Apache Flink 与 Apache Hive 的集成 | 开源大数据生态专场趣头条基于 Apache Flink+ClickHouse 构建实时数据分析平台 | 开源大数据生态专场基于 Apache Pulsar 和 Apache Flink 进行批流一体的弹性数据处理 | 开源大数据生态专场The integretion of Apache Flink SQL and Apache Calcite | 开源大数据生态专场
Apache Flink and the Apache Way | 开源大数据生态专场
开源大数据生态专场”数据爆炸“时代下如何进行有效地大规模数据处理问题?大量数据处理技术与软件应运而生,形成当前百花齐放的开源大数据生态。本专场将围绕大数据开源生态、技术生态、商业生态探讨当下开源大数据的发展趋势与未来动向,并展现大数据相关技术在一线生产场景的优秀实践。讲师介绍Fabian Hueske,Apache Flink PMC,Ververica Co-founder,Software Engneer更多直播信息开源大数据生态专场专场>>>YuniKorn 对Flink on K8s 的调度优化 | 开源大数据生态专场流处理基准测试 | 开源大数据生态专场Apache Flink and the Apache Way | 开源大数据生态专场Delivering stream data reliably with Pravega | 开源大数据生态专场Deep dive into Pyflink & integration with Zeppelin | 开源大数据生态专场Apache Flink 与 Apache Hive 的集成 | 开源大数据生态专场趣头条基于 Apache Flink+ClickHouse 构建实时数据分析平台 | 开源大数据生态专场基于 Apache Pulsar 和 Apache Flink 进行批流一体的弹性数据处理 | 开源大数据生态专场The integretion of Apache Flink SQL and Apache Calcite | 开源大数据生态专场
小米流式平台架构演进与实践 | 实时数仓专场
实时数仓专场数据仓库的建设是“数据智能”必不可少的一环,也是大规模数据应用中必然面临的挑战。实时数仓专场将聚焦Flink实时数仓在数据链路中扮演的角色与在智能商业中的重要价值,由一线大厂大数据专家分享实时数仓的应用实践及平台智能化的探索与思考。讲师介绍夏军,小米流式平台负责人,高级研发工程师更多直播信息实时数仓专场>>>美团点评基于Apache Flink 的实时数仓平台实践 | 实时数仓专场小米流式平台架构演进与实践 | 实时数仓专场Netflix:Evolving Keystone to an Open Collaborative Real-time ETL Platform | 实时数仓专场菜鸟供应链实时数据技术架构的演进 | 实时数仓专场OPPO基于Apache Flink 的实时数仓实践 | 实时数仓专场
美团点评基于Apache Flink 的实时数仓平台实践 | 实时数仓专场
实时数仓专场数据仓库的建设是“数据智能”必不可少的一环,也是大规模数据应用中必然面临的挑战。实时数仓专场将聚焦Flink实时数仓在数据链路中扮演的角色与在智能商业中的重要价值,由一线大厂大数据专家分享实时数仓的应用实践及平台智能化的探索与思考。讲师介绍鲁昊,美团点评高级技术专家更多直播信息实时数仓专场>>>美团点评基于Apache Flink 的实时数仓平台实践 | 实时数仓专场小米流式平台架构演进与实践 | 实时数仓专场Netflix:Evolving Keystone to an Open Collaborative Real-time ETL Platform | 实时数仓专场菜鸟供应链实时数据技术架构的演进 | 实时数仓专场OPPO基于Apache Flink 的实时数仓实践 | 实时数仓专场
bilibili 实时平台的架构与实践 | 企业实践专场
企业实践专场企业实践专场将邀请知名企业一线技术专家,分享大数据及人工智能最新技术进展和实践,详细解读Apache Flink在各行业的应用与落地,包括应用场景、业务痛点、面临挑战、如何破局等宝贵经验,并就大数据与人工智能等技术的发展趋势进行探讨和展望。讲师介绍郑志升,bilibili 实时平台负责人更多直播信息企业实践专场>>>Apache Flink 在字节跳动的实践与优化 | 企业实践专场Apache Flink在快手实时多维分析场景的应用 | 企业实践专场bilibili 实时平台的架构与实践 | 企业实践专场Apache Flink在滴滴的应用与实践 | 企业实践专场Apache Flink 在网易的实践 | 企业实践专场Apache Flink在中国农业银行的探索和实践 | 企业实践专场基于Apache Flink的爱奇艺实时计算平台建设实践 | 企业实践专场实时计算在贝壳的实践 | 企业实践专场基于Flink构建CEP引擎的挑战和实践 | 企业实践专场
New Source API – Make it Easy! | Apache Flink 核心技术专场
Apache Flink核心技术专场数据的价值在于数据分析,而数据分析的挑战之一在于支撑大数据处理的平台技术。深度技术专题将邀请下一代大数据计算引擎Apache Flink创始团队及业界资深专家解析Flink技术动向,并回归技术本质,打造Flink全方位技术盛宴。讲师介绍秦江杰,Apache Kafka PMC,Apache Flink PMC,阿里巴巴高级技术专家更多直播信息Apache Flink 核心技术专场>>>Pluggable Shuffle Service and Unaligned Checkpoint | Apache Flink 核心技术专场New Source API – Make it Easy! | Apache Flink 核心技术专场Stateful Functions | Apache Flink 核心技术专场Apache Flink新场景——OLAP引擎 | Apache Flink 核心技术专场New Feature and Improvements on State Backends in Flink 1.10 | Apache Flink 核心技术专场阿里巴巴在 Apache Flink 大规模持久化存储的实践之道 | Apache Flink 核心技术专场深入探索 Apache Flink SQL 流批统一的查询引擎与最佳实践 | Apache Flink 核心技术专场Using Apache Flink as a Unified Data Processing Platform | Apache Flink 核心技术专场Apache Flink 流批一体的资源管理与任务调度 | Apache Flink 核心技术专场
实时数仓建设以及典型场景应用
本次分享会介绍实时数仓的思路以及一些实践,包括SparkStreaming SQL引擎,以及对Delta/Kudu/Druid/阿里云多种存储组件的深度整合;同时会在这个基础上介绍一些典型案例应用讲师介绍宋军,花名嵩林 阿里云EMR高级技术专家。从事Spark内核优化,对SparkCore/SprakSQL有深入了解,Spark Contributor
云上大数据的存储方案设计和选择
上云拐点已来,开源大数据上云是业界共识。如何满足在云上低成本存储海量数据的同时又实现高效率弹性计算的潜在需求?放眼业界,都有哪些成熟存储方案和选择?各自适用的存储和计算场景是什么?背后的技术关键和考虑因素都有哪些?欢迎大数据技术爱好者面对面交流和探讨!嘉宾介绍姚舜扬,花名辰山,阿里巴巴计算平台事业部 EMR 高级开发工程师,目前从事大数据存储方面的开发和优化工作;苏昆辉,花名抚月,阿里巴巴计算平台事业部 EMR 高级工程师, 曾就职于华为、网易. Apache HDFS committer. 对Hadoop、HBase等有深入研究, 对分布式存储、高性能优化有丰富经验. 目前从事大数据云化相关工作.
一条SQL在MaxCompute之旅(技术快闪)| 大数据技术专场
一条SQL在MaxCompute之旅(技术快闪)嘉宾介绍振禹 颖达 谢宁
混合云模式下MaxCompute +Hadoop混搭大数据架构实践 | 大数据企业级服务专场
混合云模式下MaxCompute +Hadoop混搭大数据架构实践-斗鱼张龙_大数据企业级服务专场嘉宾介绍张龙
待集成、连接、丰富—MaxCompute生态再出发 | 大数据生态专场
待集成、连接、丰富—MaxCompute生态再出发-李睿博_大数据生态专场嘉宾介绍李睿博
Ververica Platform-阿里巴巴全新Flink企业版揭秘-王峰
Ververica Platform-阿里巴巴全新Flink企业版揭秘-王峰
Tablestore Spark Streaming Connector -- 海量结构化数据的实时计算和处理
Tablestore是阿里云自研的云原生结构化大数据存储服务,本议题会详细介绍如何基于Tablestore的CDC技术,将大表内实时数据更新对接Spark Streaming来实现数据的实时计算和处理。最新版本的Connector会随着EMR下个版本的SDK一起开源,场景环节会结合阿里内部的业务介绍用户如何结合Tablestore和Spark来实现实时数据处理。讲师介绍朱晓然 ,Tablestore存储服务技术专家
阿里巴巴大数据产品最新特性介绍—DataWorks |2019大数据技术公开课第三季
本次直播将为您做DataWorks增值版本的高级feature及场景化介绍,帮您更好的了解和使用DataWorks增值版本。 <br/> 直播嘉宾:刘天鸢 阿里云智能事业群 高级产品经理
阿里巴巴大数据产品最新特性介绍—MaxCompute|2019大数据技术公开课第三季
本次直播将为您讲解MaxCompute产品近期最新发布的feature,涵盖SQL多项最新功能、预付费资源监控报警、IP白名单支持IPV6以及Logview中增加SQL复杂度等内容。 直播嘉宾: 曲宁 阿里云智能事业群 产品专家 <br/>
阿里云新品发布会第57期:DataWorks 实时数据开发平台发布会
查看产品:DataWorks点击了解:Stream Studio重磅发布有奖问答:互联网大数据时代的实时计算需求,你打算用什么方式来应对?点击了解:“阿里云新品发布会频道”点击订阅:阿里云新品发布·周刊发布会议程简介15:00-16:00 《阿里云DataWorks Stream Studio —— 一站式流任务开发平台》介绍实时计算任务开发的困难、问题和背景,引出使用Stream Studio可以大大加快实时任务的开发速度,降低开发和维护门槛,同时结合DataWorks的整体能力,能够实现实时数仓、实时监控、实时分析、实时大屏等实时大数据场景的一站式开发。讲师简介王喆(喆别)+阿里巴巴产品专家扫码加入阿里云Stream Studio用户群
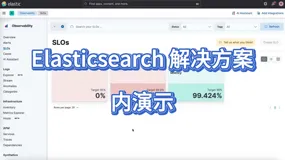
ElasticSearch AI Assistant 系列 3 —— 解决方案内演示
本视频介绍了如何在Elastic平台上配置AI助手以兼容并连接阿里巴巴的通义千问的第三部分——解决方案内演示。 演示可以帮助大家更直观的体验阿里云 ElasticSearch 企业级的功能——AI助手带来的更多帮助。
DataWorks X DeepSeek : 用AI实现数据开发治理!
DataWorks Copilot × DeepSeek-R1产品演示:以2025年春节杭州的旅游热点分析为例,通过DataWorks Copilot使用DeepSeek-R1满血版模型,进行SQL代码的自动生成、改写和测试操作,实现高效的数据开发流程。
DataWorks 数据资产治理
DataWorks 数据资产治理(原数据治理中心)可根据预先配置的治理计划,自动发现平台使用过程中数据存储、任务计算、代码开发、数据质量及安全等维度存在的问题,并通过健康分量化评估,从全局、工作空间、个人等多个视角,以治理报告及排行榜呈现治理成果,帮助您高效达成治理目标。同时,还提供业务资产管理、资产分析、任务资源消耗明细、费用预估等功能,帮助您有效掌握各类资源的使用详情。
2024FFA分论坛-流批一体2
FFA2024流批一体专场由Apache Flink核心贡献者与来自阿里云智能、小红书、哔哩哔哩、蚂蚁金服、Shopee等公司的一线技术专家聚焦于流批一体数仓的最新进展与实践,涵盖从理论探索到实际应用的全方位内容。
2024FFA分论坛-流式湖仓2
FFA2024流式湖仓专场由Apache Flink核心贡献者与来自淘天集团、抖音集团、vivo、小米、中原银行、阿里云智能、蚂蚁集团、贝壳找房、货拉拉等公司的一线技术专家解析流批一体、存算分离、湖仓融合的实时湖仓架构,探讨以 Apache Paimon 为流批一体湖存储的湖仓架构建设实践,如何帮助业务获得更实时的数据来驱动业务决策,并实现数据管理的降本增效。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。