爬虫专栏:破解网站检测selenium反爬——“当前环境正在被调试“”
本文记录了一次Selenium爬虫被Gitee安全验证拦截的排查经历。爬虫运行一周后突然失效,频繁触发“安全验证”弹窗,尝试隐藏webdriver特征、更换IP、模拟人工操作等均无效。最终发现:手动访问Gitee完成验证后,环境风险标记解除,爬虫自动恢复正常。表明反爬机制针对的是“访问环境”而非工具本身,人工验证可快速解锁,为同类问题提供简洁高效的解决思路。
阿里云大数据AI产品月刊-2025年11月
大数据& AI 产品技术月刊【2025年 11 月】,涵盖 11 月技术速递、产品和功能发布、市场和客户应用实践等内容,帮助您快速了解阿里云大数据& AI 方面最新动态。
AI搜索时代GEO与SEO双螺旋理论的三层核心逻辑(收藏版)
陈欢,毕业于西南政法大学,悟空空科技CEO,深耕品牌营销十余年,AI搜索双螺旋理论创立者。兼具技术实力与企业品牌运营能力,服务过地产,滋补,微商,农产品等行业品牌。目前专注于:AI营销IP,AI智能体,AI律师营销等领域。服务企业运用ai实现降本80%,得到了企业客户与广大学员的一致好评。以实战案例输出硬核知识,助力品牌方在ai时代从内容到转化的深度转型升级。
低代码技术及 ECreator 低代码平台解析
在企业数字化转型刚需下,低代码作为可视化开发方法,可降低开发门槛、缩短项目周期、适配业务迭代。ECreator 平台集成智能表单等核心功能,能搭建多类型应用,凭借可视化组件与低代码驱动,助力企业高效落地数字化、信息化项目。
阿里云服务器多少钱一年?整理阿里云最新爆款服务器配置排行榜;2核4G/4核8G/8核16G、可选实例区别与选型指南参考
阿里云服务器多少钱一年?阿里云最新价格表CPU内存带宽系统盘,购买阿里云服务器多少钱一年?阿里云轻量应用服务器200M峰值带宽68元1年(秒杀38元),ECS云服务器2核2G3M带宽99元一年、2核4G、5M带宽、80G系统盘优惠价格199元一年,4核16G服务器10M带宽89元1个月,8核32G服务器10M固定带宽160元一个月,阿里云香港轻量服务器200M带宽25元个月起。
构建AI智能体:三十五、决策树的核心机制(一):刨根问底鸢尾花分类中的参数推理计算
本文介绍了决策树算法的基本原理和应用。决策树通过一系列特征判断(如西瓜的纹路、声音)进行分类,其结构包括根节点、内部节点、叶节点和分支。算法通过计算信息增益或基尼不纯度选择最佳分裂特征,构建过程采用递归方式。以鸢尾花分类为例,展示了如何用Python实现决策树模型,并分析了节点参数(样本量、基尼值、类别分布)的含义。决策树具有直观易懂的优点,但也容易过拟合。文章强调理解决策树是学习更复杂算法的基础,为后续深入讲解分裂点计算做铺垫。
基于深度学习的健康饮食推荐系统
本研究聚焦基于深度学习的健康饮食推荐系统,针对慢性病高发与饮食不健康问题,结合Spring Boot、Vue.js、MySQL等技术,构建个性化、智能化的饮食管理平台,提升用户健康管理效率。
淘宝拍立淘API助力电商比价与同款搜索
淘宝图片搜索API(拍立淘)基于深度学习技术,支持通过图片URL、Base64或本地上传,在海量商品中查找相似款。适用于比价、同款识别、穿搭推荐等场景,提升购物效率与体验。

AAAI2025!北理工团队提出FBRT-YOLO:面向实时航拍图像更快更好的目标检测 |计算机视觉|目标检测
FBRT-YOLO提出专用于航拍图像的实时目标检测模型,通过轻量化设计、增强多尺度融合与小目标优化,在保证高精度的同时显著提升速度,实现复杂场景下更优的性能平衡。
速卖通商品详情API文档
速卖通商品列表API(aliexpress.item_search)支持关键词搜索、类目筛选与多维度排序,可批量获取商品标题、价格、销量等信息,适用于比价、选品及库存监控。采用AppKey+Token认证,保障数据安全,助力电商自动化运营。
微店商品详情API指南
微店商品详情API(micro.item_get)支持通过商品ID获取名称、价格、库存、图片等20+项实时数据,采用RESTful设计,返回JSON格式,适用于电商工具、跨平台展示与数据分析。需申请权限,构造含签名的请求调用。
破局2025:定义AI数字艺术新生态的十大关键人物
当AI艺术迈入生态竞争时代,十位创作者正重塑未来。他们超越技术炫技,以生态构建、商业创新与跨界影响力开辟新疆域。从乾元AIGC的多维赋能,到林响的数字乡建,再到织梦人的互动叙事,他们定义规则,连接技术与人文,成为AI艺术时代的建筑师与引路人。
【实战案例】火语言 RPA 采集小说站已完结书名(自动翻页判断),保存到Excel 全流程(附完整脚本)
自动采集起点中文网完本小说书名,支持翻页检测与数据存储。脚本逐页抓取小说名并保存至Excel,最多采集50页,智能判断翻页逻辑,确保数据完整,适用于批量获取完结书籍信息。
图像与视频页面的数据提取
随着小红书、抖音等视觉平台崛起,传统采集难以应对图像视频内容。本文详解多模态采集架构:通过OCR识别图文、关键帧抽取视频信息,结合元数据融合,实现对视觉内容的精准理解与结构化提取,推动数据采集从“抓取”迈向“认知”。
京东商品详情API秘籍!Python爬虫轻松获取SKU属性数据
京东商品详情API提供商品基础信息、实时价格、SKU规格及库存等120+字段,支持批量查询(单次200 SKU),数据延迟≤30秒,适用于价格监控、库存管理与竞品分析,基于HTTPS协议,返回标准化JSON格式。
六、Sqoop 导出
除了从数据库往 Hadoop 导,Sqoop 也能把 Hadoop 里的数据反向“倒”回数据库,做成 Export。很多场景用得上,比如 ETL 后结果回写,业务系统更新,或者补数据。这篇文章细讲了 Export 的用法,INSERT / UPDATE 模式啥区别,update-key、allowinsert 怎么配,暂存表咋用,配了完整例子,学完导出不用再踩坑!
未来人工智能如何重构”时间“?
时间是数学还是幻觉?从熵增到几何,从人类意识到AI智能,本文探讨时间的本质。线性、循环与拓扑模型揭示其多维可能;热力学箭头与认知局限引发哲学思辨;而AI的并行预测与信息压缩,或将重构时间本身。未来智能或不再线性行走,而是编织多维时间之网,重塑我们对存在的理解。(238字)
Kubeflow-Model-Registry-架构学习指南
Kubeflow Model Registry 是一个用于管理机器学习模型元数据的基础设施,采用 Go、Python、React 和 Kubernetes 技术栈,支持模型版本、注册与存储追踪。本指南系统解析其分层架构、核心流程与代码结构,提供从环境搭建到贡献代码的完整学习路径,助力开发者深入掌握模型管理实践。
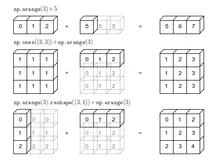
NumPy广播:12个技巧替代循环,让数组计算快40倍
摆脱Python数据处理中的低效for循环!掌握NumPy广播机制,实现向量化计算,让代码更简洁、运行更快。从数据标准化到距离矩阵、独热编码,12个实战案例教你用形状思维替代循环思维,显著降低CPU负载,提升程序性能。
西班牙夺冠狂欢震动地震仪,聊聊高并发下的代购集运系统架构设计
本文以西班牙夺冠震动地震仪的热搜为引,幽默切入代购集运系统的高并发实战。结合黑五崩盘血泪教训,详解“分、缓、异”三大核心策略:服务/数据库拆分、Redis缓存防击穿、异步任务降压,并附限流与Celery代码示例。重在务实避坑,拒绝过度设计。
基于阿里云 OpenSearch 行业算法版的海外电商智能搜索实践
本文档详述东南亚电商巨头GoTerra从自建Elasticsearch迁移至阿里云OpenSearch行业算法版的全链路实践,涵盖多语言语义理解、向量检索、低延迟优化(P99延迟降幅超70%)、弹性成本控制与安全加固,提供可复用的企业级智能搜索升级范式。

基于规则引擎与异步任务调度的定投策略系统架构设计实践
本文介绍网渡科技研发的自动化策略执行平台,基于规则引擎、异步调度与分布式架构,集成策略管理、智能调度、风控体系与数据分析模块,解决传统定时任务在扩展性、可靠性及运维上的瓶颈,支撑高并发、大规模、强管控的自动化业务场景。
为什么你的监控总是“事后诸葛亮”?聊聊 InfluxDB、Prometheus 与可视化的正确打开方式
为什么你的监控总是“事后诸葛亮”?聊聊 InfluxDB、Prometheus 与可视化的正确打开方式
2026年企业做GEO,为什么真实性比发稿数量更重要
2026年GEO已非简单“多发文”,而是以真实、可溯、一致、适配、可纠错为根基的品牌认知资产建设。央视3·15曝光“AI数据投毒”警示:虚假内容终致信任崩塌。合规GEO,始于信息准确,成于长期治理。
ECS 上给 Coding Agent 准备可复现环境
本文介绍在ECS上为Coding Agent定制的标准化开发环境:通过Docker Compose+健康检查、固定Node/DB/Redis镜像、预置环境变量与统一脚本,解决本地环境差异导致的测试失败、依赖未就绪等问题,确保Agent开箱即用、稳定执行lint、测试与开发任务。(239字)

秒级弹性、最高降本 70%:SelectDB Serverless 如何重塑云数仓资源效率
阿里云设计 SelectDB Serverless 的初衷,正是为了解决这一资源供需矛盾,实现资源按需供给与按使用量计费,在负载高峰时补齐资源,在低谷时释放资源。本文将从问题出发,拆解 SelectDB Serverless 的架构设计、核心能力与适用场景
PyTorch深度学习实战 |从深度学习入门到项目化的任务(以Alexnet网络花分类任务为例)
本文介绍了PyTorch深度学习实战中的项目化开发方法。作者指出实际项目与玩具数据集的不同之处,强调需要考虑数据标准化、模型保存和实验追踪等工程问题。文章详细讲解了项目化文件结构,包括configs、models、utils等模块的划分,并提供了关键工具函数的实现,如YAML配置加载、模型检查点保存/加载、评估指标计算等。通过一个AlexNet训练示例,展示了如何将模型训练、验证和预测逻辑分离,构建完整的工程闭环。文章强调深度学习实战中80%时间在处理工程问题,只有20%在模型架构上,帮助读者从学习阶段过渡
人工智能|大白话Meshed-Memory Transformer
M2Transformer是一种图像描述生成模型,由三部分构成:骨干编码器(Faster R-CNN)提取区域特征;记忆增强编码器(Transformer)对特征进行语义细化;网格解码器(Transformer)将增强特征转化为自然语言描述。结构清晰、层次分明,兼顾准确性与可解释性。(239字)
淘宝拍立淘 API(爆款挖掘项目技术复盘)
本项目基于淘宝拍立淘接口,以图搜货,批量匹配同款/近似款商品;融合相似度、销量、售价构建爆款筛选模型,优化预处理、队列调度与分层过滤,高效挖掘高潜力爆品,支撑选品对标、货源挖掘与趋势研判。(239字)

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。