

子不语 x Quick BI:“爆款飞轮”高速增长背后的数字化助推力
子不语集团(2420.HK)借助瓴羊Quick BI构建数字化底座,打通数据孤岛,将报表开发从两周缩至1天,支撑智能销售、库存预警与语义分析,年降本增效显著。
海亮集团 x Quick BI:数据驱动“看到-知道-做到”,打造集团级智能决策中枢
海亮集团携手Quick BI打造“海亮大脑”,实现人资、营销、仓储三大场景数据智能升级:人岗匹配率提升20%,营销响应提速90%,库存成本下降18%。数据准确率达98%,消费超190万次。
淘宝店铺所有商品API及商品数据采集项目复盘
本项目通过调用淘宝taobao.item_search_shop接口,无需卖家授权,批量采集多店铺商品基础信息、价格、SKU、状态等全量数据,实现自动化盘点与监控,提升采集效率与准确性,为商品分析、台账管理及竞品研究提供稳定结构化数据支撑。(239字)
PyTorch深度学习实战 | 基于LSTM的时间序列预测任务
本文介绍了使用LSTM模型预测印度德里市平均温度的两个项目。项目1对温度数据进行归一化处理,采用滑动窗口法构建监督学习样本,设计5层LSTM网络结构,并详细说明了模型训练过程及评估方法。项目2在数据处理上增加了标准化和周期性特征,改进了网络架构,引入了学习率调整和早停机制优化训练过程。两个项目均通过可视化对比预测值和真实值,验证了LSTM模型在时间序列预测中的有效性。文章从数据处理、模型构建到训练优化,完整呈现了温度预测的实现流程,为时序预测任务提供了实用参考。
人工智能 |手算CLIP模型
本文详解CLIP模型原理:突破传统CNN需重新训练的局限,通过4亿图文对联合训练文本与图像编码器,实现零样本迁移。利用对比学习对齐多模态特征,支持图文检索、零样本分类等应用,让AI像人一样理解未见过的概念。(239字)
PyTorch深度学习实战 |手算变分自编码器(VAE)
本文详解变分自编码器(VAE)原理:指出传统自编码器因潜在空间无序而无法生成新图像;VAE通过引入概率建模,用高斯分布近似后验,并结合重构损失与KL散度优化,使潜在空间连续可采样,从而实现可控图像生成。含公式推导、重参数化技巧及完整代码实现。(239字)
1688商品详情API 实战总结(技术复盘)
本文为1688商品详情API(1688.item.get)实战复盘:采用官方合规接口,攻克签名校验、限流、阶梯价解析等难点,稳定采集B2B专属数据(批发价、起订量、供应商资质等),替代高风险爬虫,已支撑供应链、铺货与竞品监控业务。
人工智能|大白话YOLOv3,YOLOv4
YOLOv3采用全卷积+残差连接+多尺度融合架构,含Darknet-53骨干网、FPN颈部与三尺度检测头,支持任意32倍数输入(如416×416),输出13×13、26×26、52×52特征图,兼顾大中小目标检测。
PyTorch深度学习实战 | 手算生成对抗网络GAN
GAN(生成对抗网络)是一种深度学习模型,由生成器与判别器构成对抗训练框架:生成器学习伪造逼真数据,判别器则努力区分真假。二者博弈迭代,最终生成器可产出以假乱真的高质量样本,广泛应用于图像生成、数据增强等领域。
为什么我劝你放弃Selenium拥抱Playwright
爬虫选型指南:Playwright全面碾压Selenium!启动快5倍、反爬通过率超90%、原生异步API、代理配置极简,且持续高频更新;Selenium则陷于历史包袱、指纹暴露、维护停滞。新项目请果断迁移!
谷歌深夜发布 Gemini 3.5:多模态能力再升级,开发者该怎么抓住这波机会?
Gemini 3.5 Flash于2026年5月发布,主打原生多模态与实时智能体能力:支持图文音视一体化理解、帧级视频诊断、100万token长上下文,并在编码(76.2%)、Agent任务(83.6%)等实测中超越前代。速度快4倍、成本更低,已免费开放。
PyTorch深度学习实战 | 手算卷积网络(Resnet-18)
ResNet-18是解决深层网络梯度消失与退化问题的经典模型,核心在于残差连接(Shortcut):让输入X直接跳跃传递,与卷积学习的残差F(X)相加(F(X)+X),实现恒等映射。其含4个stage、18层可训练层,每个BasicBlock由两个3×3卷积+BN+ReLU构成,并通过1×1卷积适配尺寸/通道差异,显著提升深层网络训练稳定性与性能。(239字)
AR 智能眼镜智正优化警务领域的日常巡逻和排查麻烦的难点
AR智能眼镜开启安防3.0时代:远距精准识别、动态人脸追踪,实现“抬眼即查”;支持秒级人脸/车牌比对,赋能移动执法、重点排查与大型活动交通疏导,续航达4小时,全面提升安防响应效率。
2026互联网医院系统源码开发方案:APP+小程序+HIS一体化
随着智慧医疗快速发展,互联网医院系统正在成为医疗机构数字化转型的重要方向。本文从行业趋势出发,深入解析2026互联网医院系统源码开发方案,包括APP、小程序、HIS系统一体化搭建模式,并详细介绍在线问诊、电子处方、AI导诊、私有化部署等核心功能。适合医疗机构、创业团队及软件开发企业参考阅读。
拒绝 403 Forbidden!实战解析全球流媒体元数据的高并发爬虫架构(附完整核心源码)
这篇文档介绍了使用Python和代理构建流媒体平台元数据采集方案。包括动态代理池配置、伪装浏览器指纹、实战Demo、高并发避坑指南。旨在帮助构建稳定有效的采集方案。
深度解析:数据采集场景下的 Java 代理技术实战
本文深入解析Java爬虫中HTTP代理的核心技术,涵盖全局/局部代理配置、连接池复用与路由绑定、IP保持与动态切换(Proxy-Tunnel/Connection: Close)、HTTPS隧道认证(407排障)及生产级代码实践,助力高效稳定数据采集。
京东api:通过商品ID获取商品详情数据教程
京东商品详情API(jd.item.get)支持按SKU ID快速获取商品信息,返回标准JSON格式。含必填参数num_iid与access_token,可选字段过滤及促销信息控制。适用于ERP对接、比价监控、选品推广等场景,开箱即用,无需额外申请。
淘宝宝贝详情API:通过商品ID获取淘宝商品详情页面数据
本文详解淘宝商品详情API(taobao.item.get):含接口规范、必传参数(num_iid、session等)、HMAC-SHA256签名规则、关键返回字段(标题、价格、库存、详情页等)及常见避坑指南,开箱即用,助力高效解析入库。(239字)
天猫商品详情API数据解析
天猫商品详情API解析方案,涵盖taobao/tmall.item.get接口字段说明、JSON结构、解析代码及SKU/详情图/规格提取。支持价格库存、竞品监测、舆情预警等场景,AI智能清洗、卖点解析与爆款预测,助力中小卖家高效用数。(239字)

CN3302设计复杂困难”,简单级芯片价格高,区别有哪些的测试
(1) PW4253 全面领先:效率高达 94%,实际充电电流最大(1.112A),温升最低(表面仅34℃),且全场景兼容。 (2)CN3302 效率(88%),且在 5V/1A 输入下异常(可能是输入欠压或启动问题),热成像温度达到60℃。 (3)PW4584A 效率与 CN3302 接近,但温度更高(热成像64℃),不过5V1A输入正常,兼容性完好。
TorchEasyRec的dbmtl 模型 config 详解
DBMTL(Deep Bayesian Multi-Target Learning)是阿里开源的多任务学习模型,显式建模任务因果依赖(如CTR→CVR)。基于TorchEasyRec实现,采用共享Bottom MLP+双Tower结构,CVR Tower融合CTR中间表征,体现贝叶斯条件关系。
EasyRec和TorchEasyRec中FG NORMAL 和 FG DAG 的区别
TorchEasyRec提供两种特征生成模式:FG_NORMAL(Python逐特征处理,适合调试)与FG_DAG(C++ DAG引擎批量处理,性能更优、支持依赖、stub_type及自动侧识别)。推荐生产环境优先使用FG_DAG。
PAI-Rec 召回引擎:构建高性能推荐系统的核心引擎
PAI-Rec是阿里云智能推荐平台的核心召回引擎,经阿里大规模场景验证。支持多路召回融合(U2I/I2I/向量/随机)、召回即过滤、毫秒级实时更新与分布式弹性架构,开箱即用,助力企业构建毫秒级、高精度、强实时的推荐系统。
Python、Java、PHP 三种语言实现爬虫的核心技术对比与示例
本文对比Python、Java、PHP三大语言爬虫技术,涵盖核心工具(如Scrapy/Jsoup/Goutte)、典型代码示例及异步、分布式、缓存等性能优化策略,并给出选型建议与反爬合规实践,助开发者高效构建稳定爬虫系统。
AIGC数据引擎的基石:图库抓取架构从单机到云原生的演进与实战
AIGC领域优化数据采集策略,提升大模型竞争力。初期使用Python脚本搭建单机爬虫,后转向分布式设计,引入代理技术。云原生部署实现弹性伸缩,全链路监控。构建高可用数据采集引擎是关键。
为什么企业做智能问数,不能只靠宽表、预制指标和 SQL
本文剖析企业智能问数落地难的根源:非性能或模型之限,而在业务语义缺失——对象定义不清、关系模糊、口径不一。指出SQL、宽表、预制指标各有所长却难解复杂动态问题;提出“本体论+ABC方法”(Acquire对象→Build指标→Compute计算),以显式建模业务语义,提升可理解性、可维护性与长期演进能力。
本地自动化工具怎么用在生活里?三个非办公场景拆解
本文介绍零代码浏览器自动化工具的三大实用场景:二手游戏卡带盯梢、医院挂号抢号、自媒体负面评论监控。通过定时触发、网页操作、关键词判断与自动提醒/操作,无需编程即可解放双手,全程本地运行、安全合规,小白也能快速上手。(239字)
京东商品详情数据一键获取,item_get API接口讲解
京东item_get是获取单商品详情的核心API,支持一键拉取标题、价格、SKU、库存、详情HTML等结构化数据,适用于反向海淘、代购、ERP同步及比价分析等场景,分基础版与完整版,需认证授权后调用。(239字)

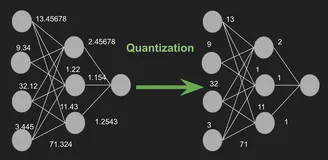
大模型太慢?别急着上 GPU 堆钱:Python + ONNX Runtime 优化推理性能实战指南
大模型太慢?别急着上 GPU 堆钱:Python + ONNX Runtime 优化推理性能实战指南
Amazon竞品调价实时预警系统:OpenClaw AI Agent + Pangolinfo API 企业级落地实践
本方案为跨境电商打造实时竞品价格监控系统:通过Pangolinfo API每10分钟采集ASIN数据,OpenClaw AI Agent智能分析降价威胁并生成应对建议,飞书/Slack即时推送富文本告警。响应速度从24小时提升至10分钟(加速144倍),年ROI超10倍,开发仅需1–2天。(239字)
零安装在线网站制作,为什么正在成为新主流
零安装在线网站制作将开发环境云端化,用户无需配置本地环境,打开浏览器即可完成建站、编码、数据管理与部署。依托浏览器能力提升、云基建成熟及AI生成技术,如lynxcode(原lynx AI)支持自然语言生成全栈代码,大幅降低门槛,加速原型验证与快速迭代,尤其适合创业者与非技术人员。

AI 新范式,从对话走向行动,奥尔特云全面接入OpenClaw,直接通过IM对话框下指令给AI完成工作任务
人机交互可能正迈向第三次变革:迈入自然语言指令时代。OortBot与OpenClaw等本地AI Agent兴起,支持私有部署、多智能体协同、深度系统集成,数据不出本地,成本可控、自由可定制——AI正加速从云端走向端侧。
2026数字助理时代真的要来临了——直接自然语言操作AI助理,马斯克预言真的来了
AI自动开浏览器抢12306车票!这不仅是聊天机器人,而是能“看屏、点鼠、敲键”的数字员工——绕过API限制,直接操作任何GUI软件。马斯克力推的MacroHard(Digital Optimus),正颠覆传统软件逻辑,宣告“数字助理时代”真正来临。
从踩坑到高效落地:淘宝天猫商品详情API的实操心得
本文分享淘宝天猫商品详情API从踩坑到高效落地的实战经验,涵盖准入权限避坑、签名与调用规范、异常处理、缓存优化、批量调度及监控运维等关键环节,助开发者快速稳定接入,提升开发效率与系统稳定性。(239字)
从130倍性能提升看Python的批量计算和并行化策略:traj-dist-rs的并行策略实现
本文以traj-dist-rs为例,讲解使用rust与rayon在python的计算密集型任务中的性能提升方案。
别再用ChatGPT群发祝福了!手把手教你“喂”出一个懂人情的AI,连马术梗都能接住
本文揭秘春节祝福AI背后的数据构建逻辑:不靠大模型堆参数,而用“关系感知”六维框架(称呼/关系/细节/场合/风格/篇幅)定义人情分寸;通过人工精写种子数据、模型辅助繁殖(400→3107条)、结构化提示词模板,让AI写出有记忆点的专属祝福。技术是导盲犬,帮人打捞真心。

场景判断:什么情况下值得做微调?三个维度帮你做决策
本文提出微调选型三维度决策框架:任务复杂度(知识查询/格式遵从/能力涌现)、风格要求(可选→固定→品牌级)、数据可得性(量、质、多样性),并对比提示词工程、RAG等轻量替代方案,助技术决策者科学评估微调必要性,避免资源浪费。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。