雷锋网(公众号:雷锋网)按:在过去的一年当中,自动化机器学习已经成为一个众人感兴趣的话题。KDnuggets举办了一个关于该话题的博客大赛。结果喜人,有很多有意思的想法与项目被提出来了。一些自动化学习工具也引起了大家的兴趣,受到了大家的追捧。
本篇文章的作者 Matthew Mayo 将会对自动化学习进行简单的介绍,探讨下一下它的合理性、采用情况,介绍下它现在使用的工具,讨论下它预期的未来发展方向。本文由雷锋网编译,未经许可不得转载。
什么是自动化机器学习呢?
接下来我们要探讨的是自动化机器学习属于哪一类科学,以及它不属于哪一类科学。
自动化机器学习并不属于自动化数据科学。毫无疑问的是它与自动化数据科学有重复的部分。尽管如此,机器学习只是数据科学工具包中的一个工具。它无法对所有的数据科学任务起作用。例如,机器学习虽然适用于预测性的数据科学任务。但它并不适用于描述性分析的数据科学任务。
即使是那些预测性的数据科学任务,也不仅仅只包含预测。我们对自动化机器学习与自动化数据科学会产生了混淆,对此,数据科学家Sandro Saitta认为:
这种误解来源于我们对完整的数据科学过程(例如:CRISP-DM)、准备数据的子过程(特征提取等等)以及建模(建模也被我们我们称为机器学习)的混淆。
在读到关于自动化数据科学与数据科学竞赛的工具新闻的时候,没有行业经验的人会很困惑,他们可能认为数据科学就是建模,这样就可以完全自动化运行了。
他是完全正确的,不仅仅是词义的问题。假如你想要对机器学习与数据科学有一个更加清晰的认识,那就读读这个。
此外,数据科学家、自动化机器学习的领军人物Randy Olson认为我们要想得到高效的机器学习设计方案,我们必须做到以下几点:
始终调整我们模型的超参数
始终尝试不同的模型
始终对我们的数据进行大量的特征探索
假如我们将以上所说的东西都考虑进去,那么我们可以认为自动化机器学习的任务是选择算法、超参调整、迭代建模以及模型评价,这样的话,我们就可以以此来定义自动化机器学习了。自动化机器学习的定义是多种多样的(对比一下数据科学,当你向十个人询问什么是数据科学的时候,你会得到是十一种不同的回答。),但是我们却可以说,这开了个好头儿。
我们为什么需要它?
尽管我们知道了自动化机器学习的概念,自动化机器学习对我们可能有好处,但是我们仍需要知道为什么机器学习会很难。
AI研究人员、斯坦福大学博士生S. Zayd Enam最近写了一篇奇特的博客,博客的标题是《为什么机器学习这么“硬”?》,在这篇文章中,他写道(注意粗体字):
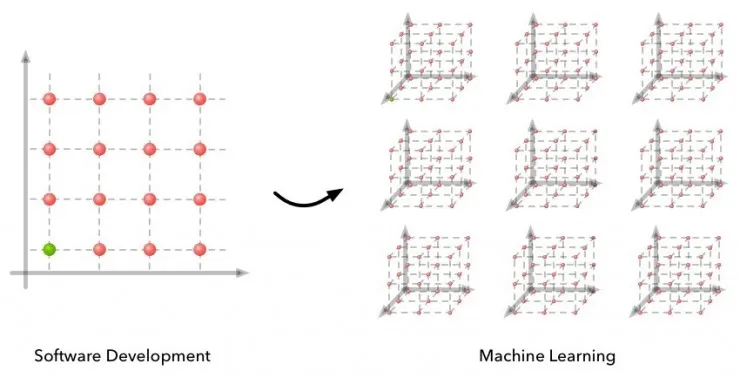
机器学习仍然是相对很困难的问题。毫无疑问,通过研究来推进机器学习算法的进步会很困难。这需要创造力、实验以及坚持。由于现成的算法、模型可以很好的为你提供服务,这就阻碍了机器学习的发展。
请注意,尽管Enam主要提及的是机器学习的研究,但是他也提到了现成的算法在用例中的实现(见粗体字)。
紧接着Enam详细阐述了机器学习的难题,并着重叙述了算法的特性(见粗体字):
机器学习的难题之一就是建立直觉。建立直觉的意思是采用某种工具来应对问题。这就需要知道可用的算法、模型、风险权衡以及每一个限制条件。
……
困难在于机器学习基本上很难进行调试。对于机器学习来说,调试会在两种情况下发生:1)你的算法不起作用了;2)你的算法效用不是很好。……算法一开始就起作用的情况很少,因此我们大部分时间都在用来创建算法。
Enam紧接着从算法研究层面阐述了框架问题。再次强调下,他所说的是应用算法。假如一个算法不起作用,或者性能不是很好,那么我们就需要对算法进行迭代,即再选择与再定义。这就产生了自动化,因此也就有了自动化算法。
我以前对于自动化机器学习算法本质的理解是这样的:
正如Sebastian Raschka描述的那样,假如说计算机程序关于自动化的,那么机器学习可以看做是“关于自动化的自动化”。那么自动化机器学习就是关于自动化的自动化的自动化。程序通过管理重复的任务来减轻我们的压力;机器学习帮助计算机如何最好的处理这些重复的任务;自动化机器学习帮助计算机学习如何优化上面的结果。
这种思想很有用处;尽管我们之前会担心调参数、调超参数。自动化机器学习通过尝试一些列不同的方法,最终会采用最好的方式来调参,从而得到最优的结果。
自动化机器学的理论基础来源于这个想法:假如我们必须创建海量的机器学习模型、使用大量的算法、使用不同的超参数配置,那么我们就可以使用自动化的方式进行建模。同时也可以比较性能与准确度。
很简单,对不对?
对自动化机器学习工具进行比较
现在我们知道了自动化机器学习到底是什么了,以及我们要用它的原因。那我们我们该如何才能创造出一个自动化机器学习模型来?接下来要讲解的是两个自动机器学习工具包的概述,以及二者之间比较。这些工具包是使用python编写而成的。这两个工具使用不同的方式来达到相同的目的,也就是是机器学习过程的自动化。
Auto-sklearn
Auto-sklearn是自动化机器学习的工具包,我们用它来替换scikit-learn中的estimator。在最近由KDnuggets举办的机器学习博客大赛中,它取得了冠军头衔。
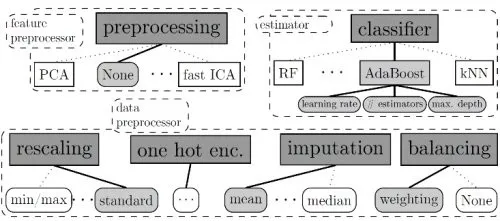
auto-sklearn使机器学习的使用者可以很轻松的进行算法选择以及超参数的调整。它的优势就是在于使用贝叶斯优化、元数据学习以及集合建设。要想了解更多关于auto-sklearn的背后技术,你可以阅读这篇2015年发表在NIPS论文。
上面的信息是摘自项目的文档说明,Auto-sklearn可以通过贝叶斯优化方式将超参数最优化,就是通过不断迭代以下几个步骤:
创建一个概率模型,来找到超参数设置与机器学习的表现之间的关系
使用这个模型来挑选出有用的超参数设置,通过权衡探索与开发,进而继续尝试。探索指的是探索模型的未知领域;开发指的是重点从已知的空间中找到表现良好的部分。
设置好超参数,然后运行机器学习算法。
下面将进一步阐明这个过程是如何进行的:
这个过程可以概括为联合选择算法、预处理方法以及超参数。具体如下:分类/回归的选择、预处理方法是最高优先级、分类超参数、被选择方法的超参数会被激活。我们将使用贝叶斯优化方法来搜索组合空间。贝叶斯优化方法适用于处理高维条件空间。我们使用SMAC,SMAC是的基础是随机森林,它是解决这类问题的最好方式。
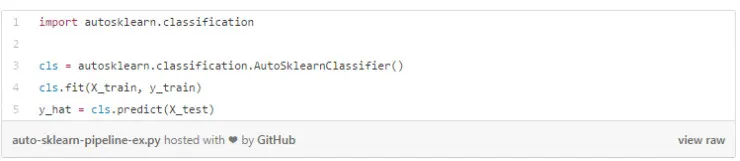
就实用性而言,由于Auto-sklearn直接替代scikit-learn的estimator,因此scikt-learn需要安装这个功能,我们才能利用到这个优势。Auto-sklearn同样也支持在分布式文件系统中进行并行计算,同时它也可以利用scikit-learn模型的持续特性。要想高效的使用Auto-sklearn替代estimator只需要4行代码就可以了。作者这样写道:
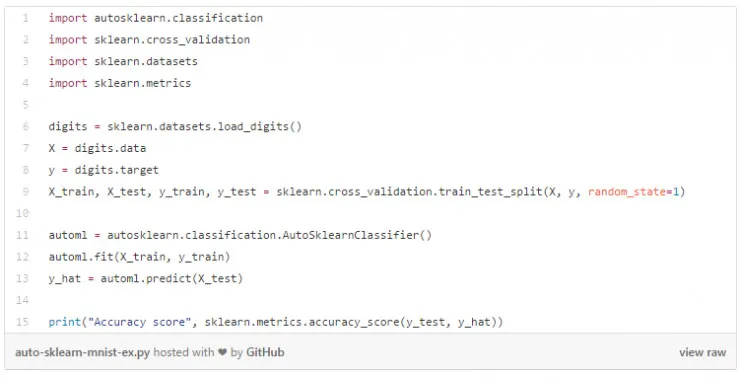
有一个更具鲁棒性的示例(该示例使用了Auto-sklearn,并以MNIST数据集作为数据来源),如下:
需要注意的是,Auto-sklearn是ChaLearn AutoML challenge竞赛中,auto单元与tweakathon tracks单元的双料冠军。
最近Kdnuggets举办了自动化数据科学与机器学习博客大赛,Auto-sklearn研发团队提交的一篇博文在本次大赛中获奖,你可以点击这里进行阅读,同样也可以点击这里来阅读对他们的的采访。Auto-sklearn是由Freiburg大学研发出来的。
Auto-sklearn已经被托管到GitHub上了,你可以找到相关文档以及API。
TPOT
TPOT被认为是“你的数据科学助手”(要注意,不是“你的数据科学替代品”)。它是一个Python的工具。通过使用“遗传编程来自动的创建与优化机器学习管道”。TPOT与Auto-sklearn类似,与scikit-learn协同工作。就像是scikit-learn的包装器。
在本文中,我们曾提到过,这两个工具使用不同的方式,达到相似的目标。二者都是开源的,都是使用python编写而成的,都宣称通过使用自动化机器学习的方式简化了机器学习的过程。然而Auto-sklearn使用的是贝叶斯优化,TPOT使用的却是遗传编程。
尽管两者使用的方法不同,但是二者的最终结果却是相同的:自动化超参数选择,用一系列算进行建模,对大量特征的探索,这些都导致了迭代建模以及模型进化。
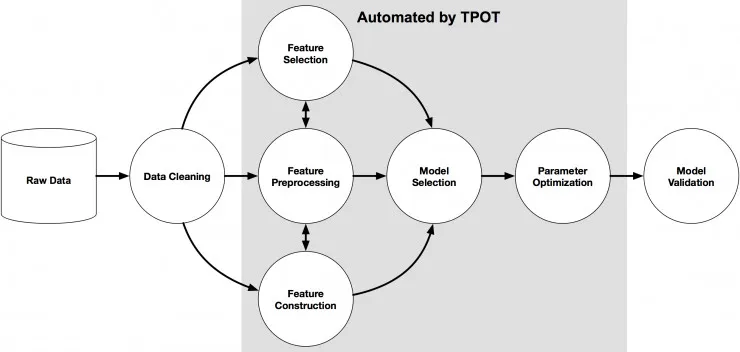
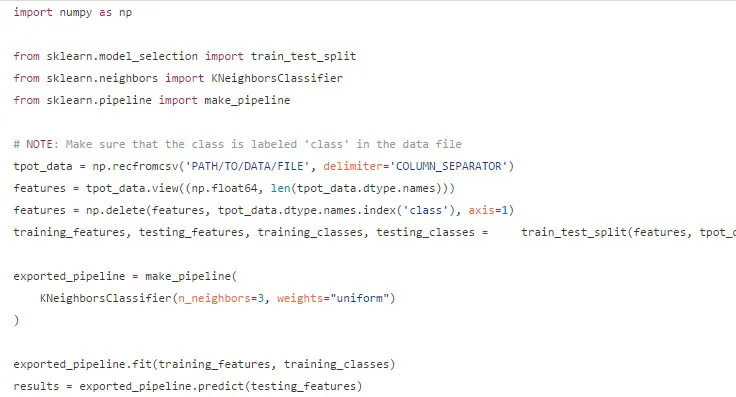
TPOT的真正好处之一就是使用scikit-learn的管道,产生可以准备运行的、独立的Python代码。这个代码代表着所有备选模型中表现最好的模型。我们就可以修改与审查这份代码。这份代码并不会是最终的模型,而是可以当做是我们寻找最优模型的有效起点。
下面是一个关于TPOT的例子,该案例使用MNIST数据集:
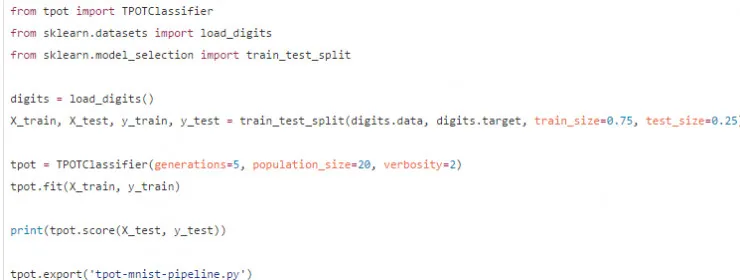
这次运行的结果正确率达到了98%,同时pyhton代码也就是我们所说的管道也会被导入到tpot-mnist-pipeline.py文件当中,如下所示:
我们可以在GitHub上找到TPOT的源代码,以及说明文档。
TPOT的领军人物Randy Olson在Kdnuggets上写过一篇关于TPOT 与AutoML(自动化机器学习)的文章,你可以点击这里找到该文章。也会在这里找到对Randy的采访。
TPOT是由宾夕法尼亚大学生物医学信息学研究所研究出来的,由NIH资助。
当然,自动化机器学习不仅仅只有这两个工具。还有其他的工具,像Hyperopt (Hyperopt-sklearn)、 Auto-WEKA,以及Spearmint等等。我打赌在未来几年,大量相关的额外项目将会出现,这些项目中既会包含研究项目,也会包含工业项目。
自动化机器学习的未来
自动化机器学习的未来在哪里?
我最近公开地进行过以下陈述(根据我的文章《2017年机器学习预测》):
自动化机器学习将变成重要的技术。在外人看来,它可能不如深度神经网络。但是自动化机器学习对于机器学习、人工智能以及数据科学都产生了深远的影响。这种影响极有可能在2017年显示出来。
在同一篇文章当中,Randy Olson也表达了在2017年他对自动化机器学习的期望。此外Randy在最近的采访中有更加详细地阐述了他的预测:
在不久的将来,我认为自动化机器学习将会替代机器学习的建模过程:一旦数据集拥有相对清晰的格式,那么自动化机器学习将会比99%的人类更快地设计与优化机器学习管道。
……
我可以很确定地认为自动化机器学习系统将会成为机器学习的主流。
但是自动化机器学习是否会替代数据科学家?Randy继续说道:
我并不认为自动化机器学习的目标是为了替代数据科学家,就像是智能代码自动完成工具的目标并不是来替代程序员一样。相反,对于我来说,自动化机器学习的的目标是为了减轻数据科学家的压力,使他们不必将大量的精力耗费在重复与耗时的任务上(比如说机器学习的管道设计与超参数的最优化)。这样他们就可以将时间投入到无法进行自动化的任务当中去。
这种思想十分好。auto-sklearn的开发人员也同样认同他的观点:
我们发展自动化机器学习方法是为了向数据科学家提供帮助,而不是代替他们。这些方法使数据科学家摆脱了讨厌复杂的任务(比如说超参数优化),机器可以很好地解决这些任务。然而数据分析与结论获取的工作仍然需要人类专家来完成。在未来,理解应用程序领域的数据科学家仍然极其的重要。
这听起来十分的鼓舞人心:数据科学家不会被大量替换,自动化机器学习是为了帮助他们更好的工作。这并不是说自动化机器学习已经很完美了。在我们提到自动机器学习是否还有进步空间的时候,Auto-sklearn团队如是说:
尽管有一些方法可以用来调试机器学习管道的超参数,但是目前为止很少有工作能发现新管道。Auto-sklearn以固定的顺序使用一系列的预定义的预处理器与分类器。假如一个方法对于找到新管道很有效,那么这个方法将会很有用处。当然,人们可以继续这种思路,并尝试自动寻找新的算法。最近,已经有几篇论文这样做了。比如说Learning to learn by gradient descent by gradient descent.(雷锋网此前也有提及这篇论文,它获得了RedditML小组评选的“年度最佳论文标题奖”)
自动化机器学习的发展方向在哪里?很难说清楚。毋庸置疑的是,迟早会出现。尽管不是所有的数据科学家都熟知自动化机器学习,但是熟知自动化机器学习将会使你获益匪浅。别忘了,假如你能够在大多数人意识到之前就去学习自动化机器学习,驾驭科技浪潮,你就不会因未来的不确定性而担心你的工作了。你对于这些技术的驾驭利用将会帮助你在未来更好的工作。而我也再想不出比这个更好的理由来学习自动化机器学习了。
本文作者:翻山
本文转自雷锋网禁止二次转载,原文链接