剖析大数据平台的数据处理

简介:

剖析大数据平台的数据处理

无论是采集数据,还是存储数据,都不是大数据平台的最终目标。失去数据处理环节,即使珍贵如金矿一般的数据也不过是一堆废铁而已。数据处理是大数据产业的核心路径,然后再加上最后一公里的数据可视化,整个链条就算彻底走通了。

如下图所示,我们可以从业务、技术与编程模型三个不同的视角对数据处理进行归类:
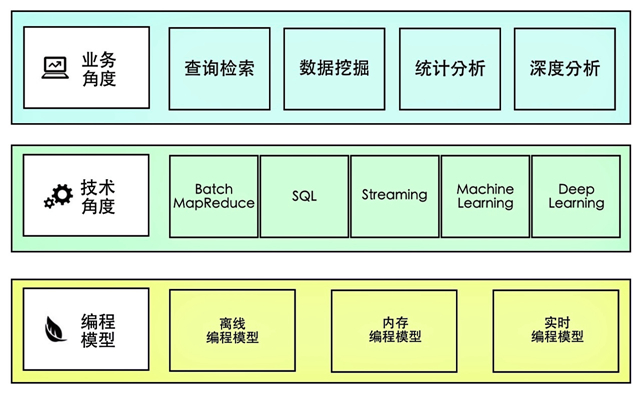
业务角度的分类与具体的业务场景有关,但最终会制约技术的选型,尤其是数据存储的选型。例如,针对查询检索中的全文本搜索,ElasticSearch会是最佳的选择,而针对统计分析,则因为统计分析涉及到的运算,可能都是针对一列数据,例如针对销量进行求和运算,就是针对销量这一整列的数据,此时,选择列式存储结构可能更加适宜。

在技术角度的分类中,严格地讲,SQL方式并不能分为单独的一类,它其实可以看做是对API的封装,通过SQL这种DSL来包装具体的处理技术,从而降低数据处理脚本的迁移成本。毕竟,多数企业内部的数据处理系统,在进入大数据时代之前,大多以SQL形式来访问存储的数据。大体上,SQL是针对MapReduce的包装,例如Hive、Impala或者Spark SQL。

Streaming流处理可以实时地接收由上游源源不断传来的数据,然后以某个细小的时间窗口为单位对这个过程中的数据进行处理。消费的上游数据可以是通过网络传递过来的字节流、从HDFS读取的数据流,又或者是消息队列传来的消息流。通常,它对应的就是编程模型中的实时编程模型。

机器学习与深度学习都属于深度分析的范畴。随着Google的AlphaGo以及TensorFlow框架的开源,深度学习变成了一门显学。我了解不多,这里就不露怯了。机器学习与常见的数据分析稍有不同,通常需要多个阶段经历多次迭代才能得到满意的结果。下图是深度分析的架构图:
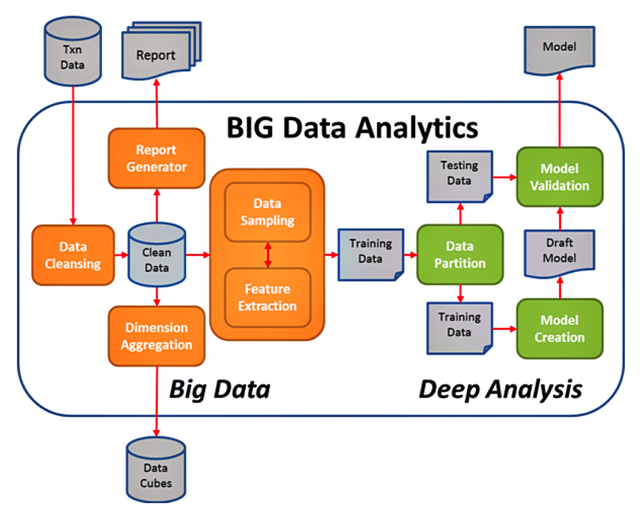
针对存储的数据,需要采集数据样本并进行特征提取,然后对样本数据进行训练,并得到数据模型。倘若该模型经过测试是满足需求的,则可以运用到数据分析场景中,否则需要调整算法与模型,再进行下一次的迭代。

编程模型中的离线编程模型以Hadoop的MapReduce为代表,内存编程模型则以Spark为代表,实时编程模型则主要指的是流处理,当然也可能采用Lambda架构,在Batch Layer(即离线编程模型)与Speed Layer(实时编程模型)之间建立Serving Layer,利用空闲时间与空闲资源,又或者在写入数据的同时,对离线编程模型要处理的大数据进行预先计算(聚合),从而形成一种融合的视图存储在数据库中(如HBase),以便于快速查询或计算。

不同的业务场景(业务场景可能出现混合)需要的数据处理技术不尽相同,因而在一个大数据系统下可能需要多种技术(编程模型)的混合。

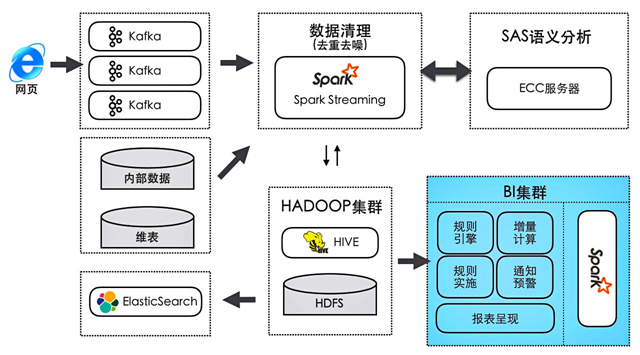
我们在为某厂商实施舆情分析时,根据客户需求,与数据处理有关的部分就包括:语义分析、全文本搜索与统计分析。通过网络爬虫抓取过来的数据会写入到Kafka,而消费端则通过Spark Streaming对数据进行去重去噪,之后交给SAS的ECC服务器进行文本的语义分析。分析后的数据会同时写入到HDFS(Parquet格式的文本)和ElasticSearch。同时,为了避免因为去重去噪算法的误差而导致部分有用数据被“误杀”,在MongoDB中还保存了一份全量数据。如下图所示:
Airbnb的大数据平台也根据业务场景提供了多种处理方式,整个平台的架构如下图所示:
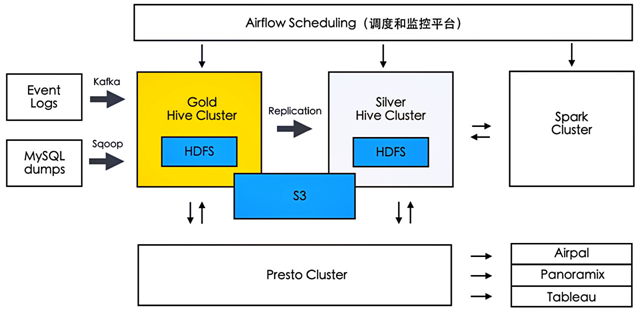
Panoramix(现更名为Caravel)为Airbnb提供数据探查功能,并对结果进行可视化,Airpal则是基于Web的查询执行工具,它们的底层都是通过Presto对HDFS执行数据查询。Spark集群则为Airbnb的工程师与数据科学家提供机器学习与流处理的平台。

行文至此,整个大数据平台系列的讲解就快结束了。最后,我结合数据源、数据采集、数据存储与数据处理这四个环节给出了一个整体结构图,如下图所示:
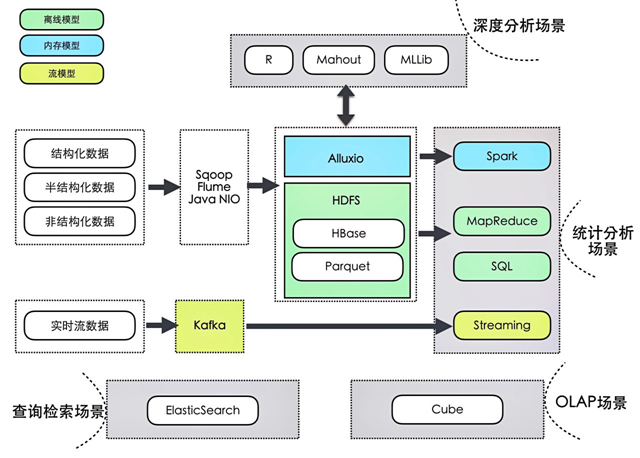
这幅图以查询检索场景、OLAP场景、统计分析场景与深度分析场景作为核心的四个场景,并以不同颜色标识不同的编程模型。从左到右,经历数据源、数据采集、数据存储和数据处理四个相对完整的阶段,可供大数据平台的整体参考。


本文作者:张逸

来源:51CTO
相关实践学习
基于MaxCompute的热门话题分析
Apsara Clouder大数据专项技能认证配套课程:基于MaxCompute的热门话题分析
相关文章
|
数据采集 机器学习/深度学习 算法
|
1月前
|
运维 API C++
香港云服务器vs美国云服务器,2026跨境商用选型指南
本文以“用户地域分布”为核心,深度解析香港与美国云服务器选型逻辑:亚太用户首选香港(低延迟、双向稳定、免备案);欧美用户优选美国(本地极速、大带宽、高性价比);混合流量可按占比决策或双节点分流。避开常见误区,兼顾线路、带宽、IP、运维四大商用维度,助跨境业务精准匹配最优节点。
|
1月前
|
Web App开发 缓存 数据安全/隐私保护
ChatGPT DeviceCheck 验证报错 403/500/503 的有效解决方案
DeviceCheck 报错是设备认证失败(非账号问题),发生在密码校验前,仅影响原生App。根因包括系统缓存异常、未完成更新、越狱/root、Play Integrity失效或macOS证书链中断。网页版完全不受影响。
|
2月前
|
人工智能 自然语言处理 安全
国外与国内大模型GEO优化:底层逻辑差异解析
本文深度剖析GEO(生成式引擎优化)在国内外大模型间的根本差异:国外重“证据链”(权威出处、精确数据、可溯源引用),国内重“语境链”(中文表达、生态闭环、实体沉淀);并揭示四大底层逻辑分野——证据vs语境、透明vs凝练、证据信号vs结构信号、制度约束vs备案准入。强调双轨策略,而非一稿多译。
263 0
|
8月前
|
Web App开发 存储 NoSQL
互联网医院系统开发如何实现在线问诊与图文视频会诊
本文深度剖析互联网医院在线问诊系统的技术本质,揭示其远超IM+视频SDK的复杂性——实为“订单驱动型医疗业务系统”。从表结构设计、状态机控制、WebSocket图文通信、TRTC视频接入,到合规留痕与高并发优化,全链路拆解SpringBoot+MySQL+Redis+WebRTC技术方案,并附核心代码示例。(239字)
|
3月前
|
存储 人工智能 JSON
Qwen 本地部署搭配 ComfyUI AI 漫剧完整实操指南|零基础小白落地,零成本无限生成,解决角色一致性难题
2026全网唯一零成本、纯本地AI漫剧全自动流水线:Ollama+Qwen3.5离线写剧本,ComfyUI+Qwen-Image3.0精准绘图,IPAdapter+FaceID三重锁人,8G显卡流畅运行,全程角色统一、隐私安全、无限量产。(239字)
|
6月前
|
人工智能 算法 JavaScript
深度解析 AI 眼镜虚拟试戴技术
本方案提供高精度AI眼镜虚拟试戴API,融合亚像素级3D面部追踪、PBR物理渲染与实时几何校准技术,精准还原镜框贴合度、镜片反光/渐变/偏光效果及遮挡关系,支持全渠道快速集成,显著提升试戴真实感与转化率。(239字)
728 3
|
7月前
|
缓存 供应链 搜索推荐
外贸B2B网站建设实践:从架构设计到转化链路的技术思考(2026)
本文聚焦B2B外贸独立站建设,从网站架构、SEO优化、交互设计及数据追踪四大技术维度,剖析模板化、插件驱动与数据驱动三类建站模式的优劣,并提出信任信息结构化展示、简洁询盘设计、系统集成等关键实践,助力企业高效获客。(239字)
449 1
外贸B2B网站建设实践:从架构设计到转化链路的技术思考(2026)
|
6月前
|
存储 运维 安全
通行密钥(Passkey)身份认证机理、安全优势与工程化实现研究
本文系统研究通行密钥(Passkey)技术,基于FIDO2/WebAuthn标准,剖析其非对称加密、源绑定与本地签名机制,对比密码及密码管理器在安全、可用性与工程风险上的短板。实证表明:通行密钥可将钓鱼攻击成功率趋近于零,账户劫持风险降低99%以上,兼具高安全性与优用户体验,是当前最成熟、可落地的无密码认证方案。(239字)
502 3
|
5月前
|
JSON 测试技术 API
别再卷提示词了,真正的护城河是你的私有Skill库
本文揭示AI工程化新趋势:提示词工程师岗位正快速消亡,真正壁垒在于构建私有Skill库。Skill将高频决策固化为可复用、带容错的低代码资产,深度绑定业务逻辑与私有配置,难以复制。文章对比OpenClaw、Cursor、Claude Code策略,提供从0到1建设路径,并指出三年后团队核心竞争力源于对业务的理解与Skill化沉淀。