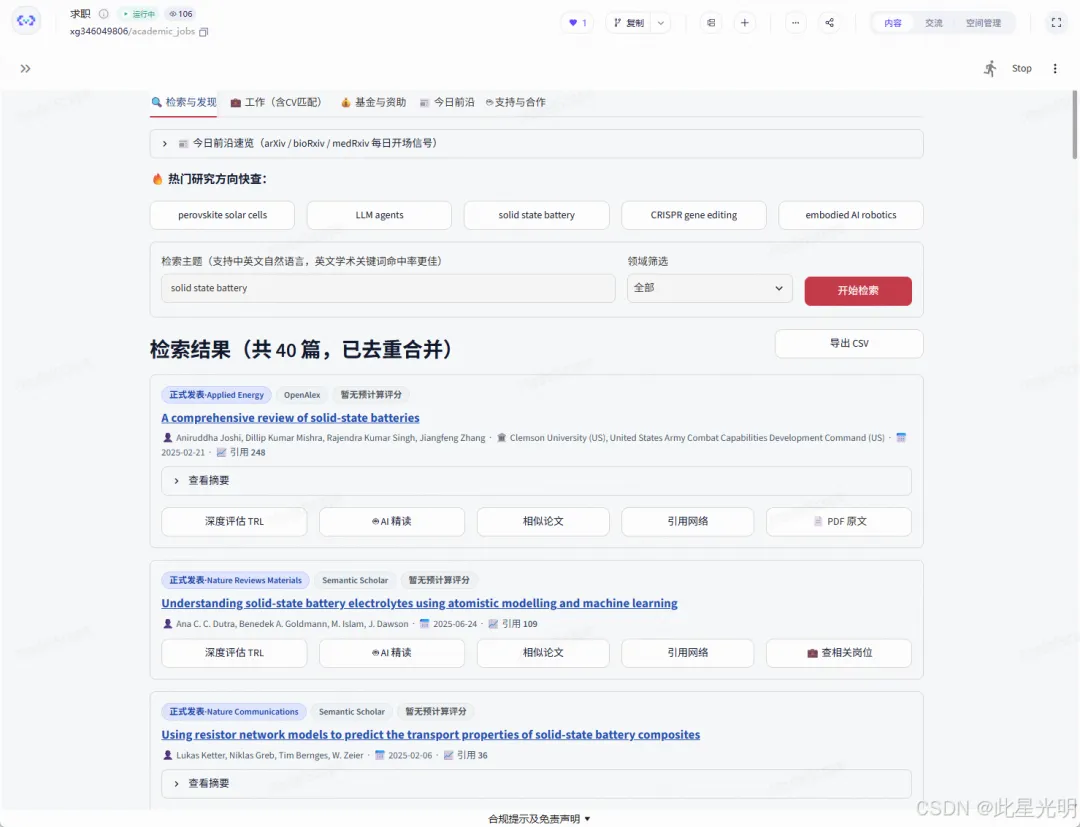
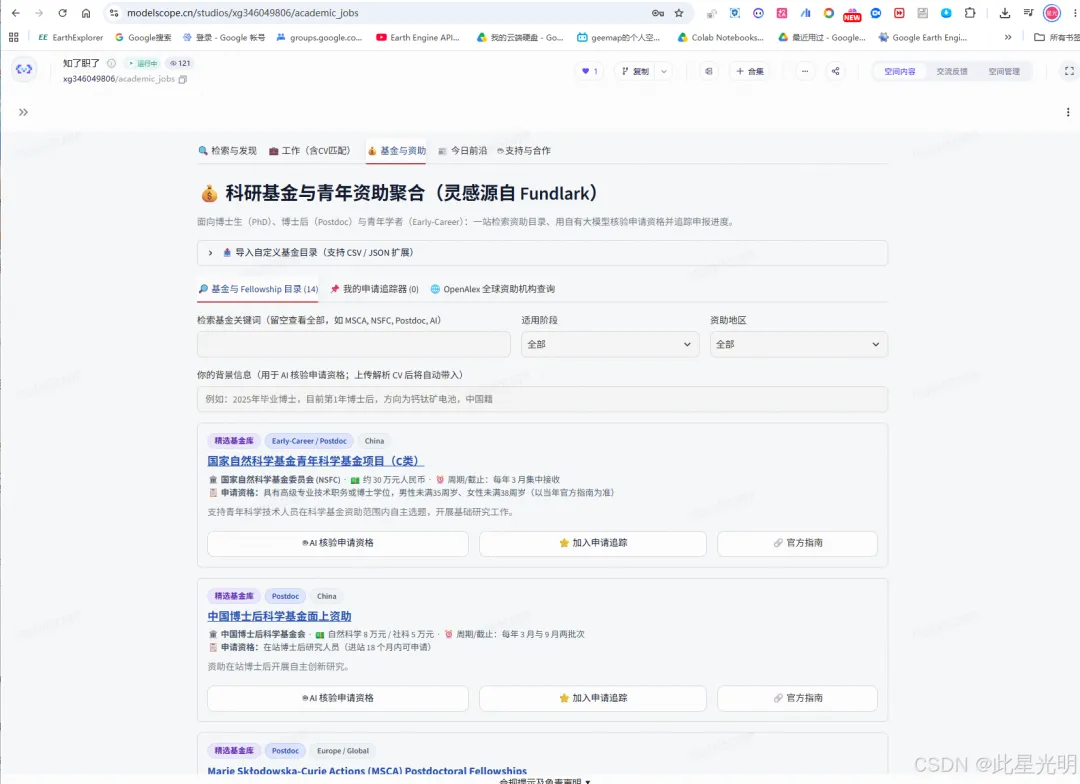
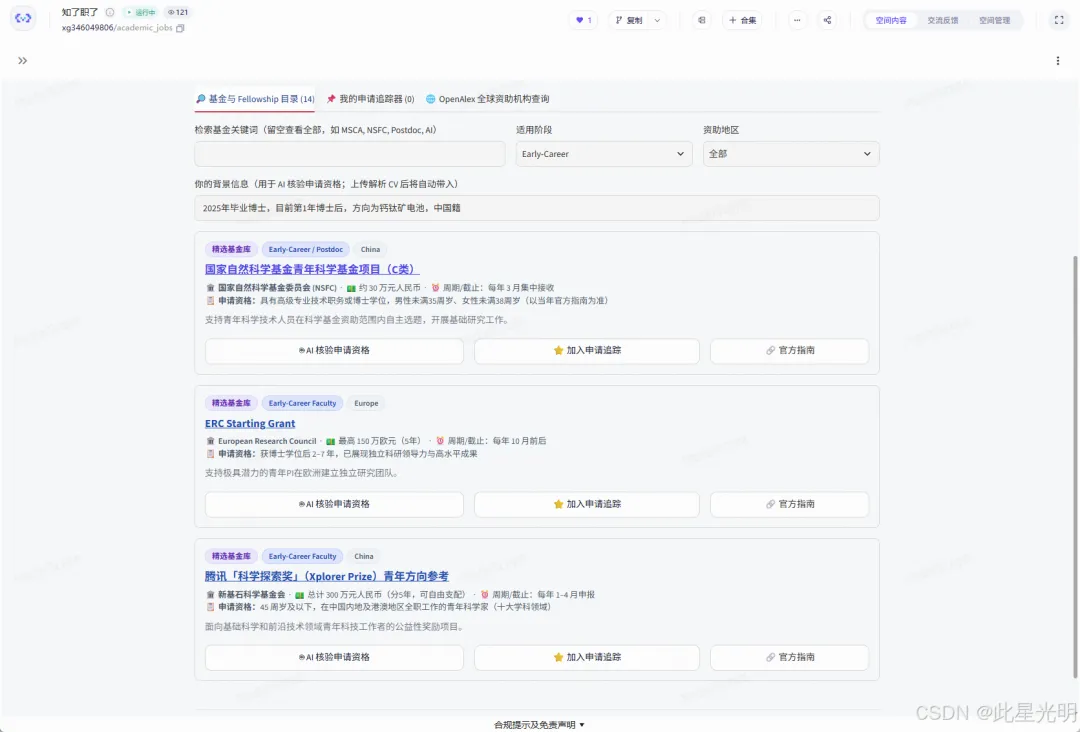
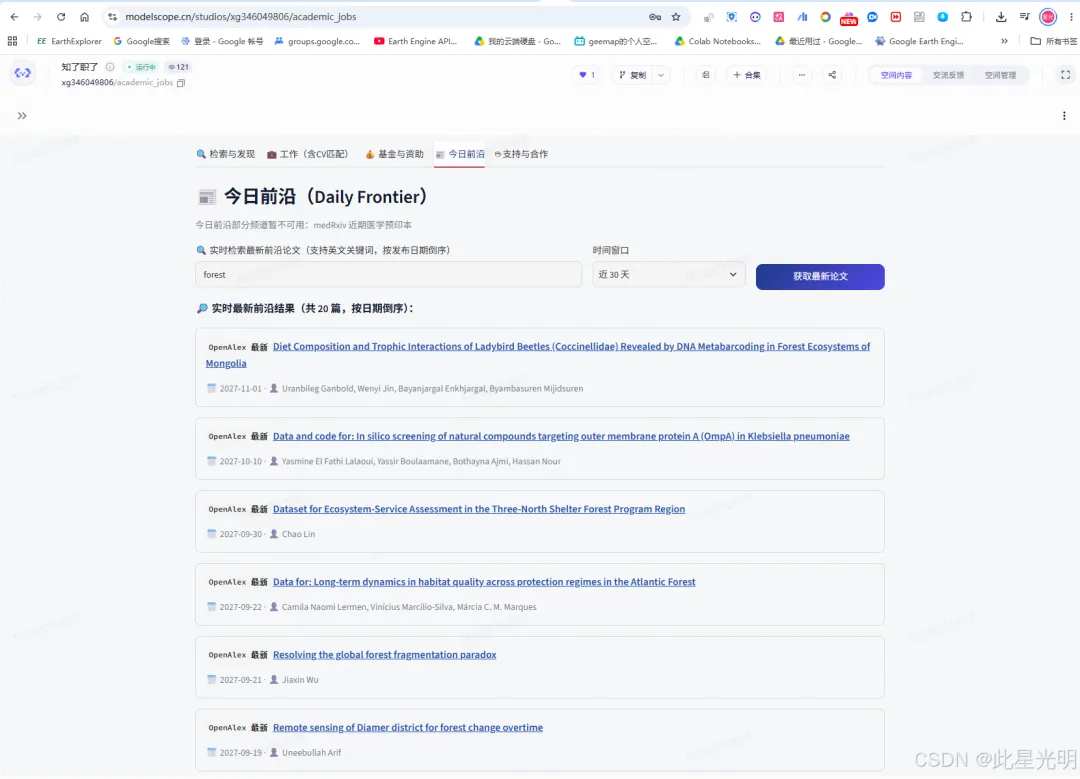
acad-job 在 README 中的自我定位非常直白:“科研前沿 × 产业化 × 学术求职与基金聚合器” 。它把四件在传统科研训练中彼此分离的事情串成了一条线: 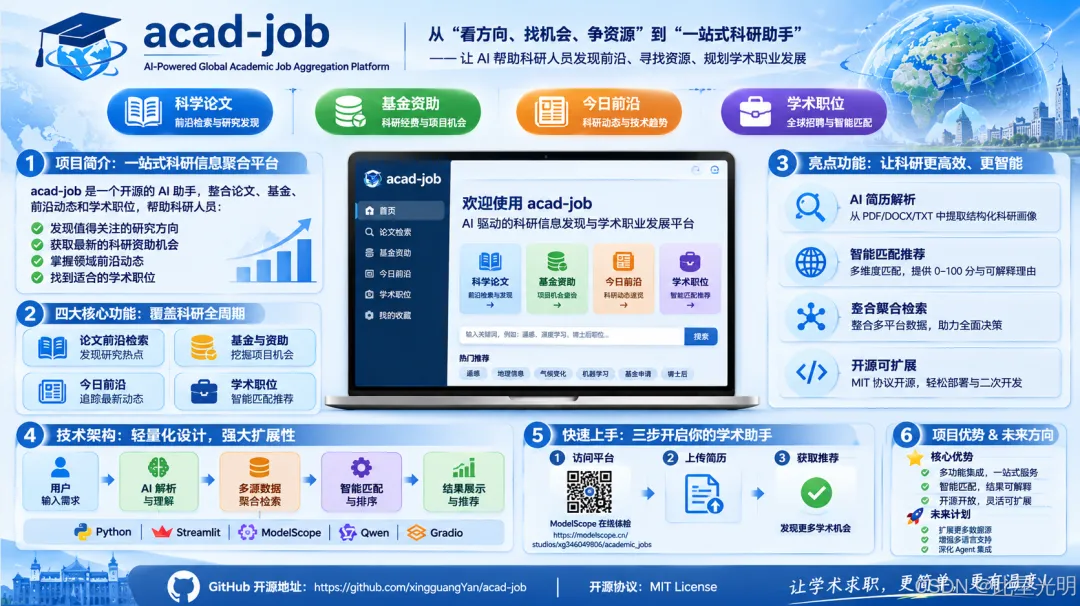 检索与发现回答“这个方向值不值得跟”——中英文自然语言检索论文,并发查询 OpenAlex、Semantic Scholar 和 arXiv,按 DOI 去重合并,然后自动注入商业潜力分级、arXiv 90 天趋势和 PatentsView 专利信号。工作与 CV 匹配回答“哪里有位置”——静态精选岗位库叠加实时 RSS 学术岗位流,用户上传 PDF/DOCX/TXT 简历后,由大模型解析学术画像,先做硬过滤(职位级别、地域、截止日期),再做软排序(研究方向语义相似度 + 发表/技能匹配),输出 0–100 分和可解释的匹配理由。基金与资助回答“钱在哪里”——内置青年科研基金库(如 NSFC 青年项目),支持资格筛选、核验与进度追踪,并可用 OpenAlex 资助方数据做补充。今日前沿提供每日 arXiv / bioRxiv / medRxiv 最新预印本的领域分桶速览,作为用户的“开场信号”。
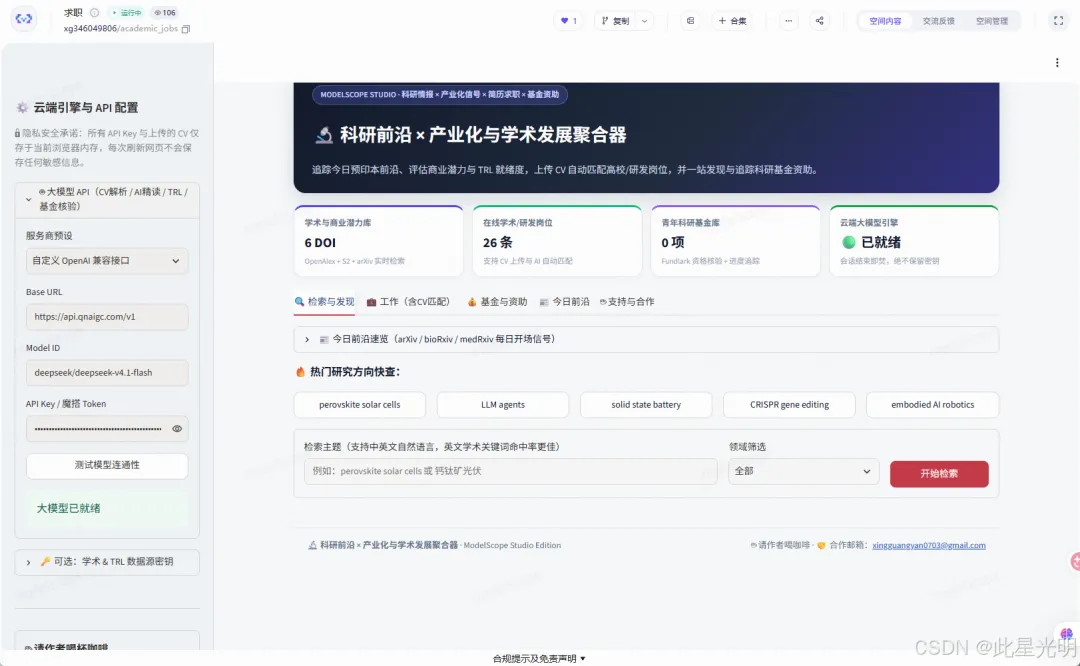
这四件事共享同一个底层逻辑:用户不需要在五个标签页、六个数据库和一堆邮件列表之间来回切换,而是在一个界面里完成一次决策链条。这正是上一篇文章中那个“只有两个字标签”的创空间试图触及、但受限于平台资源无法展开的东西。
技术架构:Streamlit 单入口 + 模块化 src/ + 外部 API 编排
acad-job 的仓库结构泄露了它的全部设计哲学。根目录下的 app.py 是 Streamlit 入口,负责页面配置、缓存和标签页编排;requirements.txt 承载 Python 依赖;真正的业务逻辑被拆分到 src/ 下的九个模块中,每个模块对应一类信号的处理管道。 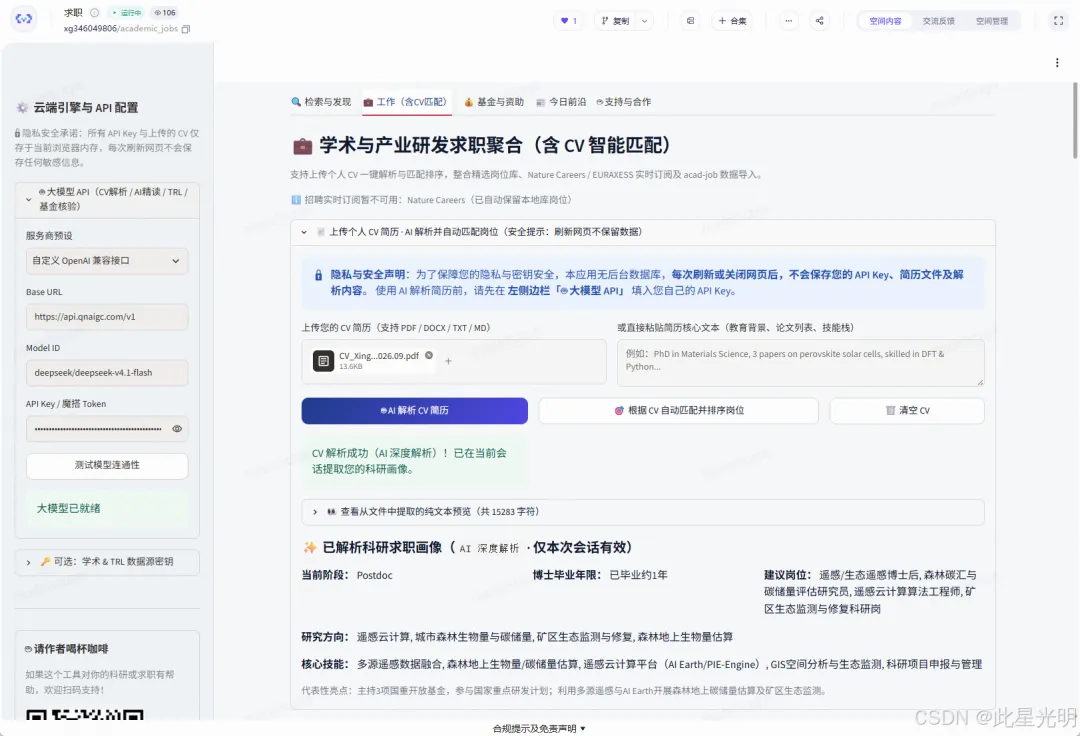
| 模块 | 职责 | 关键外部依赖 |
academic_api.py |
并发检索 OpenAlex / Semantic Scholar / arXiv,按 DOI 去重合并 | 三个学术 API |
industrial_signals.py |
arXiv 90 天趋势、PatentsView 专利信号、Apify TRL 评估 | arXiv、PatentsView、Apify |
job_signals.py |
静态岗位加载、RSS 岗位流合并、岗位过滤 | 本地 CSV + RSS |
grant_signals.py |
基金加载、过滤、资格初筛、OpenAlex 资助方补充 | 本地 CSV + OpenAlex |
cv_matcher.py |
简历文本抽取、硬过滤 + 软排序匹配 | 大模型(可选) |
llm_client.py |
兼容 OpenAI 协议的大模型客户端 | LLM API(可选) |
ui_components.py / styles.py / config.py |
侧边栏、卡片渲染、CSS、环境变量聚合 | — |
这套结构的关键约束是:应用本身不运行任何模型推理,也不维护数据库。所有“智能”能力(简历解析、匹配排序、基金资格初核、论文摘要)通过 llm_client.py 调用外部大模型 API 完成;所有产业化信号来自预计算 CSV 或第三方接口的按需查询。data/ 目录下的三个 CSV——academic_jobs.csv(精选岗位库)、research_grants.csv.csv(青年基金库)、commercial_potential.csv(DOI → 商业潜力分级)——扮演的是兜底层的角色:即使所有外部 API 都不可用,静态数据仍然可以支撑岗位浏览和基金筛选。 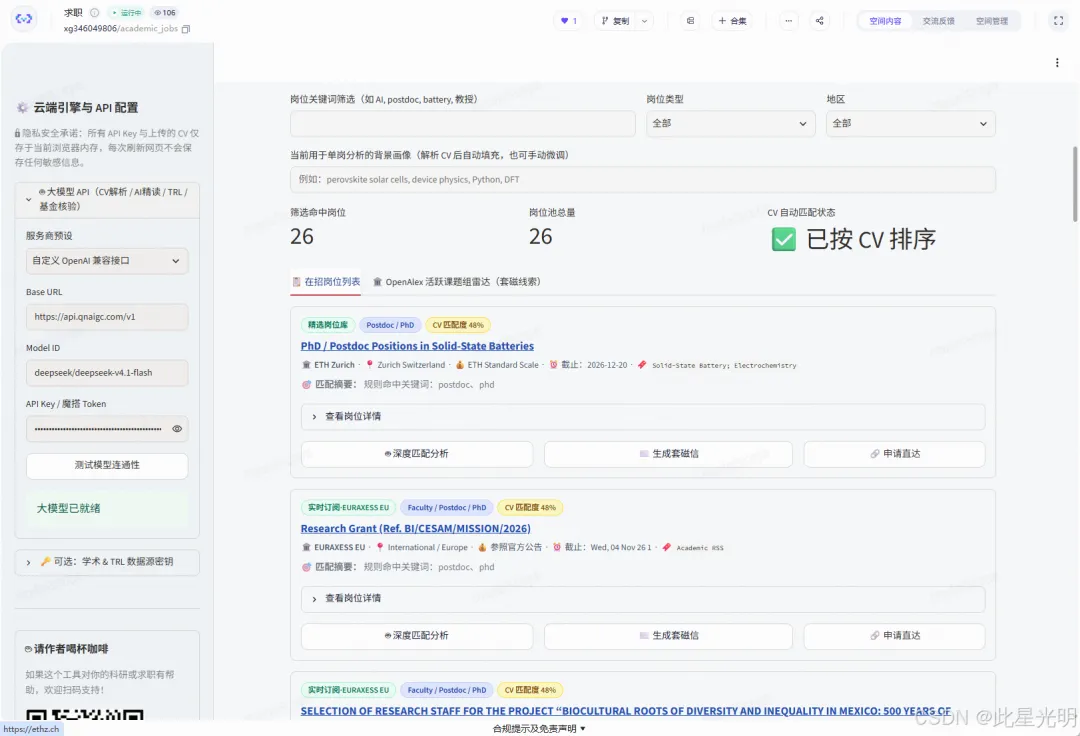
这种设计的代价是实时性受制于外部 API 的可用性和速率限制;收益是零数据库运维、零模型部署、单文件启动。在 Streamlit Cloud 或 ModelScope 创空间这类免费或低成本环境中,这是唯一可持续的架构选择。
代码:如何启动,以及密钥如何“关闭即焚”
acad-job 的启动方式被刻意压到了两行:
pip install-r requirements.txtstreamlit run app.py
默认打开 http://localhost:8501。所有 API Key 不要求预先写入任何配置文件——用户可以在左侧边栏现场填写,Key 仅保存在 Streamlit 的会话内存中,关闭页面即焚。也可以用环境变量预置,但所有变量都被标注为“可选”:OPENALEX_API_KEY、SEMANTIC_SCHOLAR_API_KEY、APIFY_API_TOKEN(TRL 评估)、PATENTSVIEW_API_KEY、COMPOT_CSV_PATH、JOBS_CSV_PATH、GRANTS_CSV_PATH。没有任何 Key 时,应用仍然可以启动:静态数据和基础检索可用,AI 相关功能显示“待填 Key”,而不是直接崩溃。
这一设计选择在学术求职工具中并不常见,但它与 acad-job 的用户画像高度匹配:目标用户是科研学生、博士后和青年 PI,其中相当一部分人不具备配置云服务、管理 Secrets 或维护 Python 环境的技术意愿。让 Key 的生命周期与浏览器标签页同步,牺牲的是“一次配置、长期使用”的便利性,换来的是零门槛的首次体验——一个正在投简历的人,可以在五分钟内把应用跑起来,而不需要先读一份部署文档。
部署:本地、ModelScope Studio 与 Streamlit Cloud 的三行路径
README 的部署章节只有三个条目,但覆盖了从个人笔记本到公共云的全部场景:
本地:streamlit run app.py。ModelScope Studio / Streamlit Cloud:入口文件设为 app.py,持久化目录指向 /mnt/workspace/data,敏感信息走平台 Secrets,不要写入仓库。
最后一句不是装饰性的提醒。acad-job 的 .gitignore 明确排除了 __pycache__ 和标准 Python 临时文件,提交历史中也没有出现过 API Key 泄露的痕迹。对于在公共平台上部署的科研工具,密钥卫生不是最佳实践,而是最低合规要求。
版本演进:从 Gradio 骨架到 Streamlit 聚合器,一次有信息量的重构
acad-job 的版本历史只有两条,但第二条的幅度值得注意:
v1.0 是 AcademicJobsOnline 适配器 + Gradio 前端骨架,代码保留在 scripts/scaffold_phase1.py 中作为历史模板。v2.0 是一次整体重构:前端从 Gradio 切换到 Streamlit,功能从“单一岗位适配器”扩展为“文献检索 + 产业化信号 + 基金 + CV 匹配”的聚合器,并新增了 src/ 下的全部模块化管道。
从 Gradio 迁移到 Streamlit 并非随意的技术选型偏好。Gradio 的强项在于快速暴露模型接口,但在多标签页编排、会话状态管理和复杂布局上,Streamlit 的原生能力更直接地匹配 acad-job 的需求:四个功能模块需要在同一个侧边栏下共享配置(LLM Key、API Key、静态数据路径),而 Gradio 的状态管理在这种场景中会迅速变得笨重。选择 Streamlit 不是因为它是“更好的框架”,而是因为它的约束条件恰好落在 acad-job 的可接受范围内——单文件入口、会话级状态、零后端、可以通过 st.cache 做轻量缓存。
合规与边界:一份写在 README 里的“免责声明”,也是一份设计文档
acad-job 的 README 中有四条“合规与边界”声明,它们不只是法律措辞,而是对系统能力边界的诚实标注:
第一,职位与基金数据“不保证实时性与完整性,申请前以原始链接为准” 。这直接对应架构中“静态 CSV + RSS 按需拉取”的组合——RSS 流提供近实时信号,但静态库才是可保证存在的兜底数据。
第二,遵守目标站点的 robots.txt 与 crawl-delay。这意味着 acad-job 不依赖无节制的爬取来维持数据新鲜度,而是接受“在合规前提下尽可能聚合”的约束。
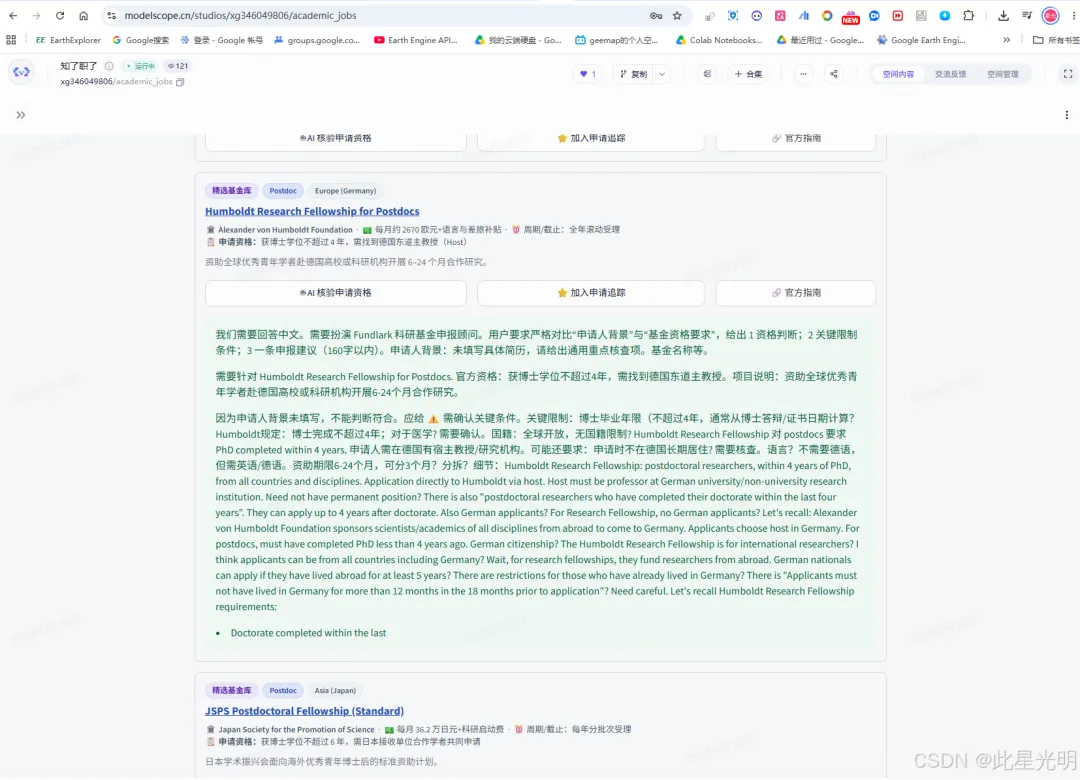
第三,AI 功能“仅辅助判断”,不代写求职信正文,不修改简历内容,最终决定权在用户” 。这与 cv_matcher.py 的设计一致:LLM 输出的是匹配分数和可解释理由,而不是一份可以直接提交的申请材料。系统的角色是缩小候选集,而不是替用户做决定。
第四,密钥只保存在会话内存或环境变量,绝不出现在代码与提交历史中。这一条已经通过 .gitignore 和仓库的提交记录得到了验证。
这个项目以 Apache 2.0 许可开源,意味着任何人可以 fork、修改、部署到自己的服务器或创空间。它不追求成为一个“平台”,而是提供一个可以被重新组装的基础件。一个课题组的技术转移办公室可以把 commercial_potential.csv 替换成自己领域的产业化评估数据;一个学院的研究生可以修改 job_signals.py 来接入本领域的专属岗位源;一个青年 PI 可以在 grant_signals.py 中加入自己关注的基金项目。薄,恰恰是它可以被重新组装的前提。
从一个只有“求职”两个字的创空间,到一个有结构、有模块、有部署路径和明确边界的开源应用,acad-job 展示的不是“一个工具变得更强大了”,而是一个更朴素的命题:在系统性压力面前,能够被快速搭建、快速修改、快速部署的薄工具,比等待一个完美方案更接近可操作。