
大模型落地最容易被低估的成本,不是模型调用费,而是“把能力拼成系统”的工程摩擦:文本模型一家、图像模型一家、语音模型又一家,接口风格各异、计费口径不同、弹性策略互不相通,团队大量时间耗在适配与运维上,而不是业务创新上。阿里云大模型能力体系的价值,恰恰在于把这些能力收敛到同一套产品矩阵与技术底座上。本文从技术视角拆解这套体系的分层结构,以及每一层在真实落地中解决什么问题。
一、能力层:按模态划分的模型矩阵
文本生成是体系的主干。 产品页上可以看到面向不同定位的文本模型:Qwen3.8-Max 作为旗舰版本,适合智能体时代对综合能力要求高的任务;Qwen3.8-Flash 主打百万级上下文窗口,能一次性处理超长文档和代码仓库;Kimi-K3 侧重长程编程与推理;Deepseek-v4-pro 以 MoE 架构提供百万上下文与顶尖推理能力;GLM-5.2 的 1M 上下文则专为长程任务而生。选型逻辑不是“哪个最强”,而是按任务长度、推理深度与成本容忍度匹配。
图像与视频生成覆盖创意生产链路。 Wan3.0-Video 支持四模态全能参考,多种创作一站完成;Qwen-Image-3.0-Pro 强调细节真实与知识厚实,把图像生成做成可落地的生产力工具;HappyHorse-1.1-T2V 负责文字到高质量视频的转换。这类负载的共同特征是显存峰值高、单次耗时集中,容量规划要围绕并发出图能力展开。
语音识别与合成补齐交互闭环。 语音链路的工程难点在冷启动与实时性,Happy 系列等模型深度适配广告营销等场景,配合弹性实例可以把实时合成与批量处理分流承载。
二、平台层:让模型“可调用、可体验、可计量”
千问 AI 平台-Token Plan 是计费与接入的收敛点。 个人版上线、团队版降价的背后,是按 Token 计量的统一口径:业务侧不必为每个模型单独谈价、单独对接,调用量可以按统一账单管理,成本核算的分母也从“理想满载”回归真实请求分布。
在线体验降低选型试错成本。 全尺寸、多种模态的模型效果可以在同一入口对比,团队在写第一行接入代码之前,就能用真实业务样本验证模型是否匹配场景,避免“先接入再返工”。
三、应用与方案层:从模型能力到业务落地
大模型原生应用与解决方案是能力的封装形态。 对多数企业而言,直接调用裸模型只是起点,真正落地需要的是带业务逻辑的应用模板与行业解决方案。这一层把提示词工程、上下文管理、工具调用编排等共性工作预先沉淀,团队只需聚焦自身数据与流程差异。
AI 应用市场汇聚伙伴产品。 大模型、AI 应用与行业解决方案在这里形成供给生态,企业可以按场景选择成熟组件,而不是所有环节自研。
四、技术支撑层:算力、弹性与运维底座
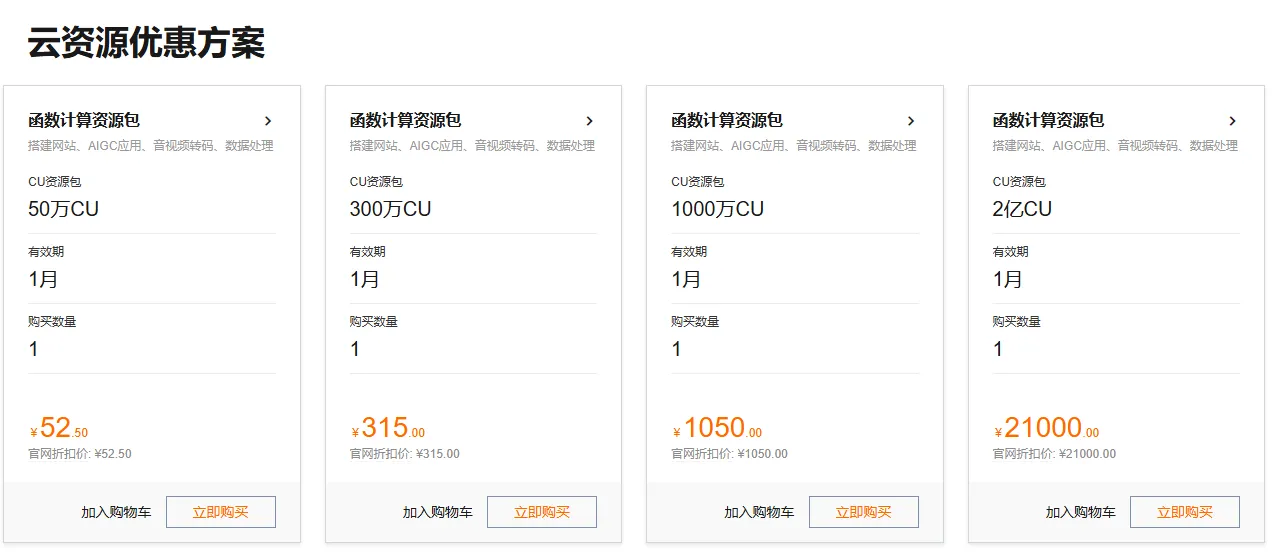
函数计算 FC 承担弹性推理的底座角色。 其免运维、Serverless GPU 极致弹性、按量付费的特性,正好匹配大模型负载“波峰波谷明显、冷启动代价高”的特征:基础流量用预留实例保底,波峰交给弹性实例承接,波谷不为闲置买单。产品页上“三步快速部署专属 AI 大模型”的路径,本质上就是把模型部署、弹性配置与计费口径标准化。
配套产品形成完整支撑。 云服务器 ECS 提供安全可靠的弹性算力;容器计算服务 ACS 以 Kubernetes 为界面供给容器算力;负载均衡 SLB 按需分发流量;云数据库 RDS 承载业务数据;MaxCompute 面向分析场景提供企业级云数据仓库;日志服务 SLS 提供一站式可观测性数据存储分析;DataWorks 做一站式智能数据开发治理。推理服务的延迟分位值、失败率、实例利用率、冷启动比例等指标,正需要 SLS 这样的统一采集与告警能力才能形成闭环。
成本与权益体系降低试错门槛。 上云优选提供超 140 款免费试用产品,初创企业最高可得 100 万抵扣金,5 亿算力补贴面向新迁上云场景。对技术团队而言,这意味着可以在真实负载上做压测与基线采集,而不是靠纸面估算做容量决策。
把这套体系拆开看,它的技术逻辑是一致的:模型层按模态与任务特征分工,平台层统一接入与计量口径,应用层封装共性工程工作,支撑层用弹性算力与可观测性兜住真实流量。团队落地时建议按此顺序推进:先用在线体验验证模型匹配度,再通过统一平台接入并建立性能基线,最后用函数计算的弹性配比覆盖波峰。完整的模型能力清单、部署指引与优惠方案,可访问活动页面了解:一键打造你的专属AI应用 手把手玩转热门AI大模型 。从看清矩阵分层开始,把“一站式”从宣传语变成可执行的技术路线。
