
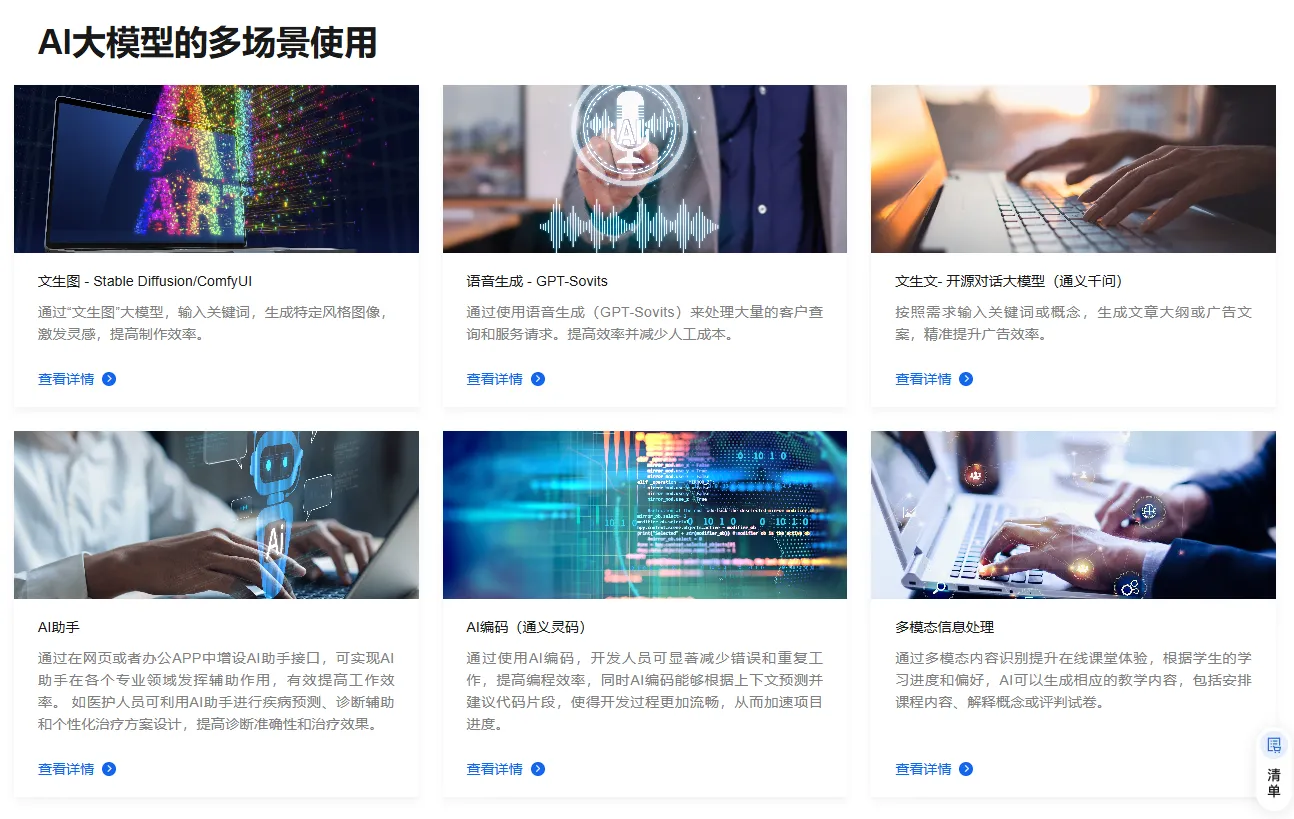
同一个大模型能力池,落到不同业务场景里,技术路线的差异远比“换个模型”要大。文生图关心的是显存峰值与单张耗时,语音生成在意首字节延迟与并发隔离,文生文比拼的是上下文窗口与吞吐成本,AI 编码则对长程推理和工具调用链路更敏感。本文把四类场景放在同一张技术地图上对比,帮助团队在选型与架构设计时看清:哪些环节可以复用,哪些必须按场景单独优化。
一、四类场景的负载特征先对齐
文生图是“重计算、短输出”型负载。 扩散模型单次推理的算力集中在前向去噪过程,输出是一张图,链路短但显存占用高。性能评估要看冷启动耗时、单张耗时与批大小对显存峰值的影响,容量规划的核心是实例保有量与并发出图能力的平衡。
语音生成是“加载重、推理轻”型负载。 模型权重加载与音色初始化耗时明显,但单句合成本身较快。它更关注首字节延迟与实时性,架构上通常需要把实时合成与批量合成分流,用预留实例保底、弹性实例承接波峰。
文生文是“长上下文、连续输出”型负载。 吞吐与上下文长度强相关,Token 级流式输出决定了体验。评估重点是首 Token 延迟、每秒生成 Token 数与长上下文下的显存占用,成本核算要以真实输入输出长度分布为分母。
AI 编码是“长程任务、多轮工具调用”型负载。 它不只是文本生成,还涉及代码仓库级上下文、工具调用、多轮修正。链路长、单任务耗时不可预测,对上下限管理与任务编排的要求高于单纯的推理性能。
二、共性能力:四类场景可以复用的部分
服务化与无状态设计是共同前提。 无论哪类场景,把模型封装为独立推理服务、业务侧只依赖接口契约,都能让模型升级与参数调整不波及主流程。无状态化之后,弹性伸缩才能真正生效。
弹性与按量付费是共同的成本底座。 四类负载都有明显波峰波谷,预留实例覆盖基础流量、按量实例承接峰值,是通用的配比思路。差异只在预留比例的确定依据:文生图看冷启动容忍度,语音看实时与异步的分流比例,文生文看并发会话数,AI 编码看任务队列深度。
可观测性建设方法一致。 延迟分位值、失败率、实例利用率、冷启动比例这几类指标对四类场景都适用,差别在于需要补充场景专属指标,如文生图的单张耗时分布、语音的首字节延迟、编码任务的工具调用成功率。
三、差异点:四类场景各自的架构关键
文生图的关键在冷启动与批处理。 冷启动秒级到分钟级不等,交互式场景必须用预留实例覆盖基础流量;批量出图可通过提高批大小摊薄固定开销,但要与显存上限联动评估。异步任务队列是承接波峰的安全阀。
语音生成的关键在分流与降级。 实时问答走同步短链路,外呼与播报走异步队列;过载时按预设策略降级(降低采样率、切换轻量音色、转文本回复),避免请求堆积拖垮服务。
文生文的关键在流式与上下文管理。 流式输出决定交互体验,上下文截断与摘要策略决定长对话的成本上限。高并发下要控制单会话的上下文长度,避免个别超长请求挤占吞吐。
AI 编码的关键在任务编排与工具链。 单任务可能包含多轮生成、执行、修正,需要为任务设置超时与重试上限,并把代码检索、执行环境等工具做成可独立伸缩的服务,避免推理与工具执行相互阻塞。
四、选型与落地:把对比结论转成配置决策
按场景定基线,不共用一套参数。 四类场景应各自建立性能基线档案:记录模型版本、实例规格、关键延迟指标与成本口径,升级后重新采集,避免用旧基线做新决策。
按流量结构定预留比例。 可预测的基础流量用预留实例覆盖,波峰与异步任务交给弹性实例。预留过多会在低谷期闲置,预留不足则冷启动拖垮体验,比例应以实测低谷流量与峰值容忍度共同确定。
按业务价值分级配置。 延迟敏感的交互场景优先保体验,时效宽松的批处理优先控成本,两类流量在架构上分离承载,成本曲线才能贴近真实价值。
函数计算的 Serverless 弹性与按量付费特性,配合 GPU 实例规格与预置的模型部署方案,使文生图、语音生成、文生文与 AI 编码这几类特征迥异的负载,都能按实测数据配比预留与弹性资源。完整的模型能力清单、部署指引与优惠方案,可访问活动页面了解:一键打造你的专属AI应用 手把手玩转热门AI大模型 。从对齐负载特征开始,把四类场景的技术路线差异,转成可执行、可预算的配置决策。
