
本文是《AI工程师踩坑实录》系列第 11 篇。AMP 混合精度一开,loss 不是变 NaN 就是装死不动,教程都说「加 GradScaler」,它到底干了什么、为什么不能省。这一篇在本机用真实数值把 fp16 的世界边界和 GradScaler 的电梯机制拆开给你看。
本篇配套的两个机制演示脚本放在公Z号。
每个 AMP 教程都会写这几行代码。
scaler = torch.amp.GradScaler("cuda")
with torch.autocast("cuda", dtype=torch.float16):
    loss = model(x)
scaler.scale(loss).backward()
scaler.step(opt)
scaler.update()
然后你的训练真的不 NaN 了。但如果你跟我一样,删掉 scaler 再跑一次,发现居然也不 NaN,就会冒出一个问题——这玩意到底防的是什么。
今天这篇文章就是回答这个问题的。先说结论,GradScaler 防的是两种死法,一种你会注意到(NaN),一种你根本注意不到(静默不学习)。第二种更危险。
一、fp16 的世界,比你想的小得多
一切要从 fp16 的表示范围说起。直接看我本机的真实输出。
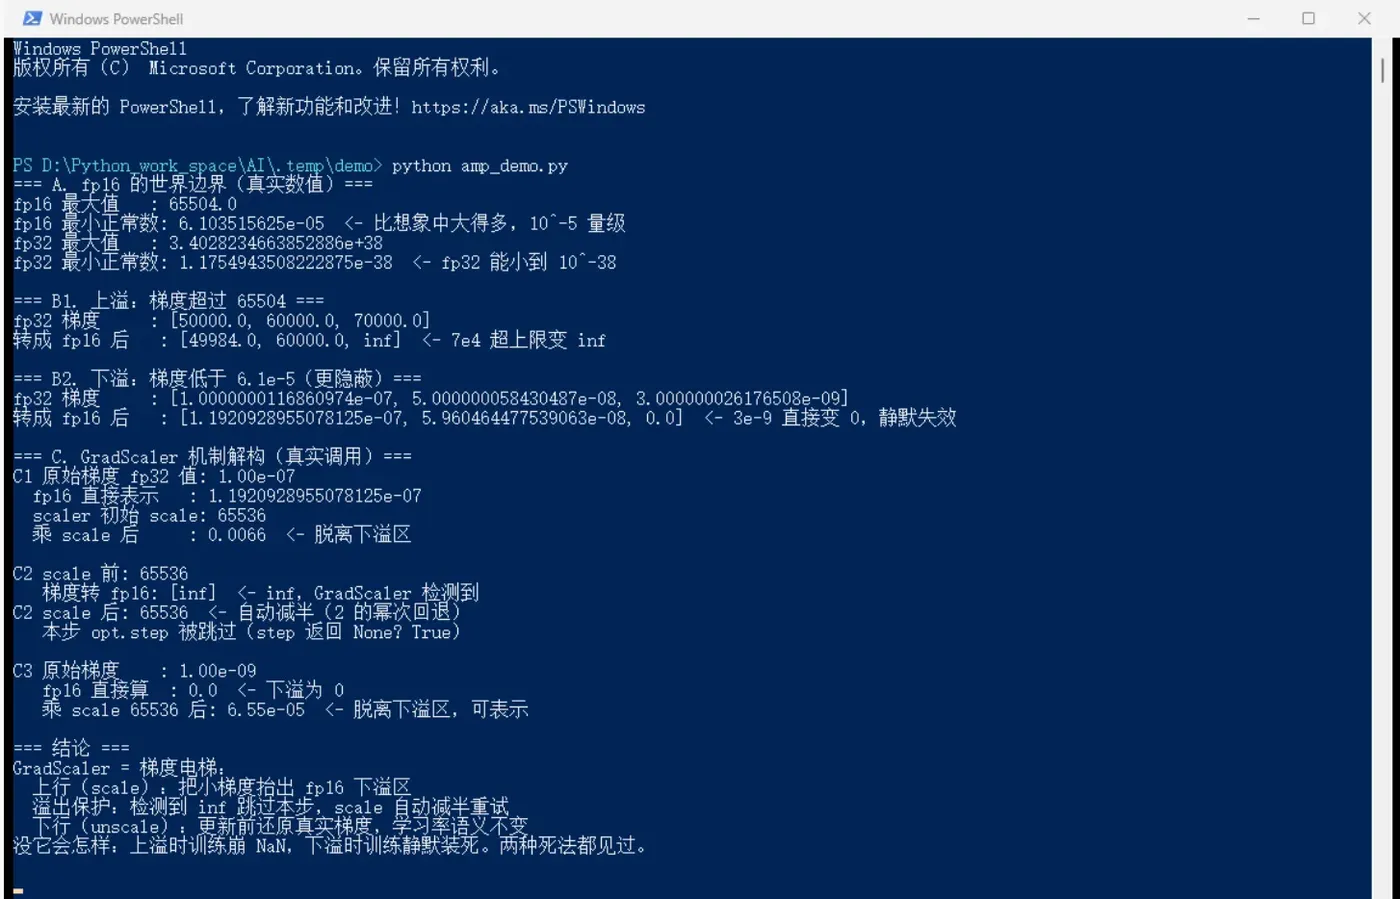
A 部分是关键。fp16 的最大值是 65504,最小正常数是 6.1e-5。而 fp32 的对应值是 3.4e38 和 1.2e-38。
翻译一下。fp32 能表示的数值范围横跨 77 个数量级,fp16 只有 9 个。fp16 的世界比 fp32 小 68 个数量级。
把两条范围画在一张图上,视觉冲击更直接。
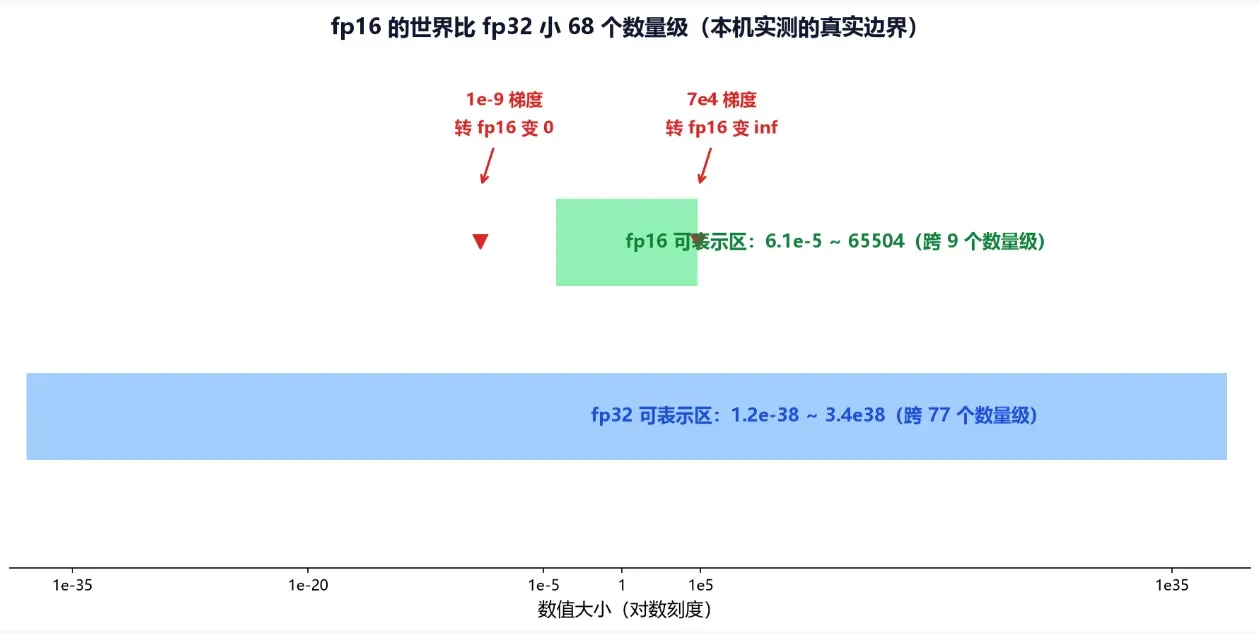
训练中的梯度,动辄从 1e-9 到 1e5 之间波动。在 fp32 里这都是正常居民,在 fp16 里,低于 6.1e-5 的和高于 65504 的,全都活不下去。
二、两种死法,一种比一种安静
死法一,上溢,你会看到的。真实数据,梯度 7e4,超过 65504,转成 fp16 直接变 inf。inf 进入更新,权重变 NaN,loss 跳红。这是显性死亡,第 4 篇讲过的 inf 预警那套方法照用。
死法二,下溢,你根本看不到。梯度 3e-9,低于 6.1e-5(严格说低于约 6e-8 的次正规数区后逐步丢失精度),转成 fp16 变成 0。零梯度乘什么学习率都是零,这一步参数纹丝不动。没有报错,没有警告,loss 曲线看起来只是「降得慢」。你以为模型在收敛,其实它在装死。
第二种死法的可怕之处在于,深网络反传时梯度天然逐层衰减,越靠近输入层的梯度越小,下溢首当其冲的恰恰是最需要学习的前几层。
三、GradScaler,一部三段式电梯
理解了边界问题,GradScaler 的设计就是水到渠成。它是一部「梯度电梯」。
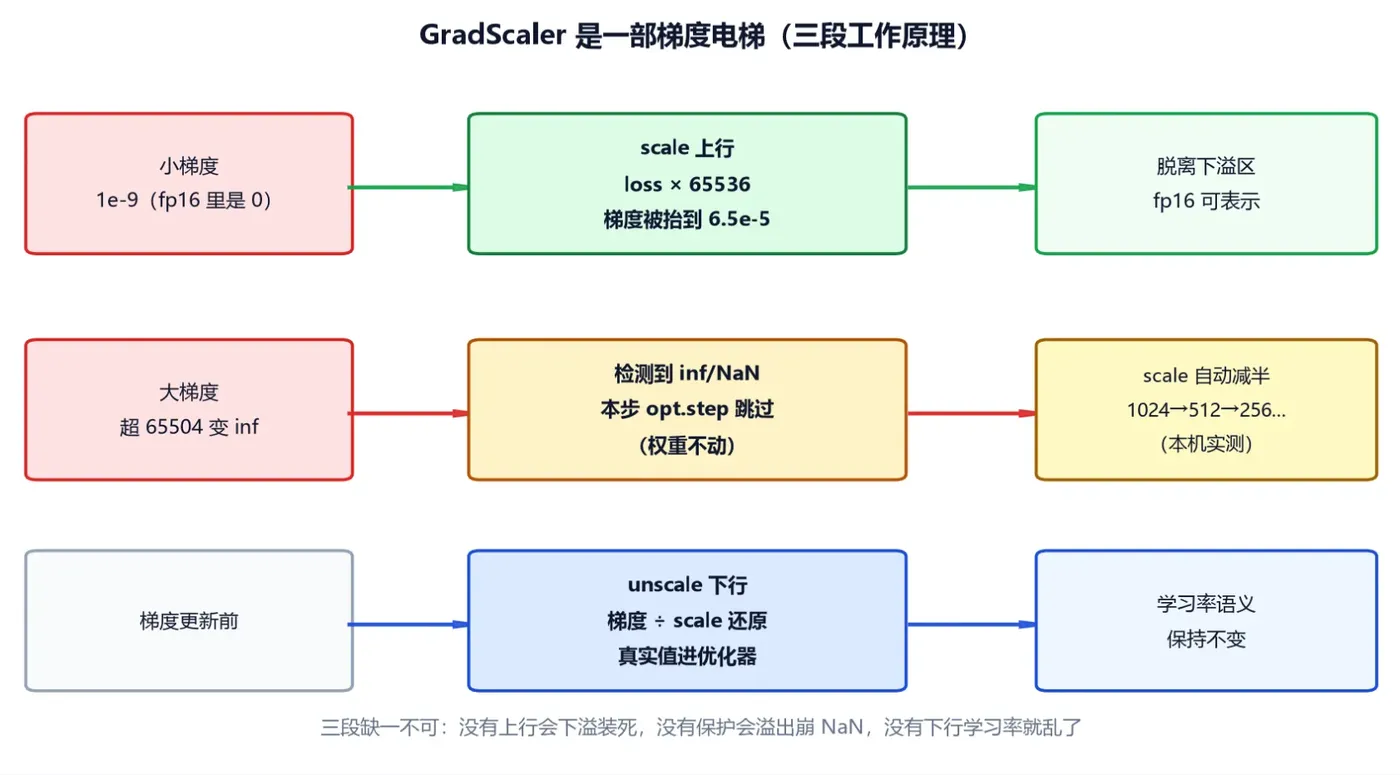
上行,防下溢。梯度太小进不了 fp16 的门?把 loss 乘上 scale(初始 65536)再反传,梯度整体抬高 4 个多数量级,1e-9 的梯度被抬到 6.5e-5,正好进得了门。本机实测,C3 场景的数字就在上面那张截图里。
溢出保护,防上溢。万一抬过头了呢?每一步更新前,GradScaler 检查梯度里有没有 inf 或 NaN。有,就跳过这一步的更新(权重原封不动),并把 scale 减半,下一步用更保守的倍数重试。
下行,保学习率语义。更新前把梯度除回 scale 还原成真实值。没有这一段,你的梯度被放大了 65536 倍,等效学习率暴涨,优化直接失控。
三段缺一不可。这就是为什么教程让你写四行而不是两行。
四、scale 的自适应回退,真实跑给你看
电梯还有个聪明的地方,scale 不是写死的,它会自己找安全区。
我构造了一个持续溢出的场景,观察 scale 的变化。真实输出。
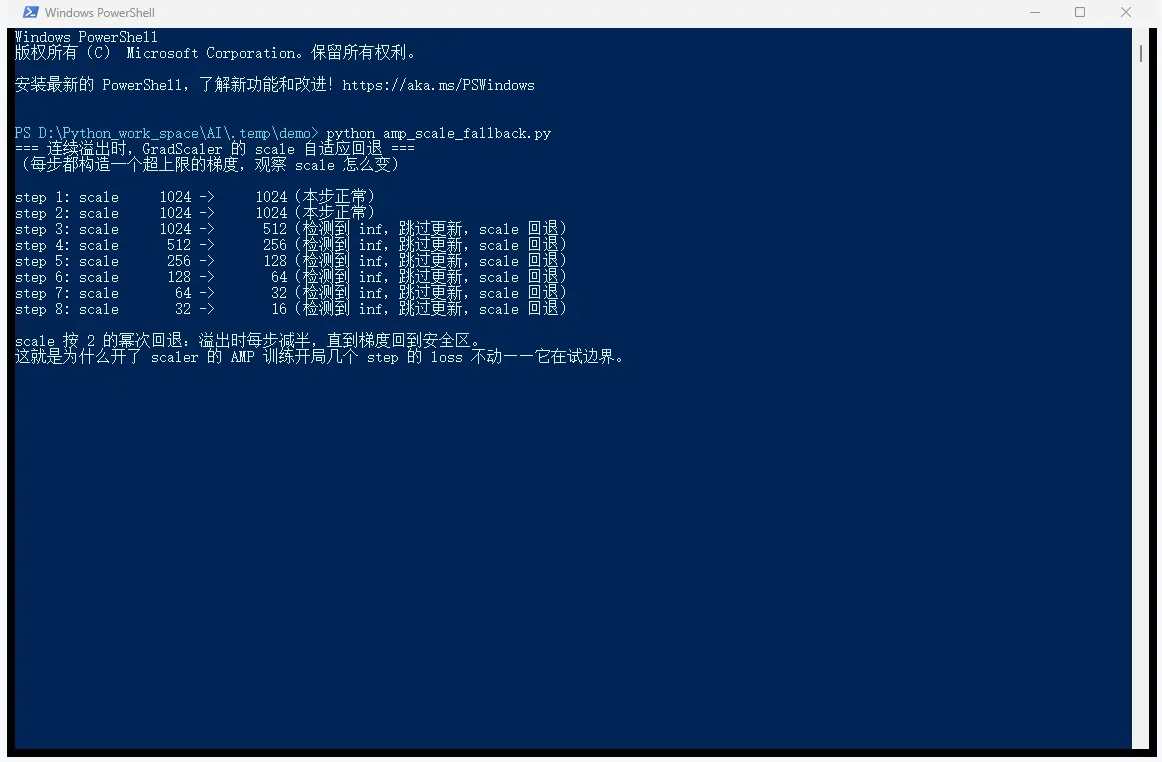
1024 保持两步,第三步检测到 inf,跳过更新并减半到 512。之后每步继续溢出继续减半,256、128、64、32、16……一路退到梯度回到安全区。
这顺便解释了一个新手常见的疑惑——为什么开了 scaler 的 AMP 训练,开头几个 step 的 loss 纹丝不动。不是坏了,电梯在试边界。
五、一个如实报告:为什么删了 scaler 也常常不炸
我准备这篇文章时做过对照实验,把 scaler 删掉跑深残差网络,训练居然正常。当时我愣了一下,后来想明白了两个原因。
第一,PyTorch 的 autocast 很聪明,它维护着一张算子表,哪些算子跑 fp16 安全、哪些必须保 fp32(比如 softmax、loss 计算)是写死的。很多网络结构下,真正危险的算子根本没被转成 fp16。
第二,我的 1660 Ti 是 Turing 架构,没有 fp16 Tensor Core 加速,部分算子直接回退 fp32 执行,等于局部开了假 AMP。这在新款显卡上不会发生,也意味着新卡上删 scaler 会不会炸,不能拿老卡的结论外推。
所以正确的心态是,GradScaler 不是「炸了才加的补丁」,而是 AMP 协议的一部分。就像安全带,大多数行程你没撞车不代表它没用。
六、常见问题 3 连
1. bf16 还需要 GradScaler 吗?
基本不需要,这是 bf16 的核心优势。bf16 的范围跟 fp32 一样大(都是 8 位指数),只是精度低(7 位尾数),它牺牲精度换范围,上溢下溢都天然免疫。Ampere 之后的卡和主流大模型训练都往 bf16 迁。老卡(比如我这张 Turing 的 1660 Ti)不支持 bf16 加速,只能用 fp16,所以 fp16 + GradScaler 这套在老卡上还是必修课。
2. autocast 和 GradScaler 是什么分工?
autocast 管前向,按算子白名单自动决定每层跑什么精度。GradScaler 管反向,负责把反向传播的梯度安全地运过 fp16 的窄门。一个管去程一个管回程,所以两个要配套用。
3. 开了 AMP 反而变慢,怎么回事?
大概率是你的卡没有对应精度的 Tensor Core 加速(fp16 需要 Volta 之后,bf16 需要 Ampere 之后),算子回退 fp32 还多了类型转换开销。1660 Ti 实测过,小模型上 AMP 和 fp32 速度几乎持平。另外小 batch 下 kernel 启动开销占比高,AMP 的收益也被稀释。AMP 的甜区在大模型 + 新卡 + 大 batch。
七、本篇小结
- fp16 的可表示范围比 fp32 小 68 个数量级,上限 65504 下限 6.1e-5,训练梯度天然横跨这个区间外。
- 两种死法,上溢变 inf 会看到(NaN),下溢变 0 看不到(静默装死),后者更危险。
- GradScaler 是梯度电梯,上行放大防下溢、溢出检测跳步降 scale、下行还原保学习率,三段缺一不可。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | AMP 混合精度下 fp16 数值边界导致的 NaN(上溢)与静默失效(下溢) |
| 现象原文 | loss 变 NaN,或 loss 曲线降得异常缓慢(下溢无任何报错) |
| 环境 | Win11,GTX 1660 Ti,torch 2.9.1+cu126 |
| 复现步骤 | fp16 边界数值演示(7e4 转 fp16 变 inf,3e-9 变 0)→ GradScaler 机制解构 → scale 回退过程 8 步实测 |
| 根因 | fp16 范围仅 6.1e-5~65504,比 fp32 小 68 个数量级,训练梯度天然越界 |
| 解法 | autocast 配套 GradScaler;上行放大 + 溢出检测跳步 + 下行还原,三段机制 |
| 避坑建议 | bf16 卡(Ampere+)优先 bf16;老卡 fp16 必须带 scaler;loss 前几步不动是在试边界不是坏了 |
| 可信度 | 本机验证(含如实报告:本机未能在常规网络中复现删 scaler 即崩) |
| 版本时间戳 | 2026-11-06,torch 2.9.1+cu126 |
| 关联坑 | 第 4 篇 loss 变 NaN(同为数值稳定性赛道) |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | 已发 |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | 已发 |
| 3 | 标签和图像没对齐,模型一直在学噪声 | 已发 |
| 4 | loss 变 NaN,用 hook 逐层定位 | 已发 |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | 已发 |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | 已发 |
| 7 | 数据泄漏:预处理做在了划分之前 | 已发 |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | 已发 |
| 9 | 随机种子都设了,结果还是不可复现 | 已发 |
| 10 | 相似度全是 0.9:向量没归一化 | 已发 |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 已发(本篇) |
| 12 | loss 不降反升,先别怀疑模型结构 | 排期中 |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
下一篇预告,《loss 不降反升,先别怀疑模型结构》。loss 一路走高,直觉喊着「模型写错了」,但最常见的根因其实藏在数据和超参里。下一篇用真机对照实验给出排查顺序。
版权说明,本文边界数值与机制演示均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。
