
对正在把智能体接入现有软件、或要跑多步编码与验证循环的开发者和技术负责人来说,2026 年 11 月 10 日 Google 正式向付费开发者推出 Gemini 4 Carbon:它面向长周期智能体工作流,并写明会比面向常规任务的 Gemini 4 Argon 消耗更多 token,用来做更彻底的探索、推理和扩展验证。结论先说清楚:不要只看「单价是否和更快的型号相同」——长程型号会把更多 token 花在思考和续写上,思考还按输出计价;要在会话层设一道累计闸,总量口径必须计入输入、输出、缓存读写,以及并入输出的思考 token;金额上限只对确实以该币种计价的模型有效,不能当成万能刹车。已经发出的模型流和工具调用通常不会被中途截断,所以闸门解决的是「下一跳还开不开」,不是「正在飞的请求立刻归零」。
Google 官方博客《Gemini 4 Carbon is now available》(2026-11-10,本机 2026-11-11 再核 HTTP 200)写明:Carbon 是其在网络安全能力与长周期智能体工作流上表现最强的型号,覆盖复杂知识工作、软件工程和科学推理;继 Gemini 4 Argon 之后,Argon 仍是绝大多数软件工程和知识工作的理想选择,而 Carbon 专为挑战模型智能极限的任务而生——例如复杂的多步骤编码与调试、开放式科学研究——「using more tokens than Argon to explore thoroughly, reason deeply, and run extended verification loops」。同一篇文章给出的首发体验价与 Argon 相同:每百万输入 token 2 美元、每百万输出 token 10 美元;脚注写明优惠期于 2026 年 11 月 30 日结束后,适用每百万输入 4 美元、每百万输出 20 美元(仅面向公众开放的 Carbon 型号)。面向开发者的配套说明见 《Gemini 4 Carbon is now available for developers》(同日,HTTP 200)。中文官方转述见 Google 黑板报《Gemini 4 Carbon 现已正式推出》(标注日期 2026 年 11 月 11 日,本机同日再核 HTTP 200),表述与英文主文一致,并同样写明首发体验价与 11 月 30 日后的调整。
对费用闸更直接的官方口径在 Google AI Studio 定价页(本机 2026-11-11 再核 HTTP 200,由 ai.google.dev 文档定价页跳转至此):Carbon 不在免费档;「模型处理的每一枚 token 都会被计数并计费,包括 thinking tokens,以及在使用 grounding 时的内部工具系统指令和函数声明」;标准档「Output price (including thinking tokens)」在 2026 年 11 月 30 日及以前为每百万 10 美元,2026 年 12 月 1 日起为 20 美元。该页还写明 Carbon 面向复杂软件工程、深度数理与科学问题、高事实准确性、自主多步智能体,以及最长可达 100 万 token 的 long-decode 生成。DeepMind 模型卡(标注 Published 10 November 2026,本机 2026-11-11 再核 HTTP 200)把输入与输出合计的上下文窗口写成最多 1M。LiteLLM 同日技术说明(https://docs.litellm.ai/blog/gemini-4-carbon ,HTTP 200)可作为交叉转述,把统一窗口写成输入、思考与输出合计 1,048,576 token,并指出同步请求单段输出有上限、需要续写才能跑满长解码;本文以 Google 定价页和官方博客为行业事实主出处,不把第三方网关的实现细节写成 Google 原文。
对读者的影响是直接的。单价与 Argon 相同,并不等于一次长程会话的账单相同:官方已经说明 Carbon 会用更多 token 去做更深的探索、推理和扩展验证循环;思考 token 计入输出价;工具声明和 grounding 相关的内部指令也会被计数计费;长解码可以把单次任务的生成拉得很长。若宿主或网关只按「这一轮的输出上限」或「界面上看到的最终回答」估费,就会漏掉思考和续写。若只设一笔美元金额上限,但实际所用模型并不按美元计价,这道金额闸可能根本不设防。开发者和企业在把长程型号接到已有软件里时,真正要先回答的不是「要不要换新模型」,而是:会话累计消耗触顶时,下一跳还开不开、口径里有没有把思考算进去、金额维对当前计价币种有没有效。
把上述材料收成不依赖某一品牌模型或某一家 SDK 也能成立的行业答案:
- 先分清「单价」和「会话花费」。 两个型号可以在同一段体验价里标出相同的每百万输入/输出价格,但面向长程任务的型号会主动消耗更多 token。相同单价不会自动给出相同账单。
- 思考和续写要进总量,不能只数最终回答。 官方定价把 thinking tokens 算进输出价,并写明模型处理过的 token(含工具系统指令和函数声明)都会计费。长解码还可以把生成拉到很长。会话闸的总量口径至少应覆盖输入、输出和缓存读写,并把思考并入输出、避免重复计或漏计。
- 闸门应设在会话累计层,并与「单轮思考预算」分开。 单轮思考预算只管这一跳能想多深;会话累计闸管的是整场会话已经花了多少。两道旋钮不要混成一个开关。
- 金额上限只对确实以该币种计价的模型有效。 币种不对、或缺价模型,金额维可能不折算、不设防。币种无关的兜底应用 token 总量上限。
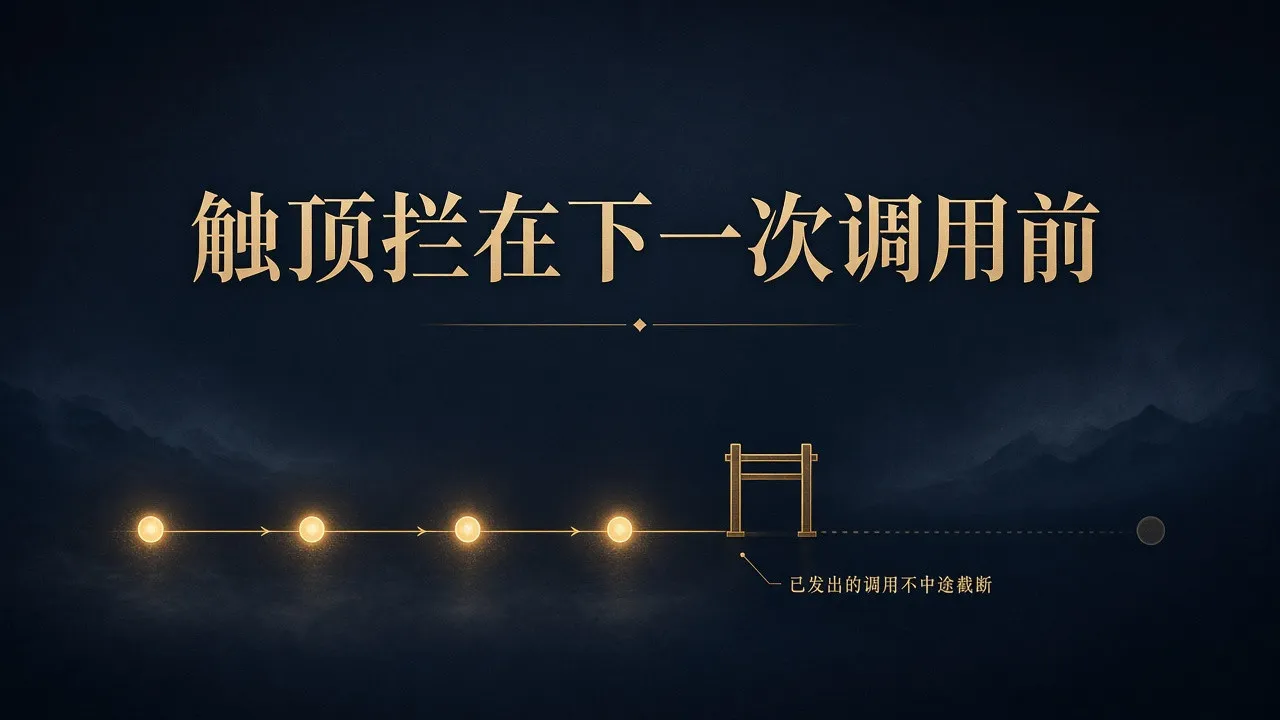
- 触顶动作要先约定:是拦下一跳,还是只警告后继续。 已经发出去的模型流和工具调用,通常不会被中途截断。把「触顶」理解成「账单精确停在上限」是不成立的。
- 观察用量、平台配额和最终账单是三件事。 逐请求的用量事件适合做界面提示;日额度、每用户日额度、RPM 等硬配额在平台侧执行,本地缓存的配额值往往不是剩余额度;最终对账以账单为准。
- 恢复或重开会话时,不要默认历史用量已经被回填进闸门。 若文档或实现写明恢复不回填,就要在宿主里重新设闸,或接受闸门只保护恢复之后的消耗。
- 常规任务与极限任务可以分型号,但不要把「换模型」当成费用闸。 官方把 Argon 作为大多数工程任务的选择、把 Carbon 留给更难的多步任务;换型号改变的是后续怎么跑,不能替代会话累计上限。
这些结论对「现有软件接入智能体」同样成立:宿主如果自己调用模型 API,或把智能体运行链嵌进应用,就可能在长程型号上线的第一周把费用跑飞。下文把行业问题对照到已核实的 Tansr 机制,而不是把某一家模型的定价写成 Tansr 的卖点,也不声称 Tansr 已经把 Gemini 4 Carbon 列入其模型目录。对应公开页为 SessionBudgetOptions、CreateSessionOptions、会话与事件流、平台装配与 bundle 与 设置与 doctor(本机 2026-11-11 再核均为 HTTP 200)。版本核对基线:资料站现行页对应 tansr 命令行 0.10.3、@tansr/sdk 0.19.0、@tansr/serve 0.15.1(均 2026-10-10 发布);0.20.0 候发内容不得写成已上线。它不是 S06 的 401/429/余额/能力位逐级排障,也不是按套餐档位解释平台服务费和并发定义的费用构成稿。本篇只回答:长程、更耗 token 的型号上线后,会话预算闸该怎么设,口径如何计入思考,以及触顶时会发生什么。
直接答案
- 用会话预算闸,而不是只靠单轮输出上限或事后看账单。
createSession({ budget: { maxTotalTokens, maxUsd, onExceeded } })是会话累计消耗触顶时的处置;字段与命令行配置文件的budget段同形,TUI/headless/serve/acp/SDK 五形态走同一闸门语义。两个上限都缺席 = 不接闸。 - 总量口径用
maxTotalTokens:输入 + 输出 + 缓存读 + 缓存写;思考 token 按各模型能力位并入输出、不重复计。 这是币种无关的兜底,也是本轮行业问题里最需要先补上的一环。 maxUsd只对以 USD 计价的模型出数。 令牌档按平台 bundle 计价;托管/注入档当前内置价目为 CNY,maxUsd不设防。不要以为「写了金额上限,所有模型都会在美元额度处停下」。- 缺省
onExceeded: 'block':在下一次模型调用前终止本轮,事件流出turn.aborted { reason: 'budget_exceeded' },会话保持打开,后续轮同样被拦。'warn'则每次查询至多一条turn.error { scope: 'budget', recoverable: true }后照常继续。文档写明:已发出的模型流/工具调用不会被中途截断。 - 这道闸与
thinking.budget(单轮思考 token 预算)无关。 不要用单轮思考预算冒充会话费用闸,也不要在界面上把两个「budget」显示成同一个数字。 - 用量观察走
cost.usage.updated逐请求事件;平台配额是另一层硬执行。 终端自查用GET /v1/my-usage(恒无金额字段);开发者对账用GET /v1/app-usage/by-end-user(含金额,恒不代理给终端)。AppQuota(日 token、每终端用户日 token、RPM 等)不随 bundle 下发,硬执行在平台;本地持有的配额值不是剩余额度,SDK 不据此本地判限。 - 恢复会话不回填历史用量。 闸门从恢复之后继续累计,不能把「会话还在」理解成「旧账单已经重新装进这道闸」。
- 本批未在测试应用上实际触发
budget_exceeded,也未核对某一具体上游型号(含 Carbon)在令牌档 bundle 中的计价币种与思考能力位。 标题收窄为机制与口径说明,不承诺「按示例数字设闸就一定不会超支」。非法取值(非正数/非正整数/词表外)会在任何 IO 前以invalid_options拒绝,这一点以公开文档为准。
行业问题:为什么「单价没涨」不够
| 开发者常问 | 只看单价或单轮上限时的盲区 | 会话闸要补上的一环 |
|---|---|---|
| 新增长程型号和常用型号标价一样,是不是可以随便开? | 忽略「它会用更多 token 去做更深的推理和验证」 | 按会话累计消耗设上限,而不是只比较每百万价格 |
| 思考过程要不要付钱? | 界面上的最终回答看起来不长 | 思考按输出计价,工具声明也可能被计数 |
| 设一个美元额度是不是就安全了? | 假定所有模型都按美元出数 | 币种不符时金额维不设防,要用总量上限兜底 |
| 触顶之后会不会立刻停? | 以为闸门会切断已经发出的请求 | 默认拦的是下一次模型调用;在途调用仍可能产生消耗 |
| 屏幕上的用量是不是剩余额度? | 把本地配额缓存当成余额 | 观察事件、平台硬配额和最终账单要分开看 |
| 会话恢复后闸还在吗? | 以为历史消耗会自动装回去 | 若实现不回填,闸只保护恢复之后的部分 |
官方博客把 Carbon 和 Argon 的分工写得很清楚:大多数工程任务仍可用更快、更省的型号;把更耗 token 的长程型号留给真正需要多步验证的任务。这与「要不要设会话闸」不是同一句话——即使你决定只用更快的型号,长会话加上思考和缓存,同样需要累计上限。换型号不能代替闸门。
你原来要自己做的事 → Tansr 接手什么 → 应用仍要负责什么
原来常要自行完成的:
- 自己在每次模型调用前累加输入、输出、思考和缓存,并决定超限后是拒绝、降级还是只记日志。
- 自己区分美元、人民币或其他币种的价目,避免用错币种的金额上限。
- 自己约定「已发出的请求还要不要跑完」,以及超限后会话是否还能继续提问。
- 自己把用量展示、按终端用户对账和平台配额当成同一套数字来维护。
Tansr 公开机制可接手的部分(以 2026-11-11 抓取的 docs.tansr.com 为准;0.20.0 候发内容不得写成已上线):
- 会话预算闸:
budget.maxTotalTokens/budget.maxUsd/budget.onExceeded,与命令行budget段同形,五种形态同一语义。 - 总量口径明确计入输入、输出、缓存读写,思考并入输出且不重复计;金额维只对 USD 计价模型出数,其余用总量兜底。
- 缺省
block在下一次模型调用前终止本轮并保持会话;warn可恢复地提示后继续;不截断已发出的模型流和工具调用。 - 非法预算取值在任何 IO 前以
invalid_options拒绝。 - 用量事件
cost.usage.updated;终端自查与开发者对账接口分离(金额不暴露给终端)。 - 应用配额
AppQuota在平台硬执行,不随 bundle 下发,SDK 不在本地判限。
应用仍要负责:
- 按任务选择合适的型号和思考档,而不是把所有会话都开到最耗 token 的型号;这是产品策略,不是 SDK 自动完成的事。
- 为不同计价档选择有效的闸:令牌档若按 bundle 以 USD 计价,才可同时使用
maxUsd与maxTotalTokens;托管/注入档当前内置价目为 CNY 时,不要指望maxUsd设防。 - 在界面上分别展示「会话闸状态」和「单轮思考预算」,并按
turn.aborted { reason: 'budget_exceeded' }或turn.error { scope: 'budget' }给用户可理解的提示,而不是只显示通用失败。 - 不要把本地持有的
AppQuota值画成剩余额度;按终端用户收费时,用开发者对账接口,不要把含金额的接口代理给终端。 - 会话恢复、fork 或重开后重新评估闸门:文档写明恢复不回填历史用量。
- 本批未实际触发触顶事件,也未核对 Carbon 是否出现在某一应用的 bundle 模型目录中;不把示例上限写成适用于所有生产账单一刀切的数字。
宿主接线要点(机制说明,非「一键完成」)
- 打开可能跑长程、多步验证的会话前,先接
budget。只设maxTotalTokens也可以;需要金额维时,先确认当前模型确实以 USD 计价,再同时设maxUsd。两个都缺席就是不接闸。 - 默认使用
'block',除非产品明确要在超限后继续跑并只提示一次。拦截发生在下一次模型调用前,要在 UI 上告诉用户:本轮已结束、会话还在、继续提问仍会被拦,而不是「程序崩溃了」。 - 不要用
thinking: { budget }去承担费用闸的职责。它只约束单轮思考生成;会话累计闸是另一道门。 - 在
send()前挂上事件订阅者,处理cost.usage.updated、turn.aborted与可恢复的turn.error { scope: 'budget' }。长跑会话不要等用量已经涨上去再补闸。 - 对账与展示分开:给终端用户看不含金额的自查数据;给运营和财务看开发者对账接口。计量与向终端如何转售,由应用自己决定。
- 若历史会话要 resume:按文档,闸不会回填恢复前的用量。需要「整段生命周期都不超限」时,要在宿主侧另行记账,或对新会话重新设更紧的上限。
- 把平台日额度、每用户日额度和 RPM 当作另一层天花板,不要用会话闸去「模拟」这些配额,也不要在本地用
AppQuota字段做剩余额度计算。
示例(数字只为说明字段形态,不是推荐生产限额):
await createSession({

  token,
  baseUrl,
  budget: {

    maxTotalTokens: 200000,
    onExceeded: "block",
  },
});
若当前模型确按 USD 计价,可以再加 maxUsd。托管或注入档若走 CNY 内置价目,不要只写 maxUsd。
机制速查(以公开页为准)
| 问题 | 公开机制怎么说 | 应用还要自己做的 |
|---|---|---|
| 会话花费触顶怎么办 | budget.onExceeded 缺省 block,事件为 turn.aborted { reason: 'budget_exceeded' };会话仍开,后续轮同拦 |
在 UI 解释「拦的是下一跳」,不要暗示在途请求已被切断 |
| 总量计什么 | 输入 + 输出 + 缓存读 + 缓存写;思考并入输出、不重复计 | 不要只按最终可见回答估费 |
| 金额上限何时有效 | 只对 USD 计价模型出数;令牌档按 bundle 计价;托管/注入档当前内置价目为 CNY 时不设防 | 先核对计价币种,再用 maxTotalTokens 兜底 |
| 和思考预算的关系 | 与 thinking.budget 无关 |
界面上不要合并成一个「预算」数字 |
| 用量怎么看 | cost.usage.updated 逐请求进入事件流 |
观察值不是最终账单 |
| 按用户限额怎么做 | 平台 AppQuota 硬执行;开发者对账接口含金额,终端自查不含金额 |
不要把含金额接口代理给终端,也不要在本地判剩余额度 |
| 恢复后还准不准 | 恢复会话不回填历史用量 | 需要全程封顶时,宿主另行记账或重开更紧的闸 |
| 命令行能否共用 | 配置文件 budget 段与 SDK 同形、同一语义 |
五种形态不要各写一套互斥规则 |
什么时候采用,什么时候不采用
值得按此推进:现有软件或会话宿主会接通可能消耗思考 token、会做多步验证或长解码的型号;同一会话可能跨多轮累加;你需要在账单出来之前就挡住下一跳;团队里同时存在 USD 计价和以其他币种计价的模型档。
先不要:把「单价与常用型号相同」写成「会话费用差不多」;把 maxUsd 写成对所有档位都有效的万能上限;把 block 写成会切断已发出的请求、或保证账单精确等于上限;把本地 AppQuota 值当成剩余额度;把未实测的触顶事件或未核对的 bundle 价目写成已经验证的生产手册;或把本页机制宣传成「用了就不会超支」。纯单轮、用量极小且确定不含思考计费的调用,可以不接会话闸——一旦会话会跨多轮或开启长程型号,就应按累计口径来做。
与已有稿的差异
- 相对 S06:S06 讲调用报 401/429/余额不足/能力关闭时怎样逐级排障。本文不重复那些平台错误码,只讨论会话尚未被平台拒绝之前,宿主自己如何设累计闸。余额耗尽是平台层拒绝,会话预算闸是应用主动设的上限,两者不要混成同一个「没钱了」。
- 相对 S11:S11 讲非致命降级通道
onPlatformWarning。预算触顶在block时是明确中止本轮,不是静默少一个工具。 - 相对 S10:S10 讲统一 API 的 202/SSE 与终态。本文不讨论请求是否完成,只讨论花费口径和触顶处置。
- 相对费用构成选题:本文不写 Tansr 套餐价、并发定义或测试期人数;不把官方模型体验价写成 Tansr 的售价。
- 相对模型切换选题:官方虽然区分了常规型号与长程型号,本文只把「换型号不能替代费用闸」作为边界,不展开
setModel/switchModel的上下文备份与窗口校验。
限制(紧邻结论)
- 产品事实以 2026-11-11 抓取的 docs.tansr.com 公开页为准;未在测试应用上实际触发
budget_exceeded,未核对 Gemini 4 Carbon 是否已出现在某一应用的 bundle 模型目录,也未实测托管/注入档在当前内置 CNY 价目下maxUsd的不设防行为(正文按文档收窄,不写成已复现)。 - Google 官方博客、黑板报、定价页和模型卡用作长程型号更耗 token、思考计入输出价、体验价与 11 月 30 日后调价的行业事实来源,不表示与 Tansr 存在实现兼容、模型上架或商业关系。
- 示例中的
maxTotalTokens: 200000只为展示字段形态,不是对任何生产应用的推荐限额。 - 不写 Tansr 的具体价格或「免费试用」;不把 0.20.0 候发内容写成已上线;无 AI/身份/适用版本页脚。
- AI 效果基线本批缺测,按指导单独记录,不阻塞内容交付。
不依赖产品也能用的最小基线
- 给可能跨多轮、会开启思考或长解码的会话设一道累计上限,不要只比较每百万单价,也不要只限制单次可见输出长度。
- 总量口径计入输入、输出、缓存,并把思考并入输出;工具系统指令和函数声明若会被计费,也要进入观察,而不是只数最终回答。
- 金额上限必须与模型的实际计价币种一致;币种不明或不一致时,用 token 总量作为兜底,不要只写一笔美元。
- 事先约定触顶是「拦住下一跳」还是「警告后继续」;不要假设已经发出的请求会被切断,也不要把账单理解成精确等于上限。
- 把界面用量、平台配额和最终账单分开看;不要把本地缓存的配额值当成剩余额度,也不要把含金额的对账数据直接交给终端用户。
- 会话恢复或重开后,确认历史消耗有没有被重新装进闸门;没有回填时,为需要全程封顶的任务重设上限或改开新会话。
- 常规任务与极限任务分型号使用:把更耗 token 的长程型号留给真正需要多步验证的工作,并仍然保留会话累计闸。
