一、前言
模型刚部署的时候,回答精准、逻辑清晰、响应速度也很快,可随着会话次数变多、使用时间变长,模型就越来越笨。要么回答前后矛盾、逻辑混乱,要么响应延迟越来越高,偶尔还会出现无意义乱码、重复话术,甚至凭空生成错误信息。通常我们会觉得参数设置不合理,或是提示词写得不够优质,但其实绝大多数场景下,问题根源根本不在模型本身,而是推理阶段的脏数据污染。和训练阶段的数据集污染不同,大模型推理污染是发生在实时交互过程中的动态问题,用户每一次对话、每一轮上下文留存,都会产生大量无效、冗余、错误的数据,持续干扰模型的推理判断。
简单来说,大模型推理就像人的思考过程,干净的信息输入才能产出精准的结果,而上下文冗余、历史脏会话、无效Token这三类脏数据,就像杂乱的杂念,会不断扰乱模型的注意力、占用推理资源、扭曲输出逻辑。传统的清洗方案大多是人工筛查、简单截断,不仅效率极低,还无法适配实时推理场景,很容易丢失有效信息。今天我们仔细分析搞懂如何从源头治理推理污染,低成本提升大模型推理精度、速度与稳定性。
二、推理脏数据核心类型
1. 上下文冗余
上下文冗余是大模型推理场景中最普遍、最易被忽视的脏数据类型,几乎所有长会话大模型应用都会存在这类问题,目前对话机器人、智能客服、企业知识库问答等主流大模型应用,均默认开启上下文记忆功能,用于实现连续对话交互。而上下文冗余指的是会话留存中,与当前提问无关、重复表述、过期失效的历史对话内容。比如用户连续多轮修改同一问题、反复追问同类内容、多次切换对话话题后残留的老旧话题内容,都属于典型的冗余上下文。这类脏数据是无差别留存上下文导致的必然结果,具备极强的隐蔽性。
很容易误以为上下文越多,模型理解越全面,这是核心错误认知。实际上,过量的冗余上下文不仅无法提升回答质量,反而会持续干扰模型推理,不会带来任何正向增益,是典型的无效数据累加问题,长此以往带来的核心业务危害:
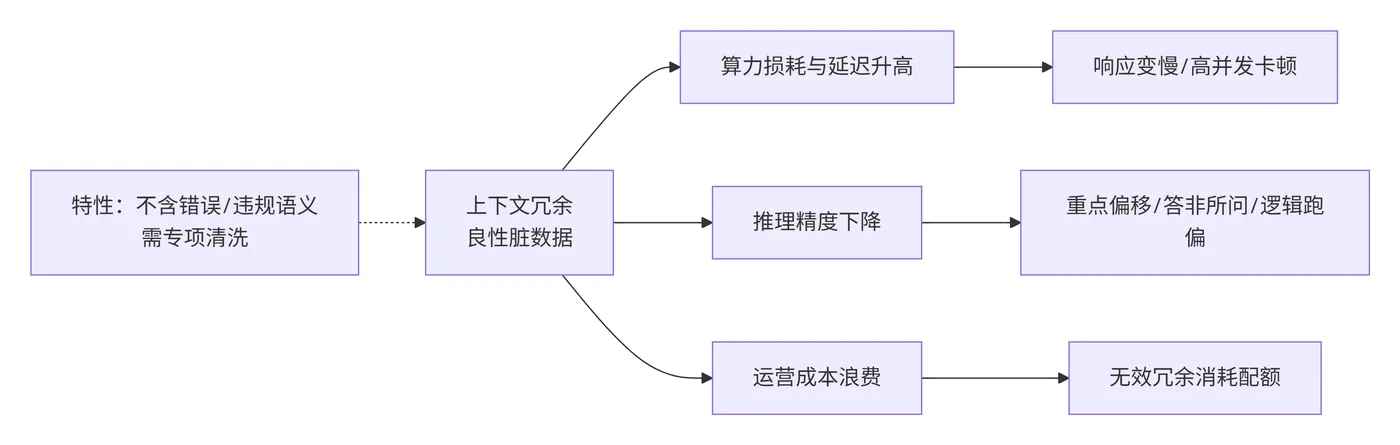
- 1. 算力损耗与延迟升高,大模型每一轮推理需对全部上下文做注意力计算,冗余内容会大幅增加计算负担,导致响应变慢、高并发场景服务卡顿;
- 2. 推理精度下降,冗余信息分散模型注意力,造成重点偏移、答非所问、逻辑跑偏等问题;
- 3. 运营成本浪费,大模型接口按输入Token计费,无效冗余上下文会持续消耗配额,增加企业调用成本。
上下文冗余属于良性脏数据,本身不包含错误、违规语义,仅存在无效累加、资源占用问题,无法通过常规风控、错误检测机制识别,必须依靠语义筛选、话题聚类等专项机制清洗。
2. 历史脏会话
历史脏会话是指大模型会话记录中,所有能够干扰模型正常推理、破坏输出准确性的劣质对话内容,具备极强的污染性和滞留性,是大模型越用越差的核心元凶。脏数据的危害最大、最易导致模型输出失真的恶性脏数据,区别于无危害的冗余数据,其本身包含错误、冲突、无效语义,会直接扭曲推理逻辑.
脏会话的核心类型:
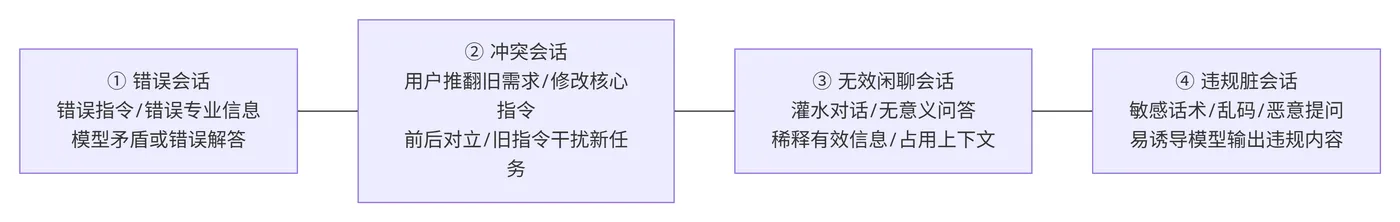
- 1. 错误会话,包含用户输入的错误指令、错误专业信息,以及模型历史输出的矛盾、错误解答;
- 2. 冲突会话,同一会话内用户多次推翻旧需求、修改核心指令,前后语义对立,残留旧指令干扰新任务执行;
- 3. 无效闲聊会话,无业务价值的灌水对话、无意义问答,稀释有效信息权重、占用上下文空间;
- 4. 违规脏会话,包含敏感话术、乱码输入、恶意提问,易诱导模型产出违规、异常内容。
大模型上下文推理具备天然记忆延续性,不会自动甄别历史内容的真伪与有效性,会默认所有留存会话均为有效参考依据。脏会话会持续参与每一轮推理的逻辑构建,让模型复刻错误、冲突的推理逻辑,形成固化的错误思维惯性。
在企业知识库问答、智能办公助手、政企客服等高精准需求场景中,历史脏会话的危害被无限放大。单次错误业务会话留存后,会持续污染后续所有同类推理结果,即便优化提示词、调整参数,也无法根治输出失真、逻辑混乱的问题,最终导致模型业务落地失效。
3. 无效Token
大模型无法直接识别自然文字、符号,所有输入输出、上下文内容,都会被分词器拆解为最小语义单元Token。模型的编码计算、注意力匹配、存储计费,全部以Token为最小单位执行,Token质量直接决定推理效率与精度。
无效Token是指不承载有效语义、无法为推理提供业务价值,仅占用算力、窗口空间、计费配额的Token单元,广泛分布在每一轮模型交互中,体量细碎、数量庞大、隐蔽性极强。无效Token是最底层、最细碎的基础脏数据单元,是引发上下文冗余、会话污染的底层诱因,极易忽略。
无效Token的核心类型:

- 1. 空白类Token,无意义标点、重复空格、多余换行符等;
- 2. 残缺类Token,用户输入的错别字、乱码、残缺字符拆分生成的无效单元;
- 3. 冗余输出Token,模型重复话术、无意义铺垫、凑数内容对应的Token;
- 4. 过期指令Token,作废参数、过期需求残留的无效分词;
- 5. 异常拆分Token,分词器算法异常拆分产生的碎片化无意义Token。
无效Token对业务的影响:
- 1. 挤占上下文窗口,大模型4K/8K/32K窗口容量固定,无效Token占用大量空间,会压缩有效信息承载量,导致关键业务内容被强制截断;
- 2. 拉高推理成本,无效Token参与全程算力计算,造成算力空耗、响应延迟升高,同时增加接口计费支出;
- 3. 碎片化推理逻辑,大量细碎无效Token干扰注意力权重分配,让模型输出内容杂乱、无重点、逻辑断裂。
三、脏数据污染产生过程
1. 窗口资源挤占机制
上下文窗口是大模型推理的核心硬件与结构限制,也是脏数据产生危害的核心载体,无论是开源的Llama、Qwen模型,还是各种开放的API调用模型,均存在固定的上下文Token窗口上限。该上限由模型结构、训练参数、硬件部署条件决定,无法无限制扩容,是大模型推理的硬性边界。
上下文窗口总容量固定,遵循此消彼长原则:
- 冗余上下文、脏会话内容、无效Token等脏数据累积越多,有效业务语义信息的容纳空间就越少;
- 短会话场景脏数据体量小,危害不明显;
- 长会话、连续交互场景下,脏数据会持续累积,快速挤占有效资源。
脏数据占比大小也影响着模型的性能表现:
- 脏数据占比达30%时,模型出现轻微失忆,偶尔忽略前文关键指令;
- 脏数据占比超50%时,窗口有效空间严重不足,模型强制截断知识库内容、关键指令等核心信息,频繁出现答非所问、内容残缺、逻辑断裂等问题。
模型注意力计算的时间复杂度与窗口Token数量正相关,脏Token越多,矩阵计算量越大。大量无效计算会直接拉高推理延迟,高并发场景下极易出现接口超时、服务卡顿、甚至熔断问题,严重影响用户交互体验。
2. 注意力偏移干扰机制
自注意力机制是大模型理解语义、关联上下文、精准输出的核心核心,脏数据通过干扰注意力权重分配,引发注意力偏移,最终破坏推理效果。
注意力机制核心逻辑:
- 模型对每一个输入Token分配独立注意力权重,权重高低代表模型的关注优先级。
- 正常场景下,核心指令、业务关键词、有效问答内容会被分配高权重,无效内容权重极低,模型可精准聚焦用户核心需求。
上下文冗余、历史脏会话、无效Token的大量存在,会产生海量无效语义单元,持续分摊、稀释核心有效Token的权重,导致模型注意力无法聚焦核心需求,出现重点偏移、判断失准的问题:
- 上下文冗余会让模型注意力反复聚焦过期、重复内容,忽略用户最新提问,导致回答老旧、适配性差;
- 历史脏会话的冲突、错误内容会造成注意力逻辑混乱,模型无法甄别有效指令,输出矛盾内容;
- 零散无效Token会碎片化注意力,让输出内容杂乱、无重点、充斥无效话术。
通俗的理解该原理等同于人类思考时被持续杂音、错误提示干扰,思考速度变慢、判断失误。长期注意力干扰会大幅提升模型输出随机性,导致模型推理稳定性持续下降,出现“时准时不准”的疑难问题。
3. 推理逻辑异化机制
推理逻辑异化是脏数据最深度、最致命的隐性污染效果,区别于表层的性能、精度问题,该问题会永久扭曲模型实时推理逻辑。窗口挤占、注意力偏移属于表层性能问题,可通过简单优化快速修复;而逻辑异化属于深层逻辑缺陷,会改变模型的推理规则,形成固化错误惯性,修复难度极大、滞留性极强。
逻辑异化核心原理:

- 大模型实时推理并非简单文字拼接,而是基于上下文的逻辑推演、语义关联、规则匹配。
- 模型会默认所有上下文内容真实、有效、可信,并依托全部内容构建完整推理逻辑链。
- 脏数据中的错误、冲突、无效内容,会持续植入错误语义关联,逐步异化推理逻辑。
各类脏数据的异化表现:
- 历史脏会话的错误业务内容,会让模型复刻错误解答逻辑,形成越用越错的恶性循环;
- 上下文冗余的重复内容,会让模型过度拟合无效逻辑,输出内容冗长、堆砌、无重点;
- 零散无效Token会造成逻辑推演断层,让输出内容前后脱节、逻辑碎片化。
很多企业落地后期,即便完成模型微调、提示词优化、知识库升级,模型性能依然无法恢复,核心原因就是推理逻辑已被长期脏数据污染,形成固化错误逻辑。问题根源不在模型参数,而在实时推理数据的持续污染。
四、全自动清洗机制架构
1. 分层清洗整体架构
针对这几类脏数据的污染特性,结合实际构建推理脏数据清洗机制,采用“三层递进、逐类清零”架构,无需修改大模型底层参数、无需重新微调模型、无额外算力消耗,可直接对接现有对话系统、模型接口、知识库应用,轻量化部署。
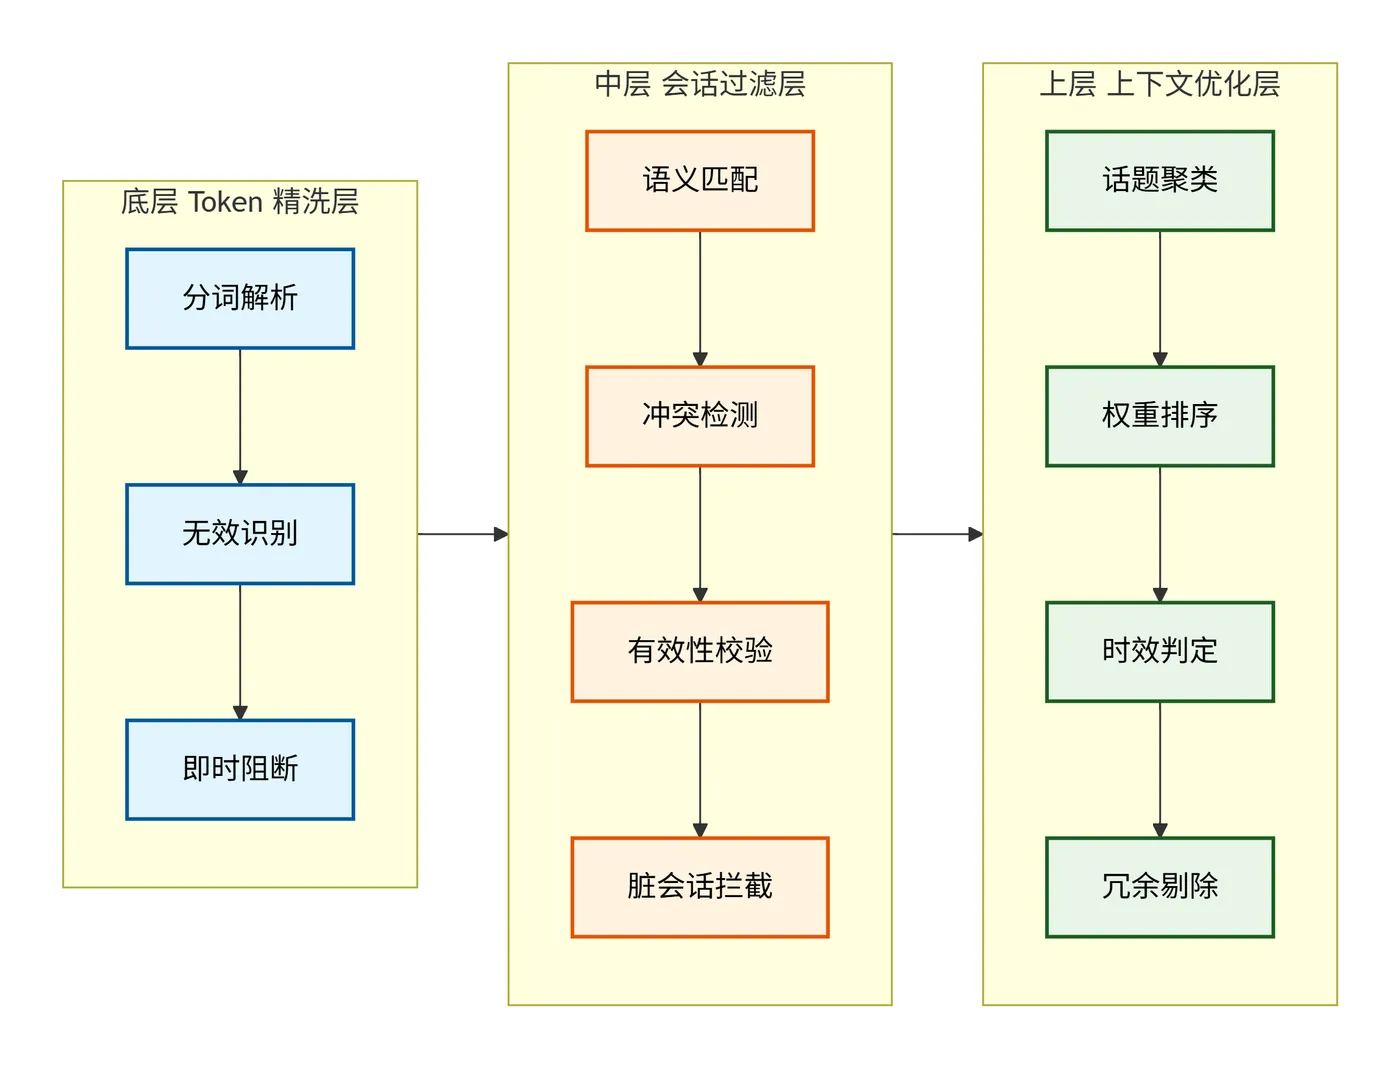
- 底层Token精洗层(基础层):核心职责是治理碎片化、低维度的无效Token脏数据。依托分词规则+轻量语义校验双机制,实时解析每一轮输入输出的全部Token,精准识别空白、乱码、重复碎片、无效标点等各类无效单元,从最小数据单元阻断脏数据生成,筑牢清洗基础。
- 中层会话过滤层(核心层):专门针对恶性历史脏会话污染设计。通过语义相似度匹配、指令冲突检测、内容有效性校验三大核心算法,智能区分有效业务会话与错误、冲突、闲聊、违规脏会话,拦截所有恶性污染数据,杜绝推理逻辑异化。
- 上层上下文优化层(全局层):聚焦解决上下文冗余问题。基于话题聚类、语义权重排序、时效优先级判定机制,对全局上下文进行筛选、精简、重组,剔除过期、重复、无关内容,最大化释放窗口资源,优化模型注意力分配。
三层架构逐级递进、层层兜底,底层清理细碎脏数据,中层拦截恶性污染源,上层优化全局推理上下文,全程实时自动化执行,彻底解决传统人工清洗滞后、低效、易丢数据、误判率高的痛点。
2. 无效Token全自动清洗
针对无效Token隐蔽性强、数量庞大、碎片化分布的特点,机制采用“实时检测-智能过滤-自动修复”的毫秒级全自动清洗流程,具体流程说明:
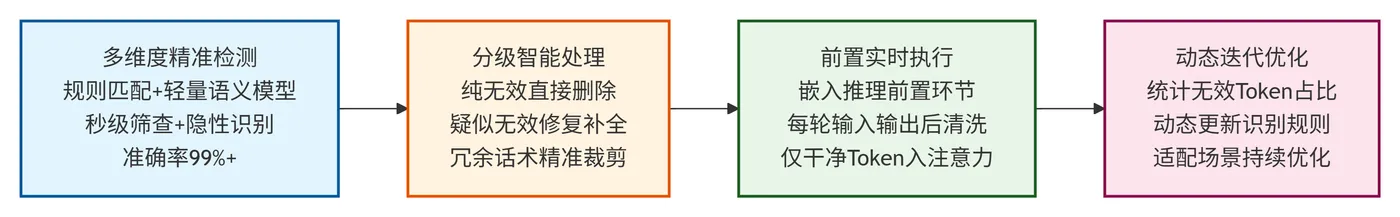
- 多维度精准检测:采用规则匹配+轻量语义模型双校验方案。规则层面,预设空白字符、重复符号、乱码、残缺字符等固定无效Token规则,实现秒级筛查;语义层面,通过分词校验模型,识别碎片化、语义残缺、重复冗余的隐性无效Token,整体识别准确率可达99%以上。
- 分级智能处理:杜绝一刀切清洗,避免有效信息丢失。纯无效的空白、乱码、碎片Token直接批量删除;语义残缺、疑似无效的Token进行智能修复补全,校正错别字与残缺字符;模型输出的冗余铺垫、重复话术Token进行精准裁剪,保留核心语义内容。
- 前置实时执行:将清洗流程嵌入模型推理前置环节,每一轮用户输入、模型输出完成后,自动执行Token清洗,仅将干净合规的Token数据送入注意力计算与上下文留存环节,从源头阻断无效Token累积。
- 动态迭代优化:系统实时统计每轮对话的无效Token占比,动态更新识别规则,适配不同业务场景的分词特性,避免场景适配误差,持续优化清洗精度。
实践可清理85%以上的底层无效脏Token,压缩输入输出Token总量20%-40%,大幅降低算力消耗与接口计费成本,彻底解决细碎Token挤占上下文窗口的问题。
3. 历史脏会话智能净化
针对历史脏会话的恶性污染问题,机制采用“语义编码-脏度评分-冲突甄别-自动剔除”全自动化流程,精准净化脏会话、保留有效会话,具体逻辑拆解说明:
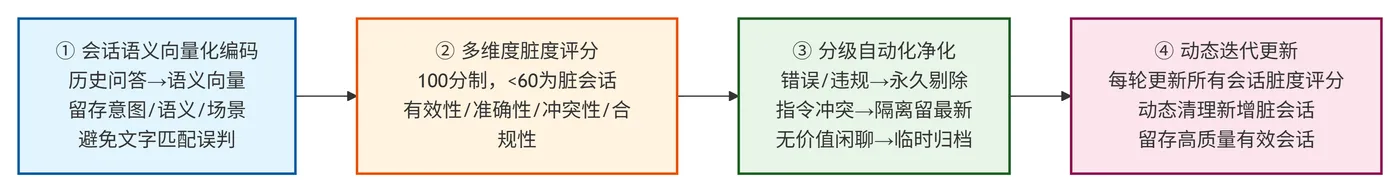
- 第一步:会话语义向量化编码:将每一条历史问答会话进行语义向量化转换,把自然语言转化为可计算向量,精准留存每条会话的核心意图、语义特征、业务场景信息,避免传统文字匹配导致的误判、漏判问题。
- 第二步:多维度脏度评分:设置100分满分评分体系,低于60分判定为脏会话,从四大核心维度打分:有效性(是否具备业务价值)、准确性(内容是否无误、逻辑通顺)、冲突性(是否匹配最新指令需求)、合规性(是否存在敏感违规内容)。
- 第三步:分级自动化净化:低分错误会话、违规会话直接永久剔除,彻底杜绝污染;新旧指令冲突会话自动标记隔离,仅留存最新有效指令,清除过期对立内容;无业务价值的闲聊会话临时归档,不参与实时推理,可按需恢复。
- 第四步:动态迭代更新:每完成一轮对话,系统自动更新所有历史会话的脏度评分,动态清理新增脏会话、留存高质量有效会话,持续优化推理参考数据源,从根源解决会话累积污染与逻辑异化问题。
4. 上下文冗余智能精简
针对上下文冗余累积、重点模糊、窗口挤占的痛点,机制采用“话题聚类-权重排序-时效筛选-智能精简”方案,在不丢失有效信息的前提下,实现上下文轻量化优化,具体流程说明:
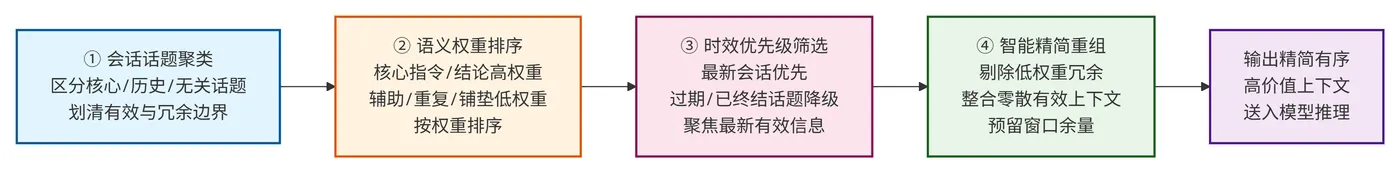
- 第一步:会话话题聚类:对全部历史上下文进行语义聚类整合,精准区分当前核心话题、已终结历史话题、零散无关话题,清晰划分有效上下文与冗余上下文边界,避免盲目截断关键业务内容。
- 第二步:语义权重排序:依托注意力权重算法,对同话题上下文进行优先级打分,核心指令、结论性问答、业务关键内容赋予高权重,辅助解释、重复表述、铺垫内容赋予低权重,按权重从高到低排序。
- 第三步:时效优先级筛选:叠加时间维度权重,最新会话、当期需求内容优先级更高,过期老旧、已终结话题内容优先级降级,适配用户动态需求变更,确保模型聚焦最新有效信息。
- 第四步:智能精简重组:剔除低权重的重复、过期、无关冗余内容,整合零散有效上下文,生成精简、有序、高价值的全新上下文送入模型推理,同时预留合理窗口余量,杜绝信息缺失、内容断层问题。
可保留95%以上的核心有效信息,同时精简30%-50%的冗余上下文,彻底解决窗口挤占、注意力偏移问题,显著提升模型推理精准度与响应速度。
五、应用实践示例
基于三层流水线清洗喂给大模型的多轮对话上下文:底层去无效字符与重复短句;中层按有效性、相关性、合规、兜底四维度逐轮打分过滤;上层KMeans聚类只留当前话题、再按时间排序与token截断,保证送进prompt的历史干净相关不超预算。
""" 全自动清洗大模型推理污染 —— 三层流水线 底层 TokenCleaner :无效字符 / 冗余短句清洗,保证进入历史的每段文本本身干净 中层 SessionPurifier :四维度脏度打分,把灌水、跑题、违规、模型兜底句挡在上下文外 上层 ContextReducer :话题聚类保留当前话题 + 按时间排序 + token 截断,喂给模型前最后瘦身 入口:LLMDirtyDataCleanPipeline.run(raw_chat_history, latest_user_msg) """ import re import tiktoken from modelscope import snapshot_download from sentence_transformers import SentenceTransformer from sklearn.metrics.pairwise import cosine_similarity from sklearn.cluster import KMeans from dataclasses import dataclass from typing import List, Dict # ===================== 配置项 ===================== MAX_CONTEXT_TOKEN = 2048 # 上下文窗口上限 DIRTY_SCORE_THRESHOLD = 60 # 脏会话阈值,低于60判定脏会话(逐轮打分,有一轮脏就丢一轮) TOPIC_SIM_THRESHOLD = 0.2 # 与最新提问的语义相关度低于此值 → 视为跑题扣分 ENCODER = tiktoken.get_encoding("cl100k_base") cache_dir = "D:\\modelscope\\hub" embedding_model_dir = snapshot_download( model_id="sentence-transformers/all-MiniLM-L6-v2", cache_dir=cache_dir, revision="master" ) EMBED_MODEL = SentenceTransformer(embedding_model_dir) # 会话数据结构 class ChatTurn: role: str # user / assistant content: str timestamp: float dirty_score: float = 100.0 embedding: List[float] = None # ===================== 底层:无效Token清洗层 ===================== class TokenCleaner: # 清理空白、重复换行、乱码、无效符号 PATTERN_INVALID_CHAR = re.compile(r"(\s{2,})|([^\u4e00-\u9fa5a-zA-Z0-9\.,;:!?,。;:?!\n])") PATTERN_MULTI_NEWLINE = re.compile(r"\n{2,}") def clean_text(raw_text: str) -> str: # 1. 清理特殊无效字符 text = TokenCleaner.PATTERN_INVALID_CHAR.sub("", raw_text) # 2. 合并多个换行 text = TokenCleaner.PATTERN_MULTI_NEWLINE.sub("\n", text) return text.strip() def count_token(text: str) -> int: tokens = ENCODER.encode(text) return len(tokens) def remove_redundant_tokens(raw_text: str) -> str: """删除重复冗余短句(简单去重,可替换LLM摘要)""" lines = [line.strip() for line in raw_text.split("\n") if len(line.strip())>3] unique_lines = [] seen = set() for line in lines: if line not in seen: seen.add(line) unique_lines.append(line) return "\n".join(unique_lines) # ===================== 中层:历史脏会话净化层 ===================== class SessionPurifier: # 模型兜底/拒答类句子:内容上没错误,但对后续推理毫无价值,属于"隐性污染" FALLBACK_MARKS = ["我不知道", "无法回答", "作为AI", "抱歉,我", "对不起,我不能"] # 违规词表(业务可按需扩充,这里只做演示) BAD_WORDS = ["乱码测试", "破解", "非法"] def calc_dirty_score(turn: ChatTurn, latest_query: str) -> float: """四维度脏度打分:有效性 / 相关性 / 合规性 / 信息量,满分100,低分即脏""" score = 100.0 content = turn.content # ① 有效性扣分:内容太短无业务价值("好的""嗯"这类) if len(content) < 10: score -= 30 # ② 相关性扣分:与最新用户提问语义对立/无关(历史话题已切换,旧话题硬留着只会带偏模型) emb_latest = EMBED_MODEL.encode(latest_query) emb_turn = EMBED_MODEL.encode(content) sim = cosine_similarity([emb_latest], [emb_turn])[0][0] if sim < TOPIC_SIM_THRESHOLD: score -= 25 # ③ 合规性扣分:违规关键词,一票重扣 for w in SessionPurifier.BAD_WORDS: if w in content: score -= 40 # ④ 信息量扣分:模型兜底句 / 高度重复(连续多轮"我不知道"会污染后续回复风格) if any(m in content for m in SessionPurifier.FALLBACK_MARKS): score -= 35 return max(0, score) def filter_dirty_chat(chat_list: List[ChatTurn], latest_query: str) -> List[ChatTurn]: """逐轮打分过滤:>= 阈值保留。只丢"脏轮",脏轮前后的好轮不受牵连""" valid_turns = [] for turn in chat_list: turn.dirty_score = SessionPurifier.calc_dirty_score(turn, latest_query) if turn.dirty_score >= DIRTY_SCORE_THRESHOLD: valid_turns.append(turn) return valid_turns # ===================== 上层:上下文冗余智能精简层 ===================== class ContextReducer: def topic_cluster(chat_list: List[ChatTurn]): """话题聚类:KMeans 把历史按语义分组,只保留与"最后一轮"同簇的当前话题。 中间话题被切换掉后,留在上下文里只会稀释模型对当前任务的注意力。""" if len(chat_list) <= 1: return chat_list embeds = [EMBED_MODEL.encode(t.content) for t in chat_list] kmeans = KMeans(n_clusters=min(3, len(chat_list)), random_state=42) labels = kmeans.fit_predict(embeds) latest_label = labels[-1] current_topic_turns = [chat_list[i] for i, lab in enumerate(labels) if lab == latest_label] return current_topic_turns def weight_sort(turns: List[ChatTurn]) -> List[ChatTurn]: """按时间权重排序(旧→新):多轮对话讲究时序,乱序喂模型会答非所问""" return sorted(turns, key=lambda x: x.timestamp, reverse=False) def shrink_context(turns: List[ChatTurn], max_token: int): """token 截断:按顺序累加,超预算立即停(后面更晚的轮次宁可整段不要,也不截半句产生残缺上下文)""" final_ctx = [] total_tok = 0 for t in turns: cnt = TokenCleaner.count_token(t.content) if total_tok + cnt <= max_token: final_ctx.append(t) total_tok += cnt else: break return final_ctx # ===================== 全链路清洗入口 ===================== class LLMDirtyDataCleanPipeline: """串起三层:文本清洗 → 脏轮过滤 → 话题聚焦 + token 瘦身。 输出可直接拼进 prompt 的多轮 messages,附带各层过滤统计方便观测。""" def run(self, raw_chat_history: List[ChatTurn], latest_user_msg: str) -> List[ChatTurn]: # Step1 Token清洗:逐轮清洗无效字符、去掉重复冗余短句 cleaned_history = [] for turn in raw_chat_history: clean_content = TokenCleaner.clean_text(turn.content) clean_content = TokenCleaner.remove_redundant_tokens(clean_content) turn.content = clean_content cleaned_history.append(turn) # Step2 脏会话过滤:灌水 / 跑题 / 违规 / 兜底句在这里被丢弃 valid_history = SessionPurifier.filter_dirty_chat(cleaned_history, latest_user_msg) # Step3 话题聚类:只保留与最新一轮同话题的历史 topic_history = ContextReducer.topic_cluster(valid_history) # Step4 按时间排序 + Token截断,控制最终上下文不超预算 sorted_history = ContextReducer.weight_sort(topic_history) final_history = ContextReducer.shrink_context(sorted_history, MAX_CONTEXT_TOKEN) print(f"[pipeline] 原始 {len(raw_chat_history)} 轮 → 清洗 {len(cleaned_history)} 轮 " f"→ 过脏后 {len(valid_history)} 轮 → 聚类后 {len(topic_history)} 轮 " f"→ 最终 {len(final_history)} 轮") return final_history # ============ 测试Demo:把 4 步逐层拆开打印 ============ if __name__ == "__main__": import time from sklearn.cluster import KMeans def banner(s): print("\n" + "=" * 64 + "\n " + s + "\n" + "=" * 64) latest_input = "现在帮我写一份产品使用手册" test_chat = [ ChatTurn(role="user", content=" 帮我写一个营销文案\n\n\n", timestamp=time.time()-120), ChatTurn(role="assistant", content="下面给你文案。下面给你文案。", timestamp=time.time()-110), ChatTurn(role="user", content="乱码测试,随便灌水闲聊", timestamp=time.time()-60), ChatTurn(role="assistant", content="我不知道你在说什么。", timestamp=time.time()-50), # 兜底句 ChatTurn(role="user", content="现在帮我写一份产品使用手册", timestamp=time.time()), ] # ───── Step 1 ───── banner("Step 1 · 文本清洗(去重/去无效字符)") cleaned = [] for t in test_chat: before = t.content t.content = TokenCleaner.clean_text(t.content) t.content = TokenCleaner.remove_redundant_tokens(t.content) cleaned.append(t) print(f" [{t.role:<9}] {before!r:34s} → {t.content!r}") # ───── Step 2 ───── banner("Step 2 · 四维度脏度打分(满 100,< 60 丢弃)") scored = [] for t in cleaned: score, why = 100.0, [] # ① 有效性:长度 if len(t.content) < 10: score -= 30; why.append("①短 -30") # ② 相关性 sim = float(cosine_similarity( [EMBED_MODEL.encode(latest_input)], [EMBED_MODEL.encode(t.content)] )[0][0]) if sim < TOPIC_SIM_THRESHOLD: score -= 25; why.append(f"②跑题 -25(sim={sim:.2f})") else: why.append(f"②相关 sim={sim:.2f}") # ③ 合规 hit_bad = [w for w in SessionPurifier.BAD_WORDS if w in t.content] if hit_bad: score -= 40; why.append(f"③违规 -40({hit_bad[0]})") # ④ 兜底句 hit_fb = [m for m in SessionPurifier.FALLBACK_MARKS if m in t.content] if hit_fb: score -= 35; why.append(f"④兜底 -35({hit_fb[0]})") t.dirty_score = max(0, score) keep = t.dirty_score >= DIRTY_SCORE_THRESHOLD scored.append((t, keep)) flag = "✅ 留" if keep else "❌ 丢" print(f" [{t.role:<9}] score={t.dirty_score:>5.0f} {flag} {t.content!r:34s} [{' | '.join(why)}]") valid = [t for t, k in scored if k] print(f"\n → 过脏后剩 {len(valid)} 轮 / 丢 {len(scored)-len(valid)} 轮") # ───── Step 3 ───── banner("Step 3 · 话题聚类(只留与最后一轮同话题)") if len(valid) > 1: embeds = [EMBED_MODEL.encode(t.content) for t in valid] labels = KMeans(n_clusters=min(3, len(valid)), random_state=42, n_init=10).fit_predict(embeds) for t, lab in zip(valid, labels): print(f" [{t.role:<9}] cluster={lab} {t.content!r}") current_topic = [valid[i] for i, lab in enumerate(labels) if lab == labels[-1]] else: labels = [0] * len(valid) current_topic = valid for t in valid: print(f" [{t.role:<9}] cluster=0 {t.content!r}") print(f"\n → 最后一轮 label={labels[-1]},同簇保留 {len(current_topic)} 轮") # ───── Step 4 ───── banner("Step 4 · 时间排序 + token 截断(不超 2048)") sorted_h = sorted(current_topic, key=lambda x: x.timestamp) total, final = 0, [] for t in sorted_h: cnt = TokenCleaner.count_token(t.content) if total + cnt <= MAX_CONTEXT_TOKEN: final.append(t); total += cnt print(f" ✅ [{t.role:<9}] +{cnt:>3}tok 累计{total:>4}/{MAX_CONTEXT_TOKEN} {t.content!r}") else: print(f" ❌ [{t.role:<9}] +{cnt:>3}tok 超预算停") break # ───── 汇总 ───── banner("送进 prompt 的最终上下文") for t in final: print(f" [{t.role:<9}] score={t.dirty_score:.0f} {t.content}") print(f"\n 漏斗:原始 {len(test_chat)} → 清洗 {len(cleaned)} → 过脏 {len(valid)} " f"→ 聚类 {len(current_topic)} → 最终 {len(final)} 轮") print(f" 最终 token:{sum(TokenCleaner.count_token(t.content) for t in final)} / {MAX_CONTEXT_TOKEN}")

代码说明:
- TokenCleaner:底层无效字符、重复文本清洗,统计Token数量,对应无效Token清洗;
- SessionPurifier:会话脏度打分,过滤低分脏会话,对应历史脏会话净化;
- ContextReducer:话题聚类、时序权重排序、Token总量控制,对应上下文冗余精简;、
运行输出
Downloading Model from modelscope to directory: D:\modelscope\hub\sentence-transformers\all-MiniLM-L6-v2
================================================================
Step 1 · 文本清洗(去重/去无效字符)
================================================================
[user ] ' 帮我写一个营销文案\n\n\n' → '帮我写一个营销文案'
[assistant] '下面给你文案。下面给你文案。' → '下面给你文案。下面给你文案。'
[user ] '乱码测试,随便灌水闲聊' → '乱码测试,随便灌水闲聊'
[assistant] '我不知道你在说什么。' → '我不知道你在说什么。'
[user ] '现在帮我写一份产品使用手册' → '现在帮我写一份产品使用手册'
================================================================
Step 2 · 四维度脏度打分(满 100,< 60 丢弃)
================================================================
[user ] score= 70 ✅ 留 '帮我写一个营销文案' [①短 -30 | ②相关 sim=0.78]
[assistant] score= 100 ✅ 留 '下面给你文案。下面给你文案。' [②相关 sim=0.33]
[user ] score= 60 ✅ 留 '乱码测试,随便灌水闲聊' [②相关 sim=0.50 | ③违规 -40(乱码测试)]
[assistant] score= 65 ✅ 留 '我不知道你在说什么。' [②相关 sim=0.68 | ④兜底 -35(我不知道)]
[user ] score= 100 ✅ 留 '现在帮我写一份产品使用手册' [②相关 sim=1.00]
→ 过脏后剩 5 轮 / 丢 0 轮
================================================================
Step 3 · 话题聚类(只留与最后一轮同话题)
================================================================
[user ] cluster=0 '帮我写一个营销文案'
[assistant] cluster=2 '下面给你文案。下面给你文案。'
[user ] cluster=1 '乱码测试,随便灌水闲聊'
[assistant] cluster=0 '我不知道你在说什么。'
[user ] cluster=0 '现在帮我写一份产品使用手册'
→ 最后一轮 label=0,同簇保留 3 轮
================================================================
Step 4 · 时间排序 + token 截断(不超 2048)
================================================================
✅ [user ] + 10tok 累计 10/2048 '帮我写一个营销文案'
✅ [assistant] + 11tok 累计 21/2048 '我不知道你在说什么。'
✅ [user ] + 12tok 累计 33/2048 '现在帮我写一份产品使用手册'
================================================================
送进 prompt 的最终上下文
================================================================
[user ] score=70 帮我写一个营销文案
[assistant] score=65 我不知道你在说什么。
[user ] score=100 现在帮我写一份产品使用手册
漏斗:原始 5 → 清洗 5 → 过脏 5 → 聚类 3 → 最终 3 轮
最终 token:33 / 2048
六、总结
大模型推理性能衰退、输出不稳定、响应慢、成本高的核心隐性元凶,就是三类容易被忽略的脏数据:上下文冗余、历史脏会话、无效Token。不同于训练阶段的数据集优化、模型参数调优、提示词工程优化,推理脏数据治理是大模型落地运维中最基础、最高效、最低成本的优化手段,也是绝大多数新手和企业容易遗漏的关键环节。
在性能层面,彻底解决脏数据引发的注意力偏移、逻辑异化、窗口挤占问题,大幅提升大模型推理精准度、逻辑连贯性和稳定性,杜绝模型越用越笨的问题;在效率层面,大幅减少无效算力消耗,降低推理延迟,提升接口响应速度,优化用户交互体验;在成本层面,有效精简无效Token数量,降低大模型接口调用计费和服务器算力成本,为企业降本增效。
未来大模型的应用是精细化运维、数据质量、推理稳定性的适配。做好推理脏数据全自动清洗,是大模型长效稳定落地的基础保障,也是从源头解决大模型推理污染难题,让大模型始终保持高效、精准、稳定的输出状态,最大化发挥大模型的业务价值。