一、前言
现在做大模型开发,基本都绕不开多模型部署的问题。不管是企业业务场景,还是个人项目开发,基本都倾向于多个大模型组合应用。Qwen通义千问擅长通用问答与轻量化部署,ChatGLM适配中文对话、微调门槛低,Llama系列模型开源性强、适配二次开发,三个模型各有优势,结合使用能完美覆盖绝大多数AI业务场景。
但理想很丰满,现实部署却处处踩坑。我们在一台服务器上混合部署这三类模型时,总会遇到各种诡异问题:明明单模型运行正常,共存后就出现库版本报错、CUDA适配失败、推理闪退、权重加载异常。大部分人遇到问题只能盲目换环境、重装依赖,耗费大量时间却找不到根本原因。其实所有问题的核心根源,都是模型依赖不统一、运行环境不隔离、适配规则不规范。不同大模型基于不同的框架版本、依赖不同的Python库、CUDA和PyTorch版本要求也天差地别。今天我们结合实践理清多模型混合部署的冲突根源,构建依赖隔离,搞定三大模型稳定共存部署。
二. 部署冲突核心
1. 模型环境差异
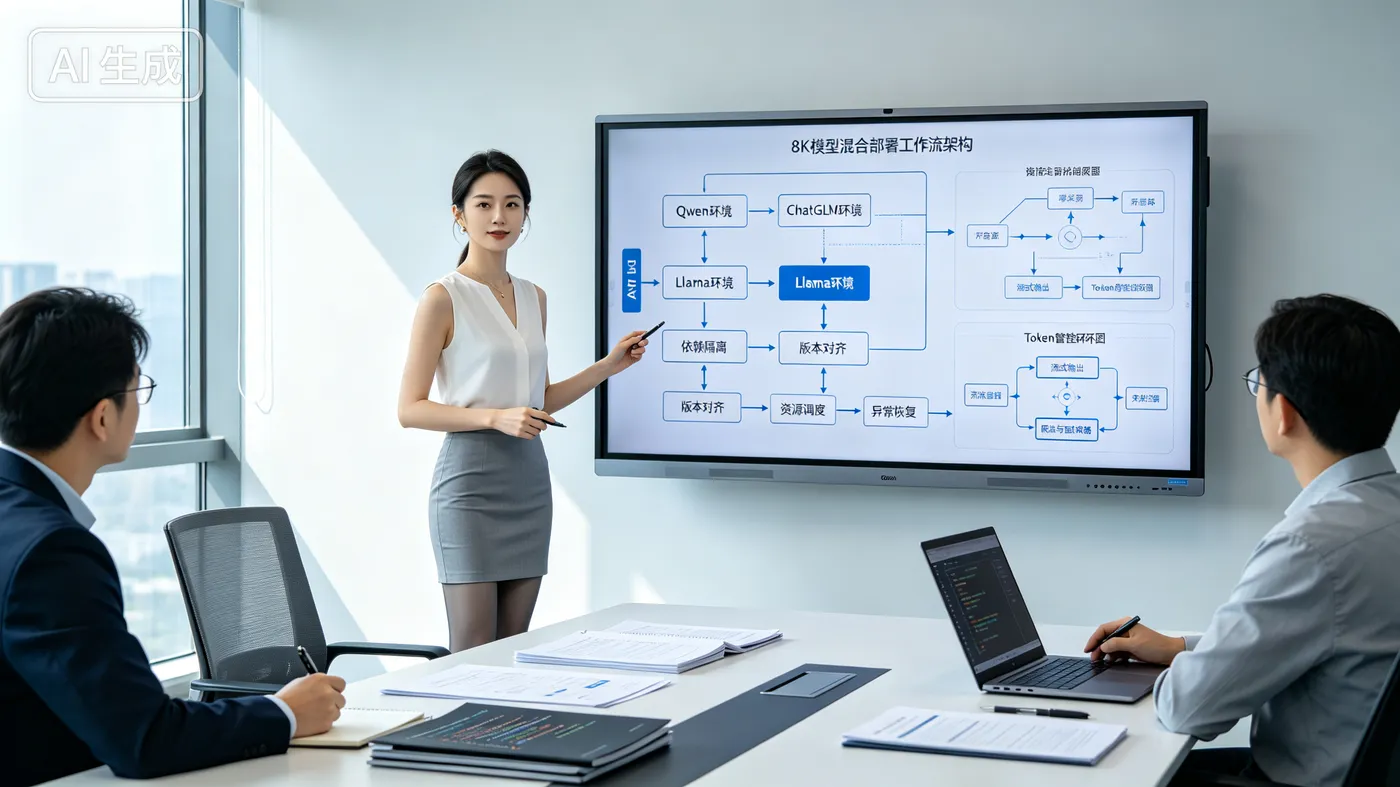
要解决版本冲突,首先要搞懂Qwen、ChatGLM、Llama三大模型的核心环境差异,这是所有兼容问题的底层原因。通常我们容易只照搬部署教程,却忽略了每个模型的适配基线,最终导致多模型共存时环境互相干扰。
1.1 PyTorch版本差异
版本差异是多模型适配最核心的冲突点:
- Llama系列模型诞生较早,原生适配PyTorch1.13及以上稳定版本,对新版本兼容性一般,过高的PyTorch会出现权重加载错位问题。
- ChatGLM系列主要适配PyTorch2.0+版本,依托新版本的加速算子实现高效推理,低版本会直接报错无法运行。
- 而Qwen模型兼容性相对宽泛,但最优运行版本为PyTorch2.1、2.2,在1.x版本中会损失推理性能。
1.2 CUDA与显卡驱动适配差异
- Llama模型对CUDA版本要求宽松,CUDA11.3、11.6、11.7均可稳定运行,适配老旧显卡驱动。
- ChatGLM依赖最新的CUDA算子,必须基于CUDA11.8及以上版本,否则加速模块失效,推理速度大幅下降。
- Qwen轻量化模型兼顾新旧环境,CUDA11.3至12.1均可适配,但量化推理仅支持高版本CUDA。
1.3 第三方依赖库差异
这是最容易被忽略的冲突点,三大模型对transformers、accelerate、sentencepiece等核心库的版本要求完全不同。
- Llama需要低版本transformers 4.28以下,高版本会更改权重解析逻辑;
- ChatGLM适配4.30以上新版本transformers;
- Qwen则对中间版本适配最佳,版本过高或过低都会出现分词异常、推理报错。
正是这些全方位的环境差异,导致单模型部署正常,多模型混合部署时,全局依赖库、运行环境被覆盖、篡改,最终出现各类报错。这也是我们必须做环境隔离的核心原因。
2. 常见冲突场景
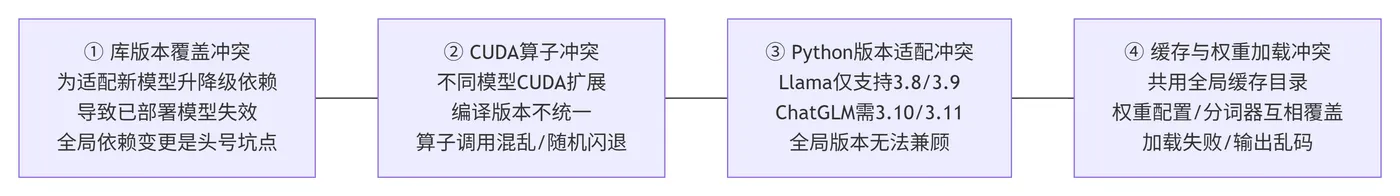
结合大量部署实战案例的积累,结合日志整理了三大模型混合部署中最常见的四类冲突场景,遇到问题可以对照自查,快速定位问题根源。
2.1 库版本覆盖冲突
- 也是最高频的问题,通常我们部署完第一个模型后,为适配第二个模型直接升级或降级依赖库,导致已部署模型失效。
- 比如部署完高版本transformers适配的ChatGLM后,部署Llama时降级transformers,直接造成ChatGLM启动报错、分词失效。
- 这种全局依赖变更,是混合部署的头号坑点。
2.2 CUDA算子冲突
- 不同模型的CUDA扩展算子编译版本不统一;
- ChatGLM的flash-attention加速算子基于CUDA11.8编译,Llama的量化算子基于CUDA11.6编译;
- 共存后会出现算子调用混乱,表现为推理卡顿、随机闪退、显存占用异常。
2.3 Python版本适配冲突
- Llama支持Python3.8、3.9老旧版本,不支持3.11及以上新版本;
- ChatGLM最优适配Python3.10、3.11;
- Qwen兼容3.9-3.11全版本。
- 如果全局Python版本固定,必然会有一个模型无法适配运行。
2.4 缓存与权重加载冲突
- 多模型共用全局transformers缓存目录时,不同模型的权重配置文件、分词器缓存会互相覆盖;
- 出现明明权重文件完整,却加载失败、输出乱码、对话逻辑混乱等问题。
以上所有冲突,本质都是多模型共用一套全局运行环境导致的资源抢占、版本覆盖、参数错乱,想要彻底解决,核心方案就是依赖隔离。
三. 依赖隔离方案
1. 虚拟环境隔离
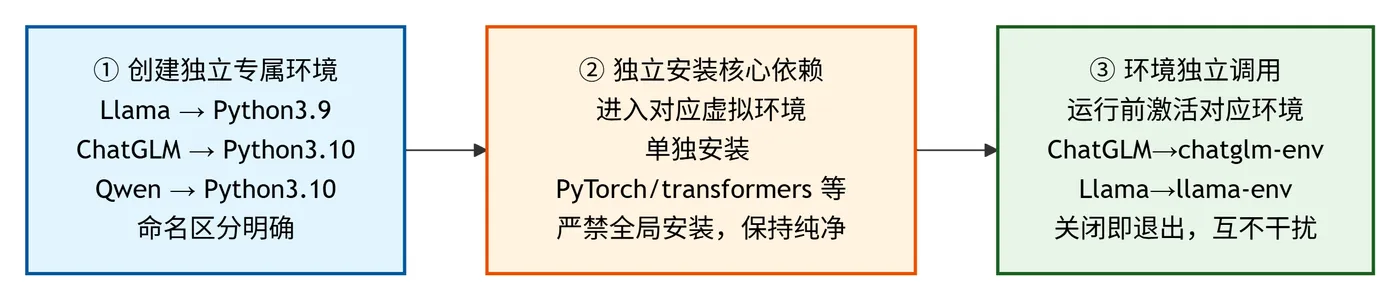
虚拟环境隔离是最容易上手、稳定性最高的基础隔离方案,核心逻辑是为Qwen、ChatGLM、Llama三个模型分别搭建独立的Python运行环境,实现依赖库、Python版本完全互不干扰,从根源杜绝版本覆盖问题。
目前主流的虚拟环境工具为Conda,相比原生venv,Conda可以精准管控Python版本、CUDA依赖、第三方库,适配大模型复杂的环境需求。具体搭建流程是说明
第一步,创建独立专属环境
严格按照各模型最优适配版本创建,三个环境命名区分明确,避免混淆:
- Llama专属环境选择Python3.9,保证兼容性;
- ChatGLM专属环境选择Python3.10,适配最新算子;
- Qwen专属环境选择Python3.10,兼顾性能与稳定性。
第二步,独立安装核心依赖
- 进入对应模型的虚拟环境后,单独安装适配版本的PyTorch、transformers、accelerate等核心库。
- 切记绝对不要全局安装任何大模型依赖,所有依赖均在对应独立环境内安装,确保每个环境的库版本唯一、纯净,不会被其他模型影响。
第三步,环境独立调用
- 部署运行时,先激活对应模型的虚拟环境,再启动推理服务。
- 比如运行ChatGLM就激活chatglm-env,运行Llama就激活llama-env,全程环境隔离,互不干扰。
- 关闭服务后,退出环境即可,不会残留任何环境配置。
示例:Conda一键创建环境脚本
create_env.sh,分别构建3套隔离Python环境
# 1. Llama环境 Python3.9 + CUDA11.6 conda create -n llama-env python=3.9 -y conda activate llama-env pip3 install torch==1.13.1+cu116 torchvision==0.14.1+cu116 --index-url https://download.pytorch.org/whl/cu116 pip install transformers==4.27.4 accelerate==0.18.0 sentencepiece==0.1.97 protobuf==3.20.3 conda deactivate # 2. ChatGLM环境 Python3.10 + CUDA11.8 conda create -n chatglm-env python=3.10 -y conda activate chatglm-env pip3 install torch==2.1.0+cu118 torchvision==0.16.0+cu118 --index-url https://download.pytorch.org/whl/cu118 pip install transformers==4.35.2 accelerate==0.24.1 sentencepiece==0.1.99 flash-attn==2.0.4 conda deactivate # 3. Qwen环境 Python3.10 + CUDA12.1 conda create -n qwen-env python=3.10 -y conda activate qwen-env pip3 install torch==2.2.0+cu121 torchvision==0.17.0+cu121 --index-url https://download.pytorch.org/whl/cu121 pip install transformers==4.33.3 accelerate==0.24.0 sentencepiece==0.2.0 conda deactivate

这套方案的优势是零学习成本、稳定性极强,适合绝大多数个人开发者和小型项目。缺点是环境占用空间稍大,三个独立环境会占用一定磁盘空间,但对于当下服务器配置来说完全可以忽略。对于初学者,优先使用虚拟环境隔离,能解决90%的版本冲突问题。
2. 容器环境隔离
如果是企业级部署、多服务长期运行、多人协作开发场景,单纯的虚拟环境隔离已经不够用,容易出现环境配置迁移失败、服务器环境污染、部署一致性差等问题。此时最优方案是Docker容器隔离,实现模型运行环境、系统依赖、配置文件的完全隔离。
Docker容器的核心优势是一次打包、随处运行、环境完全独立。我们可以为Qwen、ChatGLM、Llama分别构建专属镜像,每个镜像内置专属的Python版本、CUDA版本、所有依赖库、推理脚本,容器之间完全隔离,不会出现任何资源抢占和版本冲突,具体落地流程说明:
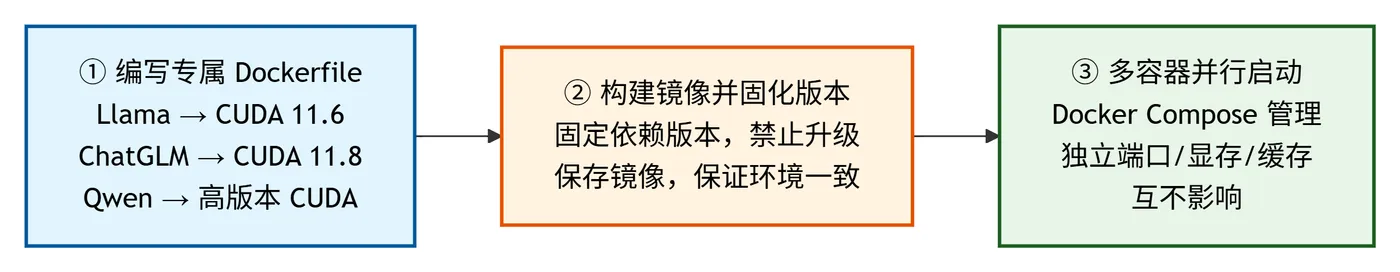
第一步,编写专属Dockerfile
针对每个模型的环境需求,定制基础镜像,精准匹配模型运行基线:
- Llama选用CUDA11.6基础镜像;
- ChatGLM选用CUDA11.8镜像;
- Qwen选用通用高版本CUDA镜像。
第二步,构建镜像并固化版本
- 在Dockerfile中固定所有依赖库版本,禁止动态升级,避免后续环境变动导致报错。
- 构建完成后,保存镜像版本,后续部署直接复用,保证环境一致性,解决协作部署中的环境不一致问题。
第三步,多容器并行启动
- 通过Docker Compose统一管理三个模型容器,配置独立端口、独立显存资源、独立缓存目录;
- 实现三大模型同时后台运行,业务端通过不同端口调用对应模型服务,互不影响。
相比虚拟环境,Docker隔离更彻底,不仅隔离Python依赖,还隔离系统层级的CUDA、驱动、配置文件,彻底杜绝所有隐性冲突。同时支持服务常驻、自动重启、资源限制,非常适合生产环境落地,是企业多模型混合部署的标准方案。
四. 兼容适配优化
1. 依赖版本对齐
完成环境隔离后,还需要做精细化的版本对齐优化,进一步提升多模型部署的稳定性,规避隐性兼容问题。很多时候环境隔离后仍出现小概率报错,核心原因就是依赖版本未精准对齐,存在细微适配偏差。

1.1 核心框架版本精准锁定
整理三大模型的最优适配版本清单,全程固定版本,不使用最新版、不使用模糊适配版本,精准的版本锁定,能从根源规避绝大多数兼容bug:
- Llama固定PyTorch1.13、transformers4.27、sentencepiece0.1.97;
- ChatGLM固定PyTorch2.1、transformers4.35、flash-attention2.0;
- Qwen固定PyTorch2.2、transformers4.33、accelerate0.24。。
1.2 次级依赖适配对齐
- 很多报错并非核心库问题,而是次级依赖版本不匹配。
- 比如torchvision、tokenizers、peft等工具库,需要跟随核心框架版本适配安装,避免版本跨度太大导致的接口调用失败。
- 禁止随意升级小众依赖库,保持整套环境版本统一稳定。
1.3 版本兼容兜底配置
- 在各模型的推理脚本中,添加版本检测逻辑,启动服务时自动校验当前环境的PyTorch、transformers版本;
- 若不符合最优版本,自动提示并终止启动,避免带错运行导致推理异常。
- 同时关闭库的自动更新功能,防止后台自动升级依赖破坏环境稳定性。
示例:版本校验脚本 version_check.py
推理启动前自动校验依赖版本,版本不对直接退出,防止带错运行。
import sys
import importlib
def check_pkg(pkg_name, target_ver):
    try:
        pkg = importlib.import_module(pkg_name)
        ver = pkg.__version__
        if ver != target_ver:
            print(f"❌ {pkg_name}版本错误:当前{ver},要求{target_ver}")
            sys.exit(1)
        else:
            print(f"✅ {pkg_name}: {ver}")
    except ImportError:
        print(f"❌ 未安装包 {pkg_name}")
        sys.exit(1)
if __name__ == "__main__":
    # 按需切换:llama / chatglm / qwen
    model_type = "qwen"
    if model_type == "llama":
        check_pkg("torch", "1.13.1")
        check_pkg("transformers", "4.27.4")
    elif model_type == "chatglm":
        check_pkg("torch", "2.1.0")
        check_pkg("transformers", "4.35.2")
    elif model_type == "qwen":
        check_pkg("torch", "2.2.0")
        check_pkg("transformers", "4.33.3")
    print("✅ 版本校验全部通过,可以加载模型推理")

2. 资源调度适配
多模型混合部署除了版本冲突,还存在显存抢占、资源过载、推理卡顿等问题,需要通过资源调度适配,实现三大模型高效共存,最大化利用服务器资源。
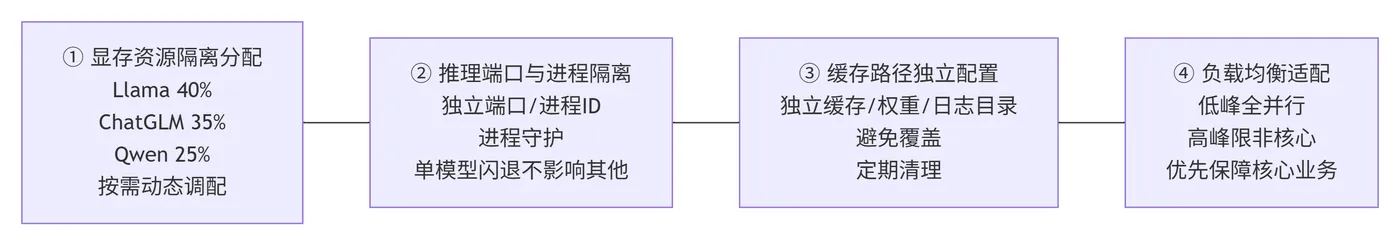
第一,显存资源隔离分配:通过环境变量精准限制各模型的显存占用,避免单模型抢占全部显存,导致其他模型OOM显存溢出。
- Llama模型量化后显存占用低,可分配40%显存资源;
- ChatGLM推理加速需求高,分配35%显存;
- Qwen轻量化模型分配剩余25%显存;
按需动态调配,保证多模型并行稳定运行。
第二,推理端口与进程隔离:
- 为三个模型设置独立的启动端口、独立进程ID,避免端口占用、进程冲突。
- 同时配置进程守护,单个模型服务异常闪退时,不会影响另外两个模型的正常运行,提升整体服务稳定性。
第三,缓存路径独立配置:
- 修改各模型的transformers缓存目录、权重加载目录、日志输出目录,实现完全独立,避免缓存文件互相覆盖、日志错乱问题。
- 同时定期清理无效缓存,释放磁盘空间,保证长期稳定运行。
第四,负载均衡适配:针对业务高频调用场景,配置简单的负载均衡规则。
- 低峰期开启全模型并行推理;
- 高峰期自动限制非核心模型的推理并发;
- 优先保障核心业务模型运行,避免服务器资源过载。
3. 独立推理服务适配
每个脚本在各自conda环境单独启动,监听不同端口;设置独立 cache 目录,避免分词器缓存冲突。
3.1 Qwen推理脚本 qwen_service.py:端口8001
import os from fastapi import FastAPI from transformers import AutoTokenizer, AutoModelForCausalLM # 独立缓存目录,不共用全局cache os.environ["TRANSFORMERS_CACHE"] = "./cache/qwen" # 显存限制,对应资源调度章节 os.environ["CUDA_VISIBLE_DEVICES"] = "0" app = FastAPI(title="Qwen Service") # 版本校验 exec(open("version_check.py").read()) model_name = "Qwen/Qwen-7B-Chat" tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_name, device_map="auto", trust_remote_code=True ).eval() .get("/chat") async def chat(prompt: str): inputs = tokenizer(prompt, return_tensors="pt").to("cuda") output = model.generate(**inputs, max_new_tokens=512) resp = tokenizer.decode(output[0], skip_special_tokens=True) return {"model":"qwen", "response": resp} if __name__ == "__main__": import uvicorn uvicorn.run("qwen_service:app", host="0.0.0.0", port=8001)

3.2 ChatGLM推理脚本 chatglm_service.py:端口8002
import os from fastapi import FastAPI from transformers import AutoTokenizer, AutoModel os.environ["TRANSFORMERS_CACHE"] = "./cache/chatglm" os.environ["CUDA_VISIBLE_DEVICES"] = "0" app = FastAPI(title="ChatGLM Service") exec(open("version_check.py").read()) model_name = "THUDM/chatglm3-6b" tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True) model = AutoModel.from_pretrained( model_name, device_map="auto", trust_remote_code=True ).eval() .get("/chat") async def chat(prompt: str): resp, _ = model.chat(tokenizer, prompt, history=[]) return {"model":"chatglm", "response": resp} if __name__ == "__main__": import uvicorn uvicorn.run("chatglm_service:app", host="0.0.0.0", port=8002)

3.3 Llama推理脚本 llama_service.py:端口8003
import os from fastapi import FastAPI from transformers import AutoTokenizer, AutoModelForCausalLM os.environ["TRANSFORMERS_CACHE"] = "./cache/llama" os.environ["CUDA_VISIBLE_DEVICES"] = "0" app = FastAPI(title="Llama Service") exec(open("version_check.py").read()) model_name = "meta-llama/Llama-2-7b-chat-hf" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained( model_name, device_map="auto" ).eval() .get("/chat") async def chat(prompt: str): inputs = tokenizer(prompt, return_tensors="pt").to("cuda") output = model.generate(**inputs, max_new_tokens=512) resp = tokenizer.decode(output[0], skip_special_tokens=True) return {"model":"llama2", "response": resp} if __name__ == "__main__": import uvicorn uvicorn.run("llama_service:app", host="0.0.0.0", port=8003)

五. 实践异常处理
1. 常见报错修复
即便按照方案部署,但落地时仍可能遇到部分报错,我们也整理了部署过程中最高频的报错问题及一键修复方案,覆盖权重加载、算子调用、版本适配全场景。
1.1 transformers版本不匹配,权重加载失败。
- 表现为启动时报错模型配置解析异常,输出维度不匹配。
- 修复方案:进入对应模型独立环境,严格卸载当前版本,安装模型适配的指定版本,禁止跨版本兼容,重启服务即可解决。
1.2 CUDA算子不兼容,推理闪退、速度极慢。
- 表现为无明确报错信息,但推理过程随机中断,显存占用波动极大。
- 修复方案:重新编译对应模型的CUDA加速算子,匹配当前CUDA版本,关闭自动算子适配功能,手动指定算子编译版本。
1.3 分词器异常,输出乱码、重复语句。
- 核心原因是多模型分词器缓存覆盖冲突。
- 修复方案:清空各模型独立缓存目录,重新加载专属分词器权重,固定分词器配置,禁止共用全局分词器资源。
1.4 PyTorch版本冲突,张量计算报错。
- 表现为模型加载正常,推理时报错张量维度、计算接口异常。
- 修复方案:核对当前环境PyTorch版本,降级或升级至最优适配版本,同步适配对应的torchvision、torchaudio版本。
2. 环境固化运维
多模型混合部署完成后,环境固化是长期稳定运行的关键,很多部署故障都是因为环境随意变更、依赖自动更新导致。做好环境固化运维,能彻底避免后续版本冲突问题。
- 首先,依赖版本冻结。每个独立虚拟环境、Docker容器环境,部署完成后立即冻结所有依赖版本,通过pip freeze生成requirements.txt文件,记录所有库的精准版本。后续环境迁移、重装部署,直接依据文件批量安装,保证环境100%复刻,无版本偏差。
- 其次,关闭依赖自动更新。禁用pip、conda、Docker镜像的自动更新功能,避免后台自动升级依赖库,篡改已稳定的运行环境。日常运维中,非必要不升级任何依赖版本,如需升级,需单独测试兼容性后再更新。
- 最后,环境备份与快速恢复。定期备份三大模型的虚拟环境、Docker镜像、配置文件。一旦出现环境损坏、版本错乱问题,无需重新部署,直接恢复备份环境,5分钟内即可完成故障修复,大幅降低运维成本。
六. 总结
其实多模型共存部署并没有想象中复杂,所有问题都围绕环境不隔离、版本不匹配、资源不独立三个核心痛点展开,只要找对方法,就能彻底规避所有坑点。
对于个人开发者和小型项目,使用Conda虚拟环境隔离+精准版本适配,就可以低成本实现三模型稳定共存;对于企业生产环境,推荐Docker容器隔离+资源调度方案,保障服务高可用、高稳定性。两种方案均无需多台服务器,单设备即可实现多模型高效部署,大幅降低AI落地成本。直白的讲,很多处理方式只能是个参照,具体问题和当时的环境也很大的关系,甚至而言,运气也同样重要,这里只是当一个微亮的探照灯散发出零星的点点星光,照亮来时路!