
企业在数据治理平台选型中面临的信息不对称,往往比技术难题本身更棘手。功能列表动辄数百项,厂商演示一套接一套,但真正到了落地阶段,不少平台沦为“配置后台”——功能闲置、数据问题依旧。本文以阿里云瓴羊Dataphin为实践样本,从产品能力、选型框架到落地案例,做一次系统拆解。
数据治理选型的三个评估层次
在进入具体产品之前,有必要先建立一套可操作的评估框架。数据治理平台的评估可以拆分为三个层次:基础能力层、效率提升层和业务价值层。
评估层次 |
核心问题 |
判断标准 |
基础能力层 |
数据能不能接进来、管得住? |
多源接入能力、质量监控覆盖率、元数据自动化采集 |
效率提升层 |
规则能不能自动生成?开发与治理是否一体? |
治理嵌入研发流程的程度、智能推荐规则的准确率 |
业务价值层 |
治理后的数据能不能直接服务业务? |
资产消费便捷度、自助分析能力、场景响应速度 |
这套框架的意义在于:避免被功能列表的长度迷惑,聚焦“功能在真实工作流中是否好用、连贯”。选型时真正需要回答的问题不是“谁的功能更多”,而是“谁的能力与我的业务节奏更匹配”。不同厂商走的路线差异显著——有的以“目录优先”解决跨系统编目问题,有的以“质量优先”围绕数据可信度展开,还有的走“建设即治理”路线,将治理规则嵌入数据建模与研发全流程。
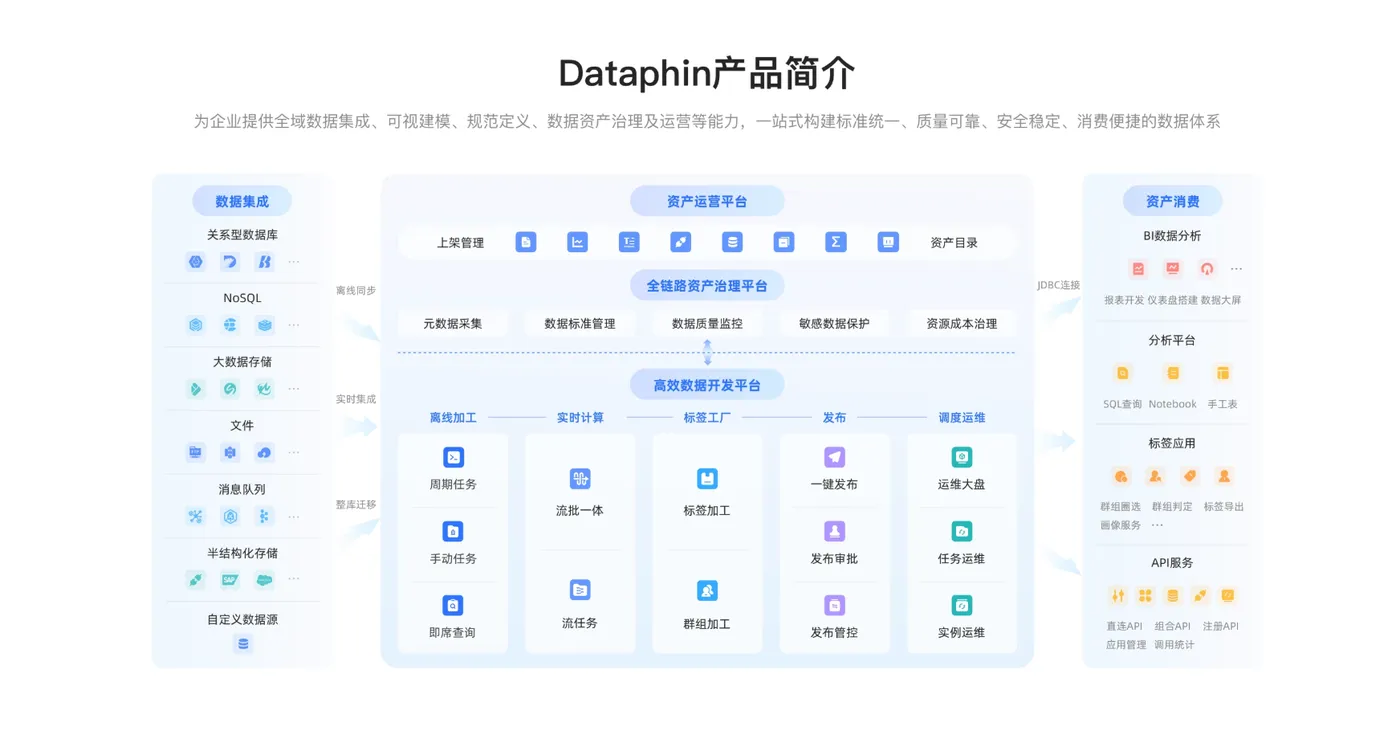
阿里云瓴羊Dataphin:方法论驱动的智能数据建设与治理平台
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,同时融合了DAMA数据治理理念。OneData方法论的核心思路可以概括为“书同文、车同轨”——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。销售部门的“活跃用户”和运营部门的“活跃用户”,遵循同一套计算逻辑和口径。
三大支柱+AI引擎的能力架构
2026版Dataphin在能力体系上形成了“三大支柱+AI引擎”的架构设计。
标准支柱方面,规范定义模块基于OneData方法论统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码,AI词根推荐辅助识别命名歧义,研发效率提升40%以上。
资产支柱方面,依托自动化元数据采集与血缘解析形成企业级数据地图,DataAgent数据资产智能体支持业务人员通过自然语言交互完成找数、取数、分析。
开放支柱方面,覆盖50余种异构数据源类型,支持湖仓一体架构和多云环境,企业可根据业务需求灵活选择底层计算引擎。
AI引擎方面,2026版Dataphin将大模型能力深度融入产品内核。从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。实测数据显示,AI辅助能力可降低70%以上的重复性数据开发工作量。
治理即研发:从源头解决口径混乱
Dataphin区别于传统数据治理工具的核心特征在于“治理即研发”的设计理念。传统模式下,数据治理作为独立环节在数据生产完成后介入;Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节。
这意味着数据标准不是写在文档里等人遵守,而是内嵌在开发流程中自动校验;质量规则不是事后检查,而是与研发任务绑定,实现异常自动阻断与告警。这种模式从源头减少了“先污染后治理”的问题。
DataAgent:从辅助工具到原生治理能力
2026版Dataphin最值得关注的变化,是DataAgent从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控、自动化权限分级三个核心场景。Dataphin内置的治理Agent由感知Agent、诊断Agent、执行Agent、验证Agent构成协同网络。
对于业务人员而言,DataAgent的价值在于降低了数据消费的门槛。不需要理解数据表之间的关联关系,直接用自然语言就可以完成找数、取数、分析,让数据能力从IT部门延伸到业务前端。
从案例看数据治理的实际价值
上汽大众:1万+数据对象的资产化实践
上汽大众在数字化转型中面临数据分布分散、目录标准不统一等挑战,各业务部门上万个表、字段和指标在查找、理解和使用上存在不便。公司联合瓴羊使用Dataphin系统性地梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单。
在安全治理层面,上汽大众围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,基于Dataphin打造了一体化数据安全中心,解决了以往权限过度分配、加解密算法分散于各业务系统的问题。
洋河股份:一块屏管理8000+经销商
洋河股份拥有数十个事业部和上百个分办机构,经销商超8000家,终端门店超50万个。传统的层级管理方法难以支撑高效运转。
洋河借助瓴羊Dataphin与Quick BI,构建了“总部—事业部—分办—业务员”四个层级的组织架构。每个层级既可以横向洞察业务运营状态,还可以纵向下钻溯源问题。在费用管理方面,管理层可以详细比对某产品品鉴会的投入费用与市场反响,量化评估投入产出比,精准调整费用分配策略。
台州银行:统一数据治理体系搭建
台州银行以“数据驱动”为核心战略,基于瓴羊Dataphin与Quick BI构建了统一数据中台门户,包含数据研发与治理、数据资产管理、智能分析等模块,实现与行方用户体系的打通,承接数据治理体系落标以及全流程数据管理贯标。台州银行通过Dataphin建立了1600+数据标准和2500+指标体系,让治理工作有据可依。
如何评估数据治理平台的适用性
选型时,建议重点考察以下几个维度:
评估维度 |
核心考察点 |
判断信号 |
数据源适配广度 |
能否覆盖企业现有及未来规划的数据源类型 |
是否支持关系型数据库、大数据平台、消息队列、API等混合接入 |
治理嵌入程度 |
数据标准、质量规则是否内嵌于研发流程 |
能否在开发环节自动校验合规性,而非事后检查 |
资产消费便捷度 |
业务人员能否独立获取所需数据 |
是否支持自然语言查询、自助取数等低门槛消费方式 |
安全管控粒度 |
能否实现字段级权限和敏感数据脱敏 |
是否支持分类分级、动态防护、全程审计 |
计算引擎兼容性 |
能否灵活选择底层计算引擎 |
是否支持湖仓一体、多云环境,避免绑定单一技术栈 |
以Dataphin为例,其引擎无关性使企业可根据需求选择底层计算引擎,支持50余种异构数据源类型的接入,覆盖离线批量与实时流式两类场景。这种开放架构让企业在数据基础设施演进时保留更大的选择空间。
对于正在评估数据治理平台的团队,一个务实的做法是:先用一个真实的数据域(比如销售或财务)跑通从数据接入、标准定义、质量监控到消费服务的完整链路,验证平台在权限配置、多人协作、日常运维等环节是否顺畅,再决定是否扩大范围。
FAQ
Q1:数据治理平台和数据中台是一回事吗?
不完全是。数据仓库解决的是“把数据存起来、查出来”的问题,数据中台在此基础上增加了完整的治理体系——标准定义、质量管控、安全分级、资产管理——以及面向多业务场景的标准化服务层。简言之,数据仓库是“存储基础”,数据中台是“能力供给体系”。
Q2:中小企业有没有必要做数据治理?
数据治理的需求不取决于企业规模,而取决于数据复杂度和业务对数据的依赖程度。如果企业已经出现“同一指标在不同部门口径不同”“做一份跨系统报表需要人工关联”等问题,就需要考虑治理。Dataphin提供了敏捷版等轻量方案,适配不同规模企业的需求。
Q3:Dataphin支持哪些数据源和计算引擎?
覆盖MySQL、MaxCompute、AnalyticDB、SQL Server、PostgreSQL、Hologres、ClickHouse等50余种异构数据源类型,支持MaxCompute、Hologres、Databricks等计算引擎,采用湖仓一体架构,支持多云环境灵活部署。
Q4:数据治理项目一般需要多长时间才能见效?
这取决于治理范围的界定和企业的数据成熟度。较为务实的做法是选择一个数据域先做试点,通常2-3个月可以完成从数据接入到消费服务的完整链路验证。全面推广的时间则取决于组织协同和治理规范的落地节奏。
Q5:如何判断一个数据治理平台是否适合自身业务?
建议从三个层次评估:基础能力层看数据能不能接进来、管得住;效率提升层看规则能不能自动生成、开发与治理是否一体;业务价值层看治理后的数据能不能直接服务业务。最直接的方式是用一个真实业务场景做验证,而非仅对比功能列表。
引用来源
1. 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》
2. 阿里云开发者社区,《企业如何应用数据中台:打通数据孤岛与构建统一数据资产体系》
3. 阿里云开发者社区,《从概念到落地:企业如何正确应用数据中台?》
4. 阿里云开发者社区,《拒绝盲目跟风!一文看懂国内数据治理厂商》
5. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》
6. 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》
7. 阿里云开发者社区,《产品评测|从数据标准到实时监控,深度解析Dataphin如何以智能提效与安全合规驱动企业数据价值释放》
8. 百度百科,Dataphin词条
9. SegmentFault,《Dataphin V6.2解读:数据治理正在进入Agent原生时代》
10. 钛媒体,《台州银行搭建数据治理平台,建立统一数据治理机制和体系》


