
一、选型路上最常见的三个误区
企业在数据治理工具选型中踩过的坑,往往不是预算不够,而是方向错了。
误区一:把功能清单当能力边界。 选型时最容易犯的错,就是盯着功能列表比长短。厂商的PPT上标准、质量、元数据、主数据、资产目录、AI功能一应俱全,但上线后业务部门依然不知道去哪里找数据。“支持”这个词的弹性很大——它可以表示菜单里有个入口,也可以表示全自动采集加端到端闭环。只有把真实数据灌进去、让团队亲手操作一遍,才能看清每项功能到底落在光谱的哪个位置。
误区二:追求大而全,忽视架构连续性。 某制造业集团花了半年时间选型,最终上线的产品管元数据的归元数据、管质量的归质量,两个系统之间打不通,数据血缘断在半路上。出问题时需要同时登录三个后台,手动拼结果。数据治理平台选型的核心问题不是“功能够不够多”,而是“架构能不能支撑闭环”。
误区三:只看产品本身,忽视与企业数据成熟度的匹配。 年数据量不足500TB的中型企业硬上支持万级表血缘的企业级平台,不仅采购成本翻倍,运维复杂度也会拖慢数据团队交付速度。选型的核心在于匹配企业数据成熟度与平台能力层级,而非追求功能最全。
二、科学评估的六个核心维度
避开误区之后,需要一套结构化的评估框架。结合Gartner 2026年数据与分析治理平台评估标准的演进方向,以及行业主流实践,以下六个维度值得重点关注。
评估维度 |
核心考察点 |
验证方法 |
预警信号 |
元数据与血缘 |
数据源适配广度、血缘粒度、解析准确率 |
接入真实数据库,观察采集完整度与耗时;追溯BI指标血缘至源表字段 |
元数据需手工录入;血缘只覆盖平台内部 |
数据标准落地 |
标准定义与稽核执行的联动能力 |
现场创建数据元标准→挂接物理表字段→执行稽核扫描 |
标准和采集是两个独立模块,需实施阶段配置 |
数据质量闭环 |
规则引擎灵活性、根因分析深度、修复流程完整性 |
拿真实痛点配置规则→全量扫描→追溯源系统根因→走完修复复验 |
质量规则需要写SQL;质量检查会阻塞数据流转 |
安全与权限 |
分类分级自动化、脱敏与权限联动 |
验证不同角色查看同一数据的结果差异;查看审计日志完整性 |
安全功能需单独购买;脱敏、权限、审计各自独立 |
AI融合深度 |
AI是否嵌入治理工作流,而非独立功能 |
观察AI是否自动触发质量分析、自动生成标准建议 |
AI只是独立问答入口,与治理流程无联动 |
多组织架构 |
多租户隔离、跨空间标准共享 |
模拟总部加子公司场景,验证标准跨空间共享与独立配置 |
多组织需要部署多套系统 |
Constellation Research在2026年的评估标准中指出,评估重心已转向主动元数据与自动化、跨系统血缘、AI就绪治理、业务采纳度以及对决策速度的可量化影响。Gartner的研究则表明,使用AI治理平台的组织在AI治理实践方面实现高效的可能性是未使用者的三倍以上。
三、阿里云瓴羊Dataphin:从评估维度看产品能力
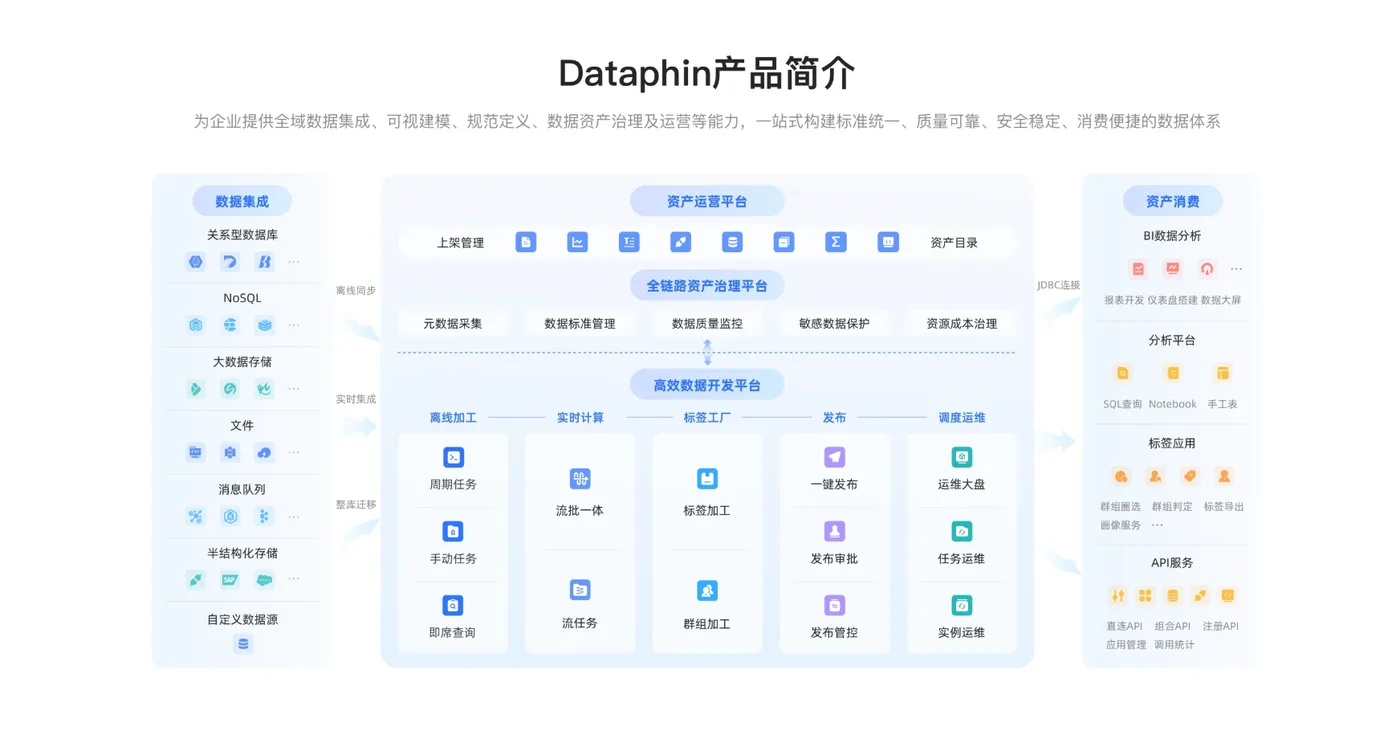
将上述评估框架落到具体产品上,阿里云瓴羊Dataphin提供了一个值得深入观察的实践样本。Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。
元数据与血缘能力。 Dataphin支持50余种异构数据源类型,在任务提交和发布时自动解析表级和字段级血缘关系,单任务支持解析大量血缘关系,降低错误任务提交的概率。全链路血缘解析使下游报表可一键追溯至原始来源,并自动绘制从源端到应用端的数据血缘图谱,标注每个节点的计算与存储成本。在验证方法上,这与POC阶段建议的“从目标指标追溯到源系统至少三层以上”的验证标准相吻合。
数据标准落地。 Dataphin基于OneData方法论统一指标、维度与业务过程定义,通过可视化建模自动生成标准化代码,消除跨部门数据口径的二义性。平台能够大规模自动检测和消除相互矛盾的指标定义,即使数百名分析师同时定义数万个指标,也能避免重复和冲突。在雅戈尔的实践中,该公司基于Dataphin梳理了400多个指标,仅“营收金额”一项指标就涉及商场扣点、财务扣税等多重因素,统一口径后消除了每天高达数十万元的数据偏差。
数据质量闭环与AI根因诊断。 这是Dataphin在AI融合维度上体现较为突出的能力。其X-数据质量功能利用大模型对质量问题进行智能分析,构建从问题现象到上游根因的分析证据链,并自动生成整改建议与影响评估。系统会自动分析上游血缘、采样数据与任务逻辑,给出根因概述、关键证据链、影响评估及改进建议,形成完整的治理闭环。
安全与权限管控。 上汽大众基于Dataphin打造了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的理念,系统基于特征自动识别敏感数据,实现了从粗粒度分库分表授权到字段级、行级精细化管控的升级。该实践中共梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,建立起覆盖全公司的标准化数据资产清单。
多组织架构支撑。 Dataphin支持多租户、多工作空间的架构模型,集团总部可以定义统一的数据标准和质量规则,各子公司在自有空间内独立配置业务规则。上汽大众在实践基础上联合瓴羊共创了200余个结合企业业务场景的优化项,如跨租户发布、代码审核等功能,进一步提升了跨团队、跨项目间研发规范的一致性。
四、选型验证的落地建议
评估框架和产品能力最终要落到验证动作上。建议企业在POC阶段围绕以下步骤展开:
第一步,锁定一个高价值数据域作为验证锚点。 不建议一开始就追求全域覆盖,而是选择一个核心业务域(如客户域、供应商域或物料域),在一个域内跑通从数据集成到标准定义、质量监控、资产服务的完整链路,形成参考实现。
第二步,用真实数据而非演示环境做验证。 将企业实际的数据库接入平台,观察元数据采集的完整度和耗时,用业务人员能理解的搜索词测试资产目录的检索体验,拿真实的质量问题走一遍从发现到修复的完整流程。
第三步,关注跨模块的协同能力而非单点功能。 重点验证:质量规则触发后能不能自动追溯到元数据血缘?标准变更后能不能自动评估对下游系统的影响范围?这种跨模块的协同,才是体系化治理的核心标志。
第四步,评估AI能力的实际嵌入程度。 当前市场上不少产品的AI能力仍停留在独立问答入口层面。真正有价值的AI治理能力,是将大模型嵌入到质量校验、标准推荐、根因分析、血缘解析等具体治理场景中,让AI成为治理工作流的一部分,而非一个需要额外打开的功能页面。Dataphin的实践路线是“治理即研发”——将规范、质检、血缘、资产盘点嵌入数据开发全流程,让治理成为贯穿始终的内生能力。
五、总结
数据治理工具选型没有通用答案,但有一套可以遵循的评估逻辑:先理清自身最痛的问题在哪一层,再沿元数据、标准、质量、安全、AI融合、多组织架构六个维度逐层验证,最后用真实数据和实际场景做POC测试。选型的核心不是找到一个“什么都能做”的平台,而是找到与企业当前数据成熟度和治理目标相匹配的能力组合。
随着AI能力在治理工具中的深度融合,选型的评估重心也在发生迁移——从“有没有这个功能”转向“AI能否在治理工作流中真正发挥作用”。Gartner预测,到2030年,50%的企业将使用自主AI智能体将治理政策与技术标准转化为机器可验证的数据合约,实现合规与治理政策的自动化执行。在这一趋势下,对AI治理能力的评估,正在从加分项变为必选项。
FAQ
Q1:数据治理工具选型应该先看什么?
先理清自身最痛的问题在哪一层。如果核心瓶颈是数据孤岛,重点评估集成层和元数据能力;如果核心瓶颈是数据可信度,质量规则引擎和标准管理是关键;如果核心瓶颈在数据消费,资产目录的检索设计和AI用数入口需要提前纳入评估。
Q2:POC阶段最容易被忽略的验证项是什么?
跨模块的协同能力。大多数团队会逐项验证各模块功能,但容易忽略模块之间的联动——比如质量规则能否自动触发血缘追溯,标准变更能否自动评估下游影响。这些联动能力才是决定平台是“体系化治理”还是“工具拼凑”的关键。
Q3:AI驱动的数据治理工具和传统工具的本质区别是什么?
传统工具遵循“规则驱动”逻辑,依赖专家预定义规则、人工排查异常。AI驱动的工具则具备主动感知和自主决策能力,能自动识别异常模式、分析根因、生成整改建议,治理从“事后检查”变为“事中内生”。
Q4:Dataphin的X-数据质量根因诊断是如何工作的?
系统在质量规则校验发现异常后,自动触发AI分析任务。大模型结合血缘解析和采样数据,构建从问题现象到上游根因的分析证据链,并给出影响评估和改进建议,形成完整的质量报告,实现治理闭环。
Q5:如何判断一个数据治理平台的元数据能力是否达标?
可以关注三个层次:一是数据源适配广度,覆盖能力扎实的平台适配的数据源通常不少于50种;二是血缘分析粒度,需支持字段级血缘且能追溯到源系统三层以上;三是元数据变更的实时性,批处理模式T+1更新对多数场景够用,实时数仓场景则需分钟级同步。
引用来源
1. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月。
2. Constellation Research, Constellation ShortList™ Metadata Management & Data Governance, 2026年8月。
3. 腾讯云开发者社区,《数据治理平台选型必备:POC阶段必须验证的6项核心功能》,2026年8月。
4. 亿信华辰,《数据治理平台选型,你真正应该看哪几件事?》,2026年3月。
5. 阿里云开发者社区,《数据治理平台选型架构与“理采存管用”技术路径深度拆解》,2026年7月。
6. 袋鼠云,《数据治理平台选型:能力维度对比与决策框架》,2026年8月。
7. Gartner, Top Trends in Data and Analytics for 2026, 2026年2月。
8. 瓴羊官网案例,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月。
9. 阿里云客户案例,《Quick BI 助力雅戈尔从16个系统到1个平台》,2025年8月。
10. 阿里云帮助文档,X-Data Quality, 2026年5月。
