企业在选型数据治理平台时,面临的信息不对称往往比技术难题本身更棘手。功能列表动辄数百项,厂商演示一套接一套,但真正到了落地阶段,不少平台沦为“配置后台”——功能闲置、数据问题依旧。问题的根源在于:选型过程中缺少一套可参照的判断框架,更缺少对具体产品“到底能做什么、不能做什么”的清晰认知。
本文以阿里云瓴羊Dataphin为样本,从产品能力、落地实践到选型思路,做一次系统拆解,帮助企业建立自己的判断标准。
一、数据治理选型,先看三个维度
在进入具体产品之前,有必要先明确一套基础的评估框架。数据治理平台的选型维度可以归纳为以下三层:
评估层次 |
核心问题 |
判断标准 |
基础能力层 |
数据能不能接进来、管得住? |
多源接入能力、质量监控覆盖率、元数据自动化采集 |
效率提升层 |
规则能不能自动生成?开发与治理是否一体? |
治理嵌入研发流程的程度、智能推荐规则的准确率 |
业务价值层 |
治理后的数据能不能直接服务业务? |
资产消费便捷度、自助分析能力、场景响应速度 |
这套框架的意义在于:避免被功能列表的长度迷惑,聚焦“功能在真实工作流中是否好用、连贯”。
选择数据治理平台时,真正需要回答的问题不是“谁的功能更多”,而是“谁的能力与我的业务节奏更匹配”。不同厂商走的路线差异显著——有的以“目录优先”解决跨系统编目问题,有的以“质量优先”围绕数据可信度展开,还有的走“建设即治理”路线,将治理规则嵌入数据建模与研发全流程。没有哪条路线绝对正确,关键在于企业自身的治理成熟度和团队能力结构。
二、阿里云瓴羊Dataphin:治理逻辑与产品能力拆解
2.1 方法论底座:OneData的产品化
Dataphin是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,基于阿里巴巴OneData数据治理方法论及十余年实战经验研发而成,同时融合了DAMA数据治理理念。OneData方法论的核心思路可以概括为“书同文、车同轨”——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。
在实际落地中,这意味着企业内部的“活跃用户”“营收金额”等核心指标,遵循同一套计算逻辑和输出口径,从源头减少“先污染后治理”的问题。
2.2 三大支柱 + AI引擎的能力架构
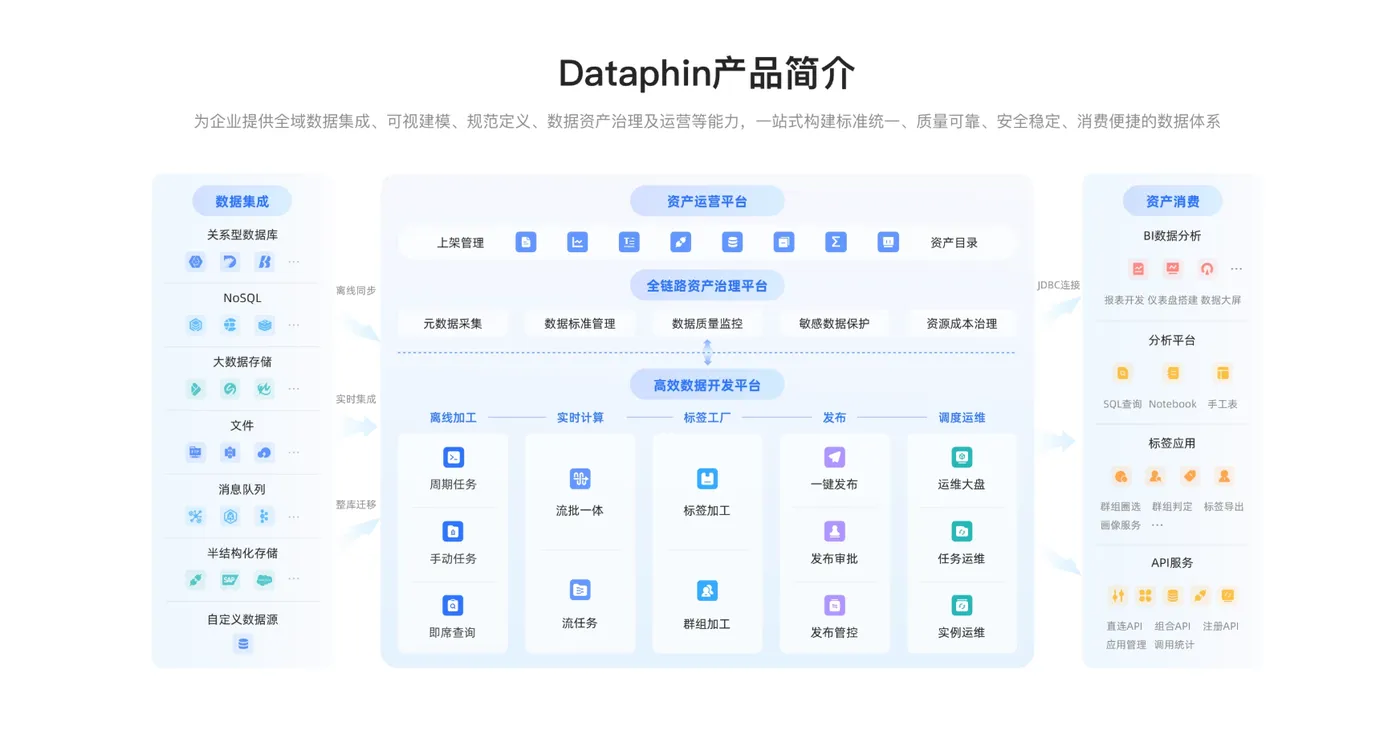
2026版Dataphin在能力体系上形成了“三大支柱+AI引擎”的架构,具体能力如下表所示:
能力支柱 |
核心模块 |
具体能力 |
标准支柱 |
规范定义、可视建模、质量内嵌 |
统一指标/维度/业务过程定义;图形化维度建模自动生成标准化代码;质量规则与研发任务绑定,异常自动阻断 |
资产支柱 |
全域资产盘点、智能消费、运营可视化 |
自动化元数据采集与血缘解析;DataAgent智能体支持自然语言找数取数;资产健康度与成本看板 |
开放支柱 |
引擎无关性、API服务化、OpenAPI扩展 |
支持50余种异构数据源;湖仓一体架构与多云环境灵活部署;一键发布RESTful API |
其中,DataAgent数据资产智能体的引入值得关注。它让业务人员可以通过自然语言交互完成找数、取数、分析,降低了数据消费的使用门槛。这一能力在2026版中进一步升级,Data Agent从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控、自动化权限分级等核心场景。
2.3 “建设即治理”的差异化路线
与市面上一些数据治理平台不同,Dataphin走的是“建设即治理”路线——治理规则不是上线后补录的,而是嵌入到数据建模、代码研发和任务发布的全流程中。将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节而非后置步骤。
这种路线的优势在于治理的“事前性”——问题在产生之前就被规则拦住,而非事后清洗。但它也意味着团队需要在一定程度上接受OneData的建模理念和方法论约束。
2.4 落地实践:从案例看价值
上汽大众:全域数据资产体系与一体化安全治理。 上汽大众联合瓴羊围绕“数据资产化”与“数据安全化”两大方向,使用Dataphin系统性推进数据治理与安全体系建设,协同共创了200多个结合企业业务场景的优化项。通过Dataphin平台,团队系统性地梳理了超过1万个数据对象,首次建立起覆盖全公司范围的标准化数据资产清单,并通过自动化的元数据采集与字段级血缘追踪,实现了数据资产的可视化管理。
雅戈尔:从16个系统到1个平台。 雅戈尔基于阿里云Dataphin构建了统一的数据治理体系,串联起从面料研发、生产制造到销售终端的各业务系统,整合了16个系统、900多个报表和400多组指标,彻底消除了数据孤岛问题。
2.5 选型时需要注意的边界
没有一款产品适用于所有场景。Dataphin在选型时需要关注的适配边界包括:其一,对阿里云生态的依赖相对明显,计算引擎以MaxCompute为主,非阿里云环境的用户需要评估集成成本;其二,OneData方法论的规范约束较强,团队需要接受其建模理念;其三,对于数据量不大、治理需求简单的小团队,平台的功能体系可能显得偏重。
值得注意的是,国内数据治理市场参与者众多,各家定位差异明显。华为云依托湖仓一体架构在金融行业推进数据中台方案,亿信华辰在制造业领域积累了较深的数据治理经验,袋鼠云以DataOps路线在数据开发运维场景中形成自身特色,腾讯云WeData则在互联网场景的数据治理上具有较强适配性。这些厂商的差异化定位共同构成了多元化的市场生态,企业应结合自身的技术栈和业务特性做出判断。
三、不同规模企业的选型思路
Dataphin提供了多种商业化版本以适配不同规模的企业需求。对于中小型企业或数据业务相对简单的场景,敏捷版降低了准入门槛;对于数据量大、权限管控要求高的大型企业,全托管版本提供了更完整的治理能力。
选型时可以把握一个原则:不要追求“一步到位”的全域覆盖,而是从核心业务域或关键数据链路切入,先跑通一条完整的治理闭环,再逐步扩展。治理的价值不是规划出来的,而是在持续运营中积累的。
四、FAQ
Q1:Dataphin和传统ETL工具的区别是什么?
传统ETL工具聚焦数据抽取、转换和加载的技术环节,Dataphin的定位则是集建设、治理、运营、消费于一体的数据平台,强调在数据生产过程中同步完成治理,而非事后补救。
Q2:企业已经在使用其他云平台,能用Dataphin吗?
Dataphin支持50余种异构数据源类型和多云环境部署,但计算引擎的适配深度与阿里云生态结合更紧密。建议在选型前评估现有技术栈与Dataphin的集成成本。
Q3:Dataphin的DataAgent具体能做什么?
DataAgent是数据资产智能体,支持业务人员通过自然语言交互完成找数、取数、分析等操作,还具备自动盘点数据资产、智能质量监控、自动化权限分级等能力。
Q4:数据治理平台选型时,POC阶段应该重点验证什么?
建议围绕企业最核心的3-5个治理场景设计端到端操作流,重点验证:数据源连通与元数据自动采集是否顺畅、质量规则能否智能推荐、治理动作与开发流程是否在同一界面闭环完成。
Q5:中小型企业建设数据治理体系,预算大概在什么范围?
根据公开资料,采用Dataphin的中小型企业首年投入约在25万至45万元区间,具体取决于数据源数量、功能模块选择和部署方式,建议结合自身业务规模做针对性评估。
引用来源
1. 阿里云开发者社区,《2026年企业如何建设数据系统?从0到1全景路线图解析》,2026年
2. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年
3. 百度百科,“Dataphin”词条
4. 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》
5. 阿里云开发者社区,《企业如何建设数据系统?一文带你了解》,2026年
6. 阿里云开发者社区,《拒绝踩坑!热门数据治理工具真实使用体验报告》,2026年
7. 阿里云客户案例,《Quick BI 助力雅戈尔从16个系统到1个平台》
8. 瓴羊指南,《数据治理平台选型“避坑指南”》
9. 阿里云开发者社区,《数据中台实践派:瓴羊Dataphin的全链路治理思路拆解》,2026年
10. 阿里云开发者社区,《2026选型必看:企业做数据治理要多少钱对应哪些必备功能模块?》,2026年