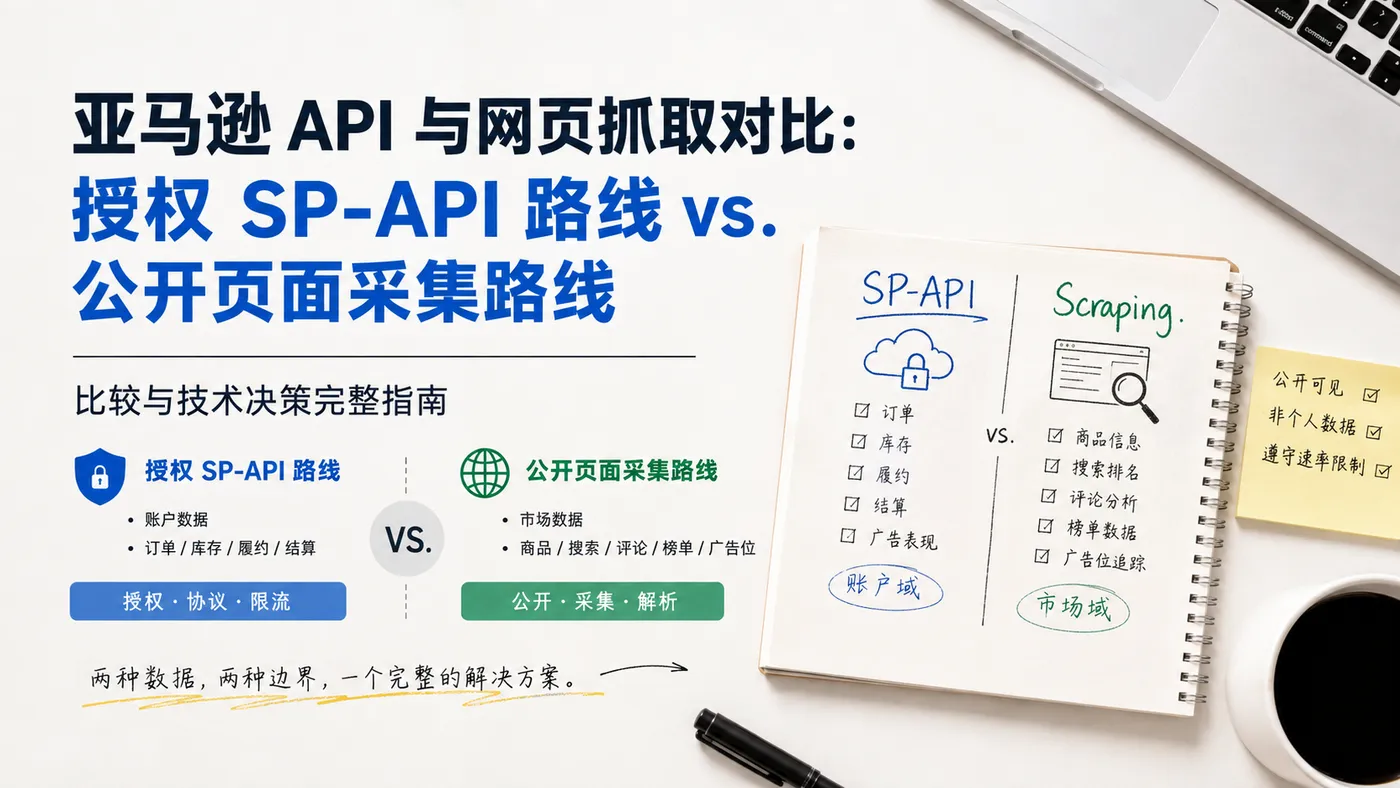
如果你的 Amazon 数据需求同时包含"自家订单库存"和"竞品市场价格",那你就必须同时面对两条数据通道:官方 SP-API 与公开页面采集。
这不是选型失误,而是数据域决定的必然结果。官方接口只覆盖账户域,公开采集只覆盖市场域,两者几乎不重叠。
问题是:两条通道的工程特性完全不同——一个受令牌桶限流约束,一个受反爬策略约束;一个有稳定的官方字段契约,一个会随页面改版漂移。把它们塞进同一个管道而不做隔离,出问题是迟早的事。
这篇讲的就是怎么设计这个双通道管道:接入层怎么收敛、限流队列怎么做、质量门禁监控什么。
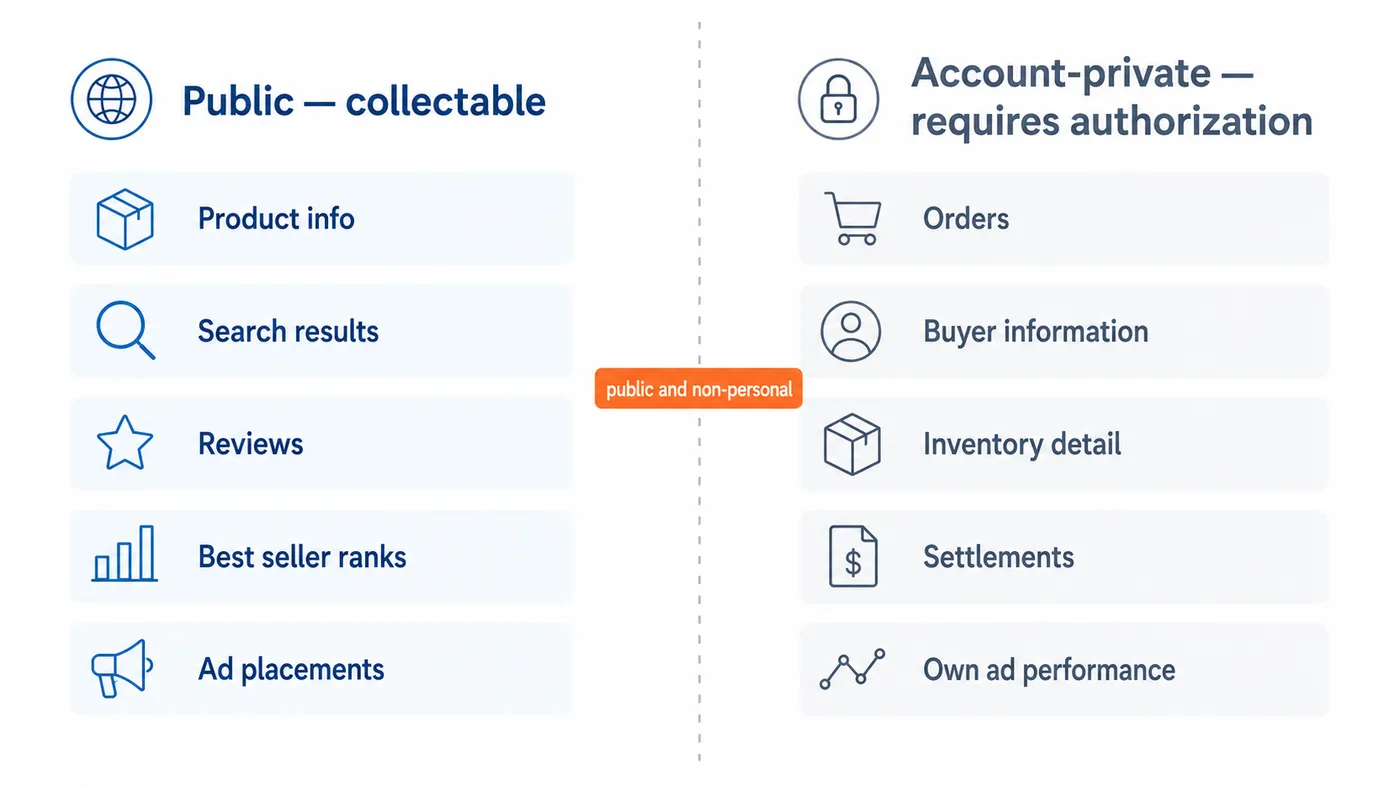
一、先按数据域分流,不要按偏好选型
在设计管道之前,先明确一件事:路线由数据属性决定,不由偏好决定。
| 数据类别 | 属性 | 通道 |
|---|---|---|
| 商品事实(标题、价格、评分、变体、BSR) | 公开可见 | 公开采集通道 |
| 搜索与广告(关键词、位次、广告类型、素材) | 公开可见 | 公开采集通道 |
| 评论内容(评分、正文、日期、变体归属) | 公开可见 | 公开采集通道 |
| 榜单与类目 | 公开可见 | 公开采集通道 |
| 订单与履约 | 账户私有 | SP-API 通道 |
| 买家信息 | 账户私有 + 个人数据 | SP-API(PII 受限角色) |
| 库存与结算 | 账户私有 | SP-API 通道 |
| 自家广告表现 | 账户私有 | SP-API 通道 |
判断标准只有一条:公开可见、非个人 → 可采集;登录可见、含个人信息 → 必须走授权接口。
拿不准的,默认按更严格的一侧处理。
一个典型的公开页结构化结果如下,全部为公开非个人字段:
{

  "asin": "B0CXYZ1234",
  "marketplace": "amazon.com",
  "title": "Stainless Steel Insulated Water Bottle, 32 oz",
  "price": {
    "current": 34.99, "currency": "USD", "listPrice": 44.99 },
  "rating": {
    "average": 4.6, "count": 12847 },
  "bsr": [ {
    "category": "Sports & Outdoors", "rank": 128 } ],
  "availability": "In Stock",
  "sponsored": false,
  "fetchedAt": "2026-08-30T10:22:41Z"
}
注意 fetchedAt 与 sponsored 这两个字段:前者是时间序列与事后追溯的前提,后者决定"关键词排名"这个指标会不会被广告污染。两者都建议设为核心必需字段。
二、SP-API 通道:限流是设计约束,不是异常
即使官方接口免费,限流也会转化为工程复杂度。这是最容易被低估的一点。
SP-API 采用令牌桶(token bucket)限流模型:每个 API 操作有独立的请求速率(rate)与可用配额(quota),配额按速率持续恢复。部分操作的初始配额与恢复速率还会随卖家业务规模浮动。
三个必须注意的点:
不同操作的配额互相独立。这是最常见的设计失误——按"总调用量"估算一定错。getOrders 和 getInventorySummaries 是两套桶,要分别建模。
被限流不是异常,是正常状态。高频轮询时限流几乎必然发生,正确做法是排队 + 退避重试,而不是让它抛异常炸掉任务。把 429 当成 error 打进告警,会让告警系统彻底失去意义。
数值会变。具体配额与速率会随官方调整变化,实施前请在官方文档核对当前值。我见过团队照着一年前的文档设计配额,上线第一天就被限流打满。
实现上有两个细节值得注意:
优先使用服务端 Retry-After 头,比自定义退避算法更准确。没有该头时再用指数退避加随机抖动,避免多实例同时重试造成尖峰。
只对 429 和 5xx 重试。400/401/403 这类是参数或授权问题,重试一百次也不会成功,只会浪费配额并掩盖真正的错误。
另外,令牌桶是进程内的。如果服务多实例部署,全局速率会是单实例的 N 倍,需要在网关层做全局限流或按比例降低单实例速率。
三、公开采集通道:blocked 必须在内容层检测
这是公开采集侧最贵的一个坑。
被拦截的页面同样返回 HTTP 200。验证码页、机器人检测页、未渲染完成的页面,状态码全是绿的。如果管道只判断状态码,这些脏数据会带着"成功"的标签流进数据仓库。
我们踩过一次:大约六分之一的响应其实是拦截页,监控全绿,等发现的时候,两周的定价建议已经建立在空数据上了。
所以必须在内容层做检测,不能只看状态码。实践中有几个信号:
- 页面中出现 captcha、robot check 等特征文本
- 页面长度异常短(正常商品页通常远大于此)
- 关键字段(如 price、title)解析结果为空
三者任一命中即判为 blocked,而不是伪装成成功数据入库。
另外,公开采集侧的并发要保守。过高的请求频率不只是技术问题,也会把性质从"读取公开信息"推向"干扰服务"。建议在任务层做硬速率上限,避免某个失控任务把整体频率拉高。
四、统一接入层:两条通道在这里收敛
管道的核心是这个接入层。它做四件事。
字段映射。把两条通道的字段映射成同一套内部模型。上游任一侧变化,错误在这一层被拦截,不会扩散到下游。
类型强校验。今天 price 是数字,明天变成带货币符号的字符串,下游聚合直接报错。接入层做强制类型校验,把这类问题挡在门外。
必需字段校验。把核心必需字段清单配置化(建议 15–30 个),缺失即判该条记录不可用。清单建议包含 fetchedAt(时间序列与追溯前提)与 sponsored(否则排名指标被广告污染)。
失败分类。三类失败必须分别计数:
| 类型 | 含义 | 归属通道 | 修法 |
|---|---|---|---|
throttled |
被官方限流 | SP-API | 调配额、排队与退避 |
blocked |
200 但非正常页面 | 公开采集 | 降并发、换策略 |
incomplete |
解析成功但缺字段 | 两侧共有 | 补覆盖、找供应商 |
这三类的修法完全不同。混进一个 error 日志,你根本判断不出该去调配额、降并发还是补字段。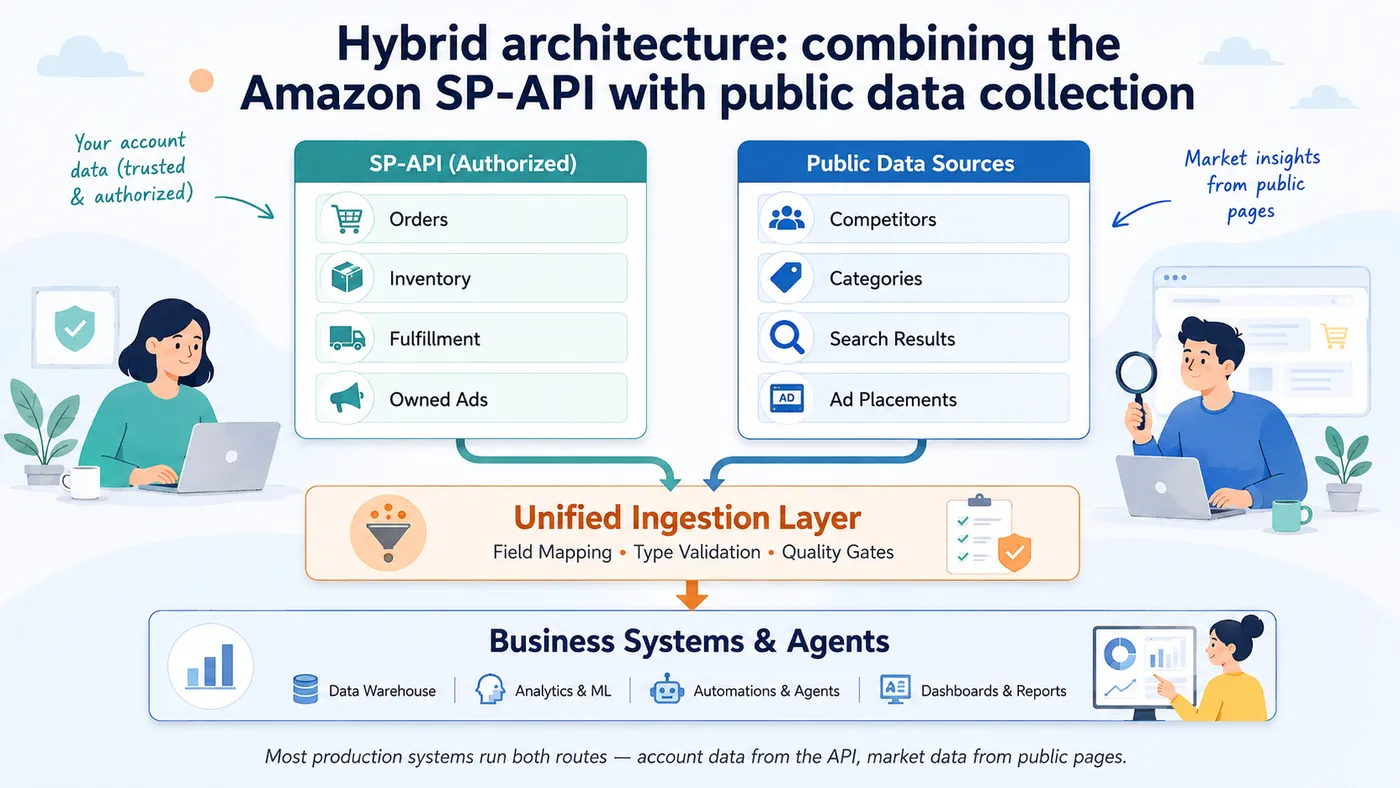
五、完整数据流
把组件串起来,一次典型的数据接入流程:
- 调度层按冷热分层生成任务——头部商品高频,长尾低频
- 分发按数据域走:账户域进 SP-API 客户端,市场域进采集客户端
- SP-API 客户端先向令牌桶取令牌再调用,遇 429/5xx 按
Retry-After或指数退避重试 - 采集客户端发起请求,先做 blocked 内容层检测,再做解析
- 统一接入层做字段归一、类型校验、失败分类
- 写入双表:当前快照表 + 历史变更表
- 三类失败分别计数,推到监控看板
第 6 步的双表结构值得强调。只存快照会丢失所有趋势信息,而趋势恰恰是亚马逊数据最有价值的部分——你知道竞品今天降价意义不大,知道他过去 30 天降了 4 次才有价值。
第 7 步的监控不是可选项。三类失败的占比趋势能提前暴露问题:blocked 上升说明反爬收紧,throttled 上升说明配额不够,incomplete 上升说明覆盖退化。等到业务方来问"数据怎么不对",通常已经晚了。
六、成本与频率的权衡
管道建好之后,成本主要来自频率。
不是所有字段都需要同样的新鲜度。品牌、类目、变体维度几乎不变;价格、库存、Buy Box、广告位、BSR 变化频繁。混在一个频率里刷新,是成本失控最常见的原因。
建议三层:
高频(分钟到小时):价格、库存、Buy Box、广告位、BSR。这些字段延迟一小时,结论可能就失效了。
日级:新增评论、评分变动、卖家列表、榜单排名。趋势信号,看的是周与月。
周级或按需:品牌、类目、变体维度、图片与 A+ 内容。
实践中的一个经验:头部 20% 的商品贡献 80% 的决策价值。把这部分设为高频、长尾设为低频,整体成本通常能压掉一半,而业务影响很小。
另一点:在公开数据侧比较单价时,单位必须是每千条可用业务记录,不是每千次请求。失败、被拦截、缺字段的返回全都照样计费。举例:单价 1.2 美元/千次、成功率 92%、完整率 88%,可用比例约 81%,真实成本约 1.48 美元/千条可用记录;单价 1.6 美元、成功率 99%、完整率 98%,真实成本约 1.65 美元。价格表上便宜 25%,实际只便宜 10%。
七、上线前自查清单
- [ ] 需求清单已逐条标注"账户域"或"市场域"
- [ ] SP-API 各操作的限流已按官方文档核对,并按操作分别建模
- [ ] 令牌桶 + 退避重试已实现,只对 429/5xx 重试
- [ ] 公开采集侧已实现 blocked 内容层检测
- [ ] 统一接入层已做字段映射与类型强校验
- [ ] 核心必需字段清单已配置化,含
fetchedAt与sponsored - [ ] 三类失败分别计数并已接监控看板
- [ ] 双表存储:当前快照 + 历史变更
- [ ] 冷热分层调度已按业务价值配置
- [ ] 字段白名单与速率上限已固化进代码(而非只在文档里)
最后一项最容易被跳过,也最有用。合规从"靠人自觉"变成"靠代码保证",能避免"文档说不能采、代码里一直在采"这种最难收拾的情况。
八、一个常见误区:把配额不够当成数据质量问题
在双通道管道里,有一类问题特别容易被误判。
现象:某个字段的数据量突然下降,或者某个时段的数据出现空洞。
第一反应通常是"数据质量退化了",于是去找供应商、查解析、翻日志。但真正的原因经常是配额——SP-API 侧令牌桶被打满,任务排队等待,最终部分任务超时被丢弃。
区分方法很简单:看三类失败的占比。如果 throttled 占比上升而 blocked 与 incomplete 保持平稳,那就是配额问题,不是数据问题。
对应的修法完全不同:配额问题要做冷热分层(降低整体请求量)、错峰调度,或申请更高配额;数据问题才需要去查覆盖与解析。两者搞混,排障时间会成倍拉长。
另一个相关误区是把 429 当成 error 告警。限流在高频轮询下是正常状态,不是故障。把 429 直接打进告警,会让告警系统彻底失去意义——团队很快会学会忽略它,然后某天真正的故障来了也没人看。
正确做法是把 429 记为 throttled 计数并观察趋势,只有当占比持续超过阈值(比如 5%)时才触发告警。
这两点看起来小,但在实际运维中能省下大量时间。很多"数据质量问题"查到最后都是配额调度问题——而如果失败分好了类,五分钟就能定位。
小结
双通道管道的核心是三件事:
- 按数据域分流,而不是按偏好选型——官方管账户域,公开采集管市场域
- 统一接入层收敛,做字段映射、类型强校验、三类失败分类
- 限流当设计约束、blocked 在内容层检测,两者都不能只看状态码
最后提醒一句:这套管道的价值不在于技术多复杂,而在于把不确定性关进了可观测的笼子。限流会被计数,拦截会被识别,缺字段会被记录——剩下的才是真正可以放心给业务用的数据。管道做得好不好,看的不是峰值吞吐,而是出问题时多久能定位。
产品上,市场域的公开对象可用 Pangolinfo Amazon Scraper API与 Pangolinfo Amazon Review API覆盖;Agent 直连走 Pangolinfo Amazon Data MCP。可从 Pangolinfo 控制台 拿 Key 实测,或查看 Pangolinfo Amazon Data MCP 文档.