
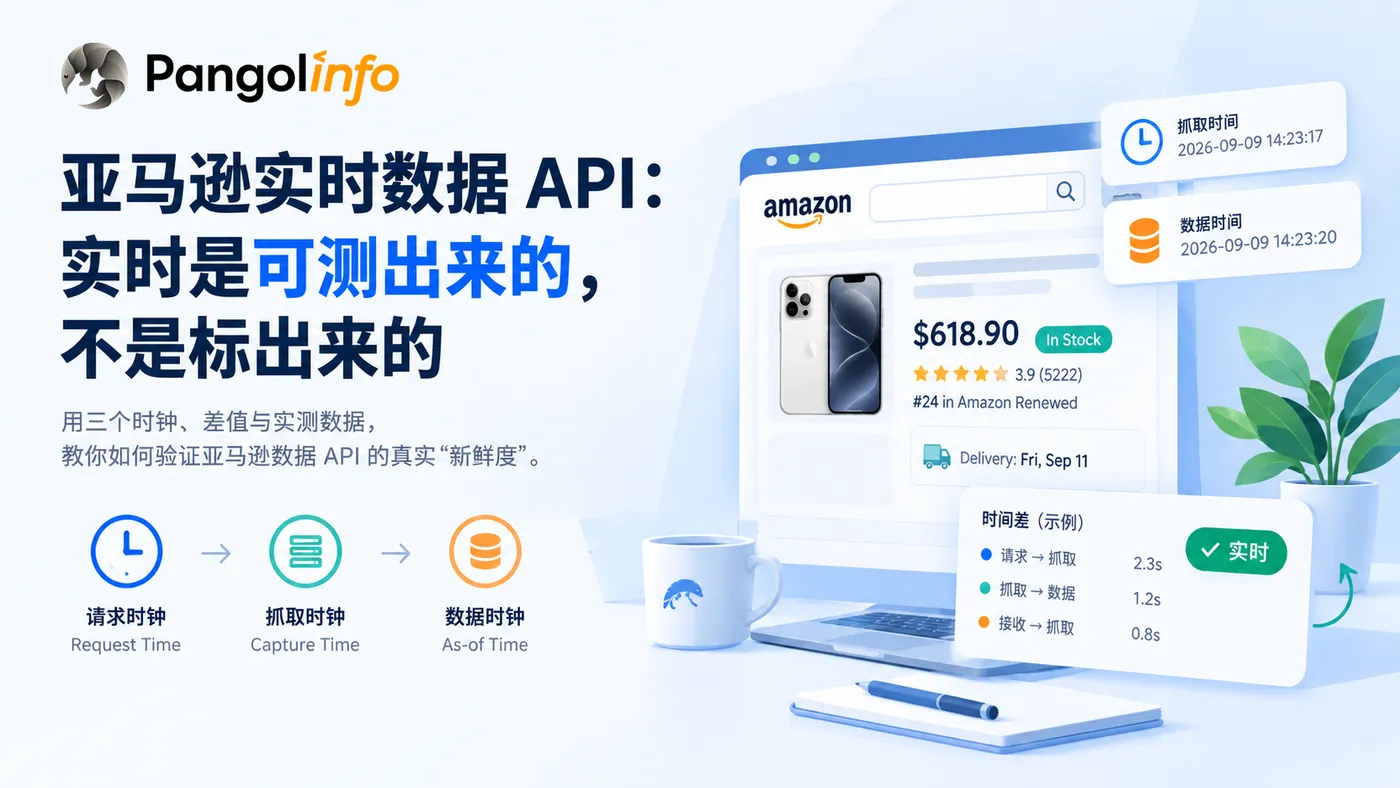
供应商首页几乎都写着"实时"。采购方在签约前面对的是同一句营销词,和一份看不出年龄的数据。本文给技术负责人和数据负责人一份可执行的过滤器:一份七问问卷,加一份 48 小时验证协议。两者的目的相同——把"实时"从形容词变成可测的差值。
一、"实时" 是一个可以测出来的差值
判断一个亚马逊数据 API 是否真实时,靠一条减法:你发出请求的时刻,减去源页面被抓取的时刻。
- 秒级 = 实时;
- 分钟到小时 = 近实时;
- 天级 = 快照。
这条差值之外,所有"实时"都是主观描述。采购合同里写"供应商提供实时数据",等于没有约定任何可验收的门槛。
三时钟模型
请求落到响应,中间有三只不同的钟:
| 时钟 | 含义 | 谁拥有 |
|---|---|---|
| 请求时钟 request time | 你的程序发出请求的时刻 | 调用方 |
| 抓取时钟 capture time | 服务端抓取源页面的时刻 | 服务端 |
| 数据时钟 as-of time | 源页面上数据本身的时刻(如配送日、促销倒计时) | 亚马逊页面 |
供应商的文档与响应暴露出哪几个时钟,决定你能验证到什么程度。最弱的情况是:响应里只有请求时钟和数据时钟,抓取时钟缺失。这时你能算出"数据本身显示的时间",但永远算不出"这份数据在服务器上活了多久"。
没有抓取时间戳的响应,无法自证它的新鲜度。这是后面所有验证方法的起点:要么让供应商把抓取时间放进响应头或 payload,要么你自己用页面对照去反推。把三行结构化日志记下来,数据年龄就从一句空话变成可监控的指标:
// 运行期新鲜度审计:每次返回记三行结构化日志
type FreshnessLog = {

  asin: string;
  request_time: string;          // 请求时钟:程序发请求时刻
  received_at: string;           // 接收时刻:拿到响应的时刻
  captured_at: string | null;    // 抓取时钟:服务端抓取时刻(缺失则为 null)
  stale_ms: number | null;       // 数据年龄:received_at - captured_at
};

function logFreshness(row: FreshnessLog) {

  if (row.captured_at === null) {

    // 无抓取时间戳时的退路:每日抽检价格活跃 ASIN 与页面对照
    console.warn(`[freshness] captured_at 缺失,启用页面对照: ${
     row.asin}`);
    return;
  }
  const stale = Date.parse(row.received_at) - Date.parse(row.captured_at);
  if (stale > SCENE_TOLERANCE_MS) {

    console.error(`[freshness] 数据超龄 ${
     stale}ms,超过场景容忍度`);
  }
}
二、先按对象定新鲜度,再谈合同
把"实时"当作一个统一标签,是采购里最常见的误判。同一个 ASIN 上的字段,天然分在不同新鲜度档位:
- 分钟级:价格、库存状态、Buy Box 归属、优惠券。价格战场景下一天可变动几十次,"Only 1 left" 可能两次轮询之间就翻转。
- 小时级:BSR 排名、广告位分布、关键词排名。
- 日级:评论数、评分、上架日期、变体结构。
- 周级:评论内容、产品描述、图片。
正确的监控设计是分层的:价格按分钟级轮询,BSR 按小时,评论按日。把刷新周期写成你自己的配置——"价格每 10 分钟一次、评论每天一次"——比合同里写"供应商提供实时数据"可执行得多。
三、官方天花板:你的要求不该高于亚马逊自己
定 SLA 前,先看亚马逊官方数据模型的边界:
- Notifications API 的价格变动类事件带聚合窗口,仅 5 分钟与 10 分钟两档可选,窗口内的中间事件被丢弃,只发首尾状态。即官方推送在价格事件上也是"近实时 + 有损采样"。
- SP-API 多数 report 按请求生成,更新周期为小时到天。
- 广告数据按日更新。
- 公开订阅工具的口径是 24–72 小时。
由此得出一条采购红线:你对供应商的新鲜度要求,不应高于官方数据模型的上限。要求"价格秒级、广告分钟级"在数据源层面没有支撑,写进合同也只是无法验收的空话。
四、一份真实样本教我们的事
2026-09-09,对 ASIN B0CMZFCQ6D(iPhone 15 Pro 512GB Renewed)做了两次实测,间隔约 20 分钟,结果如下:
- 价格:两次均为
$618.90; - 库存:
"Only 1 left in stock - order soon."两次一致; - BSR:两次均为
#24 / #15 / #21; - 配送:两次均返回
deliveryTime = Friday, September 11(请求日为 9/9 周三)。
三个结论值得单独拎出来:
结论一,配送字段是服务端现算的"活性探针"。 9/9 请求返回 9/11 送达,说明这个字段是亚马逊根据请求日动态算出来的活数据。若数据来自缓存,配送日会对不上请求日,或保持一个可疑的固定值。类似字段还有优惠券有效期、促销倒计时——它们不需要你额外验证,本身就是免费的活性探针。
结论二,单件库存两次一致不是缺陷。 两次抓取间隔内 listing 稳定,所以数值不变。监控要的正是"变化能被抓到",稳定状态下的重复是预期结果。
结论三,这份返回没有抓取时间戳字段。 你能看到字段值,却看不到服务端何时抓的。"活了多久"没有直接暴露。验证要么靠供应商给时间戳,要么靠你自己的页面对照探测。
五、延迟测量四个坑,与缓存冒充实时的五个特征
延迟四坑
- 只测总耗时不分段:要把 DNS、TCP、TLS、首字节、总耗时分开看。
- 不分冷热连接:复用会话约 15ms,新建约 53ms 量级,两者混在一起会失真。
- 只看平均不看分布:要同时看中位与 p95。
- 单一地域测:跨两地跑,分离网络段与服务端耗时。
要记住:响应快不等于数据新。缓存能在 100ms 返回昨晚的数据,而一次真实的亚马逊抓取往往要跨数秒。
缓存冒充实时五特征
- 时间戳停滞或缺失;
- 易变字段不随真实页面变化(连抓 3 次 + 浏览器页面对照,同一邮区);
- 响应毫秒级复现且无网络波动(强防护页面十次个位数毫秒更像缓存);
- 时间相关字段自相矛盾(配送日、倒计时对不上请求日);
- 不同端点新鲜度不一致且不说清(商品详情实时、评论一周批量导入却不注明)。
命中任意一个就值得警惕。把上面的检查写成可重复脚本,加上时间戳记录,每家候选就能产出一张可比对的表。
六、场景 SLA 表:先确认自己在哪一行
下面这张表要反着读——先确认自己的场景在哪一行,再决定为数据年龄付多少钱:
| 场景 | 关键字段 | 可容忍数据年龄 | 建议抓取频率 |
|---|---|---|---|
| 动态定价 / 价格战 | 价格、Buy Box、优惠券 | 分钟级 5–15 分钟 | 热战 ASIN 5–10 分钟,普通 30–60 分钟 |
| 缺货 / 补货告警 | 库存、上架状态 | 分钟到小时 | 核心竞品 15–30 分钟,长尾按小时 |
| 广告位 / 关键词排名 | SP 广告位、自然排名 | 小时级 | 每 1–6 小时 |
| BSR / 类目排名 | BSR、榜单 | 小时到日 | 每 4–24 小时 |
| 评论评分监控 | 评论数、评分、新内容 | 日级 | 每天 1–2 次 |
| 选品 / 市场结构 | 类目、变体、长期价格曲线 | 日到周 | 每周快照 |
真实监控按数据活跃度分级:ASIN 分热、温、冷三档,热档最短间隔、冷档拉长;整体不要比官方推送(5 分钟聚合)更激进。
七、供应商七问:采购问卷主干
下面七问是给候选供应商的问卷模板,也是合同条款的来源。前两条决定数据多新,中间三条决定能否按时到达、坏数据是否混入,后两条定责任。
| # | 问题 | 判读要点 | 写入合同 |
|---|---|---|---|
| 1 | 每次请求是否触发一次实时抓取?还是取上次批量结果? | 要一句话说清频率,不接受"实时"二字 | 数据模型与刷新机制条款 |
| 2 | 响应头或 payload 是否带服务端抓取时间?字段名? | 没有抓取时间戳,客户无法自证数据年龄 | 响应结构 / 抓取时间戳字段约定 |
| 3 | 延迟分布:中位与 p95、哪个地域、并发多少、最近 30 天数据 | 拒绝某天截图,要 30 天连续分布 | SLA 延迟指标定义 |
| 4 | 成功率口径:200 但字段缺失算成功吗?拦截页算吗? | 给字段填充率统计,不只给状态码 | 成功率 / 填充率验收口径 |
| 5 | 是否接受采购期用探测脚本对价格 / 库存做实时性对照 | 拒绝对照 = 不敢上测试台 | 验收期探测权限条款 |
| 6 | 限流与降级:并发上限、超限排队 / 丢弃 / 缓存兜底?缓存兜底时数据年龄? | 缓存兜底会悄悄变旧,必须写明年龄上限 | 限流与降级边界条款 |
| 7 | SLA 粒度:月 / 周 / 天?赔付口径? | 粒度决定赔付触发频率 | SLA 与赔付条款 |
第一问:数据模型
为什么问——"实时"这个词在合同里没有验收意义。你要问的是机制:每次请求是否触发一次对亚马逊源页面的抓取,还是返回上一次批量任务的结果?频率是多少?
答案怎么判读——如果对方说"我们有缓存层加速",要追问缓存兜底生效时返回的数据年龄上限。缓存本身不是问题,不说明年龄才是问题。
写进合同哪里——数据模型与刷新机制条款,写明"请求即抓取"或明确的批量刷新周期。
第二问:抓取时间戳
为什么问——这是三时钟模型里缺失的那只钟。没有它,数据年龄无从算起。
答案怎么判读——响应头或 payload 里是否有服务端抓取时间,字段名是什么。没有的话,客户只能用页面对照反推,成本高且不可靠。
写进合同哪里——响应结构约定,强制要求返回体包含抓取时间戳字段,否则视为未交付可验收的实时数据。
第三问:延迟分布
为什么问——单点延迟截图可以挑最好的一天给你看。
答案怎么判读——要中位与 p95,注明测量地域与并发数,且是最近 30 天数据,不是某天精选。
写进合同哪里——SLA 延迟指标定义,把 p95 与测量条件写死,避免日后口径漂移。
第四问:成功率口径
为什么问——HTTP 200 不代表数据可用。返回 200 但价格字段为空,报表会显示"采集完成 100%"而价格列全空。把这类问题展开,可回看同系列文章:亚马逊数据 API 返回 200 却是空字段的八处缺口;Node.js 侧从跑通到每天稳定交付的工程结构,这篇给了完整分层。
答案怎么判读——200 但字段缺失算不算成功?拦截页算不算?要字段填充率统计,而非只看状态码。
写进合同哪里——成功率与填充率验收口径,明确填充率低于阈值即视为未达标。
第五问:探测对照权限
为什么问——敢不敢让你的脚本在采购期对价格、库存做实时性对照,是区分两种服务商的分水岭。
答案怎么判读——拒绝对照的供应商,等于拒绝把"实时"放上测试台。
写进合同哪里——验收期探测权限条款,约定你有权在签约前用脚本验证字段新鲜度。
第六问:限流与降级
为什么问——高并发下供应商怎么处置,直接决定你大促期间拿到的是新数据还是旧缓存。
答案怎么判读——并发上限多少?超限是排队、丢弃,还是缓存兜底?缓存兜底时数据年龄多老?
写进合同哪里——限流与降级边界条款,写明降级路径与降级时的数据年龄上限。
第七问:SLA 粒度与赔付
为什么问——SLA 按月统计,意味着一次数小时的劣化可能被月均值稀释掉。
答案怎么判读——粒度是月、周还是天?赔付触发口径是什么?
写进合同哪里——SLA 与赔付条款,粒度越细对采购方越有利。
八、48 小时采购验证协议(四阶段表)
问卷筛完,再用一份 48 小时协议做实测。四阶段如下:
| 阶段 | 时间窗 | 动作 | 产出 |
|---|---|---|---|
| 基线 | 0–6h | 20 个 ASIN 覆盖价格活跃电子产品 + 日用消耗品 + 自己类目,跨 ≥2 市场,每对象类型抓一次,记录成功 / 填充率 / 有无抓取时间戳 | 基线填充率表 |
| 重复与对照 | 6–24h | 5 个价格活跃样本每 30 分钟抓一次 + 每小时浏览器页面对照,记录分歧时刻与方向 | 分歧事件表 |
| 并发与延迟 | 24–30h | 10 次冷热连接中位 / p95 + 5/10/20 并发各压一分钟,看延迟随负载上浮斜率 | 延迟分布表 |
| 变化捕获演练 | 30–48h | 盯一个真实会变的事件(促销开始 / Buy Box 易主 / 库存归零),测"事件发生 → API 返回反映"间隔 | 事件→可见最长间隔 |
无事件就顺延——没捕获过变化的验证等于没验证。最终产出三张表:延迟分布、字段填充率、事件到可见的最长间隔。
九、新鲜度定价逻辑与责任边界
把上面几张表合起来,得到一条采购原则:为数据年龄付费,不为"实时"这个词付费。
新鲜度定价按档拉开:分钟级价格数据单价高于小时级 BSR,日级评论最便宜。你为哪一行场景付钱,就该按那一行的 SLA 表谈判容忍年龄。把"价格每 10 分钟、评论每天一次"写进配置,比笼统的"实时"能省下一批为无效新鲜度支付的预算。
责任边界落在 SLA 粒度与赔付口径上。延迟指标要写 p95 与测量地域;填充率要写阈值;降级路径要写数据年龄上限;赔付要写触发粒度(按天优于按月)。这四条合起来,才是"实时"从营销词变成可追责承诺的地方。
十、把实时放上测试台
两种服务商的分界很清楚:一种愿意把"实时"放上测试台,给你抓取时间戳、接受探测脚本、按七问作答并把答案写进合同;另一种只把"实时"写在首页,问卷答不出、时间戳不给、对照不接。采购前用本文的七问加 48 小时协议跑一遍,区别会在第一张分歧事件表里显形。
愿意把实时放上测试台的服务商,通常采用请求即抓取模型:一次请求触发一次对亚马逊源页面的实时抓取,返回结构化 JSON,请求路径不设独立缓存层;公开口径中位延迟约 3 秒(含一次完整抓取与解析)、成功率约 99%、日调用量 3000 万以上。把第十节的协议拿去测,测完再决定。
如果你打算按这套方法评估候选,可先看中文接入页了解字段与调用方式:Pangolinfo 亚马逊数据采集 API;文档站另有完整字段与抓取时间戳说明:Pangolinfo 文档.
你的供应商合同里,写的是"提供实时数据",还是写明了抓取时间戳字段与填充率阈值?欢迎在评论区说下你是怎么验证自家数据年龄的。




