
面向数据治理、数据质量与合规团队。技术实现细节见配套的技术篇,本文聚焦字段口径的定义与治理。
一、字段级的静默失真,是数据治理的一个盲区
多数数据治理框架关注四类问题:完整性(有没有缺值)、唯一性(有没有重复)、一致性(同一实体在不同系统的表示是否统一)、准确性(值是否正确)。
在亚马逊商品数据这个场景里,最危险的问题落在第四类和第三类的交界处,而常规校验全部失效。
举例。同一件 iPhone 15 Pro Renewed 512GB,白色与黑色,父商品(parentAsin)都是 B0GP8D698X。两者的 strikethroughPrice 字段结构一致、类型一致、均非空:
// B0CMZFCQ6D(White 512GB)
"strikethroughPrice": {
    "key": "List Price", "value": "$649.00" }

// B0CMZ5KBNS(Black 512GB)
"strikethroughPrice": {
    "key": "Typical price", "value": "$629.95" }
List Price 是厂商建议零售价,Typical price 是亚马逊统计的 90 天成交中位数。
完整性校验通过(两个字段都有值)。类型校验通过(都是字符串)。唯一性校验通过(两条记录,两个不同 ASIN)。但把这两个数字放进同一个「原价」列做折扣率分析,结果没有意义——因为它们的分母定义不同。
这就是字段级静默失真:所有常规数据质量规则都绿灯,业务结论是错的。
二、治理第一步:建立字段口径字典
治理的起点不是写校验规则,而是先把字段口径写清楚。一份可用的亚马逊商品数据字段口径字典,每行至少要包含五个维度:
| 维度 | 说明 | 示例 |
|---|---|---|
| 字段路径 | 唯一标识 | strikethroughPrice.key |
| 数据类型 | 存储类型 | string |
| 可空性 | 必填非空 / 必填可空 / 可选 | 可选(键可能不出现) |
| 业务口径 | 这个字段到底指什么 | 折扣基准类型,取值见枚举 |
| 取值枚举 | 已知取值与含义 | List Price=厂商建议零售价;Typical price=90 天成交中位数 |
第四、第五列是治理的核心,也是多数团队缺失的部分。 只记录字段名和类型,等于只记录了「有个叫这个名字的东西」,而没有记录「它是什么」。
按这个标准,把字段按四类对象分组:
| 对象 | 代表字段 | 更新节奏 | 治理策略 |
|---|---|---|---|
| 身份 | asin parentAsin title brand |
几乎不变 | 主键,强校验非空 |
| 交易 | price strikethroughPrice inStock shipper |
分钟级 | 需口径字典 + 语义校验 |
| 评价 | star rating ratingDistribution |
日级 | 聚合与明细分开建模 |
| 规格 | attributes productOverview variantDetails |
周级 | 稀疏存储 + 填充率监控 |
三、变体漂移:一致性问题的特殊形态
数据治理里的「一致性」通常指同一实体在不同系统间的表示一致。在亚马逊场景下,还有一个更棘手的一致性维度:同一父商品的不同变体之间,字段表示不一致。
实测同一 parentAsin = B0GP8D698X 下的两个变体:
| 字段 | White 512GB | Black 512GB | 治理问题 |
|---|---|---|---|
strikethroughPrice.key |
List Price | Typical price | 口径不一致 |
strikethroughPrice.value |
$649.00 | $629.95 | 基准不同 |
inStock |
Only 13 left in stock - order soon. | In Stock | 自由文本未枚举化 |
shipper |
(空字符串) | Amazon | 空值语义未定义 |
attributes 长度 |
48 | 49 | 键集合漂移 |
Display Resolution Maximum |
2556 × 1179 pixels | 2556x1179 pixels | 同值不同表示 |
product_dims |
6 x 4 x 2 inches | 5.77 x 2.78 x 0.33 inches | 精度口径不同 |
price |
$628.95 | $628.95 | 一致 |
parentAsin |
B0GP8D698X | B0GP8D698X | 一致,可分组 |
rating |
(5258) | (5258) | 一致,父级共用 |

同一父商品(B0GP8D698X)两个变体的字段级 diff:折扣基准、attributes 长度与分辨率写法三组差异
十行里六行存在治理问题。三条治理动作是明确的:
① 折扣基准必须分列存储。 不要只取 strikethroughPrice.value,要把 key 一起存下来并按基准类型分列。否则跨变体的折扣率汇总没有统一分母。
② attributes 必须按稀疏映射存储。 两个变体分别是 48 和 49 条属性,差的键是 Model Series。不能用固定列宽展开,否则每新增一个属性键就要改表结构。正确做法是纵向键值表(asin + attr_key + attr_value),配一张属性键字典表。
③ 规格文本必须在入库前归一。 分辨率字段一个用全角乘号 ×(U+00D7)一个用小写 x。同规格不同字符串,会让去重和聚类出错。
import re

def normalize_resolution(value: str) -> str:
    """2556 × 1179 pixels 与 2556x1179 pixels 归一后必须相等。"""
    v = value.replace("\u00d7", "x").replace("\u00d7", "x")
    v = re.sub(r"\s+", "", v.lower())
    return v.replace("pixels", "")
这不是供应商的数据质量缺陷。 亚马逊页面本身就是两种写法,任何采集方都会原样带出。归一化是下游治理的职责,不能外包给数据源。
四、口径陷阱:同名不同义与同义不同名
治理字典最容易漏掉的是两类命名问题。
4.1 同名不同义
size 字段。 手机类目下 size = "8 GB",指的是运行内存;同返回里 Memory Storage Capacity = "512 GB" 才是存储容量。把 size 当容量入库,所有容量筛选错一个数量级。
而且这个字段的语义跨类目不稳定:服装类目下 size 是尺码,手机类目下被复用为内存规格。同名不同义的字段必须在字典里标注「语义随类目变化」并给出分品类映射表。
同一个 JSON 里的两个 size。 顶层 size = "8 GB"(内存),variantDetails[].size = " 512GB "(容量,带首尾空格)。同一个词指导两个不同概念,字典里必须用完整路径区分。
4.2 同义不同名
RAM Memory Installed(attributes)与 RAM Memory Installed Size(productOverview)。 同一个概念,两处键名差一个词。如果按字段名建索引,会得到两列内容相同但列名不同的数据。
Memory Storage Capacity 与变体选项 512GB。 同一个容量,一处带单位带空格("512 GB"),一处不带空格("512GB")。比较前必须归一。
治理动作:建立实体词映射表,把同义不同名的字段归到同一个业务实体下,明确哪一个是主字段、哪些是别名。
五、评论归属:一个被普遍误读的口径问题
这条对做口碑分析、VOC、评论挖掘的团队是必读项。
请求 ASIN B0CMZFCQ6D 的评论,返回 10 条,逐条检查 asin 字段:
B0CMYXFK3R ×2 | B0CMZL2TJ9 ×3 | B0CMZBXYWX ×1 | B0CMZ7L14T ×1
B0CRJRNTNS ×1 | B0CMZ9KS3G ×1 | B0CMZCGQDK ×1
─────────────────────────────
distinct ASIN = 7
等于请求 ASIN 的条数 = 0
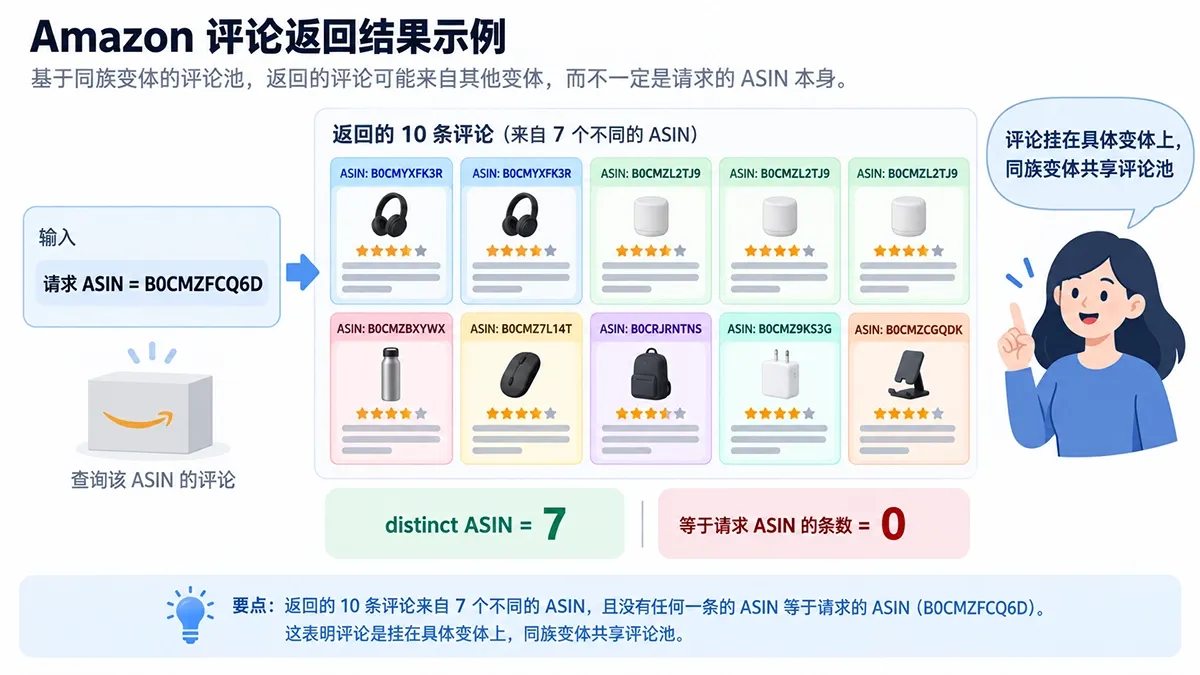
请求 ASIN B0CMZFCQ6D,返回 10 条评论分属 7 个变体,等于请求 ASIN 的条数为 0
十条评论没有一条属于请求的商品。
这不是接口缺陷,是亚马逊的评论归属机制:评论挂在具体变体上,同一商品族的变体共享评论池,页面聚合展示。 每条评论的 asin 标明它实际来自哪个变体。
治理层面的三个结论:
① 评论表的关联键必须是 reviews[].asin,不是请求 ASIN。 用请求 ASIN 归档评论,会把 7 个变体的反馈混到一件商品上。
② 族级口碑与变体级口碑是两个口径,必须在指标定义里写清楚。 品类口碑分析按 parentAsin 聚合;想知道「256GB 版本的用户抱怨什么」必须按 asin 过滤。
③ 请求 512GB 拿到的主要是其他变体的反馈。 这是本样本的实际情况——如果你直接用这批评论做该变体的产品改进决策,样本代表性是有问题的。这类口径风险必须在数据字典里标明。
六、空值语义:三种空,三种治理动作
空值治理的原则是:区分「不适用」「未知」「取不到」,给每一种定义确定的下游行为。
| 形态 | 实测例子 | 语义 | 治理动作 |
|---|---|---|---|
| 键在,空串 | shipper: ""、itemHighlights: "" |
本次未取到 / 该变体不适用 | 保留原值,标记未知,计入填充率分母 |
| 键在,null | reviews: null、importantInfo: null |
该模块当期不存在 | 跳过,不计入填充率分母 |
| 键缺失 | 部分商品的规格字段 | 卖家未填写 | 走默认值,计入填充率分母 |
关键治理原则:不要把空串归一成 null。
两者信息量不同:shipper 为空串是「这次没取到」,reviews 为 null 是「这个页面当前无评论模块」。混同后你既无法统计字段填充率,也无法在填充率下降时区分是采集问题还是页面变化。
6.1 inStock:自由文本必须枚举化,且「未知」不能默认有货
inStock 是自由文本,实测取值 " Only 13 left in stock - order soon. " 与 " In Stock ",首尾都有空格。形态包括「有货」「仅剩 N 件」「暂时缺货」等多种表达。
import re

def normalize_stock(raw: str | None) -> tuple:
    """把 inStock 自由文本归一为 (是否有货, 剩余件数)。

    (None, None) 表示无法判定,调用方须按「未知」处理,
    不得默认当作有货。
    """
    if not raw or not raw.strip():
        return None, None
    text = raw.strip().lower()
    if "left in stock" in text:
        m = re.search(r"(\d+)\s+left in stock", text)
        return True, int(m.group(1)) if m else None
    if "in stock" in text:
        return True, None
    if "unavailable" in text or "out of stock" in text:
        return False, 0
    return None, None   # 未知形态,保留原文待人工确认
治理红线:识别不了的库存文案必须标记为「未知」,绝不默认有货。 缺货误判为有货会让补货告警失效;有货误判为缺货会造成无效紧急调价。两种误判都有业务代价。
6.2 空值的变体差异是正常的
同一件商品,一个变体 shipper 有值、另一个为空;一个变体 inStock 是「仅剩 13 件」、另一个是「有货」。这属于正常差异,不是数据质量问题。
治理系统的告警必须把「字段为空」和「字段值异常」分开统计,否则会因为某个变体天然为空而持续误报。误报是数据质量体系失效的主要原因——告警一多,就没人看了。
七、版本治理:字段变化必须可预警
字段会变。亚马逊从 2026-07-27 起把商品标题拆成 itemName(主体)与 itemHighlights(后缀);属性键集合会调整;页面改版会引入新字段形态。供应商侧同样会调整返回结构。
如果字段变化只能靠业务侧发现数据不对来暴露,治理就是滞后的。 需要建立主动监控。
两步。
第一步,字段快照。 定期采样,记录每个字段的路径、类型、可空性、出现频次,存成基线。
第二步,schema diff。 对比基线与新样本,输出新增、消失、类型变化清单。
import json

def flatten(obj, prefix: str = "") -> dict:
    """把嵌套 JSON 压平成 {路径: 类型} 映射,数组记为 [] 结尾。"""
    out = {
   }
    if isinstance(obj, dict):
        for k, v in obj.items():
            out.update(flatten(v, f"{prefix}.{k}" if prefix else k))
    elif isinstance(obj, list):
        out[prefix + "[]"] = "array"
        for item in obj[:5]:
            out.update(flatten(item, prefix + "[]"))
    else:
        out[prefix] = type(obj).__name__
    return out

def schema_diff(baseline: dict, current: dict) -> dict:
    added   = sorted(set(current) - set(baseline))
    removed = sorted(set(baseline) - set(current))
    retyped = sorted(p for p in set(baseline) & set(current)
                     if baseline[p] != current[p])
    return {
   "added": added, "removed": removed, "retyped": retyped}
退出码设计成「有差异即返回 1」,让流水线标记为「待人工审阅」而不是直接失败。 字段新增通常无害;字段消失或类型变化可能破坏解析,需要人判断。治理工具是预警系统,不是拦截器——拦截过多会导致团队绕过它。
配套的还有填充率监控:对采样集统计各字段非空比例,低于历史基线即告警。这是上游批量字段丢失时最早出现的信号,比等到解析报错早得多,也比等到业务侧反馈早得多。
八、成本分级:按字段容忍延迟确定采集频率
治理决策最终要落到成本上。
| 字段类别 | 变化速度 | 建议频率 | 单商品日请求量级 |
|---|---|---|---|
| 交易(价格/库存/Buy Box/优惠券) | 分钟级 | 分钟级轮询 | 千级 |
| 评价聚合(评分/评分数) | 日级 | 每日 | 1 |
| 评论内容、规格 | 周级 | 每周 | 0.1 |
| 身份 | 几乎不变 | 一次采集长期复用 | ≈0 |
分层是唯一合理的答案。 按最高频率采全部字段是浪费,按最低频率采全部字段会让关键决策失准。
容忍延迟的定义是治理工作的一部分,不只是技术参数。 你的业务能接受多旧的价格数据?这个问题的答案来自业务方,不能由技术方单方面设定。定完之后再选采集频率,最后才是比价——顺序反了,比出来的价格没有意义。
我们在 Pangolinfo 做这类采集用的是 Amazon Scraper API,返回结构化 JSON,覆盖本文四类字段,支持按指定邮区采集以匹配地区价格与配送。字段填充率作为独立指标监控,与成功率分开统计——成功率全绿也可能掩盖数据大面积缺失的状态。
填充率之外还要盯住数据是什么时候的。我们之前写过一套分辨响应延迟不等于数据新鲜、区分实时抓取与缓存快照的工程方法:接口响应快只说明链路快,不说明值是当下的。两个指标各自独立,缺一个就会留下盲区。
评论明细用 Pangolinfo Amazon Review API,可按星级、排序、媒体类型筛选。
治理的核心不是加校验规则,而是先把口径定义清楚。 口径不清,规则越严误报越多;口径清了,规则自然简洁。



