你写下的第一行代码往往长这样:
const res = await fetch("https://...");
const data = await res.json();
console.log(data);
本地跑通,JSON 落盘,眼看就能交付了。
但当你把这套逻辑挂上定时任务,让它每天凌晨按点覆盖十几个市场、喂给下游报表和广告系统,中间会冒出一类本地调试时从不会出现的问题:请求在凌晨三点大规模超时,重试把账号打进限流,重复入库让报表数字翻倍,TLS 指纹被风控识别后整批返回空字段。
本文围绕亚马逊数据 API Node.js 落地,把「一次能跑通」推进到「每天稳定交付」需要补的工程结构拆成三条主线:网络指纹、并发模型、幂等重跑。每条线都给出可运行的 TypeScript 片段,结尾给出把这几件事一次性外包出去的口径。
一、从 await fetch 到每天交付,中间隔着什么
fetch 解决的是「把一次 HTTP 往返跑完」。生产负载要解决的是「在不可靠的网络、会变化的风控、会重复的调度里,持续产出可被下游信任的数据」。
三件事挡在路上:
- 网络指纹:你发出的握手和请求头,是否被识别成脚本而非浏览器。
- 并发模型:开了 HTTP/2 之后,并发上限的含义整段改变,限并发和限速率是两件事。
- 幂等重跑:失败之后是重跑一遍,还是往库里塞进重复行。
这三条线处理不好,脚本白天偶尔能跑,凌晨定时任务一启动就崩。下面逐条拆开。
「每天按点交付」还要求两样前面没提的东西:其一是调度本身——cron 触发、任务幂等可被重跑、失败有退避;其二是可观测——凌晨三点崩了,你得在早上八点前知道崩在哪一层,而不是等报表数字明显不对才察觉。后面会专门讲可观测,先回到三条主线。
二、网络指纹:Node 没有 Python curl_cffi 那样的一站式答案
做亚马逊数据采集,请求要像浏览器。浏览器在三个层面留下指纹:TLS 握手(ClientHello 的扩展顺序与加密套件)、HTTP/2 的 SETTINGS 帧、以及运行时的浏览器行为。Python 那边有 curl_cffi,默认就能按 Chrome 的握手去伪装。Node 生态没有这样开箱即用的默认答案,于是大家在各路库之间挑。
got-scraping 已停更,且只改请求头
got-scraping 是过去常被提到的方案,但它已停止维护,且它只改写请求头,从不碰 TLS 握手。卡在 JA3/JA4 的拦截它本来就解决不了——请求头再像,握手阶段已经暴露了。
impit 的 HTTP/2 SETTINGS 露了馅
impit 基于 Rust 的 reqwest + rustls。它的问题在 HTTP/2 的 SETTINGS 帧:它用的是底层 Rust 库的默认值,缺 HEADER_TABLE_SIZE,还会发送 Chrome 从不发的 MAX_FRAME_SIZE。一句话概括——「声称 Chrome,却在用 Rust 的语法说话」。风控只看 SETTINGS 这一帧就能把它和真实浏览器分开。
2026-08 指纹库基准
下面这张表取自 wreq-js 仓库公开 bench,测量日期 2026-08-06,M 系列 Mac,300 次串行请求对本地服务。2026-08 实测,数值随版本变化,请按你当时的版本重新测。
| 库 | 引擎 | 最新 Chrome | HTTP/2 指纹 | req/s | 冷启动 |
|---|---|---|---|---|---|
| wreq-js | Rust wreq + BoringSSL | 149 | 正确 | 12842 | 7 ms |
| impers | curl-impersonate | 146 | 正确 | 8439 | 16 ms |
| node-wreq | Rust | 149 | 正确 | 6500 | 10 ms |
| impit | Rust reqwest + rustls | 124 | 不正确 | 6710 | 37 ms |
| CycleTLS | Go 子进程 IPC | 未参与 | 未参与 | 未参与 | IPC 开销 |
选型时别只盯吞吐。指纹「正确」这一列比 req/s 重要——指纹错了,高吞吐只是更快地把自己送进拦截。
JA3 与 JA4 的来龙去脉
JA3 是 ClientHello 五字段拼接取 MD5;Chrome 110 之后扩展顺序随机置换,导致 JA3 不稳定,主流风控改用排序后哈希的 JA4。换句话说,握手层面的伪装必须跟着浏览器版本走,停留在旧指纹的库迟早被识别。
会话复用还能省握手成本:会话内复用约 15 ms,单次调用全新握手约 53 ms(量级)。高频采集时,复用会话比每次新建连接划算。
三、并发模型:开了 HTTP/2,并发上限整段改变
undici 两个入口默认值不同
Node 内置 fetch 基于 undici,默认不协商 HTTP/2(官方称实验性、未默认开启),需要显式:
import {
    Agent, setGlobalDispatcher } from "undici";

const dispatcher = new Agent({

  allowH2: true,
  connections: 8,
  pipelining: 0,
  maxConcurrentStreams: 100,
  connect: {
    timeout: 5_000 },
  headersTimeout: 15_000,
  bodyTimeout: 30_000,
});

setGlobalDispatcher(dispatcher);
注意入口差异:全局 setGlobalDispatcher(new Agent({ allowH2: true })) 需要你手动开;而 undici Client 的 allowH2 默认 true。两个入口默认值不同,混用时会踩坑。
maxConcurrentStreams 取代 pipelining
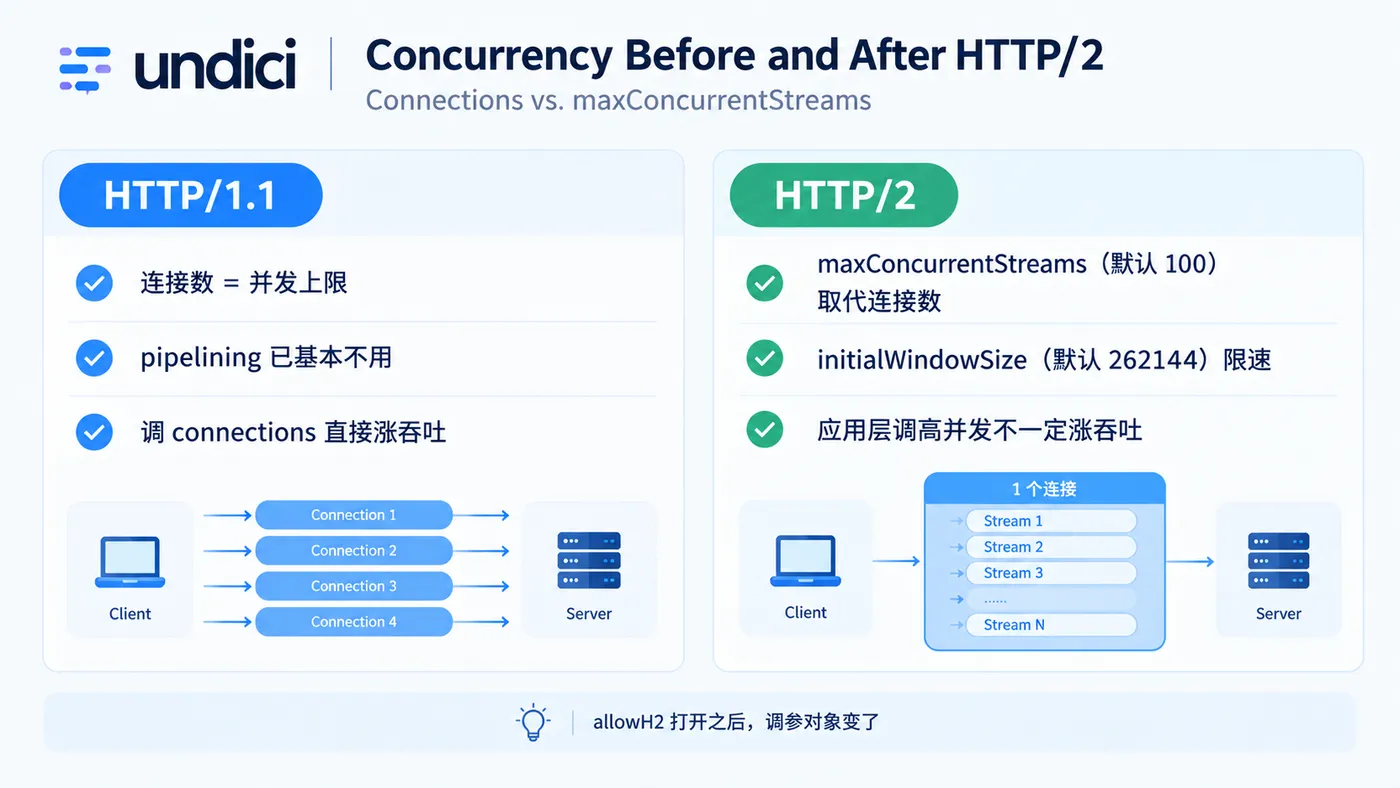
协商成 HTTP/2 之后,单连接并发天花板由 maxConcurrentStreams(默认 100)决定,取代 pipelining;流控窗口 initialWindowSize 默认 262144。这意味着「我开了 8 条连接」不再等价于「我最多 8 个并发」——每条连接上还能并 100 个流。并发上限的算法要重算。
限并发不等于限速率
p-limit(8) 只限并发不限速率。响应 10 ms 时约 800 req/s,响应 5 s 时约 1.6 req/s。差距来自下游延迟,不是你的限流。要守住调用方的预算,得用 p-queue 的 intervalCap 补速率:
import PQueue from "p-queue";

// 每秒最多 4 个,同时最多 8 个在途
const queue = new PQueue({
    concurrency: 8, interval: 1_000, intervalCap: 4 });
concurrency 管「同时在飞几个」,intervalCap + interval 管「单位时间放几个」。两者叠加,才是生产负载需要的节流。
顺带说明 pipelining:那是 HTTP/1.1 的思路,在一条连接上排队发多个请求以省往返。协商成 HTTP/2 之后这条路径被流取代,undici 里把 pipelining 设 0、改用 maxConcurrentStreams 表达并发,概念不要混。同一份配置里既写 pipelining: 0 又写 maxConcurrentStreams: 100,正是把两种模型分清的写法。
四、运行时契约:TypeScript 类型保不住运行时数据
编译期类型检查通过,不等于收到的 JSON 长那样。接口返回空字段、price 是字符串、asin 大小写不对,这些只在运行时出现。用 Zod 的 safeParse 而不是 parse,并在契约之上立一道 P0 断言——P0 字段缺失就当作契约失败,不要带病入库。
import {
    z } from "zod";

const ProductSnapshot = z.object({

  asin: z.string().regex(/^[A-Z0-9]{10}$/),
  marketplace: z.enum(["US", "DE", "JP", "UK"]),
  capturedAt: z.string().regex(/^\d{4}-\d{2}-\d{2}$/),
  contractVersion: z.string().default("2026-09-01"),
  title: z.string().min(1),
  price: z.number().positive().nullish(),
  currency: z.string().length(3).nullish(),
});

const P0_FIELDS = ["title", "price", "currency"] as const;

function assertP0(row: unknown): z.infer<typeof ProductSnapshot> {

  const parsed = ProductSnapshot.safeParse(row);
  if (!parsed.success) {

    throw new Error(`P0 contract violated: ${
     parsed.error.message}`);
  }
  for (const field of P0_FIELDS) {

    const value = (parsed.data as Record<string, unknown>)[field];
    if (value === undefined || value === null || value === "") {

      throw new Error(`P0 field missing: ${
     field}`);
    }
  }
  return parsed.data;
}
覆盖率与填充率分开算
两个指标混在一起会骗人:
- 覆盖率:尝试的 ASIN 里,拿到响应的比例。
- 填充率:拿到响应的行里,P0 字段齐全的比例。
一次「成功」的请求可能返回 200 却空字段。报表会显示「采集完成 100%」,但价格列全是空。把两者分开统计,才能看见真实交付质量。举个例子:某天覆盖率 100%,填充率从 91% 掉到 40%,HTTP 状态码全是 200。只看「成功率」的人会以为一切正常,看填充率的人当天就发现价格列大面积空缺。两个数字一起看,才是真实交付质量。
顺带提醒:TypeScript 的 type 只约束你写代码时的变量,约束不了网络那头吐回来的对象。price 字段文档写的是数字,接口某次改版后返回 "19.99" 字符串,z.number() 会直接判失败——这正是运行时校验存在的理由,类型系统在进程跑起来之后就管不到数据了。我们此前讨论过返回 200 却空字段的八处缺口,可回看同系列文章:亚马逊数据 API 返回 200 却是空字段的八处缺口。
五、分阶段超时与四类失败
undici 的超时是分阶段的,要分别设:connect 5 s、headersTimeout 15 s、bodyTimeout 30 s。一段等连接,一段等首字节响应头,一段等响应体。把它们压成一个总超时,会掩盖「连不上」和「连上了但传输卡住」的区别。
Node 错误名要认全:UND_ERR_CONNECT_TIMEOUT / UND_ERR_HEADERS_TIMEOUT / UND_ERR_BODY_TIMEOUT / TimeoutError(DOMException) / ENOTFOUND / EAI_AGAIN。AbortSignal.timeout(Node 17.3+)和 AbortSignal.any(Node 22+)可用于组合信号。
失败要分四类,每类走不同处置:
- 瞬时:网络抖动、连接超时。可重试,退避后重发。
- 限流:429。按
Retry-After退避,降低速率。 - 拦截:验证码页、空字段、风控跳转。换出口、换指纹后再试,仍失败则标记人工。
- 契约:P0 缺失或结构变化。告警,不要带病入库,等上游修。
async function classify(err: unknown): Promise<"transient" | "rate" | "intercept" | "contract"> {

  if (err instanceof Error) {

    const m = err.message;
    if (m.includes("UND_ERR_CONNECT_TIMEOUT")
      || m.includes("UND_ERR_HEADERS_TIMEOUT")
      || m.includes("UND_ERR_BODY_TIMEOUT")) return "transient";
    if (m.includes("429") || m.includes("Too Many Requests")) return "rate";
    if (m.includes("P0")) return "contract";
  }
  return "intercept";
}
六、幂等重跑:失败之后别产出重复行
定时任务失败重跑时,最容易出的事是同一份快照被写两遍,报表数字翻倍。解决靠主键四要素:asin + marketplace + capturedAt + contractVersion。同一商品同一市场同一采集日同一契约版本,只应有一行。用 ON CONFLICT DO UPDATE 把「插入或更新」合成一个原子操作,重跑安全。
import {
    Pool } from "pg";

const pool = new Pool();

async function upsertBatch(
  rows: z.infer<typeof ProductSnapshot>[],
): Promise<void> {

  const sql = `
    INSERT INTO product_snapshot
      (asin, marketplace, captured_at, contract_version, title, price, currency)
    VALUES
      ($1, $2, $3, $4, $5, $6, $7)
    ON CONFLICT (asin, marketplace, captured_at, contract_version)
    DO UPDATE SET
      title = EXCLUDED.title,
      price = EXCLUDED.price,
      currency = EXCLUDED.currency;
  `;
  const client = await pool.connect();
  try {

    await client.query("BEGIN");
    for (const r of rows) {

      await client.query(sql, [
        r.asin, r.marketplace, r.capturedAt, r.contractVersion,
        r.title, r.price ?? null, r.currency ?? null,
      ]);
    }
    await client.query("COMMIT");
  } catch (e) {

    await client.query("ROLLBACK");
    throw e;
  } finally {

    client.release();
  }
}
大批量时按批次提交,每批带 checkpoint:记下已成功入库到最后一条的游标。进程被 SIGTERM 杀掉后重启,从 checkpoint 续跑,不重头扫已完成的 ASIN,也不漏掉未完成的。
contractVersion 这一列常被忽略,作用在于契约演进。上游把 price 的语义从含税改成税前,旧数据和新数据不能混在同一行被覆盖。把契约版本纳入主键,新旧两份快照并存,下游按自己认的版本取数,迁移窗口里不会互相踩踏。批次大小建议压在数百行一级,单批失败只回滚这一批,不会被一个错误拖垮整夜的采集。
七、优雅停机:先把已取到未入库的刷进去
生产进程会被调度系统发 SIGTERM。直接退出会丢数据。收到信号后置 shuttingDown,跑完在途任务前不再接新活,先把已取到未入库的批次刷写落库,再退出。
import PQueue from "p-queue";

const queue = new PQueue({
    concurrency: 8, interval: 1_000, intervalCap: 4 });

let shuttingDown = false;
const pending: z.infer<typeof ProductSnapshot>[] = [];

process.on("SIGTERM", () => {
    shuttingDown = true; });

async function flush(): Promise<void> {

  if (pending.length) await upsertBatch(pending.splice(0));
}

async function run(asins: string[]): Promise<void> {

  for (const asin of asins) {

    if (shuttingDown) {
    await flush(); return; }
    queue
      .add(() => fetchOne(asin))
      .catch((e) => {
    /* 记录分类后的失败,不要崩溃 */ console.error(classify(e)); });
  }
  await queue.onIdle();
  await flush();
}
fetchOne 内部串起前面几段:复用会话、套分阶段超时、过 Zod 契约与 P0 断言、按分类处置失败、把通过校验的行推入 pending、到批次阈值就 upsertBatch。整套串起来,才是一天能稳定交付的采集作业。
停机信号到来时,在途任务继续跑完,新任务不再接入,待 pending 刷空再退出。这样凌晨被调度系统重启,已取到未落库的数据不会丢,重启后从 checkpoint 续跑,整夜采集不重不漏。
八、可观测性:让凌晨的失败看得见
三条主线都接好后,还差最后一层:出问题时看得见。生产负载的失败大多发生在你睡觉时,等早上看报表才发现,代价已经产生。建议至少埋四类计数:
- 按失败类型分桶:把上一节的
classify结果累加到瞬时、限流、拦截、契约四个计数器,限流忽然飙升说明速率没压住,拦截飙升说明指纹被识别。 - 覆盖率与填充率实时折线:两者都按批次打点,填充率掉而覆盖率稳,典型是风控开始返回空字段,比看 HTTP 状态码更早报警。
- 端到端时延分位:记录从入队到落库的总耗时,p95、p99 比均值更有用,能提前看见下游变慢。
- checkpoint 进度:每批提交后更新游标,进程重启能从断点续跑,也能在仪表盘上看见「今天还差多少没采完」。
这些计数器不必复杂,进程内 Map 加定时上报即可,关键是「按失败类型」和「按覆盖率/填充率」两维要分开。混在一个「成功率」指标里,会掩盖拦截上升、覆盖照旧的事实。
九、把三条主线交出去:一次请求,一份结构化 JSON
自己把指纹、并发、幂等、超时、重试、停机全部做对,工期和运维都不小。Pangolinfo 的方式是把这些一次性包进一次请求:
- 住宅与移动 IP 出口与轮换;
- TLS 与 HTTP/2 指纹对齐到浏览器版本;
- 浏览器指纹一致性;
- 需要时的 JS 渲染;
- 验证码与拦截页的服务端处理与重试;
- 地域与邮区对齐。
以上都不作为加价项单列。你发一个请求,收一份结构化实时 JSON。中位延迟约 3 s、成功率约 99%、日调用 3000 万以上、SP 广告位跨 13 个市场采集率约 91.4%。
如果你打算直接从 Node 接入,看中文接入页了解字段与调用方式:Pangolinfo亚马逊数据采集 API。调用文档参考Pangolinfo开发者指南。
把指纹、并发、幂等交给服务端之后,你的 Node 代码只需要关心一件事:拿到 JSON,过契约,写库,按点跑。
小结
从 await fetch 到每天交付,缺口在三条线:网络指纹(Node 没有 curl_cffi 那样默认答案,got-scraping 停更且只改头不碰 TLS,impit 的 SETTINGS 露了 Rust 馅)、并发模型(allowH2 两入口默认不同,maxConcurrentStreams 取代 pipelining,p-limit 限并发不限速率需 p-queue 补 intervalCap)、幂等(主键四要素 + ON CONFLICT + checkpoint)。再补上 Zod safeParse 与 P0 断言、覆盖率填充率分算、分阶段超时、四类失败分类、优雅停机,采集作业才稳。
要省掉这条工程链,把指纹与重试下沉到服务端,可以用 Pangolinfo 亚马逊数据采集 API 一次请求拿到结构化实时 JSON。