
企业上 Agent,最怕两件事:一是出事不知道谁干的,二是对外(监管/客户)说不清"为什么它动了这笔钱"。本文从企业合规与业务风险视角,讲清楚企业 Agent 权限管理到底该管什么,"人工审批"为什么扛不起治理的责任。
一、企业视角下的真实风险
技术团队看 Agent 权限,关注"能不能拦住错误调用"。企业负责人看同一件事,关注的是三笔账:
- 财务账:一笔错退、一次误改预算,直接就是真金白银。
- 责任账:出事后,能不能说清"谁在什么时候、基于什么、批准了什么"。
- 合规账:监管或客户问"你们的 AI 为什么动了这笔钱",能不能拿出可追溯的证据链。
这三笔账,"加个审批按钮"一个都填不满。审批按钮最多解决"有人点了",解决不了"点得对不对、事后查不查得到"。
二、拆锁:读 / 写 / 资金是合规底线
企业里最常见的权限事故,是一个 token 同时有"读订单"和"发起退款"。技术上叫"权限过大",合规上叫"职责未分离(SoD violated)"。
- 读:查订单、看政策。错了代价≈0。
- 写:改状态、建工单。错了可改回。
- 资金:退款、改预算。错了钱出去了。
合规要求职责分离,技术实现就是三个独立凭证:只读凭证看数据、受限写凭证改状态、资金凭证只在带审批 + 幂等键时调用。这不是过度设计,是审计师会逐项核对的硬指标。
三、把边界写进工具,不写进提示词
企业的 Agent 往往要对接多个内部系统(ERP、CRM、客服台)。每个对接工具在接入时就要声明 scope:
- tool: lookup_refund_policy
  scope: read-only
  market: US
- tool: issue_refund
  scope: fund
  required: [approver_id, idempotency_key]
即使模型被越狱、提示词被改写,issue_refund 仍强制要求审批人和幂等键。边界在工具接入层就焊死,不依赖模型表现。提示词是给人看的,工具接入规范才是企业能审计的事实。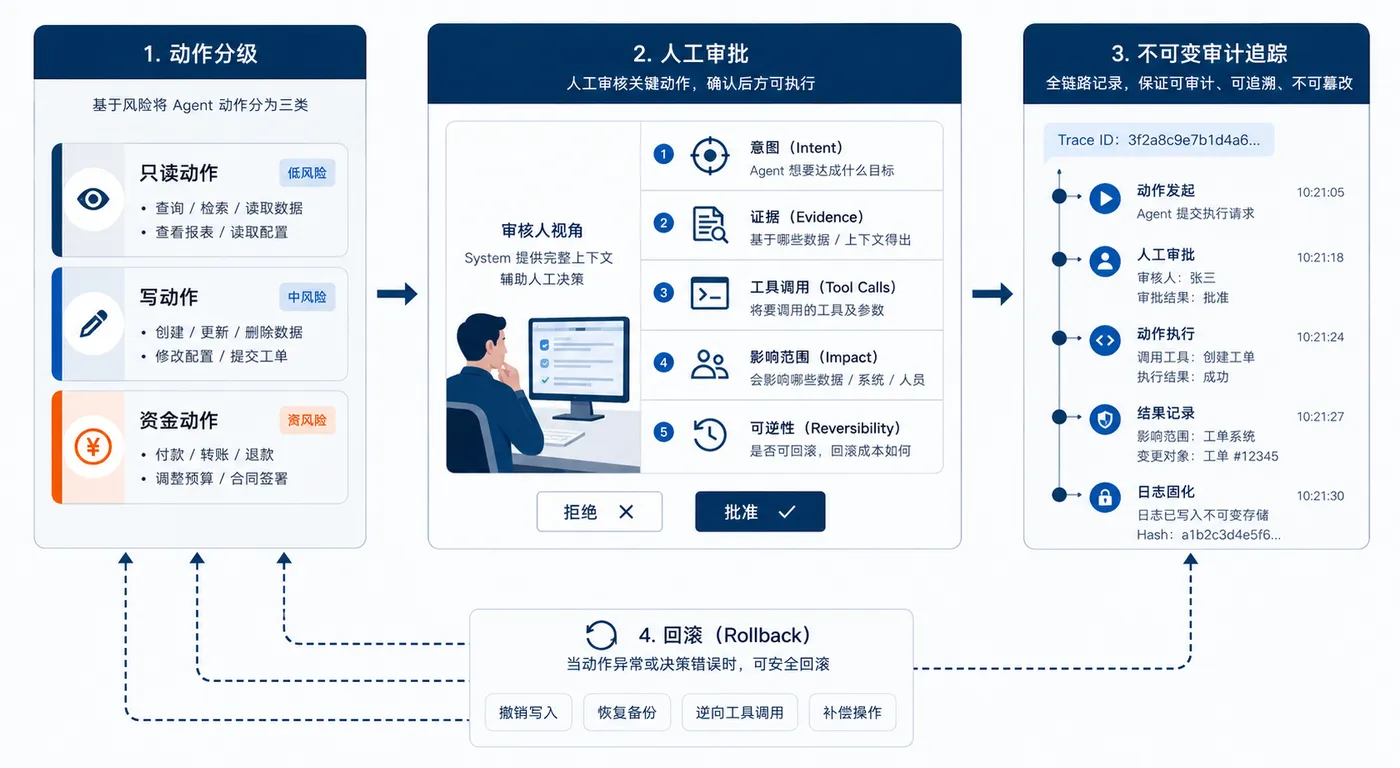
四、分阶段、按动作放开权限
企业节奏更该保守:
- 只读阶段:只发只读凭证,Agent 跑两周,把"拟执行"动作记审计日志,不落库。
- 受限写阶段:逐个动作开写凭证,配单人/双人审批。
- 资金阶段:最后开资金凭证,强制双签 + 幂等键 + 回滚。
跳过只读阶段直接全开,再用审批兜底——企业里这往往意味着"审计时发现一堆动作没人复核过"。
五、动作分级:auto / single / dual
按可逆性 + 金额分三档:
- auto:查询、草稿、建工单。错了重来。
- single:改状态、非资金通知。可逆,单人确认。
- dual:退款、改预算、删数据、跨市场写。资金或不可逆,四眼原则。
判断标准:做错了 5 分钟内能否无损撤回?不能就别自动跑。 改广告预算比一次退款更隐蔽,预算被悄悄改可能三天后才在报表露馅,企业往往这时才被发现。
六、审批页要给审核人看五类证据
企业审核人要对结果负责,就必须看到:
- 意图:哪条业务事件触发?
- 证据:看了哪些数据,可点溯源?
- 工具调用:调哪个系统、传什么参数?
- 影响范围:动多少钱、几个订单、哪个市场?
- 可逆性:点批准之后还能撤吗、怎么撤?
缺一样就是盲签,出了事审核人可以说"页面没给我看这些"。审批质量取决于喂了多少证据,不是加了多少按钮。
七、四道防线:deny / retry / rollback / audit
def execute(action):
    if not has_evidence(action):        # deny
        raise Denied()
    if action.idempotency_key in seen:  # retry 幂等
        return seen[action.idempotency_key]
    result = call_tool(action)
    seen[action.idempotency_key] = result
    audit.log(trace_id=action.trace_id, actor=action.approver_id)  # audit
    return result

def rollback(trace_id):
    compensations[trace_id]()           # reverse / snapshot / soft-delete
- deny:证据不足/超权限,系统直接拦。
- retry:幂等键防重复退款/重复改。
- rollback:退款冲正、预算快照、删除软删+回收站。
- audit:每次调用带 trace_id,串起决策/参数/审批人/时间——这是合规对账的命根子。
没有幂等键的 retry 是灾难,没有快照的 rollback 是空话,没有 trace_id 的 audit 是甩锅。三样必须和权限同设计。
八、动作矩阵(企业版)
| 动作 | 分级 | 角色 | 上限 | 证据 | 审批 | 幂等键 | 回滚 |
|---|---|---|---|---|---|---|---|
| 查询订单 | 读 | Agent | 无 | 无 | 系统 | query_id | 无 |
| 生成建议 | 读(出) | Agent | 无 | 政策版本 | 系统 | draft_id | 无 |
| 创建工单 | 写 | Agent | 低 | 订单+原因 | 系统 | ticket_id | 关工单 |
| 修改状态 | 写 | Agent+单人 | 中 | 原/新+依据 | 单人 | op_id | 还原 |
| 发起退款 | 资金 | Agent+双人 | ≤¥500单/>¥500双 | 订单+政策+时效+确认 | 双人 | refund_id | 冲正 |
| 改广告预算 | 资金 | Agent+双人 | 日预算封顶 | 旧/新+理由 | 双人 | budget_id | 快照还原 |
每周复盘:审批人离职?上限半年没调?动作从"单人"偷升"自动"?
九、五个企业常见失效模式
- 审批疲劳:高低风险混排,真人变橡皮图章。
- 共享账号:一群 Agent 共用 admin,出事分不清谁。
- 不可回滚:删库、发外邮、改全局,点了不可逆。
- 日志不全:只记"调了什么",不记"凭什么、谁批的"。
- 权限漂移:业务变了权限没变,临时写权限忘了收。
十、治理最小单位是动作,不是模型
行业谈治理总盯"模型安不安全"。企业真正要被审计的是动作——它看了什么、调了什么、改了什么、能否恢复。能改你广告预算的 Agent,和沙盒里对答如流的模型,风险不在一个量级。把治理下沉到动作层,每个动作配齐角色/上限/证据/审批/幂等键/回滚,模型再抽风也被框在小格子里。
亚马逊运营 Agent 的企业提示
运营 Agent 能碰查 BSR、改竞价、调预算、读评论、代发邮件。建议:
- 实时数据(价格/排名/广告位/评论)交给 Pangolinfo Amazon Data API提供"看"的事实;
- 任何改后台的动作走最小权限凭证 + 双人审批 + 幂等键 + 回滚。
亚马逊政策随市场/季节/类目剧烈变化,外部事实统一从可信数据层拉,至少"基于哪版政策决策"可追溯,避开权限漂移,也更好向审计交代。
第二现场:预算是怎么被悄悄烧掉的
退款事故容易被看见,因为它立刻报警。更隐蔽的是预算被悄悄改。
某团队把"改广告预算"放在"写"档而非"资金"档,理由"只是调个数字,不直接转账"。一次策略误判把某 ASIN 日预算从 ¥200 顶到 ¥2000,连烧三天才在周报发现,三天 × ¥1800 ≈ ¥5400 无声损耗。对企业来说,这种"出事三天后才被发现"最要命——对外要对客户和监管解释,对内要补审计。
教训:资金边界不能只看"是否直接转账";任何"会烧钱"的动作必须双签 + 回滚。把预算当"写"是第二常见的企业权限事故源。
90 天落地节奏(企业可排期)
- 第 1–2 周(只读凭证):只发只读凭证,Agent 跑
proposed日志,不落库。看清它想碰什么。 - 第 3–6 周(受限写凭证):逐个开写凭证,配审批档与五证据审批页。先开可逆动作。
- 第 7–10 周(资金凭证 + 回滚):开资金凭证,强制双签 + 幂等键 + 回滚,trace id 串全链路。
- 第 11–12 周(周审):动作矩阵进周会,清离职审批人、收临时写权限,留书面记录备审计。
把前 6 周压成"上线即全开",等于把事故压进了前 2 周,还丢了审计留痕。
企业自检清单(10 问)
- 读/写/资金是三个独立凭证吗?
- 权限在工具接入规范,还是只在提示词?
- 第一阶段只读吗?
- 每动作审批档写清了吗?
- 审批页展示意图/证据/调用/影响/可逆性了吗?
- 每动作有幂等键吗?
- 每可逆动作有回滚吗?
- 每次调用有 trace id 吗?
- 有不可回滚动作混进自动档吗?
- 动作矩阵本周复盘且有书面记录吗?
答不上 3 个,先别让 Agent 碰资金。
成本账
5 万咨询量/月的运营,盲签导致 10% 误动作,5% 变 ¥50 投诉 = ¥12,500/月、¥150,000/年;加 10 复核人力 ¥500 万。治理代价 = 一个兼职 owner + 周脚本。放任才是最贵,且最说不清的方案。
五个误区
- "有审批就安全"——审批是责任转移,不是边界。
- "模型乖就不会乱动"——边界在工具层,不靠模型。
- "预算不是资金"——会烧钱必须进资金档。
- "记了调用就够了"——还要证据、审批人、trace id。
- "配一次永久有效"——权限会漂移,必须周审。
强监管行业的额外要求
金融/医疗/政务还要两层:职责分离(SoD)有书面审批留痕,审计师逐项核;外部实时事实来自可信数据层,不让 Agent 自己抓网页猜政策版本。像 Pangolinfo Amazon Data API这种实时数据层,把"基于哪版政策决策"变成可举证事实,向监管交代时心里有底。
治理健康度看什么
别只看"有没有审批"。盯五个数:审批拒绝率(长期 0 说明形同虚设)、平均审批耗时(过长=证据不够)、不可回滚动作占比(趋近 0)、trace id 覆盖率(必须 100%)、权限漂移次数(周审问题数)。这五个比"我们加了审批"诚实得多。
审批页前后对比:同一笔退款,两种页面
坏的页面:"Agent 请求退款 ¥3,800,是否批准?" 好的页面:意图(买家说货损)、证据(订单 A 已签收;政策 v2025 30 天窗口可退)、工具调用(issue_refund 3800 市场 US)、影响范围(1 单 ¥3,800)、可逆性(24h 内可冲正)。同一个动作,两种决策。坏页面产出盲签,好页面产出真实判断,也常常产出证据不足时的果断"拒绝"。
反模式清单
- 审批人写进提示词:软请求,模型可忽略。
- 共享 admin token:出事分不清谁。
- 日志只记动作名:不记证据、审批人、trace id。
- "模型拒绝了"当"安全":拒绝 ≠ 已验证边界。
- 小额定额自动批:仍在训练盲签习惯。
人的一面:让审批人买账
最快毁掉治理的是淹没审批人。两招:把"影响范围"高亮,让高危动作从安全动作里跳出来;把"拒绝"做成一键。审批人相信页面给了该看的东西,审批质量才上得去、疲劳才下得来。企业治理是人际系统,为人而设计。
落地小结:治理不是按钮,是系统
把前面这些合起来,企业 Agent 权限管理是一套机制,不是一个"批准"按钮:分级的动作、每次审批都亮证据、每个动作带幂等键、每个可逆动作有回滚、每次调用有 trace id,并且每周复盘一次。对阿里云这类合规导向的团队,还要把 SoD 留痕和可信数据层算进去——外部事实来自数据层而非 Agent 自己抓网页,向监管交代时才能举证"基于哪版政策决策"。
治理真正生效,靠的是把边界写进架构和 PRD,而不是靠谁在会上说"我信任我的 Agent"。当批准不再是盲签、出错一定能撤、出事查得到谁,Agent 才从玩具变成能接进核心业务的同事;否则再多审批按钮,也只是把责任转移给一个更累的真人。权限会随业务漂移,所以周审动作矩阵那个 30 分钟,是这个系统长期不腐烂的保险,值得写进每一次迭代评审的固定议程。
结语
企业 Agent 权限管理治的是"责任",不是"开关"。当"批准"不再是盲签、出错一定能撤、出事查得到谁,Agent 才从玩具变同事,企业才敢把它接进核心业务。
系列前作:客服 Agent 拒答能力、端到端集成、Agent 不是交付单位、项目管理 Agent 系统集成、AI 转型 SOP 还是进入流程、企业 AI 知识库为什么会失效。
