
商品数据治理要保留“未知”。价格为空不等于价格为零,配送提示缺失不等于缺货。亚马逊商品数据 API 接入后,应先保留原始证据,再生成可用于某个业务场景的观测。
数据仓库里的默认值为什么需要业务含义?
默认值看起来能让报表更整齐,却可能改变命题。一个没有价格证据的记录被补成 0,后续折扣率、价格均值和降价告警都可能把它当成真实交易条件。这个风险来自转换规则,不需要接口抛出任何错误。
建议把原始值、转换值、验收状态与归因状态分开。原始值保留服务返回的形态;转换值只做有依据的类型和单位处理;验收状态回答该任务能否使用;归因状态记录问题原因及其证据。未知归因可以存在,不要为了填满一张表编造解释。
对缺失字段的监控也要有分母。目录图片任务可以统计图片覆盖,地区比价任务则统计通过身份、价格和地区门槛的观测。把所有接口调用揉成一个填充率,会掩盖业务之间的差异。
当解析器升级时,使用留存样本回放,对比哪些记录从通过变成隔离、哪些字段值发生变化。只有确认变化来自修复,才能更新业务口径。不能以新结果看起来更完整为理由覆盖旧记录而不留版本。
怎样验收亚马逊商品数据 API,才能发现错误比较?
本文历史样本用于说明检查方法;另可通过Pangolinfo 数据采集案例了解项目应用背景,不将不同案例的结果视为统一性能保证。
先用小样本找出错误类型,再扩展样本验证稳定性。一个起步设计是:同一商品族的 2 个子 ASIN,分别请求 2 个目标地区,在 2 个时间点复测,共 8 次观测。这是建议的试验设计,不是本文已经完成的接口压测,更不能用于宣称某个成功率。
历史样本能帮助选择检查点。Pangolinfo 项目在 2026-09-14 留存的 A01.08 记录中,同父商品 B0GP8D698X 的 B0CMZFCQ6D 与 B0CMZ5KBNS 出现过以下差异。本次引用的是项目记录,未重新调用接口,也没有把当时取值当作今天的商品状态。
| 历史记录中的差异 | 应增加的检查 |
|---|---|
| 划线价标签分别为 List Price 与 Typical price | 保留标签,不把两者无条件归成“原价” |
| attributes 条目数为 48 与 49 | 按属性名处理缺失,不按数组位置对齐 |
| size 为 8 GB,另一规格写 512 GB | 先确认内存与存储语义,再用于筛选 |
| 分辨率分别使用乘号与字母 x | 规范化展示差异,同时保留原值 |
样本揭示的是检查点,不是发生频率。
空值与评论归属应该怎样判断?
空字符串、null 和缺键也只描述返回形态。它们不能单独证明上游没有内容、商品不适用或采集失败。先保留原始响应,再结合状态码、重试结果与页面证据归因;证据不足就标记未知,不要补成 0、无库存或“没有评论”。
同一批历史记录还记载过一页评论含 10 条、涉及 7 个 ASIN。这个数量不足以证明它们全属同一商品族,也不能推导所有商品共享评论。评价摘要与评论明细应分开验收;请求 ASIN、评论关联 ASIN 和已经核验的关系要分开存。
亚马逊商品数据 API 应覆盖哪 5 类信息?
先写业务问题,再列字段。评估亚马逊 Listing 数据接口做目录补全时,要看标题、图片和规格;竞品监控还要识别具体变体、卖家、价格类型和配送条件;评价研究则需要分清评分摘要与评论明细。三种任务可以从同一商品页起步,却不能共用一条“有标题、有价格就通过”的验收规则。
| 检查项 | 要看什么 | 通过前必须回答的问题 |
|---|---|---|
| Listing 内容 | 标题、品牌、图片、规格、类目 | 是否对应目标商品与市场? |
| 变体关系 | 请求与返回 ASIN、父子关系、颜色或尺码 | 当前价格属于哪个可购买选项? |
| 报价条件 | 现价、币种、卖家、划线价标签、优惠条件 | 比较的是哪一种价格? |
| 配送与可售状态 | 目标邮区、配送提示、可售标记 | 该地区能否按这个条件购买? |
| 评价摘要 | 星级、数量、分布、页面展示范围 | 数字代表哪个对象,是否只是摘要? |
这 5 类是采购检查框架,不是对每份响应的字段保证。商品接口文档提供了请求与返回示例;评估时还要看目标类目和市场的实际响应。示例里出现一个键,不代表每件商品都会提供对应内容。
验收亚马逊商品信息接口时,把字段分成“本业务必需”和“缺失可降级”两组。比价任务中,价格为空应退出本轮比较;图片补全任务中,同一条记录仍可能有用。可用记录的定义必须随任务变化,不能让一条全局成功状态替每项业务作决定。
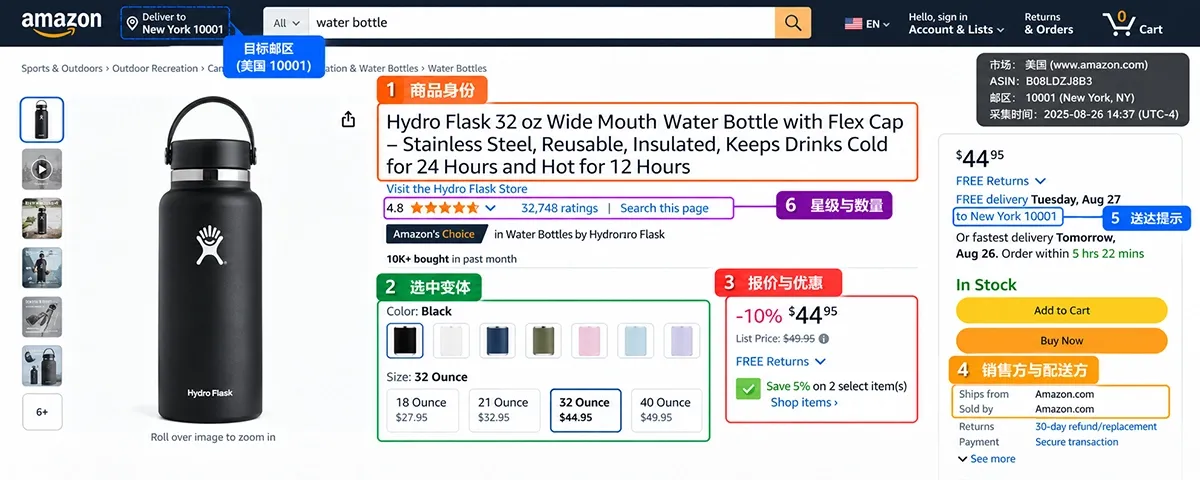
商品页面字段定位示意:商品身份、选中规格、报价和配送条件应对应同一次观测。图中价格与日期仅用于讲解,不代表当前商品状态。
按 ASIN 获取亚马逊商品数据,为什么仍不足以比价?
ASIN 是入口,不是完整的观测条件。采集亚马逊变体价格与配送数据时,建议把一次观测记成“市场+请求 ASIN+返回 ASIN+选中规格+配送地区+时间”。其中请求时间、响应接收时间与源页面采集时间要分开:若服务没有提供源采集时间,不能把本地接收时间写成源数据更新时间。
以一个假设的比价任务为例:昨天记录的是黑色 256GB,今天页面选中的是白色 512GB。即便两次标题接近,也不能据此发出涨价告警。先核对变体,再核对币种、卖家与优惠条件,最后才比较数值;这个顺序把“换了观测对象”和“对象价格变化”分开。
父子关系和配送条件还要核对什么?
父子关系用于组织商品族,子 ASIN 用于定位购买选项。拿到一组变体链接,只能证明本次发现了这些选项;若要声称覆盖全族,还需要已知清单或另一个可核验基准。不要用供应商返回的列表同时充当测试结果与覆盖率分母。
邮区也要留下证据。请求里传入 ZIP Code,不等于响应已证明页面采用了该地区;验收时应核对服务的地区状态或可见配送证据。无法核实时标记“地区未确认”,不要混入地区价格趋势。售罄、不可配送和没有读到价格,是三种待区分的状态。
这一检查还决定历史表如何存储。只按 ASIN 覆盖最新价格,会把不同地区、规格或卖家的记录揉在一起。保存观测上下文后,才能在复盘中回答某条告警基于哪次采集、哪种条件。
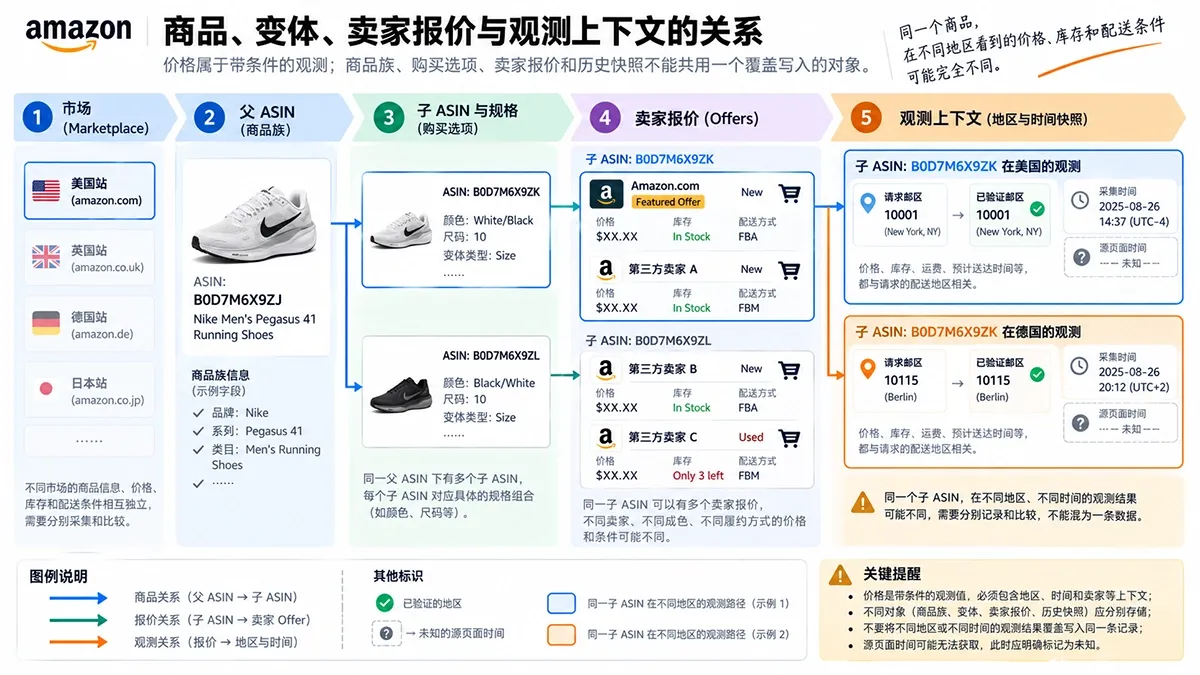
关系模型示意:同一子 ASIN 可对应不同卖家报价,每条观测还需关联地区和时间。
Pangolinfo 适合接在哪一段流程?
当任务需要公开商品页面、而团队希望把采集与解析交给服务商时,可以用Pangolinfo Amazon Scraper API 做候选数据源。商品详情使用 amzProductDetail 解析器;地区请求支持 bizContext.zipcode。下面是按文档整理的请求示意,需要替换密钥,不能视作本文已运行的测试结果。
curl --request POST 'https://scrapeapi.pangolinfo.com/api/v1/scrape' \
  --header "Authorization: Bearer $PANGOLINFO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{"url":"","parserName":"amzProductDetail","site":"amz_us","content":"B0B4NLGCH5","format":"json","bizContext":{"zipcode":"10041"}}'
接入后先保留响应,再检查外层状态、任务层状态和结果记录。不要假定 HTTP 200 就是采集成功,也不要把文档中的嵌套结果当成顶层商品对象。是否存在目标价格、返回 ASIN 是否匹配、地区是否确认,属于下一层业务验收。
接入后还要划清哪些数据边界?
公开商品页适合补全目录和观察购买条件;它不等同于销量账本、精确库存系统或全量评论库。要做评论研究,应另列评论明细的分页、范围和归属要求;要做实时告警,应补测从采集到下游可用的时延,并约定缓存与失败处理。
可将接入拆成 3 层:保存采集证据、生成带上下文的商品观测、向业务输出通过验收的结果。解析器升级或字段变化时,只重做受影响的转换,原始证据仍可用于复盘。本文不提供未经本轮验证的吞吐量、成功率或时延承诺。
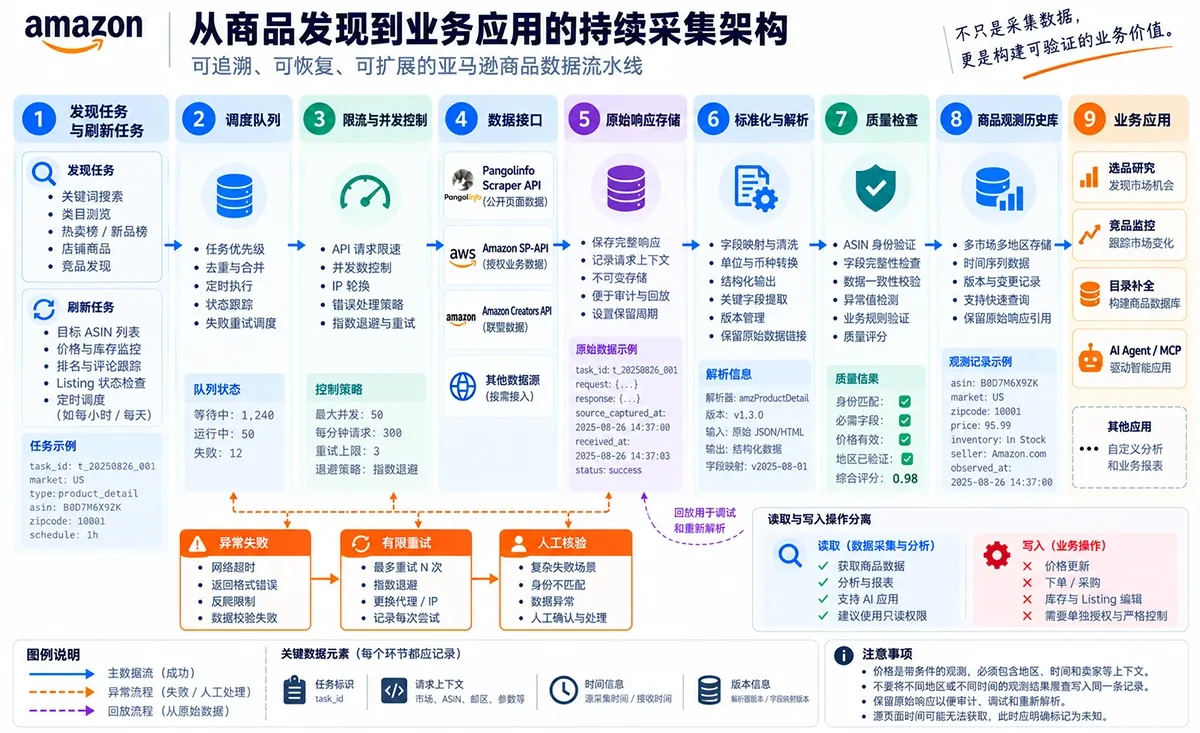
持续采集架构示意:保留原始响应与质量检查,失败任务进入受限重试或人工处理;该图不是服务商内部部署证明。
每千条可用商品记录的成本应该怎么算?
当前套餐、额度与计费说明以Pangolinfo API 价格页为准;文中的假设算例和成本分析不代表服务报价。
成本分母应是通过业务验收的观测数,而不是 HTTP 成功数。把必要重试、变体补采、地区扩展、存储和异常处理纳入同一周期,才知道报价是否适合实际工作量。
一个假设算例:预算周期内花费 100 美元取得 10,000 条响应,其中 8,000 条满足价格比较条件,则每千条可用记录成本为 100 ÷ 8,000 × 1,000=12.50 美元;若只按响应数计算,会得到 10 美元。此例不是 Pangolinfo 报价或实测通过率。
采集频率也应随任务安排。价格告警需要的频率由业务可容忍的延迟决定,图片和规格不必无条件跟随同一频率。先测每组字段的变化与价值,再制定刷新策略,避免为了取得一个价格而反复处理不需要更新的内容。
采购前把 5 项检查写成验收表:必需内容是否覆盖、变体是否匹配、报价条件是否可比、配送地区是否确认、评价范围是否明确。每项列出失败去向与责任人。用这张表评估亚马逊商品数据 API,才能把返回数据转成有依据的业务动作。
下一步可从一个商品族开始,准备目标市场、邮区与必需字段,按前面的试验设计验证候选接口。你的任务最怕哪一种错误:比错变体、比错价格口径,还是把未知配送状态当成缺货?先把它设为验收门槛。
官方接口、自建采集和专用 API 应怎样选?
先确认任务和接入资格,再看字段。Amazon 的 SP-API Catalog Items 文档包含 relationships 与 salesRanks 等数据结构,因此不能把“官方接口没有变体或排名”当作采购前提。目录数据能否满足你的任务,仍取决于接口、权限、市场和所请求的数据集。
面向联盟内容展示的路线也已变化。Amazon 官方弃用说明指出 PA-API 5 已由 Creators API 替代;新项目应查阅 Creators API 的资格和用途。它提供商品检索与变体相关操作,但不能仅凭“也是商品 API”就等同于任意竞品数据采集方案。
| 路线 | 适合优先评估的任务 | 采购或实施前需核对 |
|---|---|---|
| SP-API | 符合授权条件的卖家业务集成 | 角色、授权、市场、接口数据集 |
| Creators API | 符合计划要求的联盟购物内容 | 接入资格、使用条款、所需资源 |
| 自建采集 | 需要控制采集流程与解析逻辑 | 工程维护、访问约束、监控和失败恢复 |
| 专用数据 API | 团队希望外包公开页面采集和解析 | 字段覆盖、上下文、时效证据、计费口径 |
如何按任务边界排除不合适的路线?
自建不会消除数据语义问题,托管也不会替业务定义“可比较”。两条路线都要面对空值、页面变化和任务失败;区别在于谁负责采集基础设施、谁能提供诊断证据。不要填入没有测量依据的工程师月成本,也不要把公开页面可售标记写成卖家的精确库存数量。
需要授权账户的订单或私有库存时,应回到相应官方业务接口。需要公开商品页的价格与配送观察时,再比较自建和专用 API。这样选出来的是满足任务边界的数据源,而不是字段数最多的宣传页。
下一步该验收什么?
治理规则应让未知状态可见、让业务结果可追溯。下一次出现字段缺失,先检查证据和适用场景,再决定是否重试;不要把默认值当成故障修复。
延伸阅读:同平台的字段契约案例。旧案例可用于理解字段差异;空值原因仍需状态与页面证据,不能只从返回形态推断。


