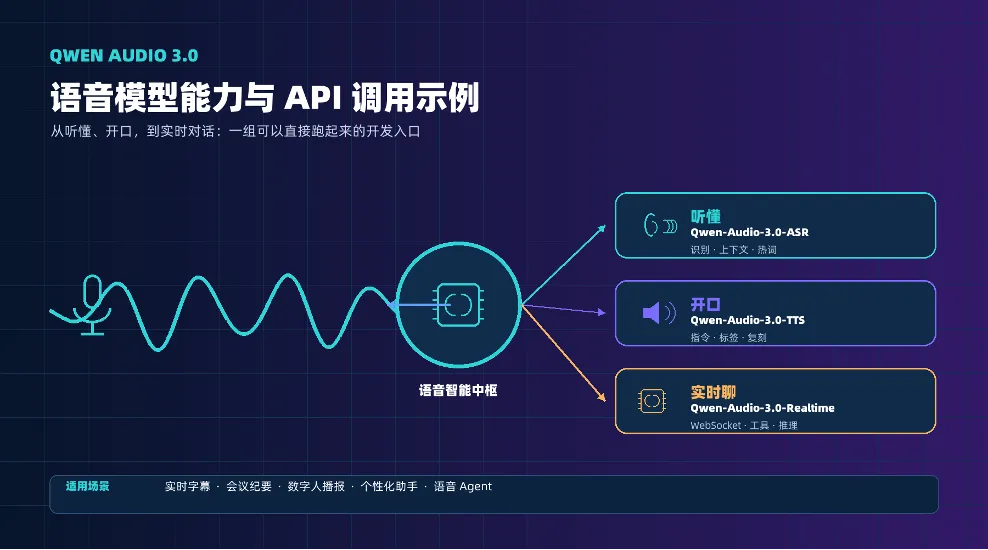
一次把「语音识别 + 语音合成 + 声音复刻 + 实时语音对话」讲清楚。 全部示例开箱即用,配置一个环境变量就能跑起来。
从智能客服到数字人,从会议纪要到陪伴助手,语音正在成为人机交互最自然的入口。阿里云百炼的Qwen-Audio-3.0 示例仓库迎来一波重要更新——我们把 Qwen-Audio-3.0 系列最新能力打包成了一组「拿来即用」的百炼平台 DashScope Python / Java 示例。本文将带你快速过一遍三大基础模型的核心能力与进阶用法:从语音识别到语音合成,再到端到端实时语音对话,帮助你快速判断应该从哪个 API 开始。
一图看懂:三条产品线
如果把语音应用拆成输入、输出与交互三层,Qwen-Audio-3.0 系列可以分别承担“听懂”“开口”和“实时聊”。三类服务既能独立调用,也能组合成完整的语音 Agent。
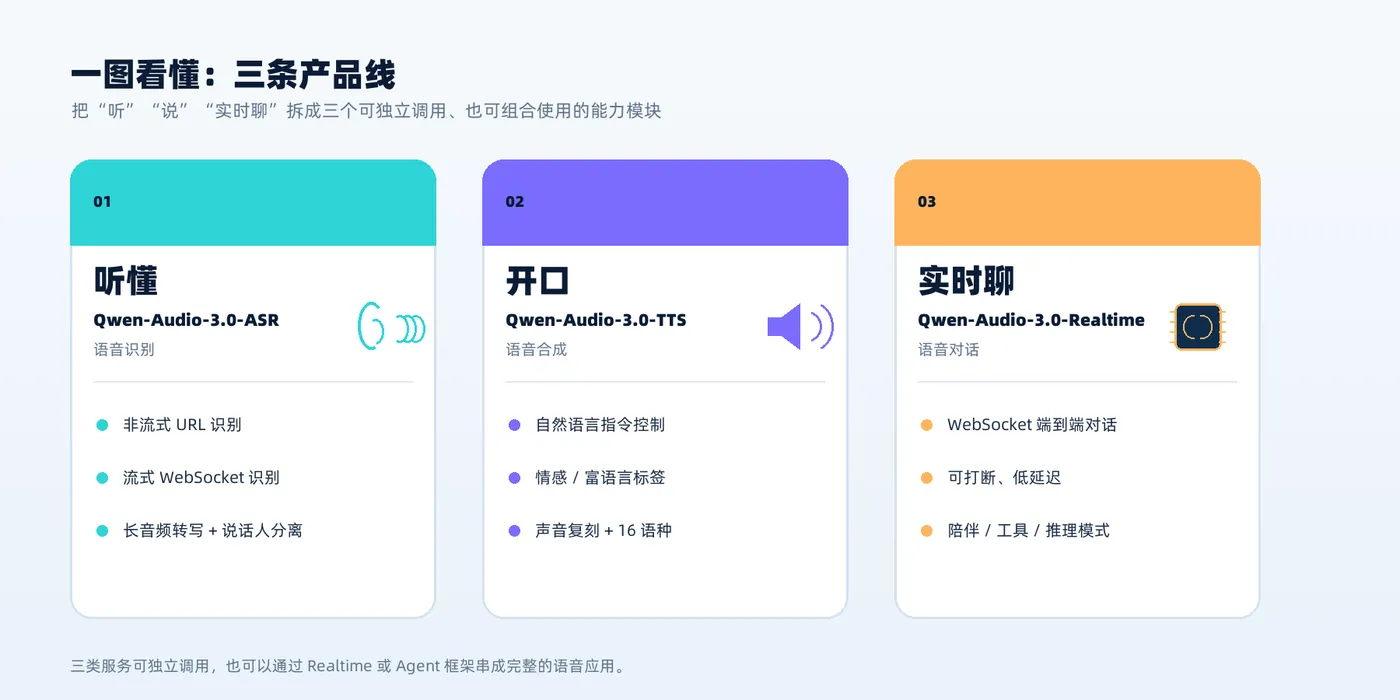
图 1:从识别、合成到实时对话的能力地图
能力模块 |
核心 API |
适合解决的问题 |
Qwen-Audio-3.0-ASR 语音识别 |
|
非流式识别、流式识别、长音频转写、说话人分离 |
Qwen-Audio-3.0-TTS 语音合成 |
|
自然语言指令、情感标签、声音复刻、多语言合成 |
Qwen-Audio-3.0-Realtime 实时语音对话 |
|
低延迟、可打断的实时语音对话与语音 Agent |
接下来按“听—说—聊”的顺序,拆开看每条产品线最值得关注的能力。
一、会「听」:Qwen-Audio-3.0-ASR 语音识别
适用场景 实时直播字幕、客服通话质检、全天会议纪要、通话录音批量转写。示例还覆盖“创建词表 → 查询状态 → 用 ID 识别 → 删除词表”的完整生命周期,并用 finally 保证资源释放。 |
识别侧覆盖三个典型场景,覆盖从“一段音频”到“一整天会议录音”的完整链路。
- 非流式识别(
recognize_speech_qwen-audio_3.0_asr_flash):对音频 URL 做一次性识别,可传入对话上下文提升专有名词准确率,最大支持 5 分钟 / 2GB。 - 流式识别(
recognize_speech_qwen-audio-3.0-asr-flash-streaming):基于 WebSocket 长连接,边说边出字;支持热词与对话上下文,适合实时字幕、通话质检等场景。 - 录音文件转写(
recognize_speech_qwen-audio-3.0-asr-flash-filetrans):面向长音频的异步转写,最大支持 12 小时 / 2GB,并提供说话人分离能力。
进阶一:对话上下文,让 ASR 听懂语境
流式识别支持传入 Context:把前几轮的用户语音识别结果与模型回复一起带上,让 ASR 在特定语境下更容易识别品牌名、人名和行业术语。也可以直接把领域术语作为一条 user 消息传入,效果类似轻量级热词。
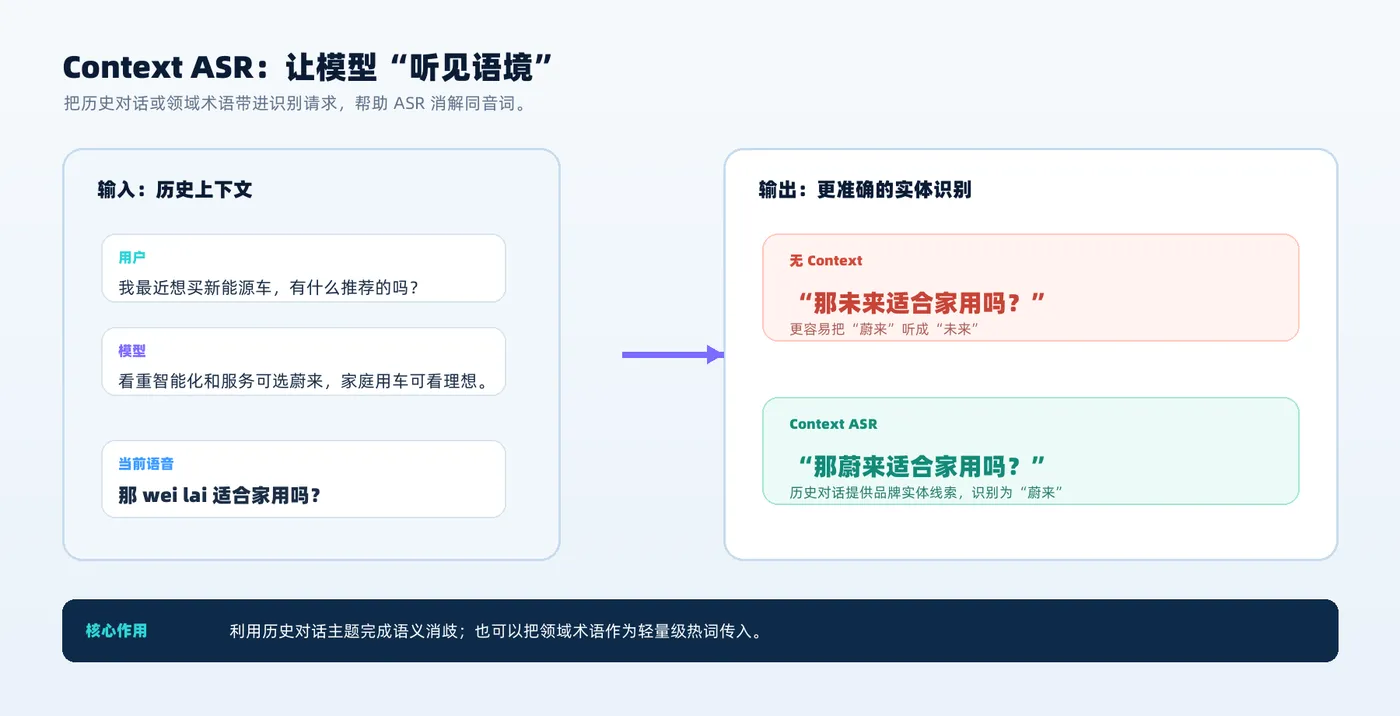
图 2:Context ASR 用历史对话完成同音词消歧
示例:传入历史对话或领域术语
context = {'context': [
    # 方式一:对话历史
    {'role': 'user',      'content': [{'type': 'input_text', 'text': '帮我查一下通义千问的最新版本'}]},
    {'role': 'assistant', 'content': [{'type': 'text',       'text': '通义千问目前最新版本是 Qwen3。'}]},
    # 方式二:领域词表
    {'role': 'user', 'content': [{'type': 'input_text',
     'text': '相关术语:语音实验室、通义千问、百炼平台、声音复刻、热词表'}]},
]}
recognition.start(raw_input=context)
服务端约束 input_text 与 text 类型各最多 5 条,每轮文本不超过 400 字符。示例代码内置自动裁剪逻辑,超限时保留最近几条。 |
进阶二:超级热词,关键术语必须识别准
热词表支持为每个词条指定 weight(1~5 为普通权重,50 为超级热词)。超级热词的召回率大幅提升,适合"无论如何都必须识别准"的关键术语:
my_vocabulary = [
    {'text': '语音实验室', 'weight': 4},   # 普通热词
    {'text': '通义千问',   'weight': 50},  # 超级热词
]
- 数量:最多 50 个,不占用普通热词额度。
- 模型:仅 Qwen-Audio-3.0-ASR 系列模型支持。
- 取值:合法取值为 1~5 或 50,不存在 6~49 这一段。
示例代码(克隆仓库后进入对应目录,按其 README 安装依赖并运行):
- 非流式语音识别(samples/speech-recognition/recognize_speech_qwen-audio_3.0_asr_flash)
- 流式语音识别(samples/speech-recognition/recognize_speech_qwen-audio-3.0-asr-flash-streaming)
- 录音文件转写(samples/speech-recognition/recognize_speech_qwen-audio-3.0-asr-flash-filetrans)
- 流式识别 + 对话上下文(samples/speech-recognition/recognize_speech_qwen-audio-3.0-asr-flash-streaming-with-context)
- 流式识别 + 预创建热词表( samples/speech-recognition/recognize_speech_qwen-audio-3.0-asr-flash-streaming-with-vocabulary)
二、会「说」:Qwen-Audio-3.0-TTS 语音合成
适用场景 数字人播报、有声书配音、方言内容、游戏 NPC、个性化语音助手、国际化多语言播报。 |
Qwen-Audio-3.0-TTS 主打“可控”与“像你”:通过自然语言指令、细粒度标签、参考音频和多语言提示,把音色、风格与表达方式放进同一套调用链,提供从基础合成到多语言全覆盖的示例。

图 3:TTS 的五个控制维度
维度一:指令控制:用一句话描述“怎么说”
流式合成、实时播放的亮点,是用一句自然语言instruction控制角色、情绪、场景与语速。
instruction = '年轻活泼的女性声音,声音清脆甜美,语速很快,适合介绍时尚产品'
instruction = '请用河南话表达'
instruction = '沉稳专业的男性播音员,字正腔圆'
维度二:情感与富语言标签:把表达写进文本
除了 instruction,也可以直接在文本中嵌入标签。原稿示例覆盖 14 个控制类标签与 7 个富语言标签,适合控制情绪、呼吸、笑声等非语言细节。
[excited]今天的天气真不错![laughing]我们一起出去玩吧!
[serious]请注意安全事项。[excited]好了,现在让我们开始吧!
支持 14 个控制类标签([excited] [sad] [angry] [whispers] [asmr] 等)和 7 个富语言标签([laughing] [sighing] [cough] 等),完整列表见指令控制详解示例。
维度三:声音复刻与文本正则化
- 声音复刻:用一段音频复刻专属音色,再用它合成任意文本,适合品牌音色、主播声音资产化等场景。
- 文本正则化(TN):把“1毫升20%甘露醇需在15~20分钟内完成滴注”读成更自然的“一毫升百分之二十甘露醇需在十五到二十分钟内完成滴注”,确保数字、单位与号码的朗读质量。
# 输入文本
"在一次检测中,1毫升20%甘露醇需在15~20分钟内完成滴注"
# TTS 读出的效果
"在一次检测中,一毫升百分之二十甘露醇需在十五到二十分钟内完成滴注"
示例包含多段难读文本(历史计量、医疗用法、热线号码),每段附带听觉检查点,方便你验证合成效果。
维度四:All-in-One 多语言,一个音色说 11 种语言
使用单一音色 longanhuan_mtlv7 即可合成 11 种语言:中文、英文、日语、韩语、法语、德语、意大利语、葡萄牙语、越南语、印尼语、菲律宾语。切换语种时音色始终保持一致,非常适合国际化内容播报。
只需传入 language_hints 告诉模型输入语种,再配合 instruction 指定说话语言:
from dashscope.audio.tts_v2 import SpeechSynthesizer, SpeechSynthesisAudioFormat
import dashscope
synthesizer = SpeechSynthesizer(
    model='qwen-audio-3.0-tts-flash',
    voice='longanhuan_mtlv7',
    language_hints=['ja'],
    instruction='請講日語。'
)
synthesizer.streaming_call('東京は美しい都市です。')
audio = synthesizer.streaming_complete()
示例代码(克隆仓库后进入对应目录,按其 README 安装依赖并运行):
- 指令控制语音合成(samples/speech-synthesizer/synthesize_speech_from_text_with_qwen_audio_tts_by_instruction)
- 声音复刻语音合成(samples/speech-synthesizer/synthesize_speech_from_text_with_qwen_audio_tts_by_cloned_voice)
- 文本正则化能力演示(samples/speech-synthesizer/synthesize_speech_from_text_with_qwen_audio_tts_text_normalization)
- All-in-One 多语言语音合成(samples/speech-synthesizer/synthesize_speech_from_text_with_qwen_audio_tts_multilingual)
三、会「实时聊」:Qwen-Audio-3.0-Realtime 语音对话
如果说前两者是“听”和“说”,Qwen-Audio-3.0-Realtime 就是把两者合二为一的“边听边说”:一个基于 WebSocket 的端到端实时语音对话服务。
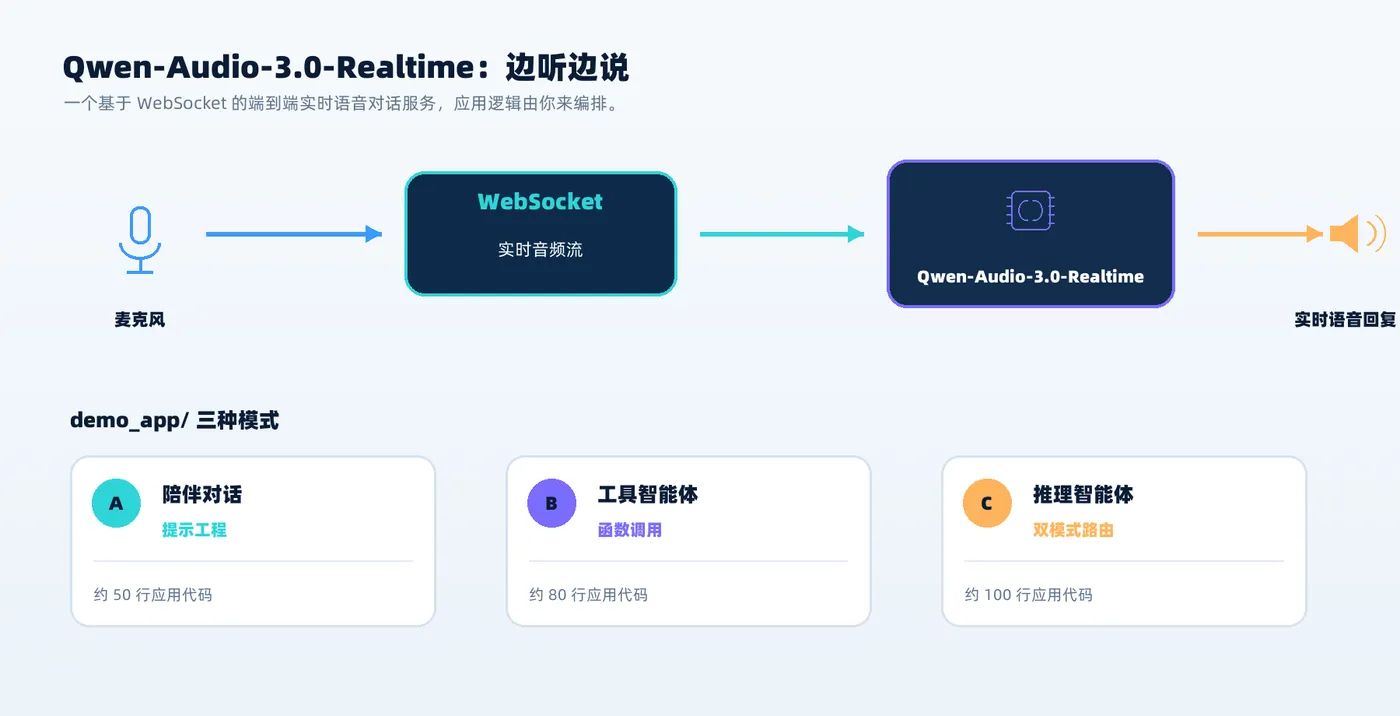
图 4:Realtime SDK 与 demo_app 的最小架构
配套的 Python SDK(fun_realtime/)刻意保持精简:只负责底层 WebSocket 连接、事件序列化、会话配置与音频编解码,不内置轮次状态机和路由器,因此可以直接嵌入自己的应用架构。SDK 本体仅依赖 websockets,不需要额外的音频硬件库。
- 场景 A · 陪伴对话:纯提示工程,配置一个角色人设即可开始对话,约 50 行应用代码。
- 场景 B · 工具智能体:注册工具、处理函数调用事件并回传结果,让语音助手能查天气、调接口、办实事,约 80 行应用代码。
- 场景 C · 推理智能体:模型自己决定走哪条路:简单问题直接快答,复杂问题路由到外部推理流水线,先垫一句“让我想想”,再播报深度思考结果,约 100 行应用代码。
浏览器体验 配套 Web 示例启动后,浏览器打开 http://localhost:8080,即可体验上述三个场景。 |
想做更复杂的 Agent?
推荐看看 **qwen-audio-agent** —— 进一步提供了多轮记忆管理、声明式工具编排、多模态输入和生产级参考架构,适合从 demo 走向上线应用的团队。
示例代码(克隆仓库后进入对应目录,按其 README 安装依赖并运行):
- Qwen-Audio-3.0-Realtime SDK 与三场景 Demo(samples/conversation/fun-audiochat-realtime)
- qwen-audio-agent(生产级 Agent 框架,独立仓库):https://github.com/QwenAudio/qwen-audio-agent
四、三步跑起来
每个示例目录下都有独立 README.md,写清依赖、参数与预期结果;示例同时提供中英文说明。建议先从 Python 示例跑通,再按需要接入 Java 或自己的应用框架。
# 1. 克隆仓库
git clone https://github.com/aliyun/alibabacloud-bailian-speech-demo.git
# 2. 配置鉴权(在百炼控制台创建 API-KEY)
export DASHSCOPE_API_KEY=your-api-key
# 实时对话 / 部分示例还需要 space_id 或 workspace_id
export FUN_REALTIME_SPACE_ID=your-bailian-space-id
# 3. 进入任意示例目录,按其 README 运行即可
#    Python:pip install -r requirements.txt && python run.py
#    Java:  mvn clean package && sh run.sh
运行建议 先用短音频或短文本验证鉴权与网络,再逐步增加上下文、热词、工具调用和多语言控制,定位问题会更快。 |
写在最后
好的示例,本身就是最好的文档。无论你想做实时字幕、数字人、智能客服、多语言播报,还是一个会聊天、会调用工具、还能“思考”的语音智能体,这组 Qwen-Audio-3.0 模型示例都提供了可运行的起点。建议从一个最小示例开始,把它接进你的产品,再根据场景逐步加入 Context、热词、标签、声音复刻和 Agent 路由。
项目地址(欢迎 Star、Fork):
https://github.com/aliyun/alibabacloud-bailian-speech-demo