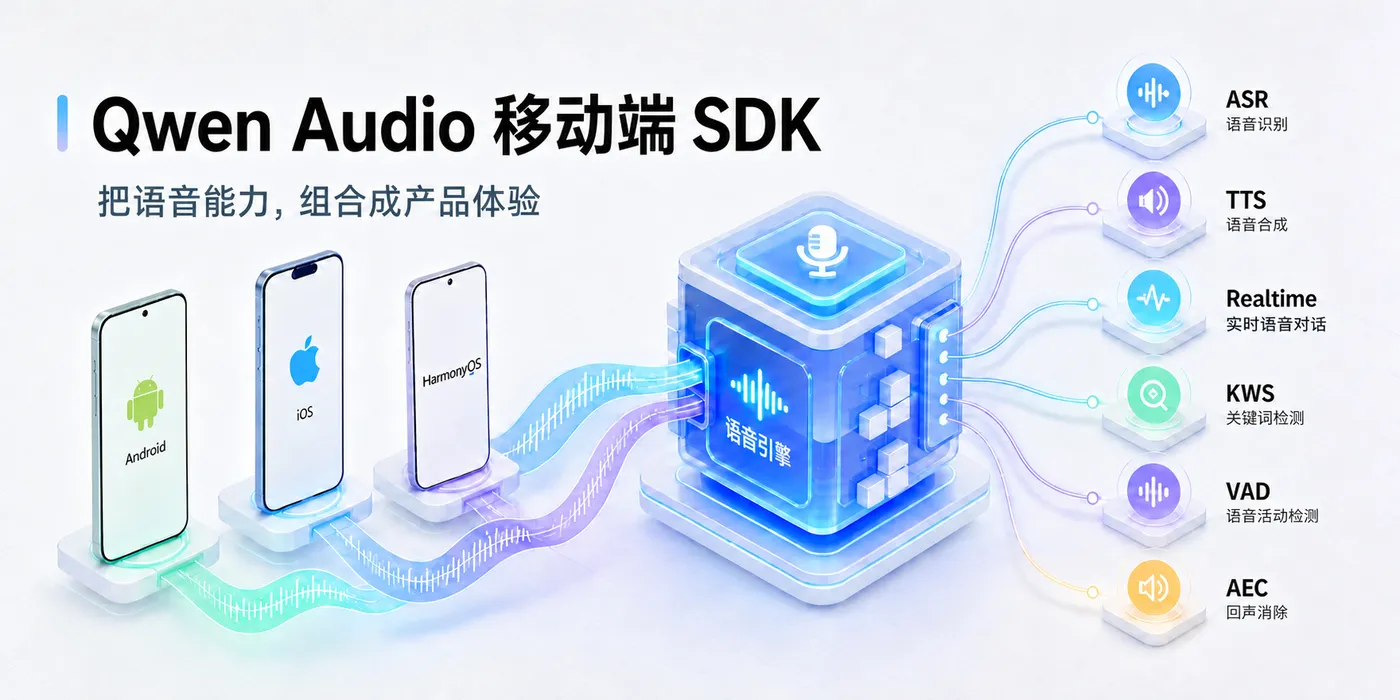
适用平台:安卓 Android、苹果 iOS、鸿蒙 HarmonyOS
关键词:音频处理|Qwen-Audio-3.0|百炼
自然的语音交互,通常需要在同一条链路中处理环境噪声和扬声器回声,检测用户是否发声,判断唤醒时机,并根据业务场景,在实时识别、实时对话、翻译、录音转写与语音合成等能力之间灵活组合。
Qwen Audio 移动端 SDK 是一套以高性能 C++ 为核心语言、覆盖 Android / iOS / HarmonyOS 三端的语音 AI 软件开发套件。它把语音能力拆解为可独立启用、自由组合的原子能力:设备端封装 VAD、AEC、KWS 与本地 TTS 等模块;通过兼容性广泛的 WebSocket / HTTP 协议,连接百炼云端的 ASR、TTS、Realtime、实时翻译与录音转写大模型能力。三端应用层面向统一的任务模型与回调语义,底层平台差异由 SDK 统一适配。
SDK 不预设唯一的交互范式,开发者可以像搭积木一样组织链路:以 KWS 作为入口,用 AEC、VAD 控制输入质量,再把处理后的音频流交给云端模型;也可以跳过 KWS 环节,直接构建实时字幕、同声传译或按键说话类对话应用——把原子的语音 AI 能力,组合成完整的产品体验。
01 一图看懂:统一 API 之下,是可自由组合的原子能力
图1:Qwen Audio 移动端 SDK 整体架构
Qwen Audio 移动端 SDK 的架构可以从上到下理解为五层:
层级 |
作用 |
代表能力 |
统一 API 层 |
三端统一接入、控制与事件回调 |
会话控制、音频输入、结果回调、播放控制 |
能力路由层 |
根据输入数据和业务配置选择对应的本地模块或云端交互协议 |
实时识别、实时对话、实时翻译、语音合成、录音文件转写 |
设备端能力 |
在端侧完成音频预处理与有效性判断,降低无效云端请求 |
KWS、AEC、VAD、离线 TTS |
百炼云端能力 |
通过 Qwen Audio 移动端 SDK 封装的 WebSocket / HTTP 连接完成识别与生成 |
实时/非实时 ASR、TTS、Realtime、实时翻译 |
基础设施 |
网络连接、断网续传与跨平台系统适配 |
录放音管理、线程、TLS、三端适配 |
比能力数量更关键的,是能力之间可被稳定编排的组合关系。以语音助手为例,一条典型链路是:
麦克风 → AEC → VAD → KWS → 实时 ASR → 业务服务 → 流式 TTS → 扬声器。
同一套 SDK 还可快速组织为:
- 实时字幕:麦克风 → AEC/VAD(可选)→ 实时 ASR → 业务服务;
- 同声翻译:麦克风 → 实时语音翻译 → 双语文本和语音 → 扬声器;
- 实时语音助手:麦克风 → AEC/VAD → Realtime → 实时全双工交互;
- 会议纪要:录音文件 → 非实时 ASR / 文件转写 → 结构化文本结果。
02 接入 Qwen-Audio-3.0:实时识别、合成与语音对话
本节三端调用示例采用 Qwen Audio 移动端 SDK 的实际调用方式。实时识别、流式合成与实时语音对话均基于 NativeNui、任务参数和回调事件完成接入,但不同能力在实例类型、任务参数和音频输入方式上会存在差异。
2.1 Qwen-Audio-3.0-ASR 实时语音识别示例
一个 NativeNui 实例对应一路实时识别。应用先初始化 SDK,再设置详细可选参数,最后开始识别。以下以 qwen-audio-3.0-asr-flash-streaming 为例。
NativeNui nui_instance = new NativeNui();
nui_instance.initialize(this, genInitParams(debugPath),
        Constants.LogLevel.LOG_LEVEL_DEBUG, true);
nui_instance.setParams(genParams());
nui_instance.startDialog(Constants.VadMode.TYPE_P2T, genDialogParams());
private String genInitParams(String debug_path) {
    String str = "";
    try{
        JSONObject object = new JSONObject();
        object.put("device_id", "empty_device_id"); // 必填, 推荐填入具有唯一性的id, 方便定位问题
        object.put("url", "wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/inference");
        object.put("service_mode", Constants.ModeFullCloud); // 必填
        str = object.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return str;
}
private String genParams() {
    String params = "";
    try {
        JSONObject nls_config = new JSONObject();
        // 模型选择, 注意模型对应的采样率要求。
        nls_config.put("model", "qwen-audio-3.0-asr-flash-streaming");
        // 设置待识别音频语种。无默认值,不设置时模型自动识别。
        nls_config.put("language_hints", ["en"]);
        if (isVadMode) {
            // 设置开启VAD(Voice Activity Detection,语音活动检测)断句,默认关闭。
            nls_config.put("semantic_punctuation_enabled", false);
            // 设置VAD(Voice Activity Detection,语音活动检测)断句的静音时长阈值(单位为ms)。
            // 取值范围[200, 6000],默认1300。
            nls_config.put("max_sentence_silence", 800);
        } else {
            // 设置开启语义断句。
            nls_config.put("semantic_punctuation_enabled", true);
        }
        // 噪音参数阈值,参数范围:[-1,1]。取值说明如下:
        // 取值越趋于-1,噪音被判定为语音的概率越大。
        // 取值越趋于+1,语音被判定为噪音的概率越大。
        nls_config.put("speech_noise_threshold", 0.88);
        // 上下文增强:传入对话历史或领域语料,模型利用上下文修正识别结果
        nls_config.put("input_context", "context");
        JSONObject tmp = new JSONObject();
        tmp.put("nls_config", nls_config);
        // 必填, 设置成实时识别模式
        tmp.put("service_type", Constants.kServiceTypeSpeechTranscriber);
        params = tmp.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return params;
}
private String genDialogParams() {
    String params = "";
    try {
        JSONObject dialog_param = new JSONObject();
        // 服务只需要在临时Token(API Key)快过期前刷新一次。各端侧在Token(API Key)快过期前从服务获得新的
        // 临时Token(API Key)。
        dialog_param.put("apikey", "临时token");
        params = dialog_param.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return params;
}
实时音频接入通常有两种方式:默认由 SDK 通过 onNuiNeedAudioData 拉取音频数据;也可以由应用调用 updateAudio 主动推送。具体选择取决于应用是否需要在送入识别前插入本地音频处理,例如 AEC。
// 回调送数据:SDK 请求一帧音频时,将音频数据填入缓存
@Override
public int onNuiNeedAudioData(byte[ ] buffer, int len) {
    // 录音数据填入缓存
}
识别结果和事件信息通过 onNuiEventCallback 获取。
// 回调送数据:SDK 请求一帧音频时,将音频数据填入缓存
@Override
public void onNuiEventCallback(Constants.NuiEvent event, final int resultCode,
                                final int arg2, KwsResult kwsResult,
                                AsrResult asrResult) {
    if (event == Constants.NuiEvent.EVENT_TRANSCRIBER_STARTED) {
        // 交互开始
    } else if (event == Constants.NuiEvent.EVENT_TRANSCRIBER_COMPLETE) {
        // 交互结束
    } else if (event == Constants.NuiEvent.EVENT_ASR_PARTIAL_RESULT) {
        // 中间识别结果
    } else if (event == Constants.NuiEvent.EVENT_SENTENCE_END) {
        // 识别句结果
    } else if (event == Constants.NuiEvent.EVENT_ASR_ERROR) {
        // 发生错误
    }
}
2.2 Qwen-Audio-TTS 实时语音合成示例
流式输入 TTS 模式建议创建独立实例。上游文本可按句或按语义片段持续写入,合成音频通过流式回调返回后,应立即送入播放器队列,以降低首包延迟和端到端播放延迟。
NativeNui tts_instance = new NativeNui(Constants.ModeType.MODE_STREAM_INPUT_TTS);
int ret = tts_instance.startStreamInputTts(new INativeStreamInputTtsCallback() {
    @Override
    public void onStreamInputTtsDataCallback(byte[ ] data) {
        // 音频送入播放队列
    }
    @Override
    public void onStreamInputTtsEventCallback(StreamInputTtsEvent event,
            String taskId, String sessionId, int code, String message,
            String timestamp, String allResponse) {
        if (event == StreamInputTtsEvent.STREAM_INPUT_TTS_EVENT_SYNTHESIS_STARTED) {
            // 打开播放器
        } else if (event == StreamInputTtsEvent.STREAM_INPUT_TTS_EVENT_SYNTHESIS_COMPLETE) {
            // 已送完合成音频,等待播放器播空
        }
    }
}, genTicket(), genParameters(false), taskId,
    Constants.LogLevel.toInt(Constants.LogLevel.LOG_LEVEL_DEBUG), true);
tts_instance.sendStreamInputTts("您好,我已经为");
tts_instance.sendStreamInputTts("您查到相关信息。");
// 通知待合成文本发送完成,等待语音合成结束
tts_instance.asyncStopStreamInputTts();
每轮合成开始前应清空播放器缓存,并将上游文本按句切分后逐段调用 sendStreamInputTts。需要立即中断时,可调用 cancelStreamInputTts 或保持连接的取消接口;正常收尾时使用 asyncStopStreamInputTts,确保待合成文本完整发送并等待服务端结束事件。
2.3 Qwen-Audio Realtime 实时语音对话示例
一个 NativeNui 实例对应一路实时语音对话。应用先初始化 SDK,再设置详细可选参数,最后开始识别。以下以 qwen-audio-3.0-realtime-plus 为例。
NativeNui nui_instance = new NativeNui();
nui_instance.initialize(this, genInitParams(debugPath),
        Constants.LogLevel.LOG_LEVEL_DEBUG, true);
nui_instance.setParams(genParams());
nui_instance.startDialog(Constants.VadMode.TYPE_P2T, genDialogParams());
private String genInitParams(String debug_path) {
    String str = "";
    try{
        JSONObject object = new JSONObject();
        object.put("workspace", workspace); // 必填, 传入模型资源所在目录
        object.put("device_id", "empty_device_id"); // 必填, 推荐填入具有唯一性的id, 方便定位问题
        object.put("url", "wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/inference");
        object.put("service_mode", Constants.ModeFullCloud); // 必填
        // 使用主动推送录音数据的方式, 自动启动AEC, 是实时对话的基础
        object.put("audio_update_manually", "true");
        str = object.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return str;
}
private String genParams() {
    String params = "";
    try {
        JSONObject nls_config = new JSONObject();
        // 模型选择, 注意模型对应的采样率要求。
        nls_config.put("model", "qwen-audio-3.0-realtime-plus");
        // 模型输出模态设置
        nls_config.put("modalities", "[\"text\", \"audio\"]");
        JSONObject turn_detection = new JSONObject();
        if (isVadMode) {
            // 服务端 VAD 检测语音起止,自动触发推理。
            turn_detection.put("type", "server_vad");
        } else {
            // 融合声学感知与语义理解判断轮次边界,而非仅依赖人声信号。无语义的声音(如”嗯”、”啊”)不会触发对话轮或打断模型播报。
            turn_detection.put("type", "smart_turn");
        }
        nls_config.put("turn_detection", turn_detection.toString());

        // 用户自有服务function_call注册
        nls_config.put("tools", "xxxx");
        JSONObject tmp = new JSONObject();
        tmp.put("nls_config", nls_config);
        // 必填
        tmp.put("service_type", Constants.kServiceTypeSpeechTranscriber);
        params = tmp.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return params;
}
private String genDialogParams() {
    String params = "";
    try {
        JSONObject dialog_param = new JSONObject();
        // 服务只需要在临时Token(API Key)快过期前刷新一次。各端侧在Token(API Key)快过期前从服务获得新的
        // 临时Token(API Key)。
        dialog_param.put("apikey", "临时token");
        params = dialog_param.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return params;
}
为实现实时对话中的全双工交互,应将 audio_update_manually 设置为 true,启用主动推送音频并开启 AEC 的工作模式。此时,应用需要同时将麦克风数据和播放参考数据送入 SDK,由 SDK 完成回声消除。
public void onPlayAudioData(byte[ ] data, int len) {
    // 将播放器输出音频作为参考信号送入SDK用于回声消除(仅SDK内部AEC模式需要,first_pack可不关注)
    nui_instance.updateRefAudio(data, len, false);
}
public int onRecorderData(byte[ ] data, int len, boolean first_pack) {
    // 开启SDK内部AEC时的录音数据回调:将原始音频通过updateAudio送入SDK,由SDK做AEC
    return nui_instance.updateAudio(data, len, first_pack);
}
识别结果和事件信息通过 onNuiEventCallback 获取。
@Override
public void onNuiEventCallback(Constants.NuiEvent event, final int resultCode,
                                final int arg2, KwsResult kwsResult,
                                AsrResult asrResult) {
    if (event == Constants.NuiEvent.EVENT_TRANSCRIBER_STARTED) {
        // 交互开始
    } else if (event == Constants.NuiEvent.EVENT_TRANSCRIBER_COMPLETE) {
        // 交互结束
    } else if (event == Constants.NuiEvent.EVENT_ASR_PARTIAL_RESULT) {
        // 中间识别结果
    } else if (event == Constants.NuiEvent.EVENT_SENTENCE_END) {
        // 识别句结果
    } else if (event == Constants.NuiEvent.EVENT_AUDIO_TRANSCRIPTION) {
        // 解析 delta 增量,累加后显示在回答内容中
    } else if (event == Constants.NuiEvent.EVENT_AUDIO_TRANSCRIPTION_COMPLETED) {
        // 最终结果,直接显示在回答内容中
    } else if (event == Constants.NuiEvent.EVENT_OTHER_RESULT) {
        // 根据返回结果处理function_call
    } else if (event == Constants.NuiEvent.EVENT_ASR_ERROR) {
        // 发生错误
    }
}
03 端云能力如何按需组合:KWS、AEC、VAD 与离线 TTS
端侧 AI 离用户最近,也最了解设备此刻的声音状态。它不一定负责完成复杂的语义理解,但需要先回答清楚“什么时候听、听什么、是否可信”这三个问题。
端侧第一原则 先把输入音频变成“可用的音频流”,再交给云端模型。端侧处理得越稳定,云端识别和对话链路越容易获得稳定的延迟与准确率。
- KWS(关键词/命令词检测):除了唤醒词能力,还支持多命令词和自定义唤醒词,可把常用动作前置为本地命令入口,避免应用始终将全部音频上传云端,更好地保护用户隐私。
- AEC(回声消除):利用扬声器播放的参考信号,抑制回声回灌,减少 AI“听见自己说话”的问题。
- VAD(语音活动检测):在噪声环境下检出有效语音区间,辅助停说检测、断句、打断和功耗控制。
- TTS(语音合成播报):离线 TTS 可以在无网时继续工作,适合作为导航提示、系统播报和关键指令的离线兜底。
- 音频与设备控制:管理麦克风采集、播放器队列、音频分片、线程与跨平台差异,保证输入与输出能够连续工作。
这也是为什么移动端语音产品不能只看 ASR 或 TTS 的单项指标:识别模型再强,如果麦克风采进了回声、断句时机不稳定,或者用户说完后播放器仍在播旧音频,体验依然会显得迟钝、不自然。开发者可以按场景在 Qwen Audio 移动端 SDK 中配置启用端侧模块,让它们在真实音频链路里协同发力。
场景一:AEC / VAD + KWS + TTS,指令回馈
组合:麦克风 → AEC → VAD → KWS → 业务逻辑 → TTS
当设备正在播放音乐或 AI 回答时,扬声器声音可能被麦克风重新采集。AEC 以播放参考信号为依据,尽量消除扬声器回声;VAD 区分有效语音与静音/背景声;KWS 在更可靠的语音片段中检测唤醒词,命中后再切换到识别或对话任务。
// 唤醒的工作实例
NativeNui nui_instance = new NativeNui();
// 本地语音合成的工作实例
NativeNui tts_instance = new NativeNui(Constants.ModeType.MODE_TTS);
nui_instance.initialize(this, genInitParams(debugPath),
        Constants.LogLevel.LOG_LEVEL_DEBUG, true);
nui_instance.setParams(genParams());
nui_instance.startDialog(Constants.VadMode.TYPE_ONLY_KWS, genDialogParams());
// 根据唤醒词/命令词,经过业务逻辑,最终结果通过TTS播报
tts_instance.startTts("1", "", "好的");
private String genInitParams(String debug_path) {
    String str = "";
    try{
        JSONObject object = new JSONObject();
        object.put("workspace", workspace); // 必填, 传入模型资源所在目录
        object.put("upgrade_file", "用户自定义的KWS模型路径");
        object.put("device_id", "empty_device_id"); // 必填, 推荐填入具有唯一性的id, 方便定位问题
        object.put("url", "wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/inference");
        object.put("service_mode", Constants.ModeFullLocal); // 必填
        // 使用主动推送录音数据的方式, 自动启动AEC和VAD组合
        object.put("audio_update_manually", "true");
        object.put("aec_params", "更详细的AEC高级参数配置");
        object.put("vad_params", "更详细的VAD高级参数配置");
        str = object.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return str;
}
private String genParams() {
    String params = "";
    try {
        // 纯唤醒模式无需传入参数
        JSONObject parameters = new JSONObject();
        parameters.put("service_type", Constants.kServiceTypeASR);
        // 默认false, 即开始循环唤醒模式
        //开启后为单轮模式, 单轮模式需要每次唤醒后再调用start接口才会启动
        parameters.put("single_round", "false");
        //可以通过以下方式设置自定义唤醒词或命令词
        JSONArray dynamic_wuw = new JSONArray();
        parameters.put("wuw", xxx);
        params = parameters.toString();
    } catch (JSONException e) {
        e.printStackTrace();
    }
    return params;
}
唤醒结果通过 onNuiEventCallback 返回。同时,开发者也可以通过 onNuiAssistEventCallback 获取唤醒瞬间的音频数据以及 AEC 回声消除后的音频数据,用于支持更复杂的交互逻辑和问题定位。
@Override
public void onNuiEventCallback(Constants.NuiEvent event, final int resultCode,
                                final int arg2, KwsResult kwsResult,
                                AsrResult asrResult) {
    if (event == Constants.NuiEvent.EVENT_WUW) {
        // 唤醒词触发
    } else if (event == Constants.NuiEvent.EVENT_WUW_TRUSTED) {
        // 触发的唤醒词确认
    } else if (event == Constants.NuiEvent.EVENT_WUW_START) {
        // 唤醒时的音频数据开始回传
    } else if (event == Constants.NuiEvent.EVENT_WUW_END) {
        // 唤醒时的音频数据回传结束
    } else if (event == Constants.NuiEvent.EVENT_ASR_ERROR) {
        // 发生错误
    }
}
@Override
public void onNuiAssistEventCallback(Constants.NuiEvent event, String info, int info_len,
                                        byte[ ] data) {
    if (event == Constants.NuiEvent.EVENT_WUW_DATA) {
        // 唤醒瞬间的音频数据
    } else if (event == Constants.NuiEvent.EVENT_AEC_DATA) {
        // 开启SDK内部AEC且aec_params.enable_aec_data_callback为true时, 回送AEC处理后的音频
    }
}
04 典型产品场景示例
Qwen Audio 移动端 SDK 不限定上层业务服务。开发者可以在识别结果与语音合成之间接入自己的业务系统、知识检索、意图理解或大模型服务,将端侧音频能力、百炼语音能力与产品界面连接起来。下面以三种典型产品形态为例,说明如何按需选择能力,构建不同的语音体验。。
场景一:语音唤醒后接入自有服务
该场景以唤醒词作为交互入口,适用于导航、车载、智能终端等需要“先唤醒、再服务”的产品。设备在播放导航或 AI 播报时,AEC 抑制播放声音回灌,帮助 KWS 和 ASR 更准确地接收用户指令;识别完成后,应用将结果交给自有业务服务处理,并将服务结果同时展示和播报。
工作流如下:
- 麦克风音频先进入 AEC,将扬声器播放的导航或播报声音作为参考信号,降低回声干扰,提升后续指令接收的准确性;
- KWS 在处理后的音频中检测唤醒词,将唤醒作为进入服务链路的入口;
- Qwen-Audio ASR 将用户语音实时转为文本;
- 文本进入自有业务服务,例如地点搜索、路线规划、订单查询或大模型问答;
- 自有业务服务将结果分别传给应用界面和 Qwen-Audio TTS,实现文字、卡片或地图结果展示与语音播报;
- 播放音频继续回送至 AEC,形成可持续工作的闭环。
场景二:一问一答的语音交互
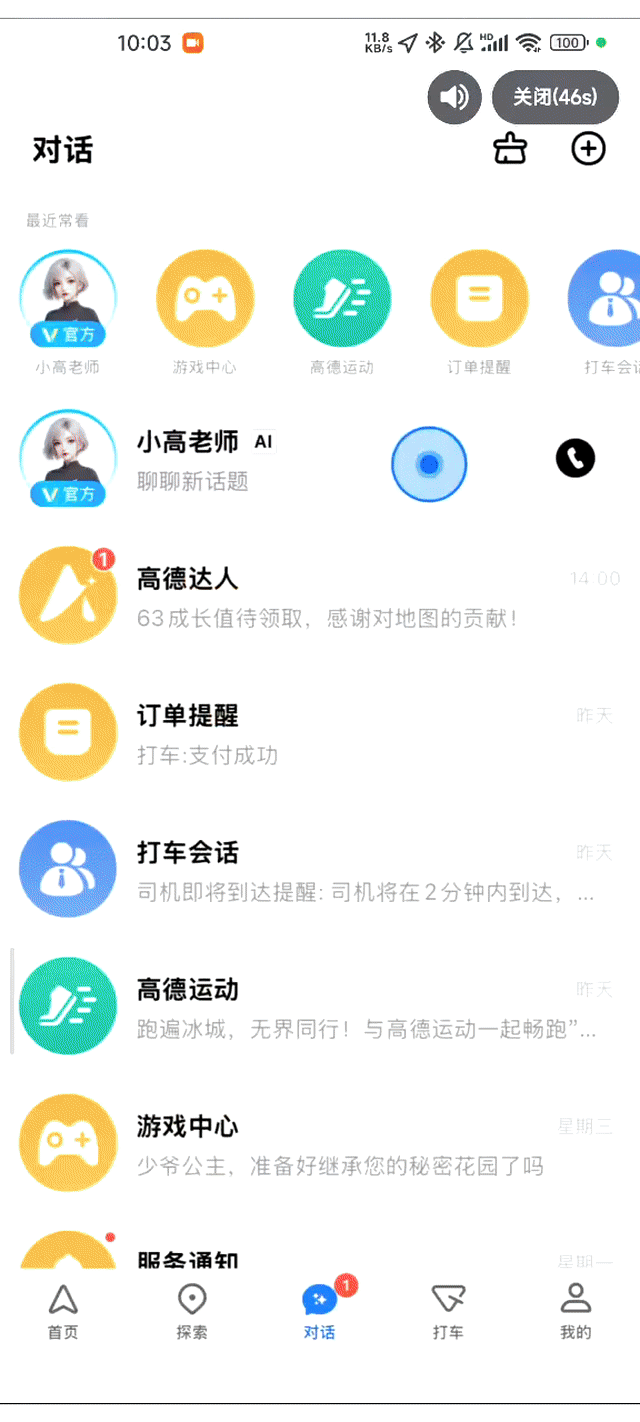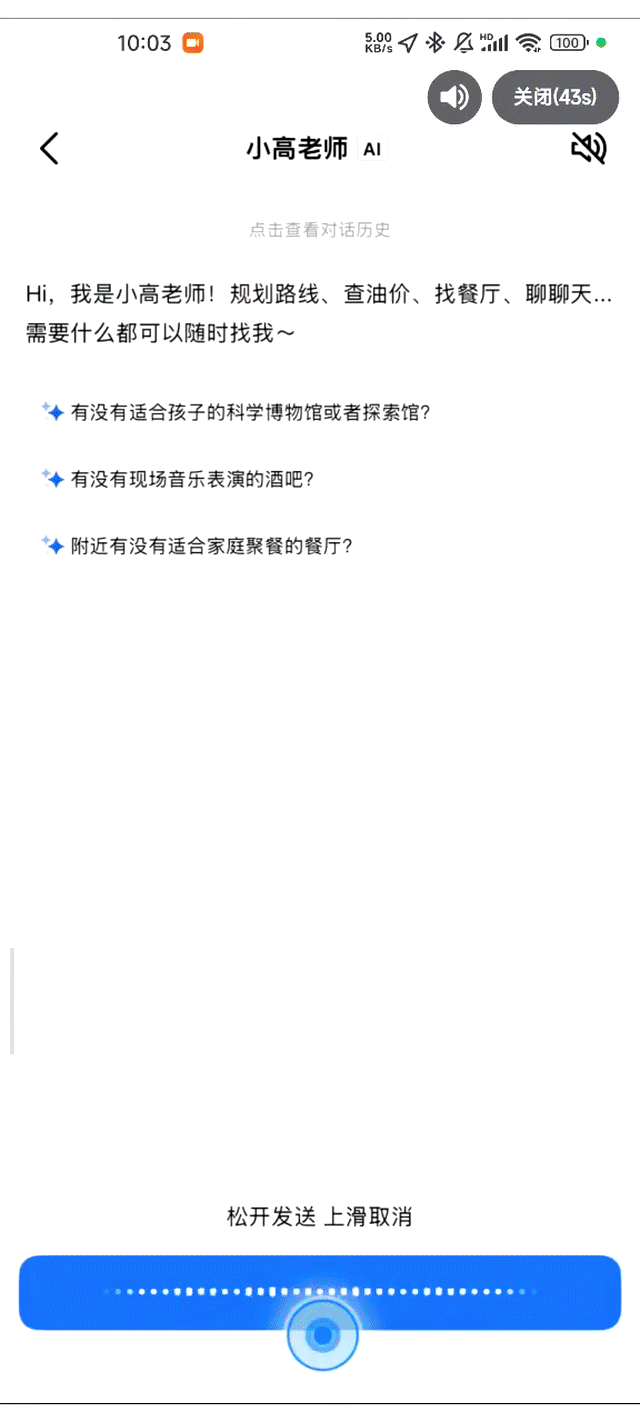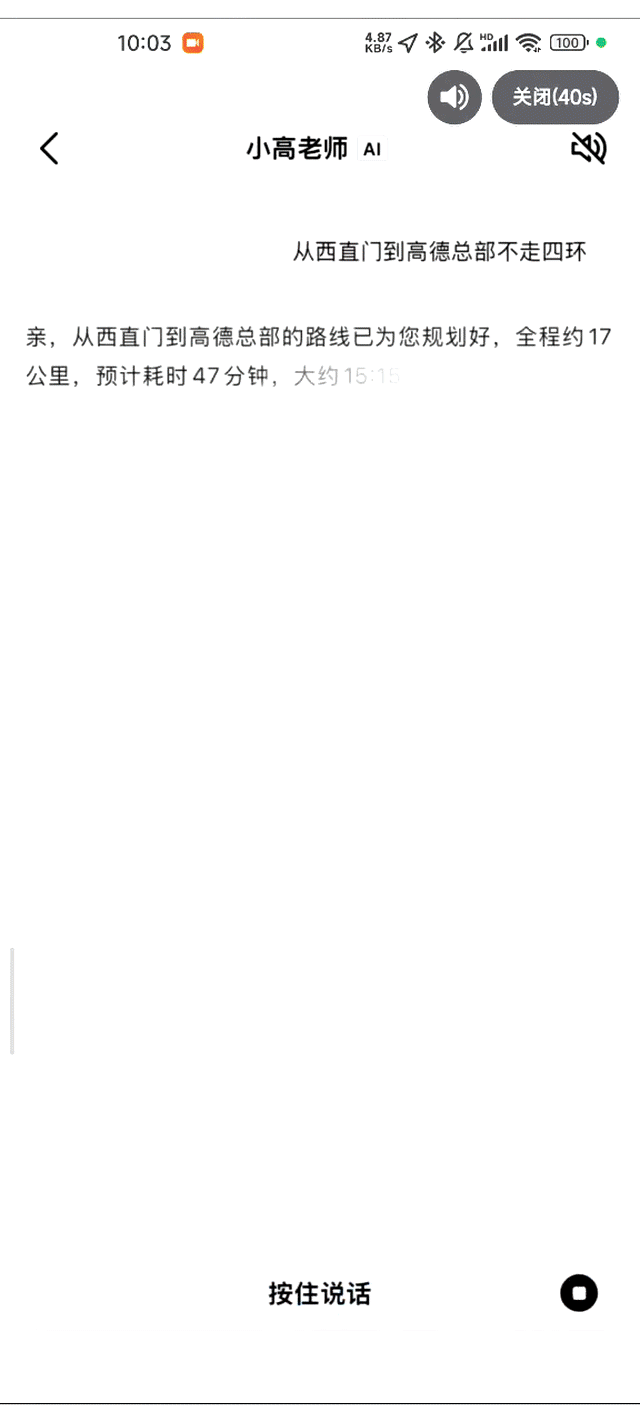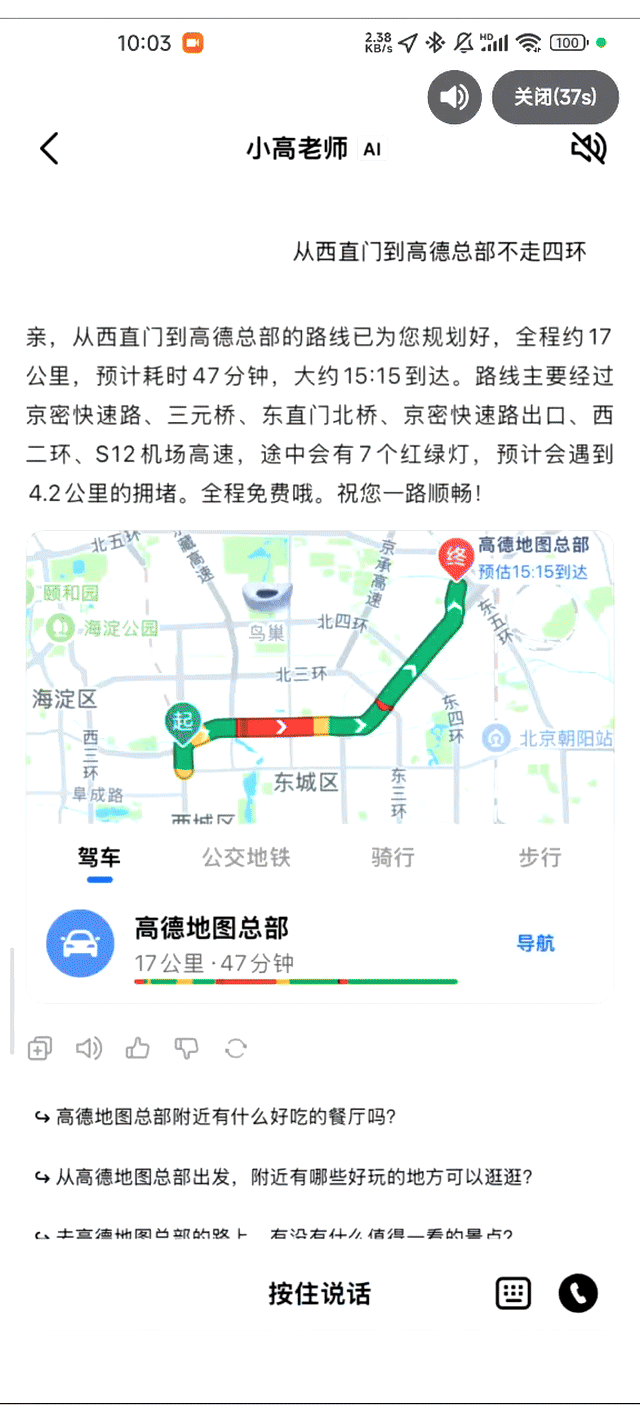
该场景是一种一问一答的简洁交互模式,适用于应用内语音搜索、对话助手和指令反馈。用户通过按键或麦克风直接发起一次语音请求,无需唤醒环节;应用将识别文本送往自有服务,并把本轮返回结果同步用于页面展示和语音播报。
工作流如下:
- 用户的语音输入由 Qwen-Audio ASR 转为文本;
- 文本进入自有业务服务,完成问答、搜索、指令处理或内容生成;
- 自有业务服务将返回结果分别传给应用界面和 Qwen-Audio TTS;
- 应用展示文本、卡片或对话消息,同时由 Qwen-Audio TTS 将结果流式合成为音频并播放,实现“看得到,也听得到”的反馈。
场景三:支持自定义工具的实时语音对话
在实时对话中,应用可以将天气查询、票务查询、搜索、订单处理等自有能力声明为工具。模型理解用户语义后,可在需要外部信息或业务执行时发起 function_call;服务返回调用结果后,模型结合结果继续生成实时文本与语音回复。
工作流如下:
- 麦克风音频经过 AEC 处理后进入 Qwen-Audio Realtime,降低播放回声对实时对话的干扰;
- 应用预先声明自定义工具及其调用参数,供模型在对话中按需选择;
- 模型理解语义并作出工具决策,需要执行外部能力时向自有服务发起
function_call; - 自有服务执行天气、票务、搜索或其他业务逻辑,并将调用结果返回模型;
- 模型将工具结果融入本轮回复,持续输出文本和语音;
- 实时语音回复送往扬声器播放,播放参考同时回送 AEC,支持连续自然的多轮对话。
这一模式的关键在于:自有服务不必被改造成独立的语音产品,只需以工具形式接入,即可成为实时语音对话可调用、可执行的业务能力。
三个场景的差异主要体现在交互入口和业务深度:场景一以唤醒为入口,并通过 AEC 帮助设备更准确接收指令,适应持续播放和免手操作的环境;场景二采用直接的一问一答模式,链路更轻量;场景三进一步把自有服务作为工具接入,让实时语音对话可以完成实际任务。它们都保留自有服务的业务决策权,开发者可按产品需求扩展模型、交互和展示方式。
结语
把复杂的语音工程转化为简单、可组合的产品能力,依赖的不只是单个模型。语音大模型让机器具备了更强的理解和生成能力,但完整的产品体验来自原子能力在设备端、云端与业务系统之间的协同:麦克风负责把用户声音带进系统,端侧 AI 负责过滤回声、判断时机和协同交互,云端模型负责理解与生成,扬声器再把结果带回用户身边。
Qwen Audio 移动端 SDK 面向 Android、iOS、HarmonyOS 提供一套可组合的移动端语音底座:以 C++ 封装端侧 KWS、VAD、AEC 和 TTS 等能力,以统一协议连接百炼云端 ASR、TTS、Realtime、翻译与转写能力,并通过统一 API 与能力路由,让开发者按参数选择所需能力、直接构建产品体验。无论目标是可被唤醒的语音助手、实时双语会议,还是能够沉淀内容的智能记录工具,都可以基于同一套 Qwen Audio 移动端 SDK 语音能力组件,组合出适配目标用户与设备环境的交互方案。
把语音能力交给 SDK,把体验交给产品——现在就动手接入百炼语音 AI 移动端 SDK,让你的应用真正"听得懂、说得出、答得准"。
接入说明
本文代码主要用于说明技术链路,workspace、临时 Token、模型路径、工具定义和错误处理等内容,仍需根据实际项目补充。实际接入时,请根据目标 SDK 版本核对地域连接地址及输入输出采样率,并避免在移动端硬编码长期 API Key。