给客服与质检团队做语音转写(ASR,声音进去文字出来),规范里最容易被漏掉的一节是专有名词。产品名、人名、地名听错之后,转写稿在检索、归档、质检打分三个环节各错一次,改起来比在识别这一步就把词修对麻烦得多。
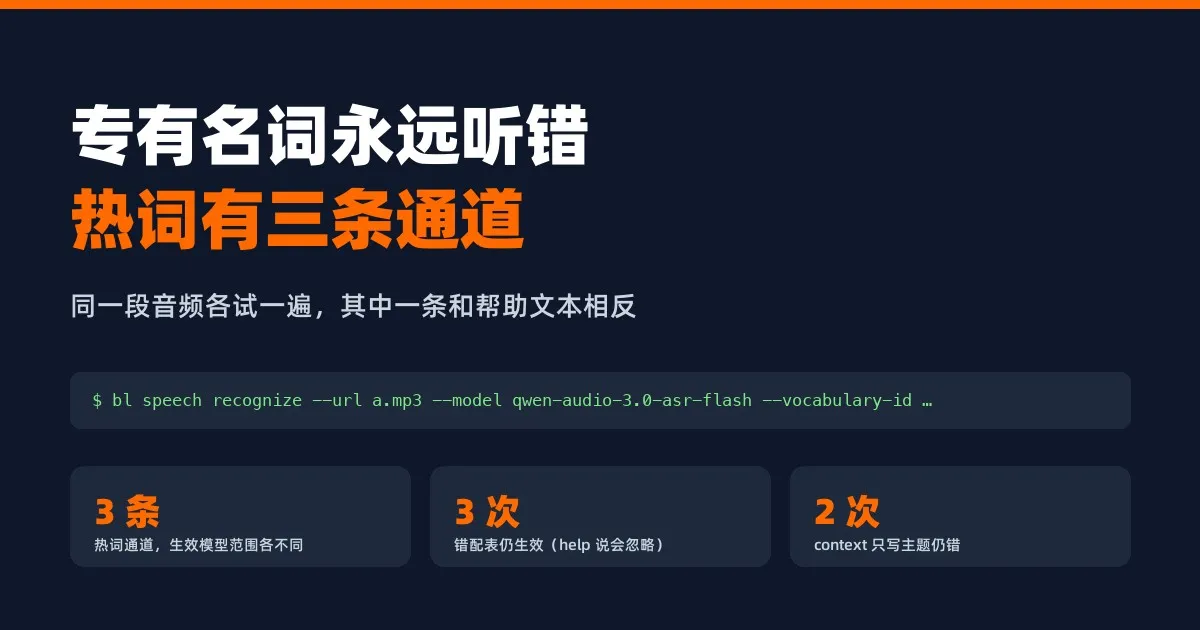
阿里云百炼的语音识别给这件事配了三条热词通道:预编译热词表、即时热词、上下文词表。热词表是提前递给识别服务的一张清单,意思是"这些词要认准"。三条都能把词修对,但生效的模型范围不一样,配错时的行为也不一样。规范里如果只写一句"加热词表",不同的人会做出三种不同实现。
这一份口径来自一轮对照:素材是我用语音合成现做的两段(不是真实通话录音),转写模型 qwen-audio-3.0-asr-flash,命令行工具 bl 2.1.0,输出是 2026-10-14 我在自己电脑上跑出来的。语音识别有随机性,每条读数都带重复次数,规范也按这个方式落笔。
一、三处容易被写进错误规范的地方
第一处是把"加热词"当成一个动作。实际上是三个互不相同的入口,资源形态、生效范围、取值约束都不同,第二节的对照表可以直接抄进文档。规范里要写明用哪一条,不能只写"配热词表"。
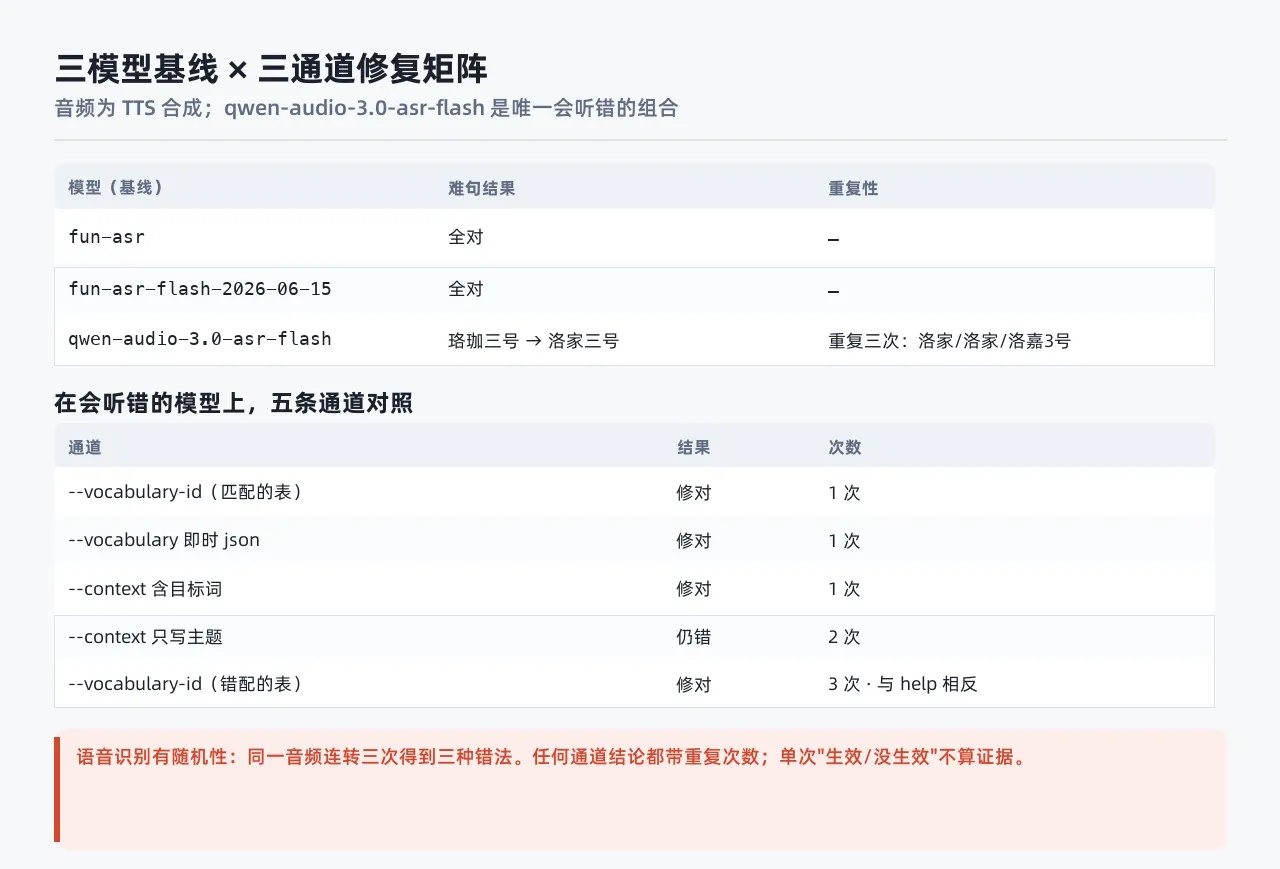
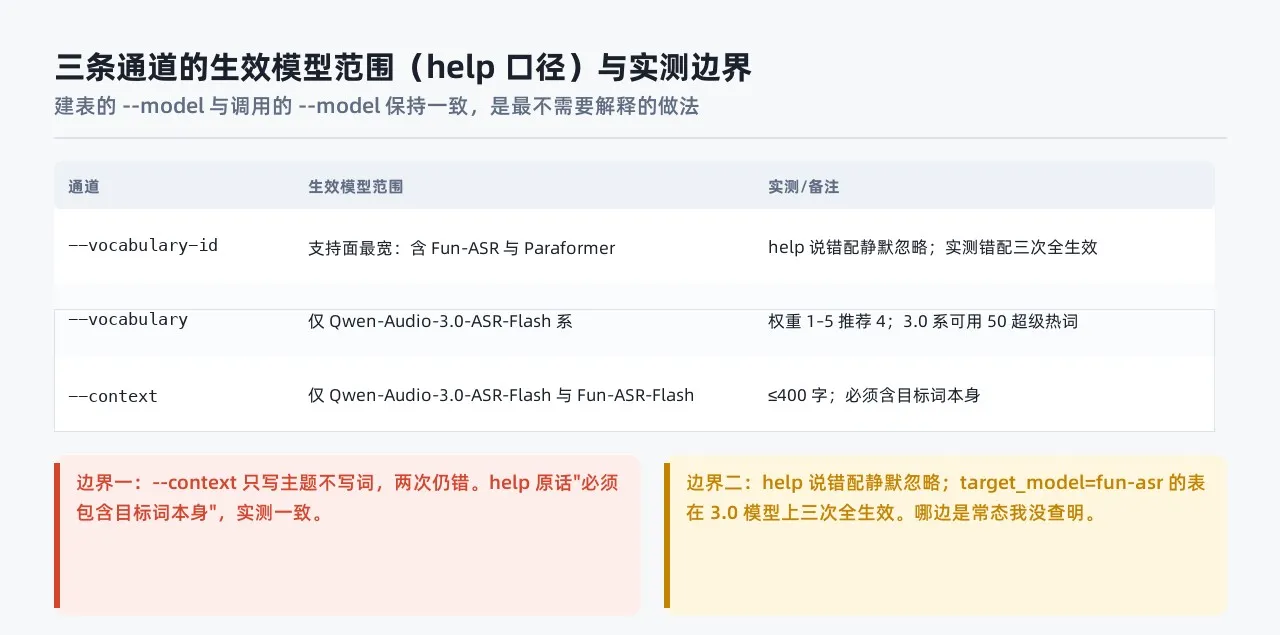
第二处是把 --context 当话题提示器。它要的是目标词本身:我把这个参数换成主题描述连试两次,两次都还是洛家三号。帮助文本的原话是"必须包含目标词本身,只写主题描述作用很小",实测与它一致。
第三处是拿"错配会被静默忽略"当兜底。帮助文本对 --vocabulary-id 与建表时的 --model 都写着不一致则热词表被静默忽略;我按错配组合连试三次,三次都生效了,没复现忽略。规范里应当写"两边保持一致",不写"错配没关系"。
这三处的共同点是都不报错。返回照给,转写稿也出,错的是后面拿这份稿子去做的检索、归档与质检打分。
二、能力面:三条通道与生效范围
| 通道 | 资源形态 | 参数 | 生效模型范围(帮助文本口径) | 约束 | 这一段合成音频上的读数 |
|---|---|---|---|---|---|
| 预编译热词表 | 云端持久资源,vocab- 开头的 ID |
--vocabulary-id <表 ID> |
建表 --model 与调用 --model 一致 |
权重 1 到 5,推荐 4;Qwen-Audio-3.0 系可用 50 的超级热词;--prefix 小写字母加数字、最长 10 位 |
1 次修对 |
| 即时热词 | 无持久资源,内联 JSON | --vocabulary '{"珞珈三号":4,"仇池":4}' |
只对 Qwen-Audio-3.0-ASR-Flash 系列生效 | 权重口径同上 | 1 次修对 |
| 上下文词表 | 无持久资源,纯词清单 | --context "珞珈三号 仇池" |
Qwen-Audio-3.0-ASR-Flash 与 Fun-ASR-Flash | 最长 400 字,必须含目标词本身 | 1 次修对 |
基线读数:同一段合成音频(内容是"请把 XQ-7734 号工单转给岑巩县的冉雍,抄送珞珈三号项目组的仇池和濮阳办事处"),fun-asr 与 fun-asr-flash-2026-06-15 全对,qwen-audio-3.0-asr-flash 把珞珈三号听成洛家三号、其余全对;这家连转三次拿到过"洛家三号""洛家三号""洛嘉3号"三种写法。
bl speech vocabulary create --model qwen-audio-3.0-asr-flash --prefix hw1014a --words '{"珞珈三号":4,"仇池":4}'
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --vocabulary-id <表 ID>
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --vocabulary '{"珞珈三号":4,"仇池":4}'
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --context "珞珈三号 仇池"
表里三条通道各只有 1 次读数,能说明通道可用,不构成稳定性结论。这也是第三节第 5 条要求"至少重复两次再写进文档"的原因:验收时按第四节的判据表重跑,用你们自己那次的读数替换表头日期。
三、团队规范五条(可直接抄进文档)
- 上热词之前先跑基线。 用团队自己的合成音频样本或已授权素材,确认当前模型组合真的会听错。基线全对的组合加热词没有可测量的增量,规范里不写"默认全量加热词"
- 词表按生命周期选通道。 长期不变、多个服务共用的词走
vocabulary create+--vocabulary-id;一次性调用走--vocabulary;只有词清单、不想维护权重走--context --context里放词,不放主题描述。 必须含目标词本身(实测只写主题两次仍错),400 字上限留给词条- 建表的
--model与调用的--model保持一致。 帮助文本写的"错配静默忽略"这一轮没复现(错配三次均生效),哪边是常态没查明,因此规范按"两边一致"写,不把忽略行为当兜底 - 任何通道结论至少重复两次再写进文档。 语音识别有随机性,单次结果不构成判据
四、验收判据表
新环境接入、模型换版或 CLI 升级之后按这张表跑一遍,七项都对得上才算口径没变。跑完把日期与 bl 版本记在表头,下一次的读数才有可比性。
| 验收项 | 期望读数(2026-10-14) | 判定命令 | 不符合时的处理 |
|---|---|---|---|
| 基线是否听错 | qwen-audio-3.0-asr-flash 把珞珈三号听成洛家三号,三次三种写法 | bl speech recognize --url <合成音频> --model <m> --language zh 连跑三次 |
若三次全对,说明模型行为已变,第三节第一条重写,热词改为按需启用 |
| 通道一 | 1 次修对 | vocabulary create 后加 --vocabulary-id |
若未修对,先核表的 target_model 与调用 --model 是否一致 |
| 通道二 | 1 次修对 | 加 --vocabulary |
若未修对,核模型是否属 Qwen-Audio-3.0-ASR-Flash 系列 |
| 通道三 | 1 次修对 | 加 --context |
若未修对,核模型范围与 400 字上限 |
| 只写主题 | 两次仍错 | --context "卫星工单项目组办事处" |
若修对了,说明主题描述开始起作用,第三节第三条改写 |
错配 --vocabulary-id |
三次全生效,与帮助文本相反 | 表 target_model=fun-asr,调用 --model 为 3.0 |
若被忽略,说明帮助文本口径复现,第三节第四条改回"错配即失效" |
| 删除闸 | 不带 --yes 被拦,带 --yes 删除,复核为空 |
bl speech vocabulary delete --id <id> |
若未拦截,说明高风险闸行为已变,先停用脚本里的自动删除 |
五、参数名与错误码口径
参数名不统一是这组命令里最容易抄错的地方,规范里建议直接把对照表贴出来。
| 命令 | 参数 | 说明 |
|---|---|---|
bl speech vocabulary create |
--model / --prefix / --words |
表的目标模型 / 前缀(小写字母加数字,最长 10 位)/ 词与权重的 JSON |
bl speech vocabulary list |
无 | 列出工作空间里的表 |
bl speech vocabulary get |
--id |
查单张表,可读 target_model 字段 |
bl speech vocabulary delete |
--id / --yes |
删除;不加 --yes 会被拦 |
bl speech recognize |
--vocabulary-id / --vocabulary / --context |
三条热词通道的入口 |
| 返回 | 口径 | 规范里怎么写 |
|---|---|---|
HTTP 403 AllocationQuota.FreeTierOnly |
免费额度用尽,需续费用或在控制台关掉"仅用免费额度"模式 | 只引错误码,不写余量数字;余量以控制台额度页当天读数为准 |
delete 未加 --yes 被拦 |
高风险闸,提示永久删除、不可撤销 | 自动化脚本显式传 --yes,并把拦截当失败分支处理 |
get 一个已删 ID 返回 400 |
资源不存在 | 作为删除生效的复核信号 |
get --vocabulary-id <id> 报未知参数 |
get 与 delete 用 --id,recognize 才用 --vocabulary-id |
参数名对照表进文档,避免复制粘贴串命令 |
我这一轮想加测的第四个模型 qwen3-asr-flash 就是撞上第一条:返回 HTTP 403 AllocationQuota.FreeTierOnly。余量我这边查不到(控制台会话过期),规范里也不写数字。
六、资源纪律:共享工作空间里的建表与删表
工作空间里原本有三张别人 09-09 建的表,全程只 list 和 get,没有改也没有删。自己建的两张用独立前缀,测完删除,删完做两次复核:bl speech vocabulary list 里只剩那三张,bl speech vocabulary get --id <已删 ID> 返回 400 资源不存在。
团队规范里建议把这三步写成硬性动作:独立前缀让资源可辨识;删除必须显式加 --yes;删完用 list 加 get 双向确认。只跑 delete 不做复核,等于不知道删掉的是哪一张。
鉴权口径一并记清:合成音频、转写、建表删表都要 API Key,list 和 get 同样要 Key,这组命令没有完全免鉴权的那一档。Key 在 API Key 签发页 签发,工具入口在 CLI 安装页,一条 npm 命令。
七、零价格口径
这一轮的花费与额度数字不进规范文档。这类数字有有效期,抄进文档就是过期源;用量与余量统一走控制台账单页与额度页,按当天读数看。规范里需要写的是判据本身:哪条通道在哪个模型范围生效、哪条约束是硬的、哪些读数会随模型换版变化。
会变的三类是模型在架名单、额度状态、热词表清单,命令签名相对稳定。所以验收要连 bl 版本号一起记,过期读数不沿用。
八、边界与移交
不在这份口径里的:字幕链路(识别加翻译加时间轴)是另一篇的事,这里只共用 recognize 一条命令;实时流式识别(realtime 系列模型)不在本规范范围;真实带噪素材我手里没有,这一轮的音频是合成的,噪声环境下的表现以团队自己那批素材的读数为准。
第三节五条与第四节判据表可以直接抄进团队文档,抄的时候把表头日期换成你们自己那次验收的日期。控制台侧的入口在 阿里云百炼首页,账单页与额度页从那里进。按季度重跑一次判据表,就能保证这份口径不过期。