团队接 agent,第一个要定的往往不是用哪个模型,是知识放哪。阿里云百炼在 CLI(bl)里给了两个位置:bl knowledge 建知识库、包一层检索服务供所有 agent 查;bl memory 按 user-id 记节点。两者都能让 agent"知道它本来不知道的事",但隔离粒度、治理粒度、ID 体系三样全不一样,选错的代价不是效果差,是查不到或者串了,而且都不报错。
这篇把这两条路径的能力边界、资源模型和度量口径摊开,末尾给一份可以直接抄进团队规范的六条清单。
下面的读数都是 2026-10-13 我在自己电脑上跑出来的,bl 2.1.0。涉及别人工作空间的知识库名和 ID 一律匿名化,占位符写成 <库 ID> <检索服务 ID> <合成标识>;记忆节点实验全程在一个合成 user-id 下完成,add → search → delete → 复核为空四步齐全,没有触碰任何真实用户的记忆。
一、两条路径在能力栈里的位置
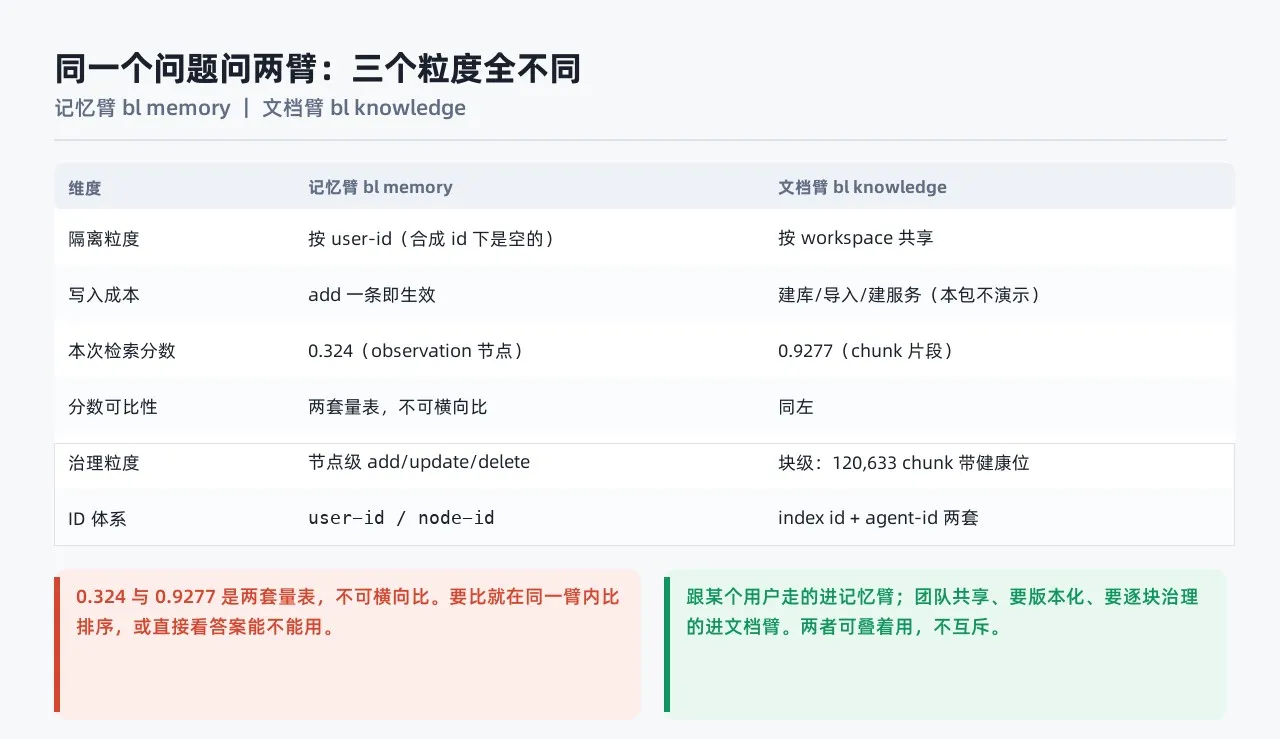
bl knowledge 是资源型命令组,管的是工作空间级的共享资产:知识库、检索服务、块。bl memory 是会话型命令组,管的是用户级的私有状态:记忆节点。
| 对照项 | 文档臂 bl knowledge |
记忆臂 bl memory |
|---|---|---|
| 隔离单位 | 工作空间共享,外面包一层检索服务 | user-id,一人一份 |
| 答案形态 | 带出处的原文片段 + 来源 URL | 一条被归纳过的观察节点 |
| 治理单位 | 块(chunk),可逐块改 | 节点,整条取舍 |
| 规模量级 | 单库可达十二万块 | 按用户线性增长 |
两条路径不互斥。生产上常见的形态是同一个 agent 两条都挂:文档臂回答"公司规定是什么",记忆臂回答"这个人上次要求过什么"。
二、资源模型:两层资源,两套 ID
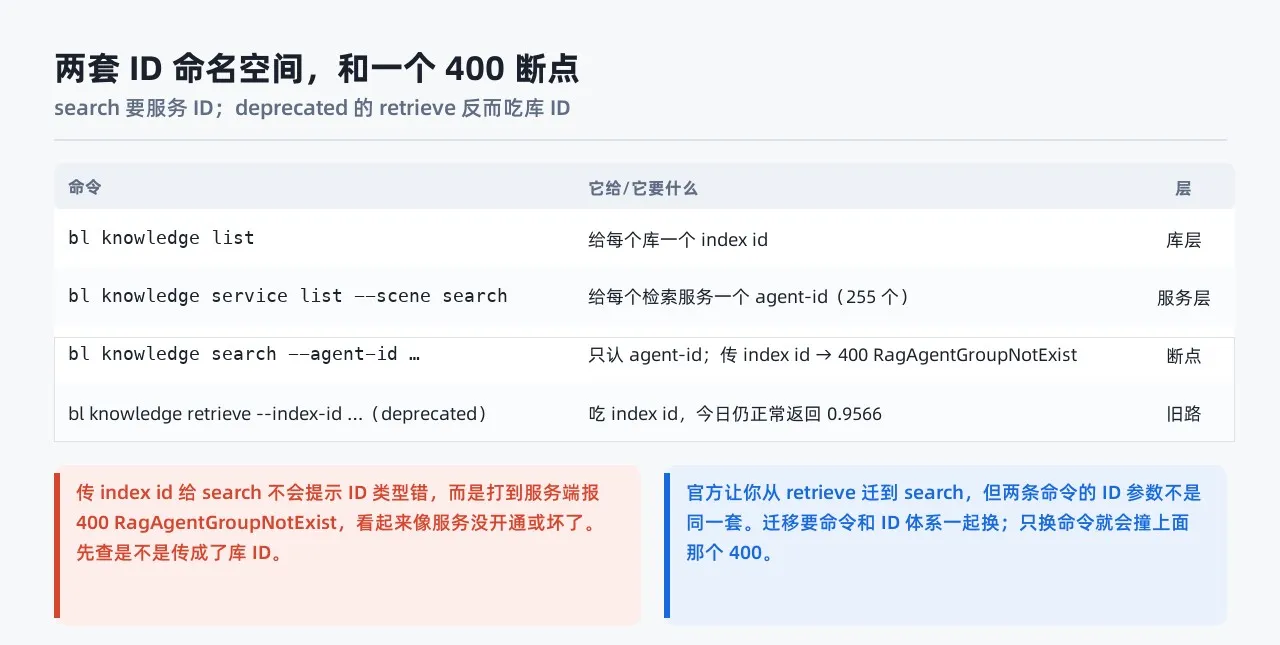
文档臂不是"库 → 查"一步到位,中间隔着一层检索服务。
第一层,知识库本身:
bl knowledge list
它给每个库一个 index ID。第二层,检索服务:
bl knowledge service list --scene search
我这边工作空间里有 255 个检索服务、258 个问答服务(问答恒比检索多 3 个,两天前是 254/257,也是差 3)。命令跑完会在末尾自己打一句提示:拿上面的 agent_id 去喂 knowledge search。
检索一次:
bl knowledge search --agent-id <检索服务 ID> --query "会话事件流 SSE 服务端推送哪些事件"
1.4 秒返回,头两条相关度都是 0.9277(文档臂量表,与记忆臂不可横向比),每条带文档名、标题、正文片段和来源 URL。命中的是平台公开文档里"服务端推送事件"那一节,连事件表格都原样回来了。
这里有一个必须写进团队排错手册的断点。 把第一层的 index ID 传进 --agent-id,不会得到"ID 类型不对"的提示,而是:
Error:       Agent application not found.
Status:      HTTP 400 (RagAgentGroupNotExist)
参数名叫 agent-id,值域却是"检索服务"这一层的 ID;index ID 类型上同样是合法字符串,前置校验拦不住,只能等服务端查表查不到。400 配"Agent application not found",一线同学的第一反应通常是服务没开通或坏了,实际是值域错了,跟服务状态无关。
三、迁移口径:deprecated retrieve 不是平替
帮助文本里 bl knowledge retrieve 标着 deprecated,让改用 knowledge search。但旧命令的参数是 --index-id:
bl knowledge retrieve --index-id <库 ID> --query "会话事件流 SSE 服务端推送哪些事件"
我这天跑它照样正常返回,相关度 0.9566。
对团队的实际含义是:这次升级要换两样,命令名换,ID 命名空间也换。存量脚本里凡是把 index ID 存成变量再喂给检索的,迁移时必须一并改。deprecated 说明只讲用哪条替代,没讲替代命令换了 ID 体系,这个断点不会在任何文档里被标红。
四、记忆臂:user-id 是第三套命名空间
记忆臂的隔离单位不是库也不是服务:
bl memory list --user-id <某个用户标识>
同一个工作空间里,不同 user-id 的记忆互不可见。我拿一个合成标识查,返回"No memory nodes found",一个干净的空库,正好做闭环验证。
写入:
bl memory add --user-id <合成标识> --content "用户偏好:周报用四段结构,一级条目不得增删。"
返回一个 memory_node_id。检索:
bl memory search --user-id <合成标识> --query "周报结构有什么要求"
命中,相关度 0.324(记忆臂量表,与文档臂不可横向比),节点类型 observation,状态 valid。返回的不是写进去那句原文,是一条被归纳过的观察节点。
删除并复核:
bl memory delete --node-id <节点 ID> --user-id <合成标识>
bl memory list --user-id <合成标识>
list 回到"No memory nodes found",search 剩 0 条。对团队的意义是:记忆节点有完整的生命周期管理,验证类实验可以用合成 user-id 隔离跑,不需要在生产用户数据上试。
五、治理粒度:十二万个块的库怎么维护
bl knowledge chunk list --index-id <库 ID> --page-size 3 --output json
我查的那个公共文档库返回 total 120,633。每个块的 metadata 里带块级健康位(_chunk_status 为 0、状态消息"成功")、所属文档 ID、文档名、来源 URL,还有一个"是否展示块内容"的开关位。
改块用 bl knowledge chunk update,签名要求同时给库 ID、块 ID、文档 ID 三个键,新内容限 10 到 6000 字。这条我只引签名没执行,它改的是共享资源。
于是文档臂可以逐块做四件事:看健康、改内容、切可见、顺藤摸到源文档。哪一块解析坏了、哪一块该下线,都有抓手。十二万块的库里坏块是常态,块级健康位是刚需。
记忆臂只有节点级的增改删查,没有块级概念。一条记忆就是一个节点,要么在要么不在。这不是能力差距,是分工:需要逐块治理的是资料,需要整条取舍的是关于某个用户的事实。
六、度量口径:两臂分数不可换算
文档臂的 0.9277 和记忆臂的 0.324 是两套量表上的数:一个是 chunk 与查询的检索相似度,一个是记忆节点与查询的匹配分,算法和取值范围都不同。我这次只有一组对照,不做量表换算,也不据此判断哪条路径更准。
这一条要写进规范,因为它容易被监控系统违反:把两臂分数塞进同一张排序表、或者共用一个相似度阈值做召回告警,阈值一定调错,两个数的分布不在一个尺度上。同臂内比较要看同一批查询的排序稳定性,跨臂比较只能看答案能不能直接用。
七、归属决策
| 知识类型 | 归属 | 理由 |
|---|---|---|
| 产品文档、规程、FAQ | 文档臂 | 工作空间共享,可版本化、可逐块治理 |
| 用户偏好、习惯、上次说到哪 | 记忆臂 | 按 user-id 隔离,天然一人一份 |
| 团队规程 | 不进记忆臂 | 塞进某个 user-id,别人查不到 |
| 个人偏好 | 不进文档臂 | 灌进共享库,所有 agent 都被它影响 |
隔离粒度选错比选路更致命,因为选错之后不报错,症状只是查不到或者串了。
八、可抄进团队规范的六条
bl knowledge list拿库 ID,bl knowledge service list --scene search拿服务 ID,两套 ID 分开记录,不复用同一个变量名knowledge search --agent-id只喂服务 ID;出现 400RagAgentGroupNotExist先回查 ID 类型,不按服务故障处理- 从 deprecated
retrieve迁移时,命令与 ID 体系一起换,存量脚本同步改 - 记忆臂写第一条之前先确认 user-id 隔离符合预期,验证类实验用合成标识
- 两臂分数不进同一张排序表,不共用相似度阈值
- 文档臂开放检索前跑一次
chunk list看_chunk_status,坏块先修再上线
九、边界与移交
建库、导入文档、建检索服务这三步会真的往云上写资源,我只给控制台路径不演示命令:知识库和检索服务都在阿里云百炼控制台的知识库、应用分组下建,建完回 CLI 用 list 取 ID。chunk update 的可见性切换同样只引签名。
用量和额度那几条命令走控制台会话,我的会话过期了查不了,需要看剩余额度直接去控制台额度页。记忆臂的画像 schema(profile)那条支线没展开,把检索结果喂回模型需要发一次模型调用,都不在这篇里。
三个入口:CLI 安装页、API Key 签发页、阿里云百炼首页。检索和列清单这几条有 Key 就能跑,建库那几步在控制台点。