自变量机器人(X Square Robot)开源了Wall-OSS-0.5,一个视觉-语言-动作(VLA)模型。在超过20种机器人形态、每轮超过100万条轨迹上完成预训练后,未经任何任务微调的预训练checkpoint直接在真实机器人上完成了17个任务的零样本测试,其中4个任务得分超过80分(满分100)。微调后在15项真实机器人任务上平均进度达60.5,领先π0.5达17.5分。模型权重、训练代码和优化器实现全部开源。
开源地址:
- wall-oss-0.5: https://modelscope.cn/models/X-Square-Robot/wall-oss-0.5
- Paper:https://x2robot.com/api/files/file/wall_oss_05.pdf
- Github:https://github.com/X-Square-Robot/wall-x
什么是魔搭社区?
大多数VLA模型的评测都是在针对特定任务微调之后才进行的——先让模型看几百条示范轨迹学会"怎么拧螺丝",再测试它拧螺丝的成功率。这种模式让人很难判断:是预训练起了作用,还是微调解决了问题?
Wall-OSS-0.5提出的问题是:如果不允许微调,预训练模型能干什么?团队把完全没有任务特定微调的预训练checkpoint直接放到真实机器人上,在17个任务上公开测试,涵盖语义理解、刚性物体操作、柔性物体操作、精细操作和长程多步操作五大类别。
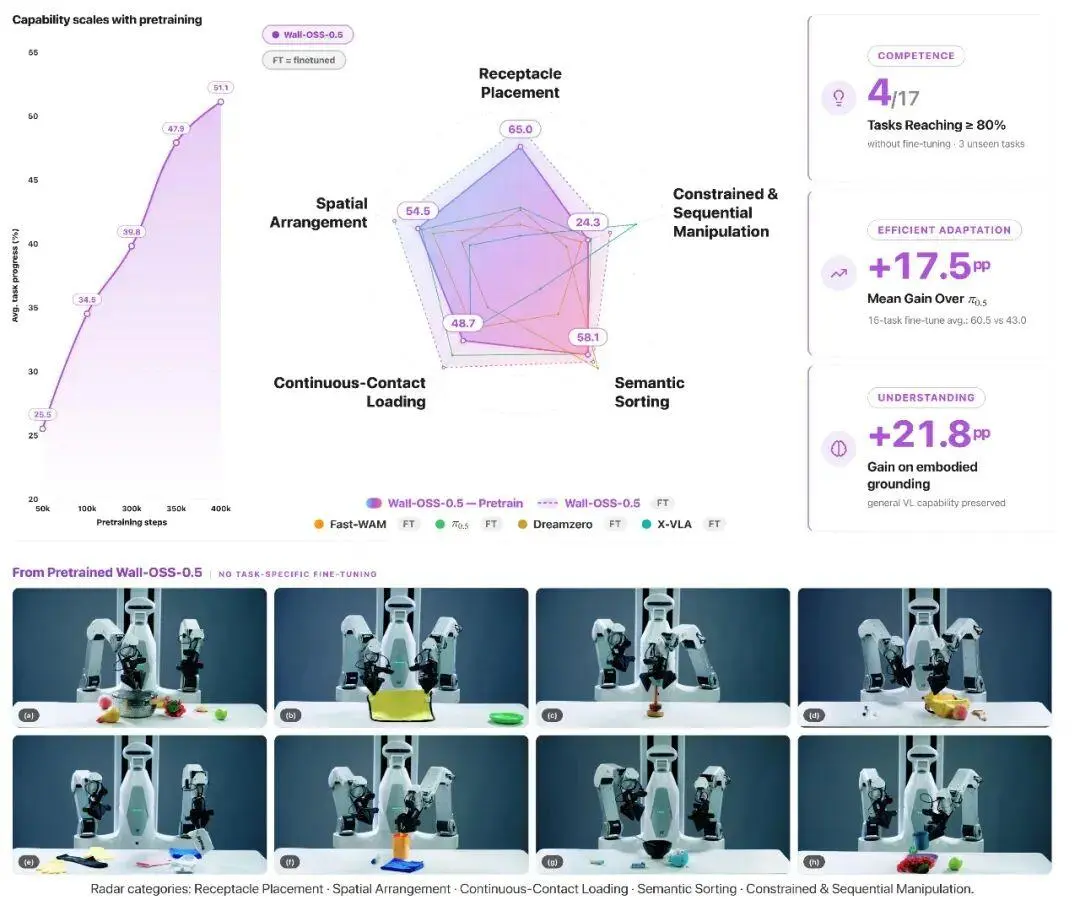
Wall-OSS-0.5 能力概览:涵盖预训练真实机器人行为、下游适配、仿真迁移及具身多模态理解。
零样本测试结果
400k预训练步数的checkpoint在17个零样本任务中,4个任务得分超过80分:
- 积木分拣(Block Sorting):100 分(已见任务)
- 水果分拣(Fruit Sorting):96 分(已见任务)
- 套环叠放(Ring Stacking):86 分(已见任务)
- 绳子收紧(Rope Tightening):82 分(未见任务,柔性操作)
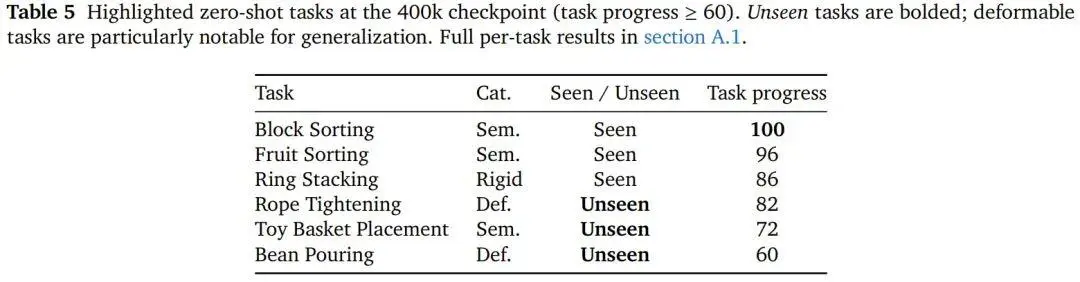
400k 预训练 checkpoint 达到了及格分数的任务(零样本)
其中"绳子收紧"是完全没有在预训练集中出现过的柔性物体任务,需要双臂协调和动态力度调整。以82分完成这个任务,说明模型迁移了可复用的操作能力,而非记住了训练分布中的样板。
能力随训练步数涌现
随着预训练步数从50k增加到400k,已见任务平均得分从26.1升至50.0,未见任务从24.2升至53.6——两条曲线几乎并排上升,说明能力确实在向新任务迁移。论文称之为"阶梯式涌现":积木分拣从约50分跳跃到100分,套环叠放从73分跳跃到100分,都发生在训练中后期的临界点。到400k步时整体平均仍在上升,尚未饱和。
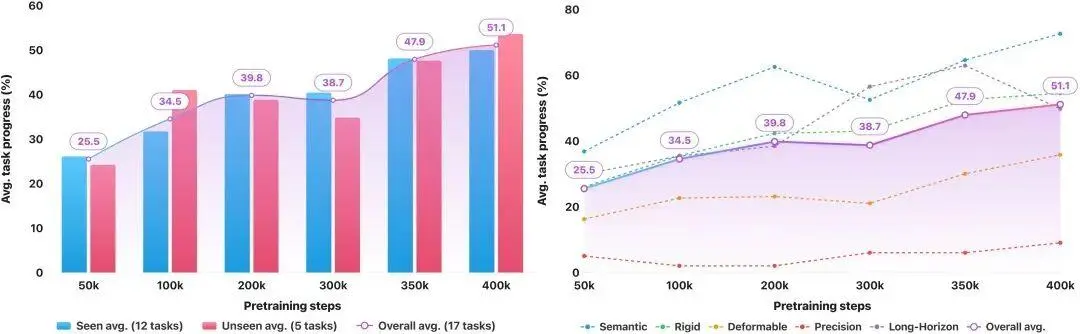
不同的预训练 checkpoint 的零样本评估趋势
当前能力边界
毛巾折叠(10分)、餐桌摆设(9分)、充电器插接(9分)几乎无法完成。这些涉及柔性形变和精细对准的任务,单靠预训练还远远不够,清晰描绘出当前的能力边界。
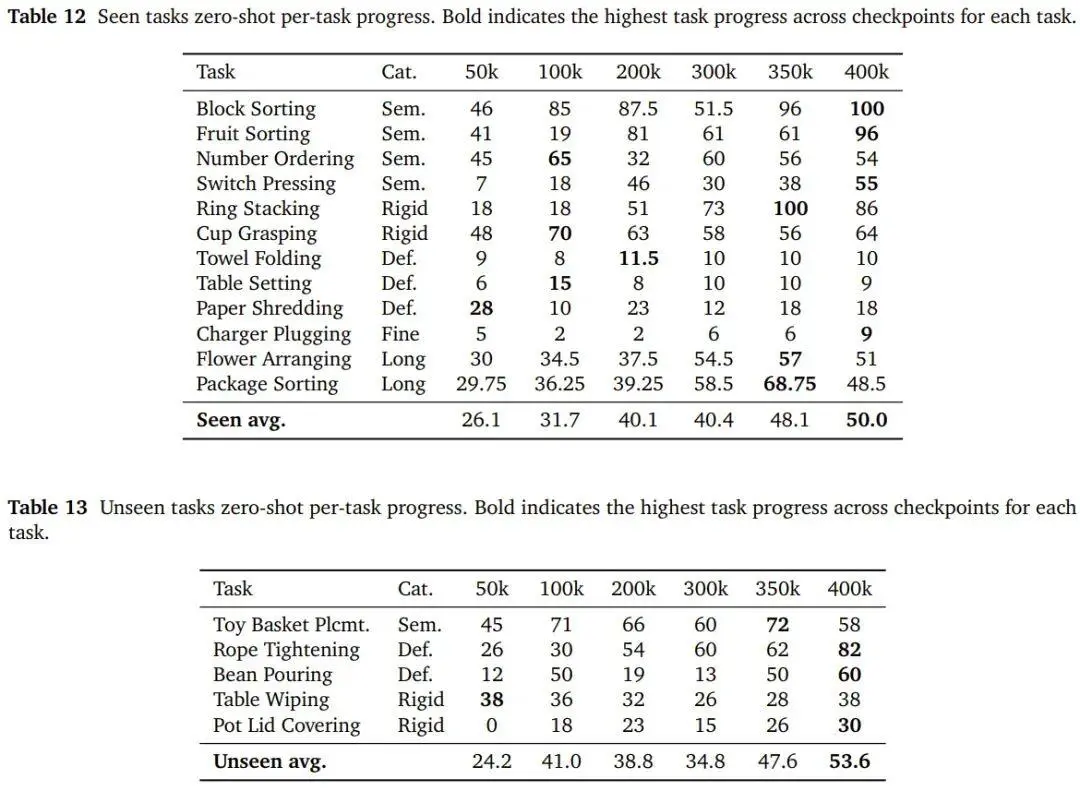
不同预训练步数的 checkpoint 在不同已见和未见任务上的零样本表现。
微调后表现
真实机器人任务
在15项真实机器人任务的微调评估中,Wall-OSS-0.5平均任务进度达60.5,领先π0.5达17.5分。在抽屉整理、碗中放勺等10项核心操作任务的子集上,领先优势扩大到26个百分点。
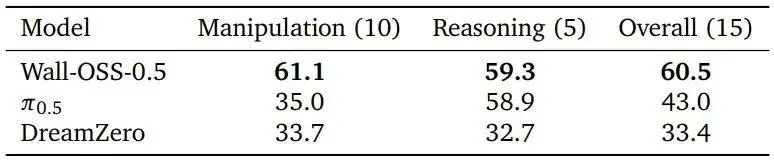
动作训练增强感知能力
接受动作训练后,模型的具身视觉定位能力提升了21.8分,放置推理(Placement Reasoning)提升了11.0分。模型没有因学习动作而退化视觉-语言理解,而是将通用视觉算力倾斜到了操控任务最急需的感知能力上。
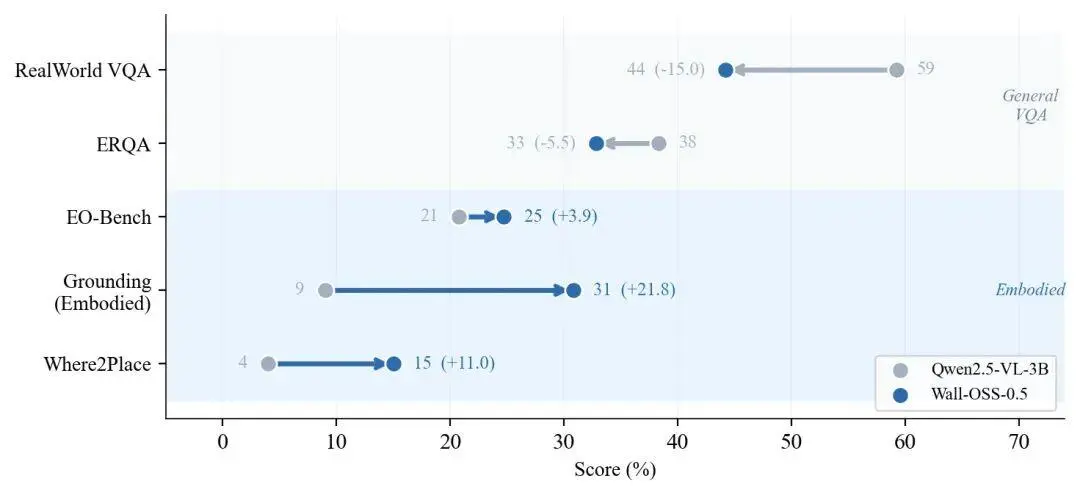
多模态感知能力的「能力重塑」。通过协同训练,模型将通用视觉算力转化为机器人更急需的具身感知能力,在 Grounding 和 Where2Place 等任务上表现出显著的性能跃迁。
核心技术
梯度桥接协同训练
当前主流VLA训练采取分层隔离策略:主干提供特征,动作专家单独训练,主干本身不理解动作。Wall-OSS-0.5将动作离散化为特殊Token,与文本Token拼接到同一条自回归序列中,用交叉熵损失训练。这在主干中架起一座"梯度桥",强迫主干在预训练阶段就把看、说、动统一在同一套表征空间。同时保留流匹配损失用于生成连续动作,辅以多模态交叉熵损失防止视觉语言能力退化。消融实验证明:砍掉这座桥,真实机器人任务成功率断崖式下降。
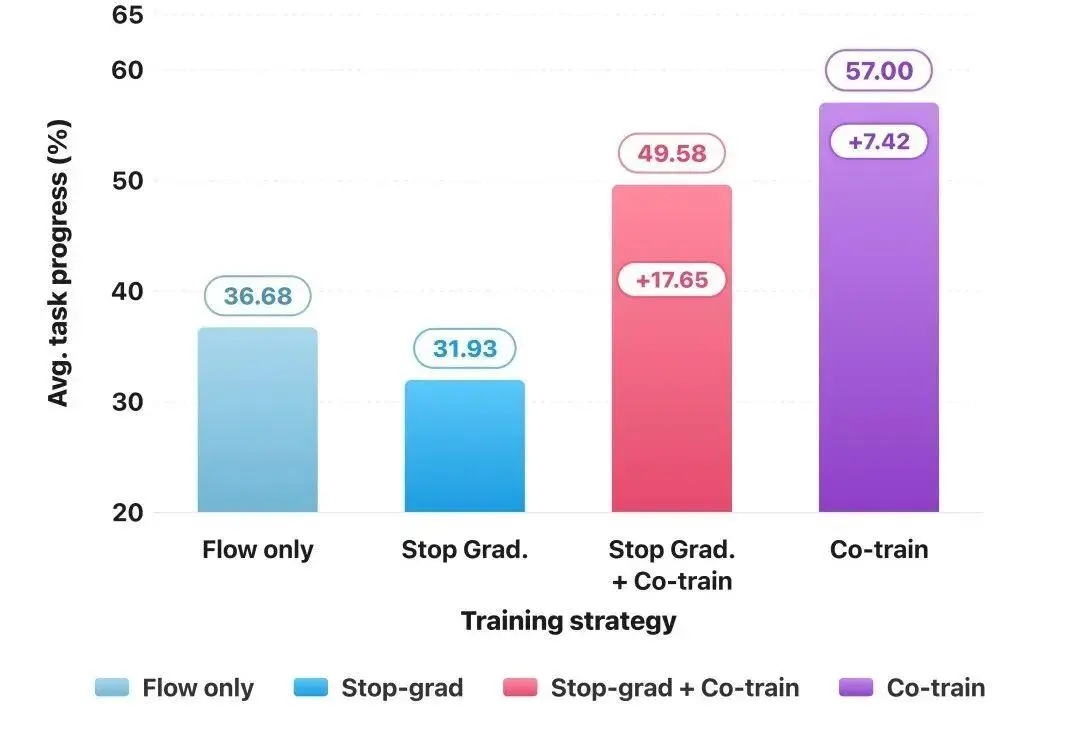
梯度桥接效应验证。实验证明,将动作监督通过「梯度桥」直接引入主干,远胜于简单的分层隔离策略。
视觉对齐的动作Tokenizer
如果离散Token只是对动作做机械的数值压缩,传进主干的只是没有物理意义的编号。Wall-OSS-0.5训练了一个视觉对齐的残差向量量化Tokenizer,在量化动作的同时强制Token表征与对应时刻的视觉特征对齐,并要求其预测下一帧的视觉变化。每个动作Token同时承载"电机怎么转"和"画面怎么变"两层信息,与视觉、语言进入同一个语义空间。
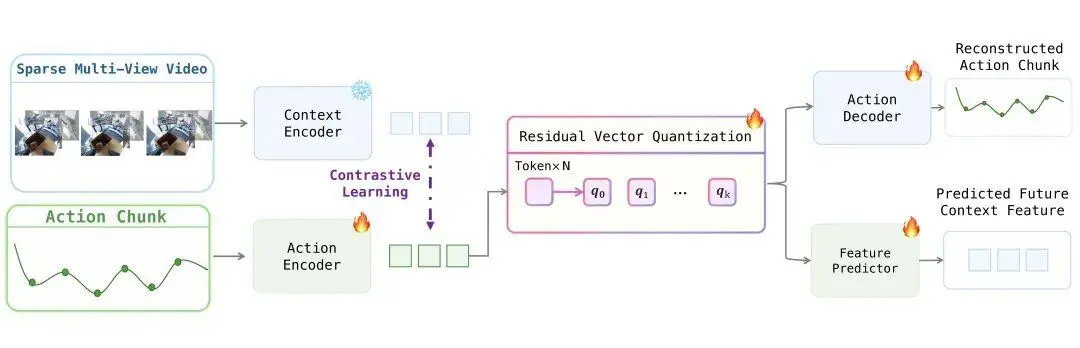
视觉对齐动作 Tokenizer 的工作流。模型不仅压缩动作,更强制动作表征与视觉特征对齐,赋予 Token 真正的「物理含义」。
动作空间监督
流匹配标准做法是预测速度(噪声到目标的瞬时方向),但机器人动作轨迹的低频结构决定任务成败,高频细节几乎无关。团队将损失从预测速度改为预测重建出的最终动作,等价于对轨迹成型初期自动加权——先把骨架打准,再描绘褶皱,收敛速度和稳定性均显著提升。
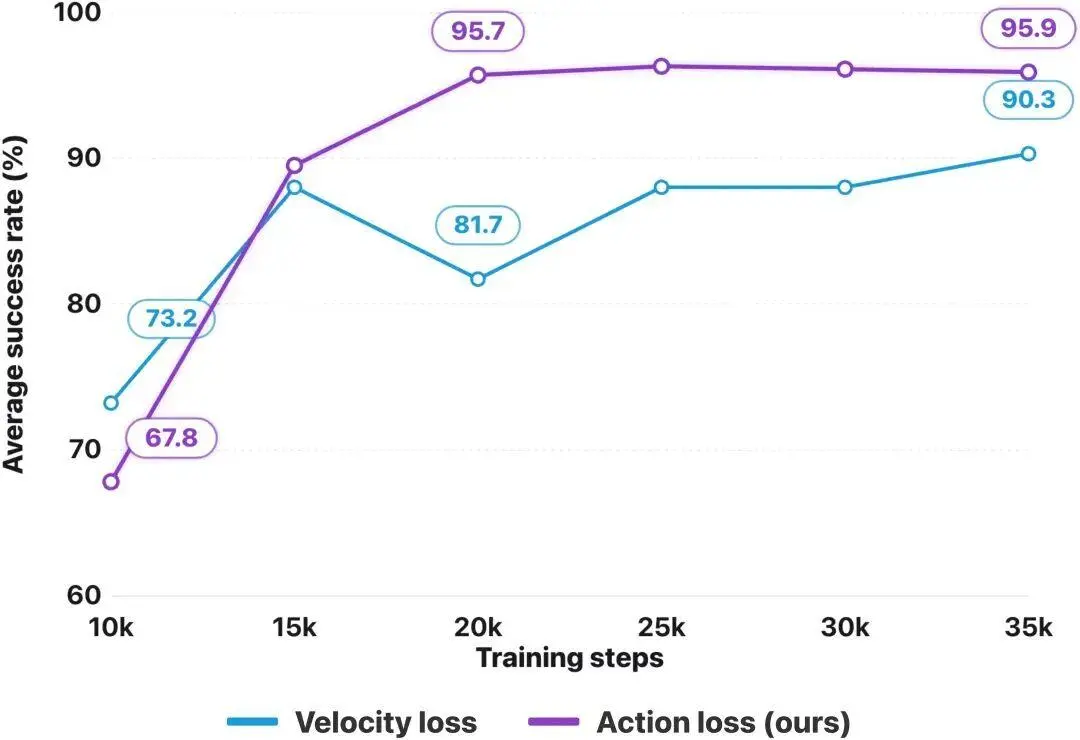
动作空间监督 vs 速度空间监督。通过将学习重心调整至轨迹结构的塑造,模型在训练效率和成功率上均表现更优。
DMuon优化器
多源监督架构导致模型内部参数尺度与梯度强度高度异构。Muon优化器通过Newton-Schulz迭代正交化可缓解这一问题,但单步开销过大。团队实现了DMuon(分布式Muon),结合LPT专属所有权调度和CuteDSL内核,将引入Muon的整体开销从2x降至0.02x,缩减约100倍。
推理与训练
模型推理
环境安装
# Create conda environment
conda create --name wallx python=3.10
conda activate wallx
# Install base requirements
pip install torch torchvision transformers
pip install huggingface_hub
# Install Wall-X from GitHub
git clone https://github.com/X-Square-Robot/wall-x.git
cd wall-x
pip install -e .
模型下载
modelscope download --model X-Square-Robot/wall-oss-0.5 --local_dir X-Square-Robot/wall-oss-0.5
推理脚本示例
"""Load checkpoint and run one inference with fake inputs."""
from __future__ import annotations
import sys
from pathlib import Path
import numpy as np
import torch
CHECKPOINT = "X-Square-Robot/wall-oss-0.5"
repo_root = Path(__file__).resolve().parents[1]
sys.path.insert(0, str(repo_root))
import wall_x._vendor.harrix.adapters  # noqa: F401
from wall_x._vendor.harrix.adapters.registry import build_adapter
from wall_x._vendor.harrix.envs.libero_common import encode_proprio
from wall_x._vendor.harrix.eval_config import EvalConfig, autofill_from_checkpoint
# 1) load model
cfg = EvalConfig()
cfg.model.checkpoint_path = CHECKPOINT
cfg.model.norm_key = "x2_normal"
cfg.model.cam_names = ["face_view", "right_wrist_view"]
cfg = autofill_from_checkpoint(cfg)
model = build_adapter(cfg)
# 2) fake input
rng = np.random.default_rng(0)
obs = {
    "eef_pos": rng.normal(size=3).astype(np.float32),
    "eef_axisangle": rng.normal(size=3).astype(np.float32),
    "gripper": rng.normal(size=1).astype(np.float32),
    "face_view": rng.integers(0, 256, (448, 448, 3), dtype=np.uint8),
    "wrist_view": rng.integers(0, 256, (448, 448, 3), dtype=np.uint8),
}
instruction = "pick up the cup"
# 3) infer (return raw action chunk, shape: [horizon, action_dim])
encoded = encode_proprio(obs, model._train_config, model._action_horizon)
prefix, postfix = model._get_flow_prompt(instruction)
batch_inputs = model._construct_model_input([encoded], [prefix], [postfix])
padding = (
    torch.zeros_like(model._normalizer_action.delta[batch_inputs["dataset_names"][0]])
    .unsqueeze(0)
    .to("cpu")
)
padding = model._normalizer_action.normalize_data(
    padding, batch_inputs["dataset_names"]
).to(batch_inputs["input_ids"].device)
out = model._model.generate_flow_action(
    action_horizon=model._action_horizon,
    action_dim=model._action_dim,
    num_inference_timesteps=model._num_inference_timesteps,
    padding_action=padding,
    **batch_inputs,
)
result = out["predict_action"].detach().cpu().numpy()
print("result shape:", result.shape)
print("result:", result)
微调训练
训练过程包括:
- 数据集准备:如何将您的机器人数据集准备成LeRobot格式
- 配置设置:GPU设置、模型路径和机器人自由度设置的详细配置
- 训练脚本:带有适当超参数的即用型训练脚本
快速训练开始:
# 详细配置见 workspace/README.md
bash ./workspace/lerobot_example/run.sh
支持将机器人数据集准备为LeRobot格式,提供GPU设置、模型路径和机器人自由度的详细配置文档。