1. 点击率预估简介
点击率预估是对每次广告点击情况作出预测,可以输出点击或者不点击,也可以输出该次点击的概率,后者有时候也称为pClick.
- 点击率预估模型需要做什么?
点击率预估问题就是一个二分类的问题,在机器学习中可以使用逻辑回归作为模型的输出,其输出的就是一个概率值,我们可以将机器学习输出的这个概率值认为是某个用户点击某个广告的概率。 - 点击率预估与推荐算法有什么不同?
广告点击率预估是需要得到某个用户对某个广告的点击率,然后结合广告的出价用于排序;而推荐算法很多大多数情况下只需要得到一个最优的推荐次序,即TopN推荐的问题。当然也可以利用广告的点击率来排序,作为广告的推荐。
2、Wide & Deep模型
Memorization 和 Generalization是推荐系统很常见的两个概念。
其中Memorization指的是通过用户与商品的交互信息矩阵学习规则, 而Generalization则是泛化规则。
我们前面介绍的FM算法就是很好的Generalization的例子,它可以根据交互信息学习到一个比较短的矩阵V VV,其中v i v_{i}vi储存着每个用户特征的压缩表示(embedding),而协同过滤与SVD都是靠记住用户之前与哪些物品发生了交互从而推断出的推荐结果,这两者推荐结果当然存在一些差异,我们的Wide&Deep模型就能够融合这两种推荐结果做出最终的推荐,得到一个比之前的推荐结果都好的模型。
可以说Memorization趋向于更加保守,推荐用户之前有过行为的items。相比之下,generalization更加趋向于提高推荐系统的多样性(diversity)。Memorization只需要使用一个线性模型即可实现,而Generalization需要使用DNN实现。
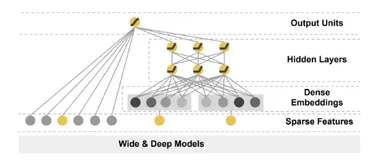
下面是wide&deep模型的结构图,由左边的wide部分(一个简单的线性模型),右边的deep部分(一个典型的DNN模型)。 
wide模型:其实就是 lr 加上 人工构造得交叉特征, 受限与训练数据,wide模型无法实现训练数据中未曾出现过得泛化。
deep模型介绍:像FM,和dnn这种embedding类得模型,可以通过学习到得低维稠密向量实现模型得泛化能力,包括可以实现对未见过得内容进行泛化推荐。但是当 query-item矩阵比较稀疏得时候,模型会过分泛化,推荐出很多无相关得内同,准确性得不到保证。
- 如何理解Wide部分有利于增强模型的“记忆能力”,Deep部分有利于增强模型的“泛化能力”?
- wide部分是一个广义的线性模型,输入的特征主要有两部分组成,一部分是原始的部分特征,另一部分是原始特征的交互特征(cross-product transformation),对于交互特征可以定义为:
 这个式子什么意思读者可以自行找原论文看看,大体意思就是两个特征都同时为1这个新的特征才能为1,否则就是0,说白了就是一个特征组合。
- 对于wide部分训练时候使用的优化器是带L 1 L_1L1正则的FTRL算法(Follow-the-regularized-leader),而L1 FTLR是非常注重模型稀疏性质的,也就是说W&D模型采用L1 FTRL是想让Wide部分变得更加的稀疏,即Wide部分的大部分参数都为0,这就大大压缩了模型权重及特征向量的维度。**Wide部分模型训练完之后留下来的特征都是非常重要的,那么模型的“记忆能力”就可以理解为发现"直接的",“暴力的”,“显然的”关联规则的能力。**例如Google W&D期望wide部分发现这样的规则:用户安装了应用A,此时曝光应用B,用户安装应用B的概率大。Deep部分是一个DNN模型,输入的特征主要分为两大类,一类是数值特征(可直接输入DNN),一类是类别特征(需要经过Embedding之后才能输入到DNN中),Deep部分的数学形式如下:
 我们知道DNN模型随着层数的增加,中间的特征就越抽象,也就提高了模型的泛化能力。**对于Deep部分的DNN模型作者使用了深度学习常用的优化器AdaGrad,这也是为了使得模型可以得到更精确的解。
Wide部分与Deep部分的结合
W&D模型是将两部分输出的结果结合起来联合训练,将deep和wide部分的输出重新使用一个逻辑回归模型做最终的预测,输出概率值。联合训练的数学形式如下: 
Tensorflow内置的WideDeepModel
全局实现
tf.keras.experimental.WideDeepModel(
    linear_model, dnn_model, activation=None, **kwargs
)
这一步很容易看出来就是将linear_model与dnn_model拼接在了一起,对应于Wide-Deep FM中的最后一步。比如我们可以将linear_model与dnn_model做一个最简单的实现
linear_model = LinearModel()
dnn_model = keras.Sequential([keras.layers.Dense(units=64),
                             keras.layers.Dense(units=1)])
combined_model = WideDeepModel(linear_model, dnn_model)
combined_model.compile(optimizer=['sgd', 'adam'], 'mse', ['mse'])
# define dnn_inputs and linear_inputs as separate numpy arrays or
# a single numpy array if dnn_inputs is same as linear_inputs.
combined_model.fit([linear_inputs, dnn_inputs], y, epochs)
# or define a single `tf.data.Dataset` that contains a single tensor or
# separate tensors for dnn_inputs and linear_inputs.
dataset = tf.data.Dataset.from_tensors(([linear_inputs, dnn_inputs], y))
combined_model.fit(dataset, epochs)
linear_model = LinearModel()
linear_model.compile('adagrad', 'mse')
linear_model.fit(linear_inputs, y, epochs)
dnn_model = keras.Sequential([keras.layers.Dense(units=1)])
dnn_model.compile('rmsprop', 'mse')
dnn_model.fit(dnn_inputs, y, epochs)
combined_model = WideDeepModel(linear_model, dnn_model)
combined_model.compile(optimizer=['sgd', 'adam'], 'mse', ['mse'])
combined_model.fit([linear_inputs, dnn_inputs], y, epochs)
4. 深度学习推荐系统的发展
Wide&Deep模型在深度学习发展中起到了非常重要的作用,从下图中我们就可以看到它对后续模型发展的一个影响。 
最后。如果文章中有不足之处,请务必指出,一定迅速改正。谢谢