ELK顾名思义就是:
ElasticSearch、Logstash和Kibana
这里还用到一个插件那就是filebeat进行进行采集日志
添加filebeat插件现在已经是非常提倡的做法
Logstash太耗费cpu 内存等资源了,所以可以通过filebeat来取代它
`
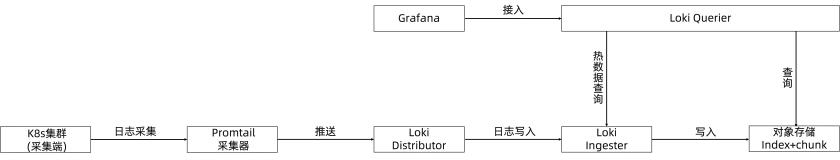
原理就是通过filebeat进行采集日志,发送到logstash主机然后logstash主机收集之后进行过滤发送到es进行分析方便搜索,最后用kibana进行图形化展示`
实验环境为正式环境
| 节点 | 服务 | IP |
|---|---|---|
| proxy02 | Nginx / Filebeat | 192.168.80.3 |
| log2 | ElasticSearch / Logstash / Kibana | 192.168.80.52 |
上传所需要的安装包,放到对应的节点


实验步骤
log2需要jdk(java)/es/logstash/kibana
如jdk已经安装直接跳过
[root@elasticsearch-master ~]# java -version
java version "1.8.0_45"
Java(TM) SE Runtime Environment (build 1.8.0_45-b14)
Java HotSpot(TM) 64-Bit Server VM (build 25.45-b02, mixed mode)
安装es
tar zxf elasticsearch-6.3.2.tar.gz
mv elasticsearch-6.3.2 /usr/local/es
调整系统文件描述符的软硬限制
vim /etc/security/limits.conf
 末尾添加
 打开文件的软限制,ES要求系统文件描述符大于65535
* soft nofile 655360
 打开文件的硬限制
* hard nofile 655360
 用户可用进程数软限制
* soft nproc 2048
 用户可用进程数硬限制
* hard nproc 4096
 JVM能够使用最大线程数
echo "vm.max_map_count=655360" >> /etc/sysctl.conf
sysctl -p
配置Elasticsearch服务环境
useradd es
mkdir -p /es/{data,logs}  # 日志及数据存放目录
chown -R es:es /usr/local/es /es # 使用es用户启动时,权限不对也会报错
网络对时
ntpdate ntp.ntsc.ac.cn重启log2主机
编辑elasticsearch.yml配置文件,ES默认就是集群模式的,所以只有一个节点也是集群模式
vim /usr/local/es/config/elasticsearch.yml
 取消注释
cluster.name: my-application
node.name: node-1
 添加
node.master: true
node.data: true
 取消注释并修改
path.data: /es/data
path.logs: /es/logs
network.host: 192.168.80.52   # 改为本机ip
discovery.zen.minimum_master_nodes: 1 # master的最少节点数
 取消注释
http.port: 9200
安装Kibana
tar zxf kibana-6.3.2-linux-x86_64.tar.gz
mv kibana-6.3.2-linux-x86_64 /usr/local/kibana
修改Kibana配置文件
vim /usr/local/kibana/config/kibana.yml
 取消注释
server.port: 5601
server.host: "192.168.80.52"
 用来连接es服务
elasticsearch.url: "http://192.168.80.52:9200"
安装Logstash
tar zxf logstash-6.3.2.tar.gz
mv logstash-6.3.2 /usr/local/logstash
编辑logstash配置文件
vim /usr/local/logstash/config/logstash.yml
 取消注释
path.config: /usr/local/logstash/config/*.conf  # 配置文件路径
config.reload.automatic: true  # 开启自动加载配置文件
config.reload.interval: 3s   # 自动加载配置文件时间间隔
http.host: "192.168.80.52"  # 改为本机ip
proxy02需要Filebeat/Nginx
Nginx已经安装跳过
安装Filebeat
tar zxf filebeat-6.3.2-linux-x86_64.tar.gz
mv filebeat-6.3.2-linux-x86_64 /usr/local/filebeat
整合环境
修改filebeat配置文件,将本机的nginx日志文件打标签为nginx,方便elasticsearch来创建索引
proxy02
vim /usr/local/filebeat/filebeat.yml
 添加注释
 filebeat.inputs:
- type: log
 paths:
    - /var/log/*.log
 添加以下内容为inputs配置
filebeat:
  prospectors:
    - type: log
      paths:
        - /usr/local/nginx/logs/access.log
      tags: ["nginx"]
 修改
  enabled: true # 表示以上配置是否生效
 添加注释
 output.elasticsearch:
  hosts: ["localhost:9200"]
 取消注释
output.logstash:
  hosts: ["192.168.80.52:5044"]  # 该ip为logstash的主机ip
log2
新建nginx-logstash.conf文件,用来匹配日志索引
vim /usr/local/logstash/config/nginx-logstash.conf
添加:
input {
  beats {
    port => 5044  # filebeat端口号
  }
}

output {
  elasticsearch {
    hosts => "192.168.80.52:9200"   # 该ip为elasticsearch的ip和端口
    index => "nginx"  # 数据索引名
  }
}
进行启动
log2
启动es
su es
/usr/local/es/bin/elasticsearch
proxy02
启动filebeat
/usr/local/filebeat/filebeat -c /usr/local/filebeat/filebeat.ymllog2
启动logstash
/usr/local/logstash/bin/logstash -t /usr/local/logstash/config/nginx-logstash.conflog2
启动kibana
/usr/local/kibana/bin/kibana
各个服务启动之后阻塞信息都是INFO就没问题,遇到WARN是no route的就关闭防火墙或者放行端口
在访问kibana的ip:5601,http://192.168.80.52:5601
进入管理界面,通过设置索引样式可以匹配出具体索引的数据
设置在这个索引里使用时间字段来进行过滤数据
创建成功
创建可视化图表
选择样式为条形图样式
选择为刚才创建的索引数据生成图表
右上方可保存图表,自动刷新间隔,时间维度