上周有位做 Java 的读者问我:公司要选实时计算引擎,候选是 Flink 和 Spark Structured Streaming,领导让他出一份对比。他把两边的特性列表并排贴在文档里,写了二十页,最后自己也不知道该选哪个。
问题出在「特性列表」这个形式本身。特性是能力的广告词,不是决策依据。真能拿来做判断的,只有三个问题:
- 数据晚到五分钟,结果还能算对吗?
- 算子要记住三个月前的中间结果,记在哪儿?
- 半夜挂了,重启之后会不会多算一遍?
这三个问题分别对应时间、状态、一致性。Flink 的八个特性,说到底是这三件事的不同侧面;而它的应用场景,也不是一份行业名单,是「延迟 × 状态 × 正确性」三个坐标筛出来的交集。
一、一句话定义,藏着八个特性
官方定义只有一句:在有界和无界数据流上做有状态的计算。
拆开看,三个关键词就是三组能力。「流」意味着批只是有终点的流,一套运行时通吃;「有状态」意味着中间结果留在算子本地,不必回表重算;「计算」则要求在会宕机的分布式机器上,结果依然对得上。
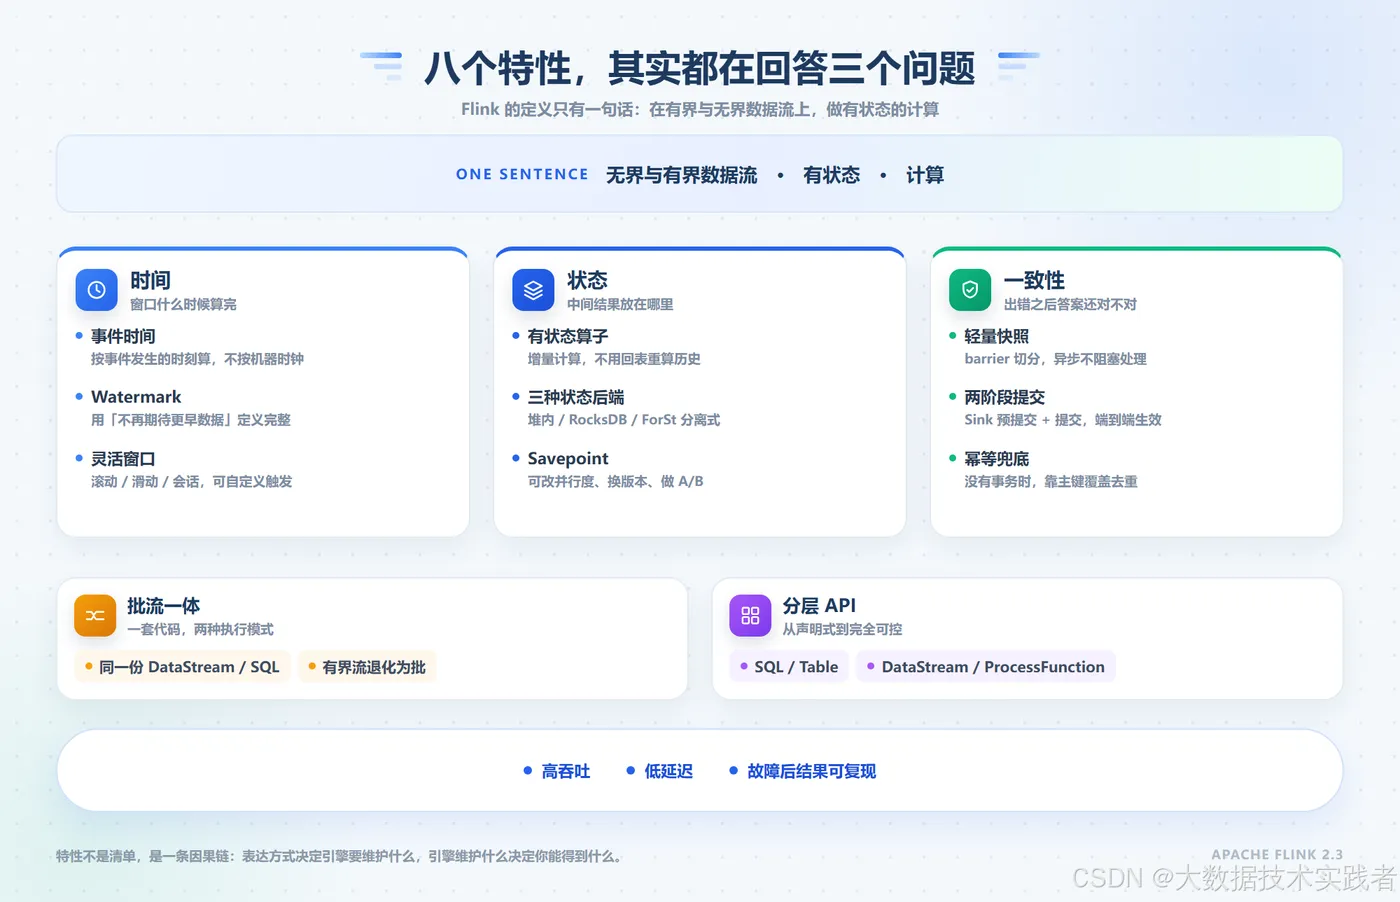
最上面那行是横切能力:批流一体决定你怎么写,分层 API 决定你写到多细。中间三根柱子是引擎真正要维护的东西。最下面那行是结果——高吞吐、低延迟、故障后结果可复现。
注意最后一条。前两个是性能,第三个才是 Flink 在选型里难以被替代的原因:它把「算得对」做成了架构属性,而不是运维纪律。
二、时间:先把「算完」定义清楚
流处理最反直觉的一点是:你永远不知道下一条数据什么时候来,那窗口凭什么关闭?
Flink 给了三种时间语义。处理时间用机器时钟,最快但没有确定性;摄入时间用进入引擎的时刻,折中;事件时间用事件真正发生的时刻,能还原业务顺序,代价是要处理乱序。
真正让事件时间落地的是 Watermark。它不是时间戳,是一个承诺:「早于 T 的事件,我不再期待了。」窗口收到水位线越过自己的结束时间,才敢触发计算。
DataStream<Order> orders = env
    .fromSource(kafkaSource, WatermarkStrategy.noWatermarks(), "orders")
    .assignTimestampsAndWatermarks(
        WatermarkStrategy.<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
            .withTimestampAssigner((e, ts) -> e.getEventTime())
            .withIdleness(Duration.ofMinutes(1)));
这段代码里有两个容易被忽略的参数。forBoundedOutOfOrderness(5s) 表示容忍 5 秒乱序,水位线取「已见最大事件时间减 5 秒」;容忍越大,结果越稳,延迟也越高。withIdleness 则处理分区空闲——某个 Kafka 分区长时间没数据,水位线会卡在那里不动,整个作业的窗口都不触发。
还有两个配套机制:allowedLateness 让窗口关闭后仍接收一段迟到数据并重新触发;再晚的用侧输出流单独接住,落库后离线补。到这里,「晚到五分钟能不能算对」才有答案——能,但要你显式定义容忍边界。
生产上最常见的故障不是算错,是「窗口迟迟不出数」。先看两个指标:当前水位线和系统时间的差值,以及各源的 currentInputWatermark。前者持续拉大,说明有分区没数据却仍在参与对齐;后者某个源明显落后,说明那一路在背压。这两个数一比,问题基本就定位了。
2.3 在这里改了一个很工程味的细节。水位线对齐原本会在数据积压时拖慢处理速度:允许漂移 30 秒、每秒更新一次,实际每秒只能推进 30 秒的事件时间。新版本加了 pipeline.watermark-alignment.buffer-size,默认值 3,把算法延后三个更新间隔生效;设成 0 可退回旧行为。代价是源暂停得稍晚,窗口状态可能略涨。
三、状态:决定你能算多大
没有状态的流处理只能做过滤和映射。一旦要「过去一小时该用户下了几单」,就必须记住中间结果。
Flink 的状态分两类:Keyed State 绑定在 key 上,随 keyBy 分区,支持 Value/List/Map/Aggregating 等形态;Operator State 绑定在算子实例上,常用于 source 的位点。状态默认放本地,靠 Checkpoint 定期快照到远端,故障时回填。
状态放哪儿,是 2.x 最实质的变化。目前三个后端:
| 后端 | 存储位置 | 快照方式 | 适合 |
|---|---|---|---|
| HashMap | JVM 堆内对象 | 全量 | 状态小、追求极致延迟 |
| RocksDB | TM 本地盘 | 增量(唯一稳定支持) | 状态超过内存 |
| ForSt | 远端 DFS + 本地缓存 | 异步增量 | 状态无上限、云原生扩缩容 |
默认是 HashMap。状态一旦超过几十 GB,就得换 RocksDB,代价是所有读写都要序列化,吞吐掉一个量级。ForSt 是 2.x 的分离式状态方案,把 SST 文件放对象存储,本地盘退化成缓存,但目前仍是 experimental,不支持 canonical savepoint 和全量快照——敢不敢用,取决于你能不能接受「换不回去」。
# 2.x 起配置文件由 flink-conf.yaml 改为 config.yaml
state.backend.type: rocksdb
state.backend.rocksdb.memory.managed: true
execution.checkpointing.interval: 60s
execution.checkpointing.unaligned.enabled: true
execution.checkpointing.dir: s3://flink-state/ck
状态规模还会反过来咬你一口:Checkpoint 越大,单次快照越久,恢复越慢。一个 2 TB 状态的作业,从冷启动恢复到能处理数据,十分钟起步是常态。这也是分离式状态存在的理由——把恢复变成「从远端拉元数据 + 按需拉文件」,而不是「把几个 T 搬到本地」。
还有一个容易被当成万能解药的东西:状态 TTL。给状态配 StateTtlConfig 能让过期数据自动清掉,但它不是免费的——每条状态访问都要做时间比对,配置不当会在读路径上多一次开销;而且 TTL 只在读或写时顺带清理,冷 key 会一直占着空间。想真正控制膨胀,还是得靠窗口设计、去重策略和定期重跑。
四、一致性:三段式,少一段都不算
「Flink 支持 Exactly-Once」这句话,经常被理解成引擎单方面的承诺。实际上它是三段拼起来的:
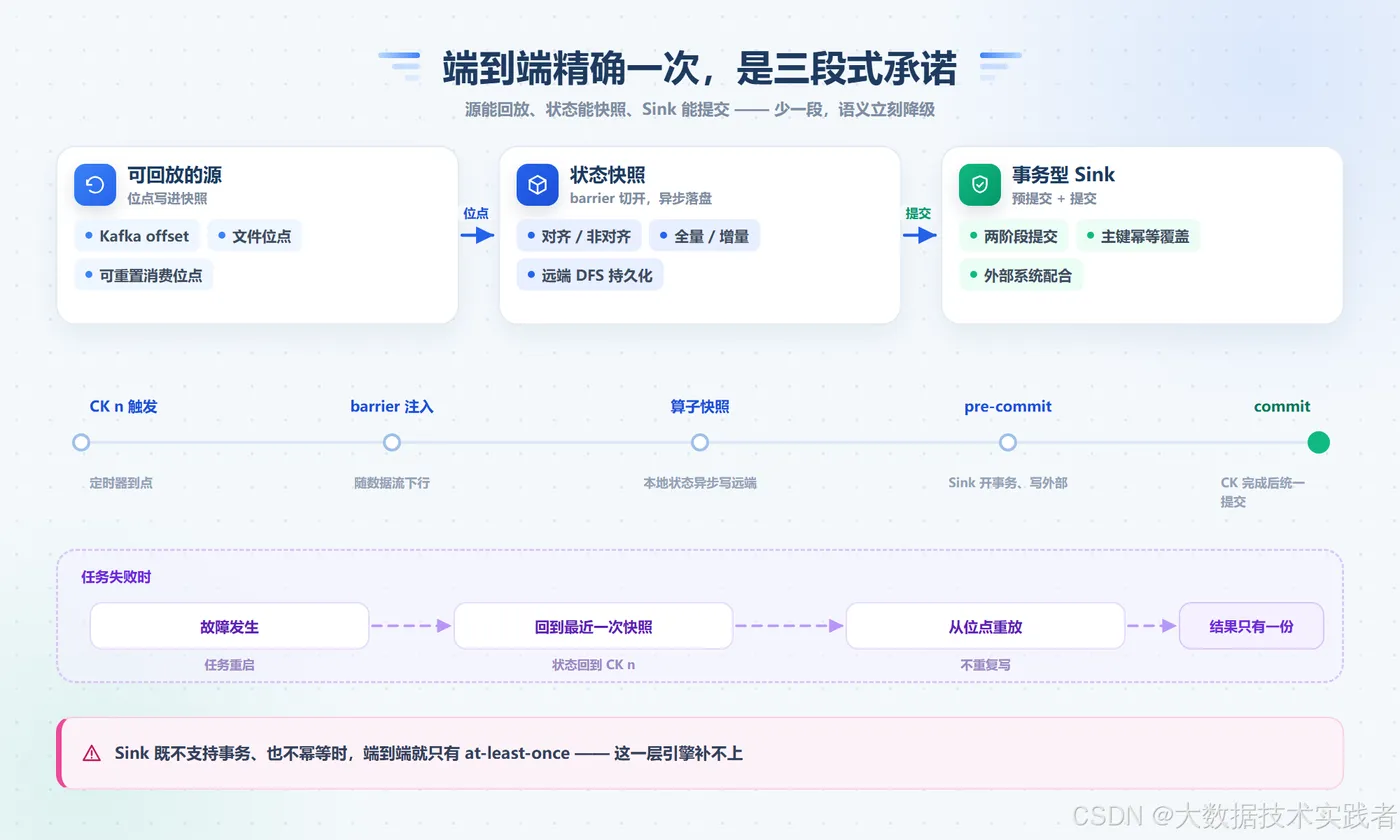
第一段,源要能回放。 快照里存的不是「处理到第几条」,而是 Kafka 的 offset、文件的位点。恢复时从那个位点重新消费,中间的数据一条不少。
第二段,状态要能切。 JobManager 周期性注入 barrier,把数据流切成「快照内」和「快照外」。算子收到 barrier 就把本地状态异步写到远端,写完继续处理,不阻塞。反压严重时对齐会拖很久,可以切到非对齐快照,把飞行中的数据一并写进快照。
第三段,Sink 要能提交。 这是最容易被跳过的一段。Kafka Sink 走两阶段提交:Checkpoint 期间开启事务写数据但不提交,等这次 Checkpoint 全局完成,才统一 commit。如果 Sink 既不支持事务、也不幂等,端到端就只有 at-least-once——引擎再强也补不上。
KafkaSink<Order> sink = KafkaSink.<Order>builder()
    .setBootstrapServers("kafka:9092")
    .setRecordSerializer(serializer)
    .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
    .setTransactionalIdPrefix("order-sink")
    .setProperty("transaction.timeout.ms", "900000")
    .build();
transaction.timeout.ms 是个经典坑。Flink 的 Kafka 生产者为保证长 Checkpoint 不被中断,默认把这个值设成 1 小时,而 broker 的 transaction.max.timeout.ms 默认只有 15 分钟,不改就会被拒;改小了又要保证它大于 Checkpoint 间隔加上最长重启时间,否则事务在快照完成前就超时,作业直接失败。这条参数没有任何默认值能同时满足所有场景,只能自己算。
一致性还有一个隐形成本:Checkpoint 间隔就是故障时可能重放的数据量。 间隔 10 分钟,宕机就可能重算 10 分钟的数据。想更快恢复就得缩短间隔,代价是更多网络与存储开销。
五、八个特性归位
有个特性前面没单独讲:高吞吐和低延迟为什么能同时成立。答案在三处工程实现里。算子链把 map、filter 这类没有 shuffle 的算子合并进同一个 task,省掉线程与队列的传递;信用制反压让下游把可用 buffer 报给上游,处理不过来时主动减速,而不是把数据堆在内存里直到 OOM;二进制内存管理则把数据放进 MemorySegment,减少对象头和 GC 扫描。三件事叠加,才有「内存速度、任意规模」这句话。
把前面讲的东西收进一张表,八个特性各自的位置和代价就清楚了:
| 特性 | 解决什么 | 代价或边界 |
|---|---|---|
| 批流一体 | 一套代码,两种执行模式 | 批模式的算子优化并不完全等价 |
| 事件时间与窗口 | 乱序数据也能算对 | 结果正确性依赖水位线质量 |
| 有状态计算 | 增量计算,不回表重算 | 状态规模直接等于运维成本 |
| 状态后端可插拔 | 从 GB 到 TB 平滑换挡 | 换后端要重建快照 |
| 轻量分布式快照 | 故障恢复后语义不破 | 受 Sink 事务能力约束 |
| Savepoint | 改并行度、换版本、做 A/B | 状态 schema 兼容要自己管 |
| 算子链与二进制内存 | 高吞吐同时保持低延迟 | 仍要看反压与 GC 调优 |
| 分层 API | SQL 到 ProcessFunction 全覆盖 | SQL 仍有表达力边界 |
这张表最值得看的是第三列。选型时大家只比第一列,出问题全在第三列。
六、六类场景:三个坐标筛出来的交集
Flink 官方把应用分成三类:事件驱动(对每个事件做出反应)、数据分析(持续产出结果)、数据管道(持续搬运加工)。落到具体业务,我看到的是六个战场。
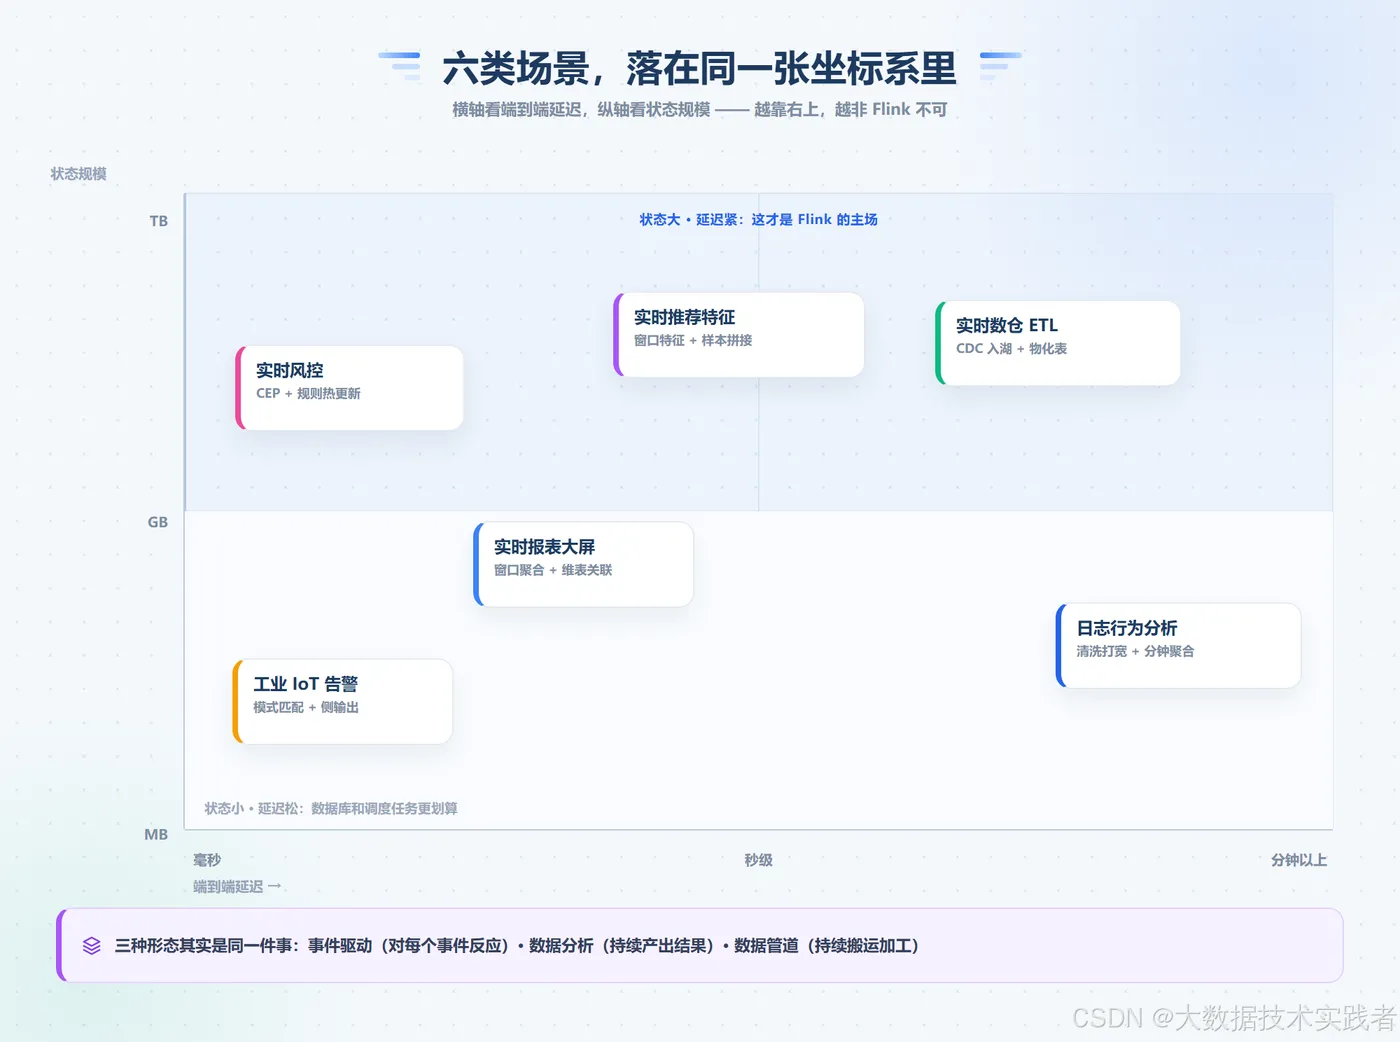
实时风控与反欺诈。 毫秒级判定,状态是用户画像、设备指纹、近期行为序列。CEP 做「五分钟内三次失败登录后一笔大额转账」这类模式匹配,规则用广播状态热更新,不用重启作业。边界在于规则复杂度——超过几百条以后,维护成本会超过收益。
实时推荐与特征工程。 秒级窗口特征(近 30 分钟点击品类、近 1 小时加购数),双流 join 拼样本。难点不在计算,在线上线下一致性:离线训练用的特征口径,必须和实时产出完全对齐,否则模型上线就漂。
实时数仓与 CDC 入湖。 这是近几年增量最大的一块。业务库变更经 CDC 进 Flink,清洗打宽后写 Paimon,ODS→DWD→DWS 每层都是湖表。物化表让你只声明「多久新鲜一次」,引擎自己决定起流作业还是跑批。
实时报表与大屏。 窗口聚合加维表 lookup join,秒级刷新。公开案例里,双十一大屏从下单到展示的全链路压到了 5 秒以内,峰值几十万笔订单每秒。这类场景的技术重点其实是维表——维表变更能不能被及时感知,比聚合本身难。
工业 IoT 与复杂事件。 设备传感器高频上报,做故障模式识别、状态机流转、超时告警。特点是数据量极大但状态不大,且必须容忍脏数据,侧输出流基本是标配。
日志与行为分析。 埋点清洗、打宽、分钟级聚合,供漏斗和 A/B 实验使用。这类场景对延迟要求最松,但对吞吐和成本最敏感,往往是「该不该上 Flink」的分界线。
六个场景有一半落在「状态大、延迟紧」的右上区域,这就是 Flink 的主场。反过来,左下角那些状态小、延迟松的需求,用它属于浪费。
七、2.3 在这条链上补了五块
2.3 是 2026 年 6 月发布的版本,15 个 FLIP。跟「特性—场景」这条链直接相关的有五项。
原生 S3(FLIP-555)。 基于 AWS SDK v2 重写,甩掉整棵 Hadoop 依赖树,插件包从 30–93 MB 降到约 13 MB,官方基准里 Checkpoint 平均耗时从 90.1 秒降到 48.8 秒。它是分离式状态的经济前提。
Application 成为一等公民(FLIP-549/560)。 集群模型从「集群—作业」变成「集群—应用—作业」,新增 /applications/* 一组 REST 接口,Web UI 也有了独立页签。高可用现在支持「单流作业」和「多批作业」两类应用。
物化表的 START_MODE(FLIP-557)。 改一条物化表定义,默认要重跑全部历史。现在可以声明 FROM_NOW、FROM_TIMESTAMP、RESUME_OR_*,配合 STATE_RETENTION 决定旧状态留不留。加一列不用再付重放两年的账单。
SQL 级的 changelog 转换(FLIP-564)。 FROM_CHANGELOG 把带操作列的追加流转成动态表,TO_CHANGELOG 反过来把 upsert 流拍平成追加流。这是第一个 SQL 级运算符,对「归档、审计、写只支持追加的 Sink」很实用。
自适应分区(FLIP-339)。 上下游并行度不一致时,原来轮询分发,一个慢下游会拖垮全局。新策略把记录发给最空闲的 channel,下游倾斜场景吞吐最高提升约 3 倍。默认关闭,要显式打开。
另外提醒一个升级风险:SinkUpsertMaterializer 引入了 ON CONFLICT(FLIP-558),当 upsert key 与 Sink 主键不一致时,默认规划会直接失败,必须显式选择 DO NOTHING、DO ERROR 或 DO DEDUPLICATE。从 2.2 升上来,这是最可能让作业起不来的变更。
八、四道闸门:什么时候不该用
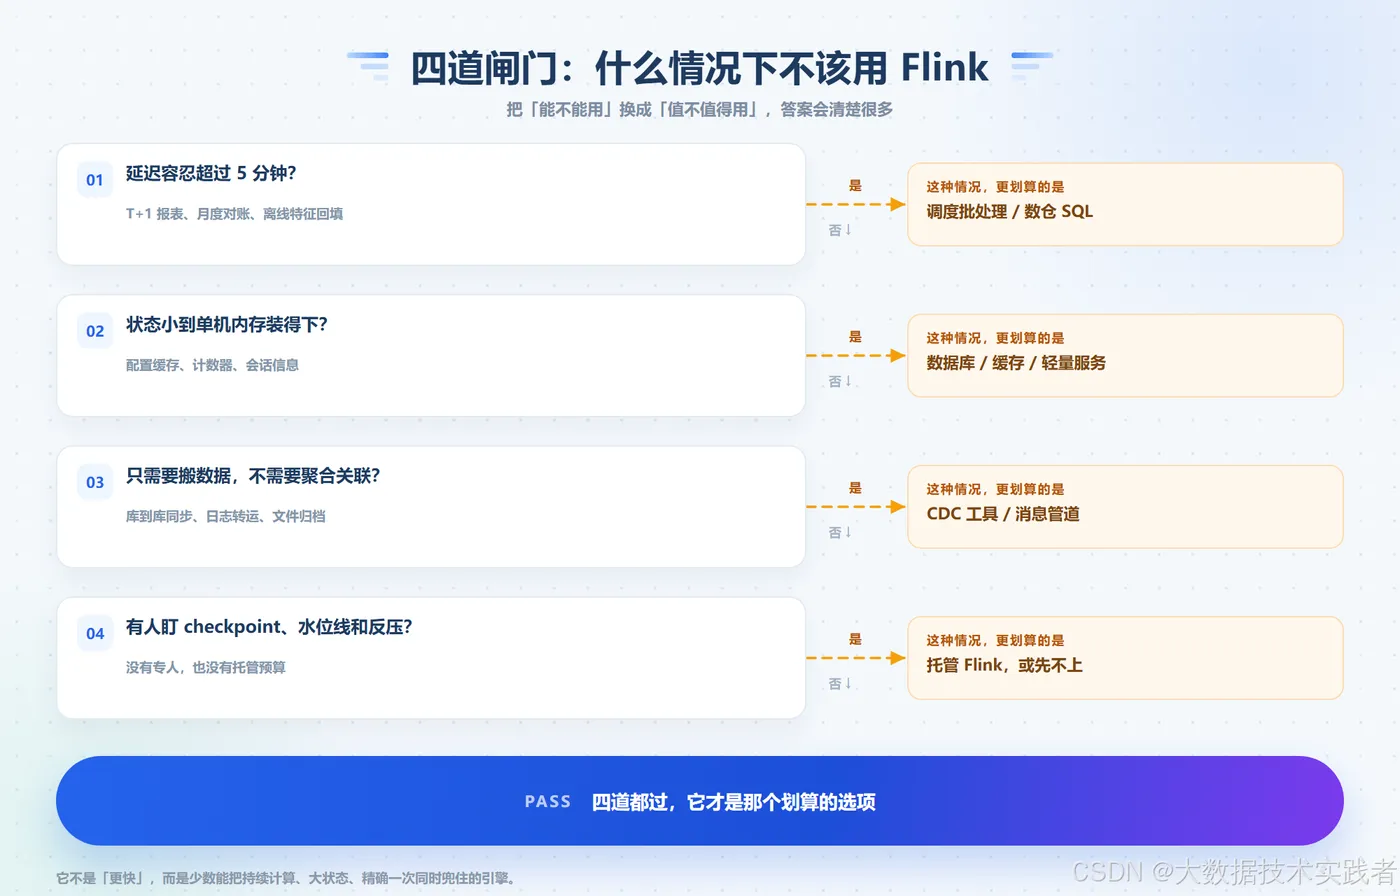
这四道闸门可以当成选型时的自检:
- 延迟容忍超过 5 分钟。 T+1 报表、月度对账、离线特征回填,调度批处理或数仓 SQL 的成本可能只有十分之一。
- 状态小到单机内存装得下。 配置缓存、计数器、会话信息,数据库加缓存就够,不必引入分布式状态。
- 只需要搬数据,不需要聚合关联。 库到库同步、日志转运、文件归档,CDC 工具或消息管道更省心。
- 没人盯 Checkpoint、水位线和反压。 流作业的故障大多不是崩溃,是「看起来在跑,结果不更新」。没有专人也没有托管预算,先别上。
四道都过,它才是那个划算的选项。Flink 的价值从来不是「更快」,而是少数能把持续计算、大状态、精确一次同时兜住的引擎。
九、最小可用骨架
如果决定用,最小闭环是这四件事:声明水位线、配好状态后端、定好 Checkpoint、提交时用 Application 模式。
flink run-application -t kubernetes-application \
  -Dkubernetes.cluster-id=order-risk \
  -Dkubernetes.container.image=registry.local/flink:2.3.0-scala_2.12-java17 \
  -Dstate.backend.type=rocksdb \
  -Dexecution.checkpointing.interval=60s \
  local:///opt/flink/usrlib/order-risk.jar
Application 模式下 main() 在 JobManager 上执行,集群生命周期和作业绑定——这是 1.15 之后官方推荐的方式,Per-Job 已经退场。
剩下的调优顺序建议是:先看反压(哪个算子 busy 100%),再看 Checkpoint 时长(对齐慢还是上传慢),最后才动并行度和内存。反过来调,通常只是把问题推到下游。
十、最后
回头看不难发现,八个特性其实是三个问题在不同层面的答案:时间决定窗口何时闭合,状态决定能算多大,一致性决定故障后答案对不对。批流一体和分层 API 只是把这三个答案包装成你能写出来的代码。
而场景,是这三个问题反过来筛你。
所以选型会上真正该问的不是「Flink 有哪些特性」,而是「我的业务,最不能容忍哪一种错」。答得出这一句,答案基本就出来了。
你们现在的实时链路,卡在时间、状态还是一致性上?评论区聊聊。