
着急下载 Ollama 的小伙伴,请直接转到:2026 最新版 Ollama 官方安装包免费下载地址
Ollama 官方最新版 v0.35.1,文件 OllamaSetup.exe,1.47 GB,国内直连秒下。
安装包来自 Ollama 官方 GitHub 发布页(开源项目 ollama/ollama,GitHub Star 超 18.2 万,MIT 协议),文件未经任何修改,软件完全免费,没有广告、没有会员、没有任何捆绑。
一、Ollama 是什么?
简单来说,有了 Ollama,一条命令,就能让 DeepSeek、Qwen 在你自己电脑上跑起来。
用过 DeepSeek、通义千问网页版的朋友都遇到过这些糟心事:晚上高峰期排队、转圈、响应变慢;问敏感资料不放心,毕竟内容要传到别人服务器上;断网了直接没法用;用多了还可能碰到额度限制。
Ollama 就是来解决这些问题的:Ollama 是一款免费开源的工具,把"在自己电脑上运行大语言模型"这件事,简化到了“一行命令”的程度。你不需要懂 Python、不用配环境,装好之后输入ollama run qwen2.5,模型自动下载、自动加载、自动调用显卡,马上就能在终端里跟它对话。
- 完全本地运行:模型和对话都在你自己电脑上,断网也能聊,对话内容不出本机;
- 免费开源:MIT 协议,源代码在 GitHub(ollama/ollama)公开,Star 超 18.2 万,任何人可以审查;
- 模型任选:DeepSeek-R1、Qwen(通义千问)、Llama、Gemma 等主流开源模型都能一条命令拉下来,小的只有几百 MB,大的几十 GB,丰俭由人;
- 自动用显卡:NVIDIA 显卡自动识别调用(本文实测 RTX 4060 Ti 跑小模型显示 100% GPU),没有独显也能用 CPU 跑小模型;
- 装好后常驻后台,在本机 127.0.0.1:11434 提供接口,各种第三方客户端、编程插件都能接它。
一句话:想免费、离线、保护隐私地用 DeepSeek/Qwen,Ollama 是目前最省心的本地方案。
先说清楚一件事,免得你装完疑惑
Ollama 本质是一个命令行工具,外加一个托盘小图标和一个简单的桌面引导窗口。
截至本文实测的 v0.35.1,桌面窗口的本地模式只有一个"复制命令去终端运行"的引导页,并没有内置聊天界面。真正对话是在 PowerShell 终端里进行的(全程本文都有截图,跟着复制粘贴即可,完全不需要命令基础)。
二、你的电脑能不能装 Ollama?
Ollama 对系统要求不高,但模型越大越吃硬件,先对照一下。
系统要求(Windows):
| 项目 | 要求 | 大白话解释 |
| 系统版本 | Windows 10 22H2 及以上(Win10 较新版本 / Win11) | 太老的 Win10 版本和 Win7/8 装不了 |
| 显卡(非必须) | NVIDIA 显卡建议驱动 551.61 或更新;AMD 核显/独显部分支持 | 没有独显也能装,用 CPU 跑小模型,就是慢一些 |
| 磁盘空间 | 程序本体约占 2.78 GB,模型另算(默认存在 C 盘用户目录,可改到其他盘,见第七章) | 玩几个模型建议预留 20 GB 以上 |
| 网络 | 安装后第一次下载模型需要联网 | 模型下完后,使用时可以完全断网 |
模型大小怎么选(新手参考):
| 模型(示例) | 模型文件大小 | 建议配置 | 适合场景 |
| qwen2.5:0.5b | 397 MB | 4 GB 内存,无独显也能跑 | 纯体验、验证安装,秒回 |
| deepseek-r1:1.5b | 约 1.1 GB | 8 GB 内存 | 轻量问答,带简单推理 |
| 7B 级别(如 qwen2.5:7b、deepseek-r1:7b) | 约 4.7 GB | 16 GB 内存,8 GB 显存更佳 | 回答质量和速度的平衡点 |
参数越大 ≠ 越适合你
模型越聪明,但对内存/显存要求越高、回答越慢。新手强烈建议先从 397 MB 的 qwen2.5:0.5b 开始,把流程跑通,再慢慢换大模型。
Mac 和 Linux 用户:Ollama 官网也提供 macOS(Intel / Apple 芯片均支持)和 Linux 版本,命令用法完全一样(Linux 还可用官方一键脚本安装)。本文聚焦 Windows 版,安装步骤以 Windows 11 实测为准。
三、Ollama 下载(2026最新版)
Ollama 官方安装包托管在 GitHub 上,国内访问 GitHub 时快时慢,安装包又有 1.47 GB,直连容易断。我已把官方原版文件搬运到夸克网盘,文件未做任何修改、无捆绑。
下载地址:2026 最新版 Ollama 官方安装包免费下载
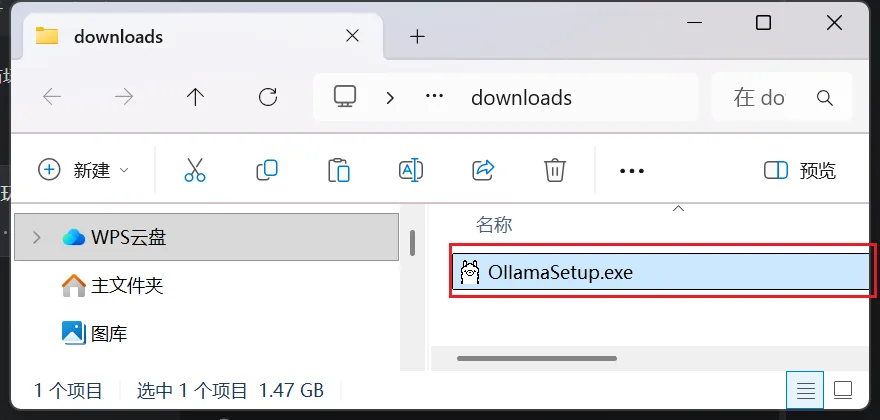
下载好的文件名叫 OllamaSetup.exe,大小 1.47 GB(约 1507 MB),文件图标是 Ollama 标志性的羊驼:
如何确认文件是官方原版、没被动过?
在 OllamaSetup.exe 上「右键 → 属性 → 数字签名」,能看到签名者为 Ollama Inc.(Toronto, Canada)、状态显示正常,即代表文件来自 Ollama 官方、未被篡改。
四、Ollama安装教程(约1分钟)
以 Windows 版为例,在文件夹里找到 OllamaSetup.exe,双击运行。
本次实测双击后没有出现"Windows 已保护你的电脑"SmartScreen 拦截,也没有 UAC 权限弹窗——因为安装包带有 Ollama 官方正规数字签名,且默认安装到当前用户目录(不需要管理员授权)。如果你电脑上的安全软件弹出询问,点"允许/运行"即可。
安装向导是英文界面(只有一屏,没有安装路径选择页、没有任何捆绑勾选),直接点右下角的“Install”:
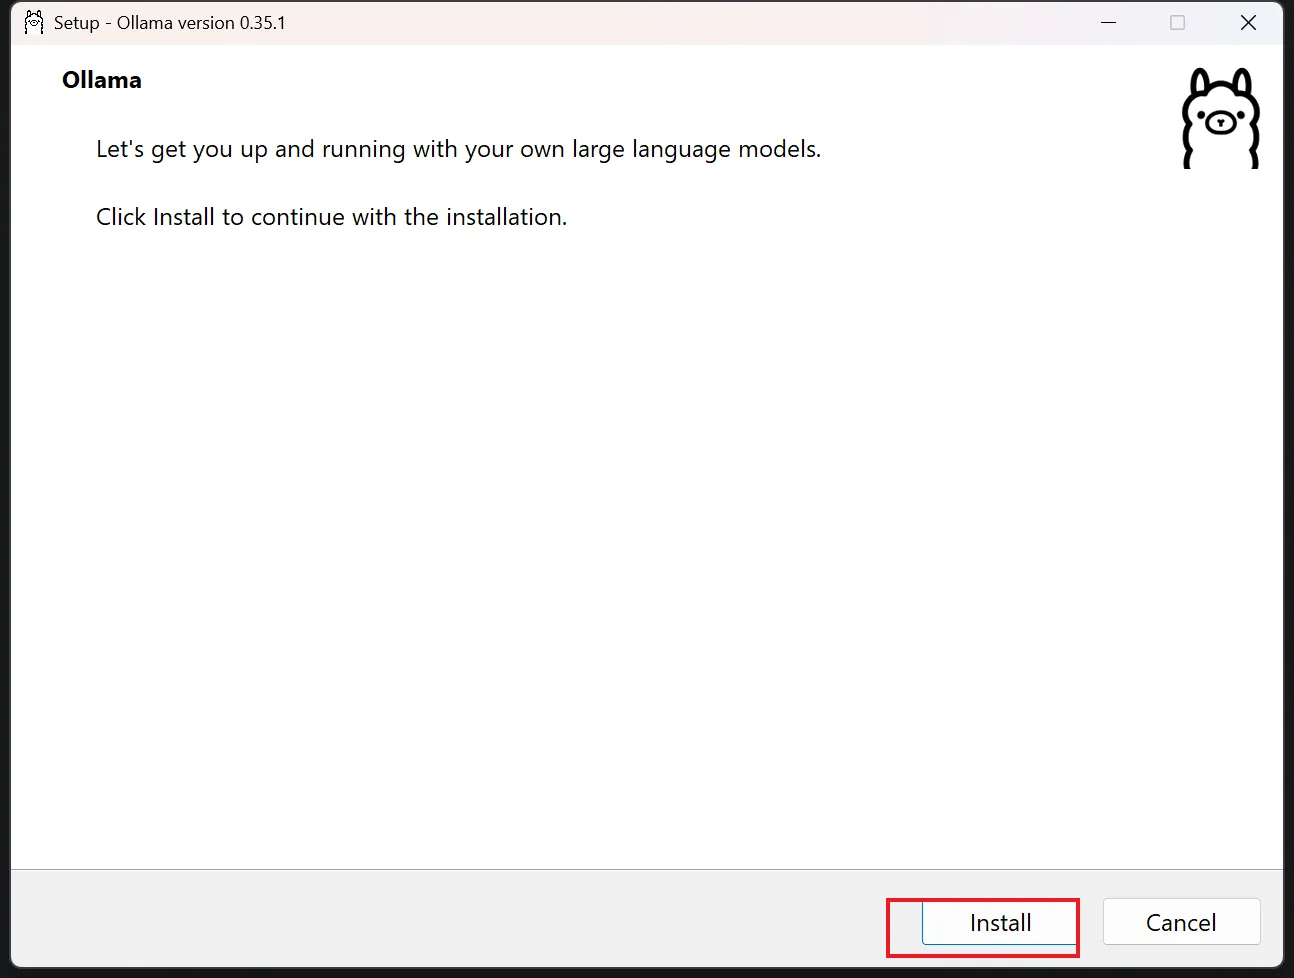
Ollama 的安装路径不可选,程序会自动装到 C:\Users\你的用户名\AppData\Local\Programs\Ollama。
进度条走完大约几十秒,安装结束后屏幕右下角会弹出一条中文通知:"一切就绪,只等你动手":
同时,任务栏右下角托盘区会出现一个羊驼图标,这就是 Ollama 的图标。
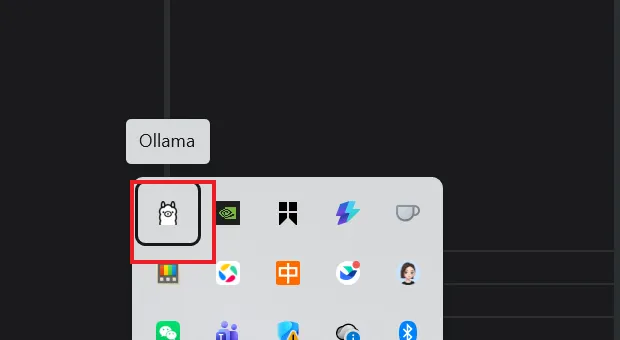
在羊驼图标上点击鼠标右键,菜单一共四项:Open Ollama(打开 Ollama)、Settings(设置)、View logs(查看日志)、Quit Ollama(退出),先认个脸:
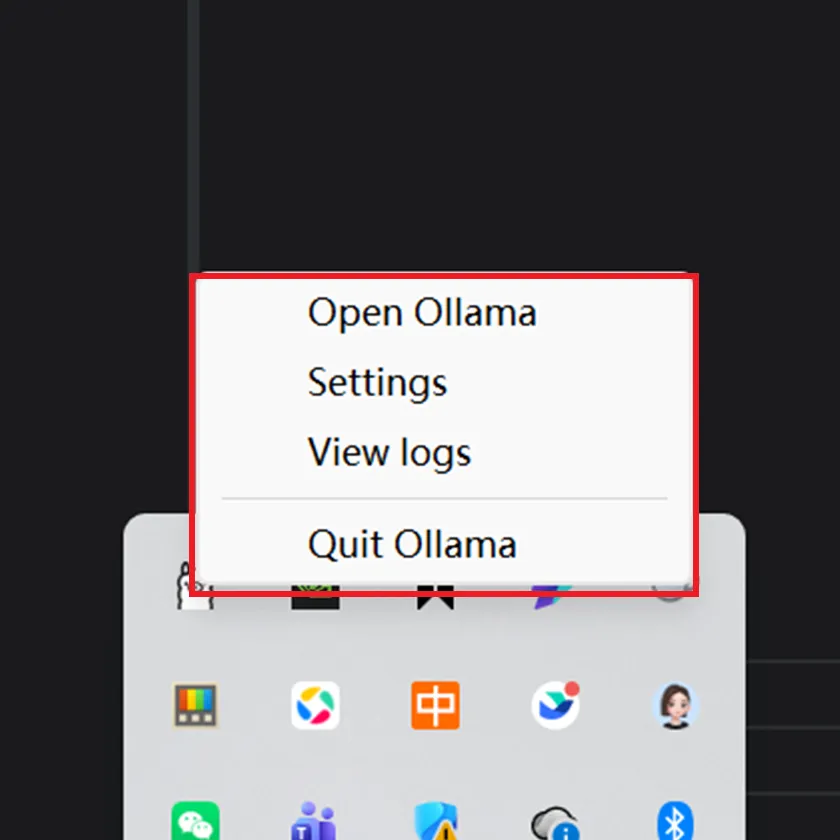
五、第一次打开桌面 App:三连引导,选"本地使用"即可
双击托盘图标,或在菜单里选 Open Ollama,会打开 Ollama 的桌面窗口。第一次打开有三屏引导,照着点:
1) 第一屏欢迎页 "Welcome to Ollama!",中间有三条特性说明(连接你的应用、一键切换模型、数据只属于你),点黑色的 Continue:
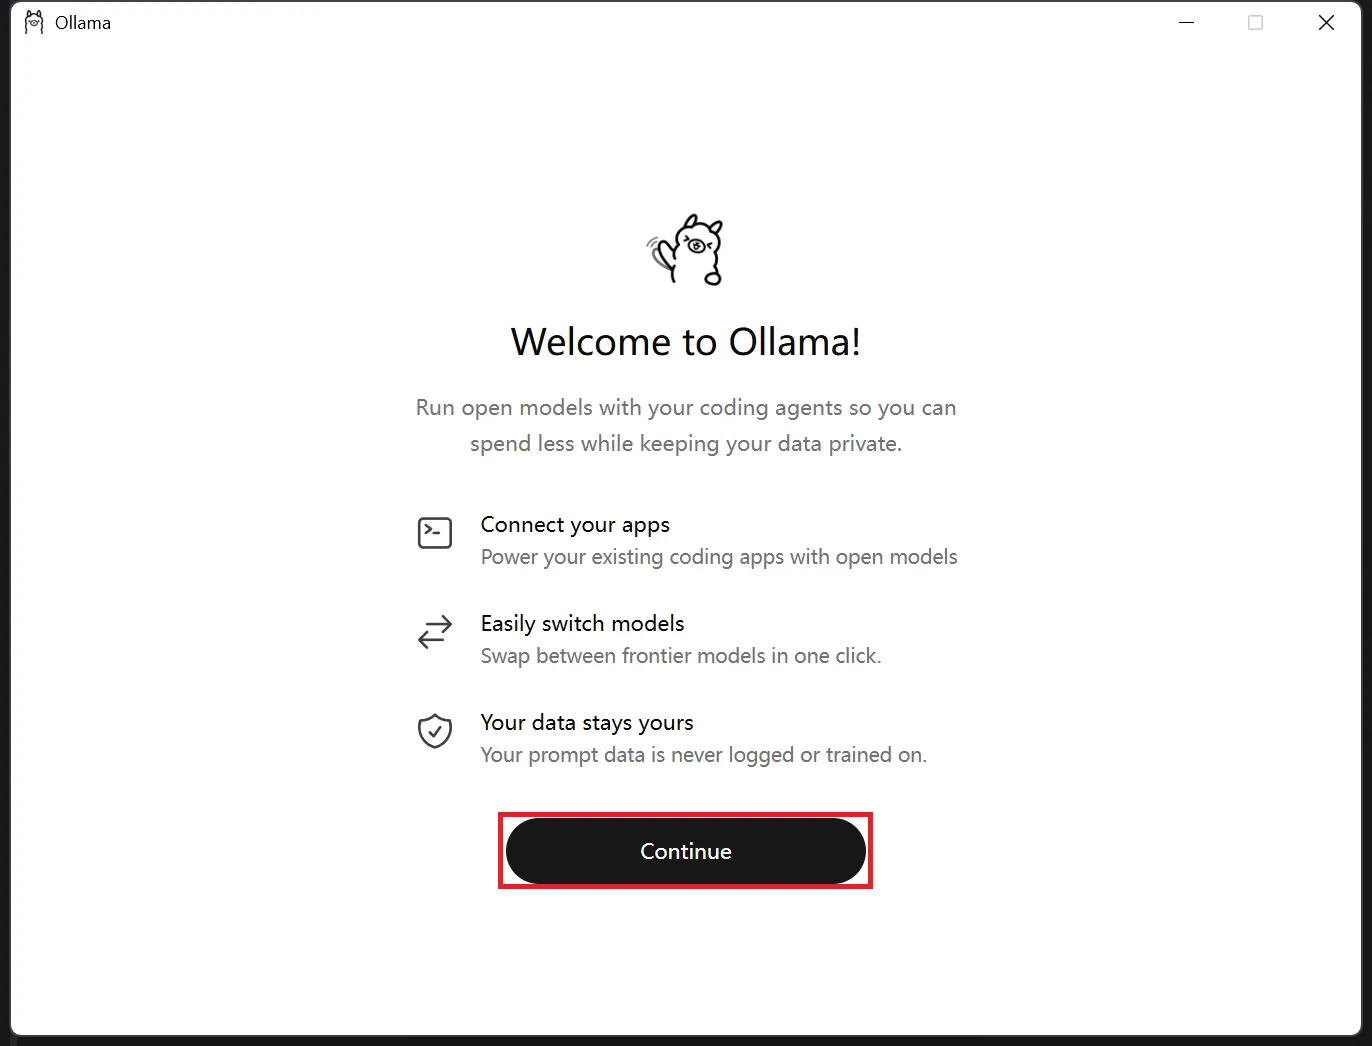
2) 第二屏是 "Create an account"(创建账号),宣传注册后可以访问更快、更大的模型。本地使用完全不需要注册,直接点底部那行灰色小字 "No thanks, I'll use Ollama locally"(不了,谢谢,我在本地使用 Ollama):
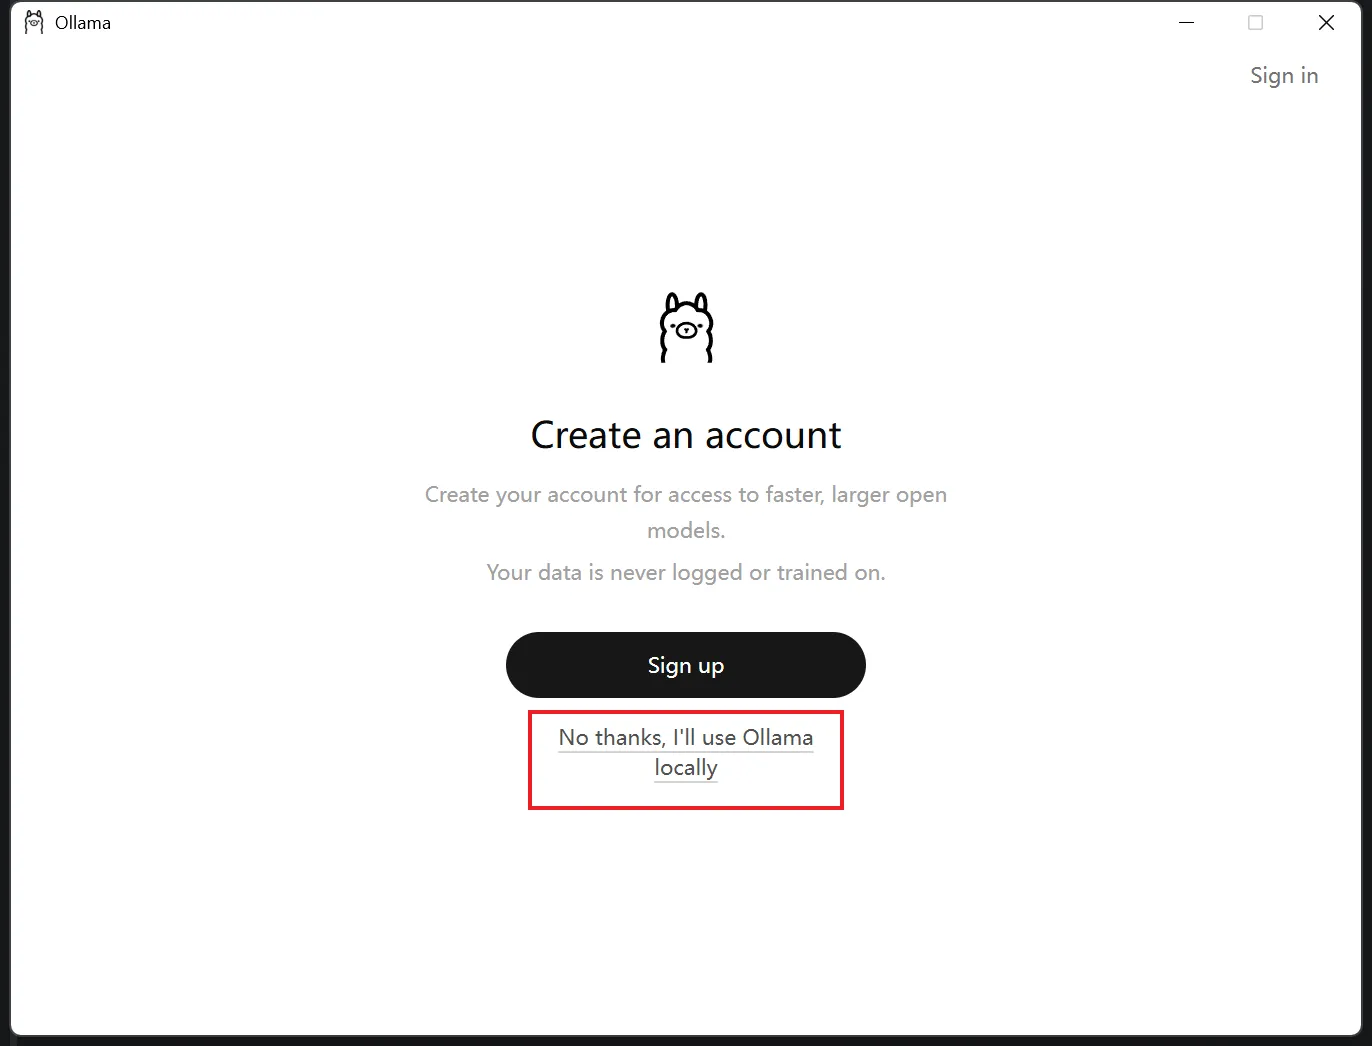
红框:不用点 Sign up,直接点底部 No thanks, I'll use Ollama locally,跳过账号、进入纯本地模式。
3) 进入本地模式主页后,你会看到页面上只有 "Run Ollama" 标题、一个写着 ollama 的命令框(右侧有复制图标),以及一句提示 "Run this command in your terminal to get started."(在终端中运行此命令以开始):
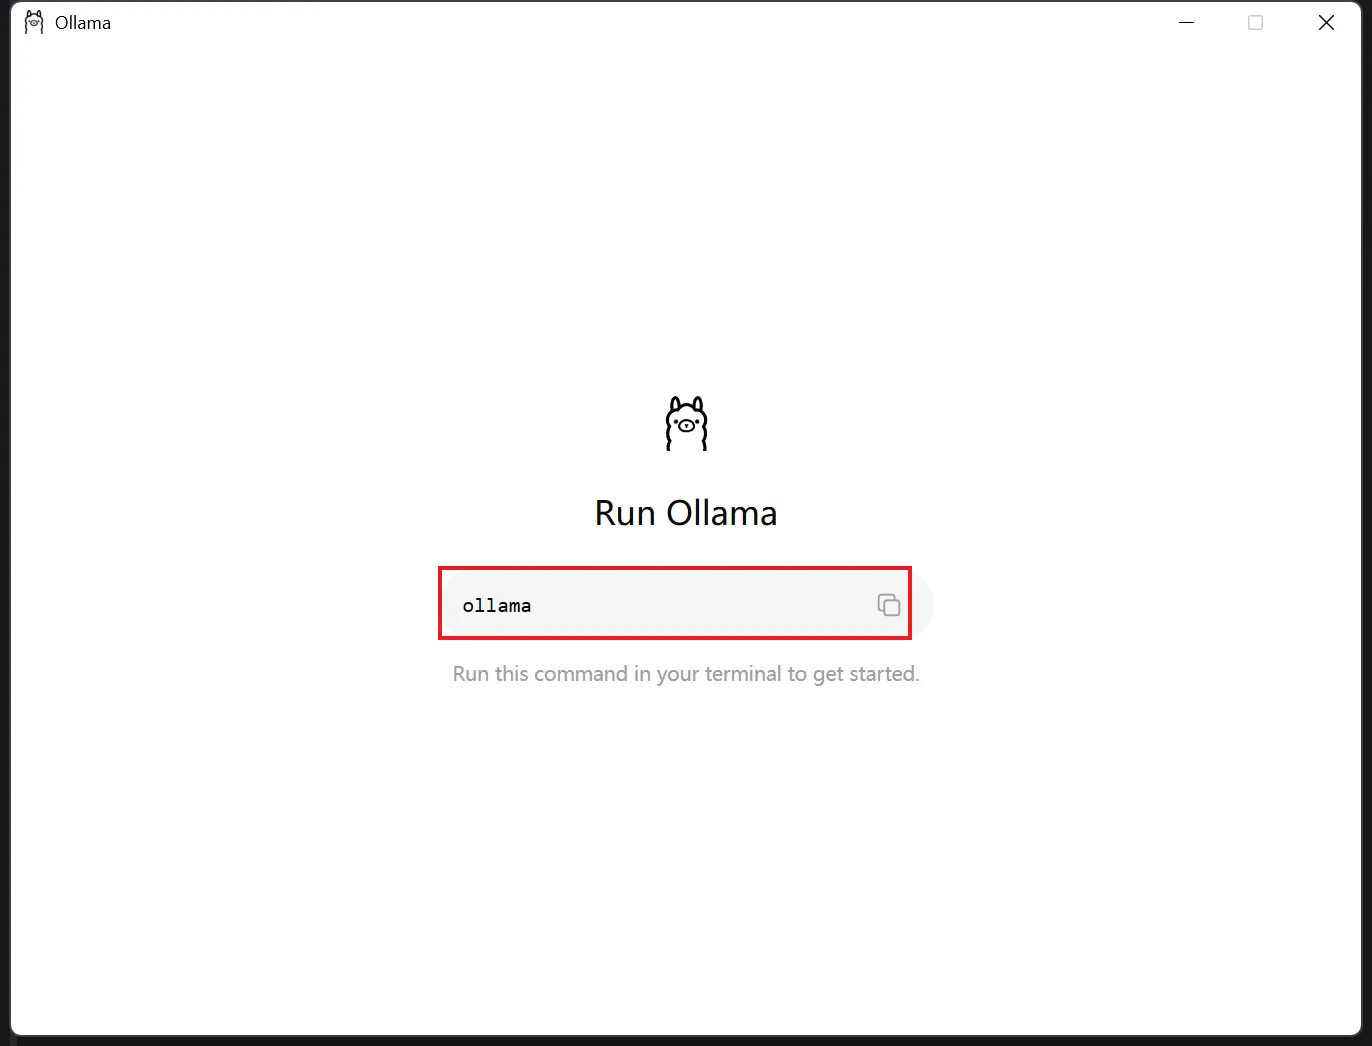
红框:本地模式主页就是一个命令引导页,不是聊天窗口。点复制图标把命令拷走,然后到 PowerShell 终端里运行(下一章手把手教)。
再次提醒:v0.35.1 本地模式没有内置聊天对话框,这不是安装出了问题。另外窗口里还有个 "Apps" 页面,是给 Claude Code、Cline 这类编程助手做接入引导的,新手暂时不用管。真正的对话,咱们到终端里进行。
六、核心用法:下载模型、中文对话,4 个命令全搞定
第 1 步:打开 PowerShell 终端
按 Win 键,直接输入 powershell,回车,打开蓝色/黑色的 "Windows PowerShell" 窗口。
高频踩坑预警:如果你在安装 Ollama 之前就已经开着终端窗口,那么在旧窗口里输入 ollama 会提示 "无法将 ollama 识别为 cmdlet、函数、脚本文件或可运行程序的名称"。这是因为旧窗口没刷新环境变量。把终端窗口全部关掉、重新打开一个就好了(实在不想重启,临时修复命令见第八章对照表)。
第 2 步:下载第一个模型 ollama pull
以 DeepSeek-R1 1.5B(1.1 GB,会推理的小模型)为例,在终端输入下面的命令,回车:
ollama pull deepseek-r1:1.5b
下载时会显示动态进度条:已下载百分比、已下载大小/总大小、实时速度、预计剩余时间:
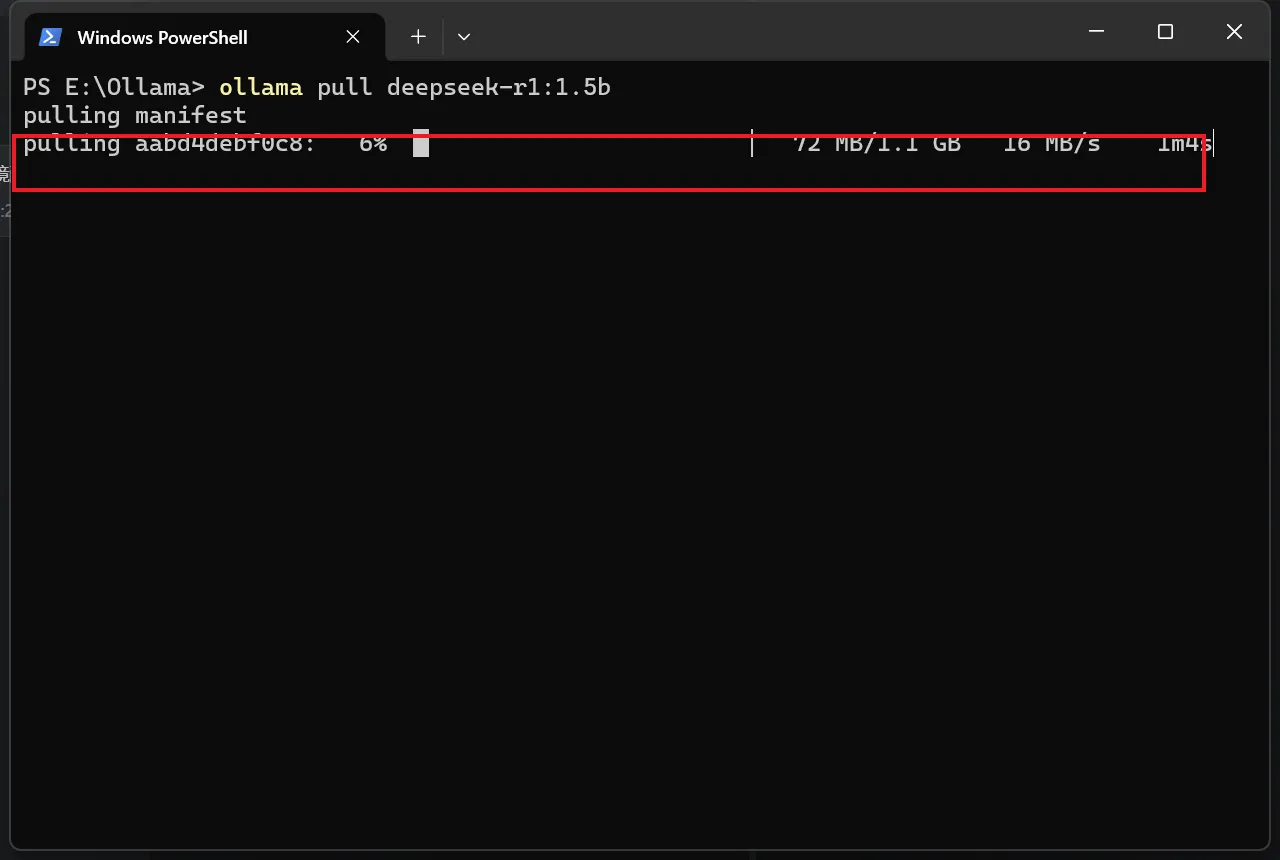
红框:下载进度行——pulling 进度 6%、72 MB/1.1 GB、实时 16 MB/s、剩余 1m4s。实测官方源在国内直连能稳定跑到 16~19 MB/s,并不慢。
几个要点:
- 模型是断点续传的:中途按 Ctrl+C 取消、或断网关机了,下次重新执行同一条
ollama pull 模型名会接着已下载的部分继续,不会重头再来; - 想先零成本体验,可以改下更小的
ollama pull qwen2.5:0.5b(只有 397 MB,一两分钟下完); - 如果你的网络环境下进度条长期卡在 0%、速度只有几 KB/s,请看第八章的排查方案。
第 3 步:开始中文对话 ollama run
模型下好后,运行下面的命令进入对话(以 Qwen2.5 0.5B 为例;如果本地还没有该模型,run 会自动先下载再进入):
ollama run qwen2.5:0.5b
第一次进入会看到 >>> 提示符,直接输入中文问题、回车,模型就会回答。本例问了句"你好,你是谁?请用一句话介绍你自己。",模型用中文自报家门:"我是 Qwen,阿里云自主研发的超大规模语言模型……"
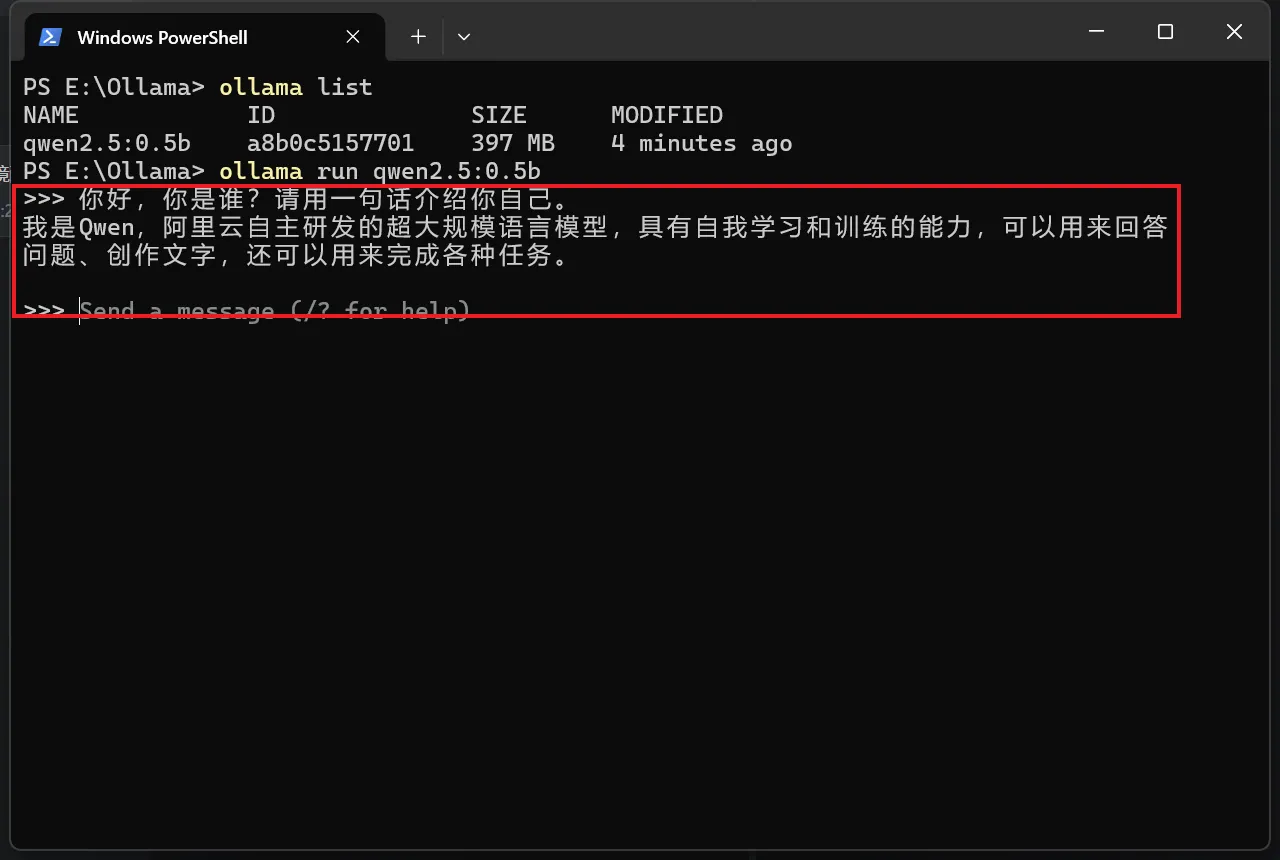
红框:
ollama run qwen2.5:0.5b进入对话 → 在 >>> 后输入中文问题、回车 → 模型直接给出中文回答,全程不联网也能聊
使用方式:
- 每次输入完按回车发送;一条消息想换行写,按 Shift+回车;
- 想退出对话,输入
/bye回车,回到 PowerShell 提示符; - 模型加载后会在内存/显存里保留约 5 分钟,这期间继续对话秒回;闲置超时自动卸载腾出资源。
第 4 步:两个常用查看命令
① 看本机已经下载了哪些模型:ollama list
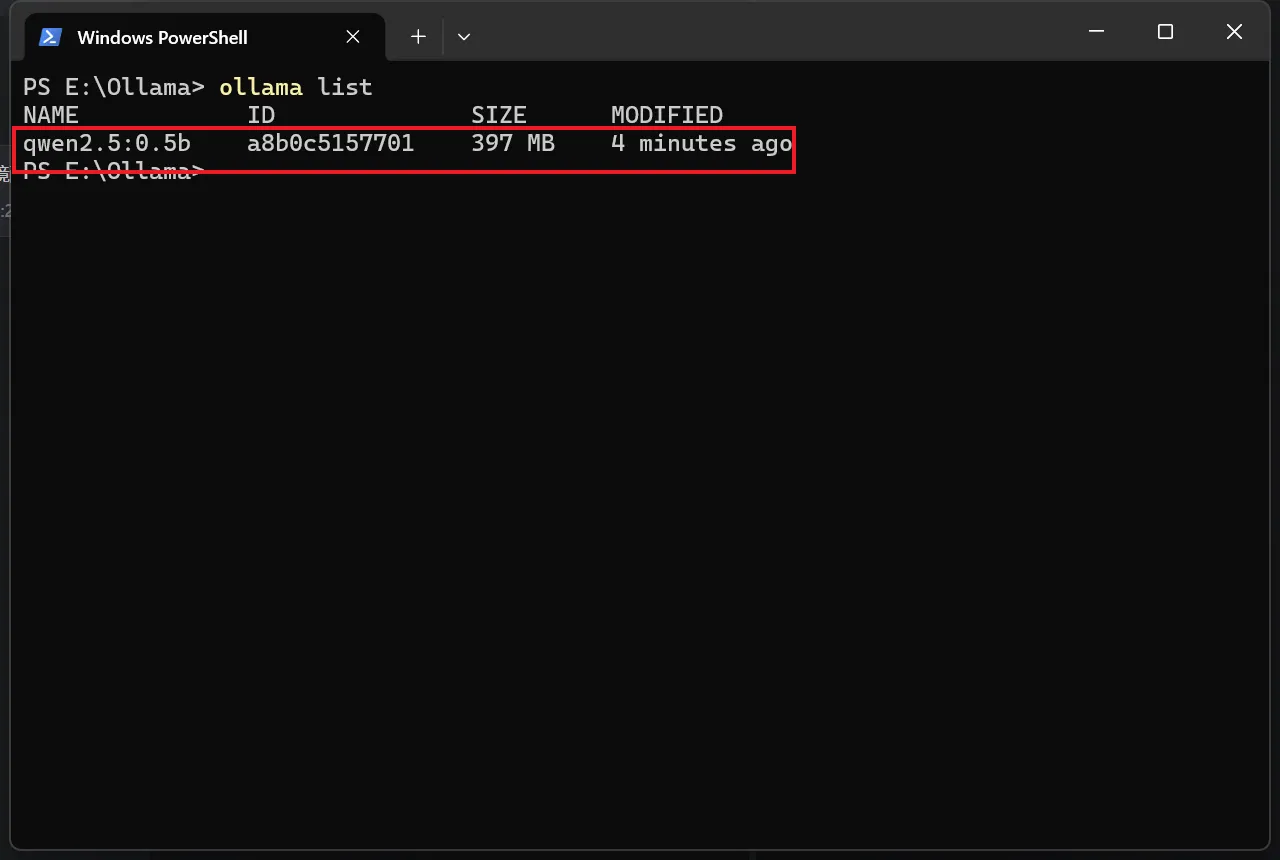
ollama list 以表格列出本机全部模型——NAME 模型名、ID 模型编号、SIZE 大小(397 MB)、MODIFIED 下载时间。
② 看当前正在运行的模型是否用上了显卡:ollama ps
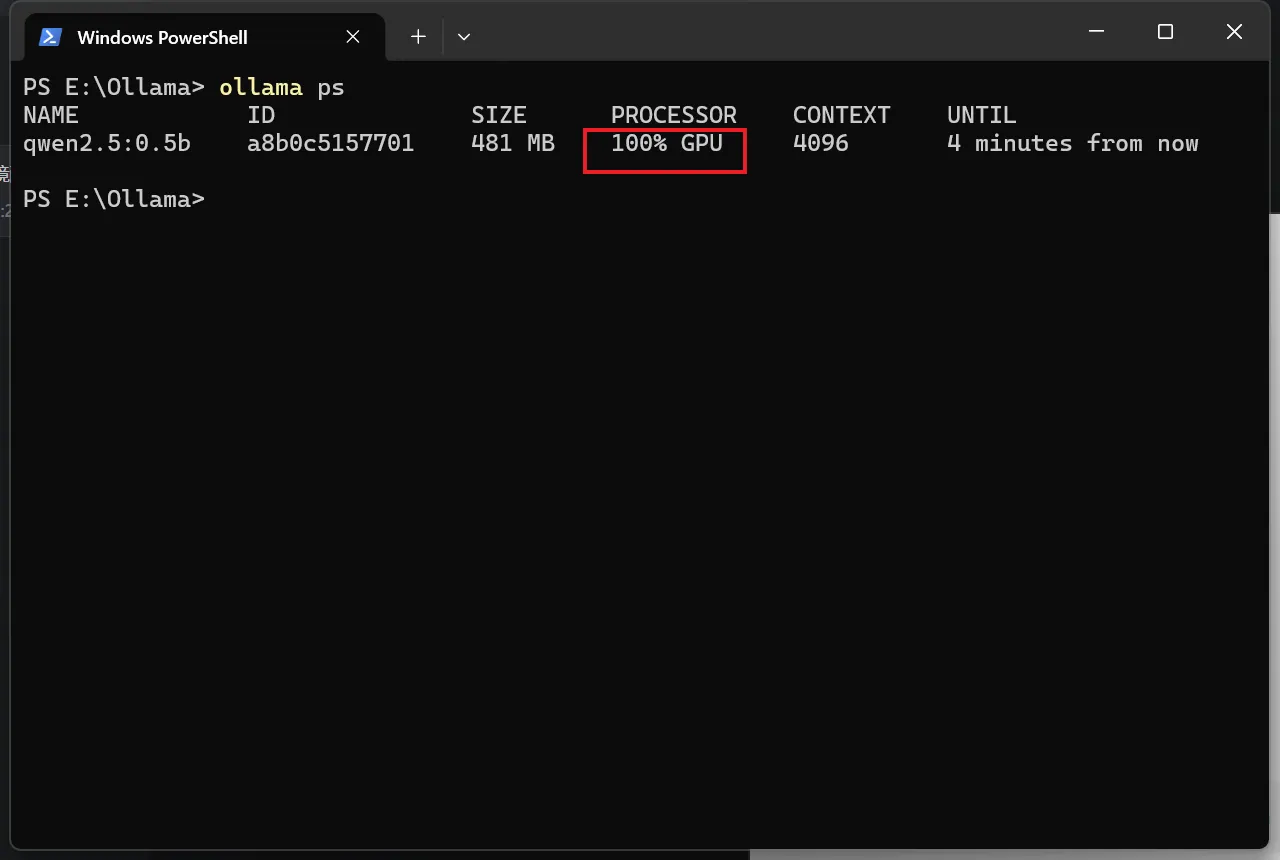
ollama ps 的 PROCESSOR 列显示 100% GPU,说明模型完全跑在显卡上(本机为 RTX 4060 Ti),速度最快;CONTEXT 4096 是上下文长度,UNTIL 显示还有多久自动卸载。如果显示 CPU / 百分比,说明在用处理器跑(也能用,更慢)。
最后,用 ollama --version 可以核对版本号。下图是本文实测环境的版本(0.35.1),下方顺带列出了本机已下载的两个模型:
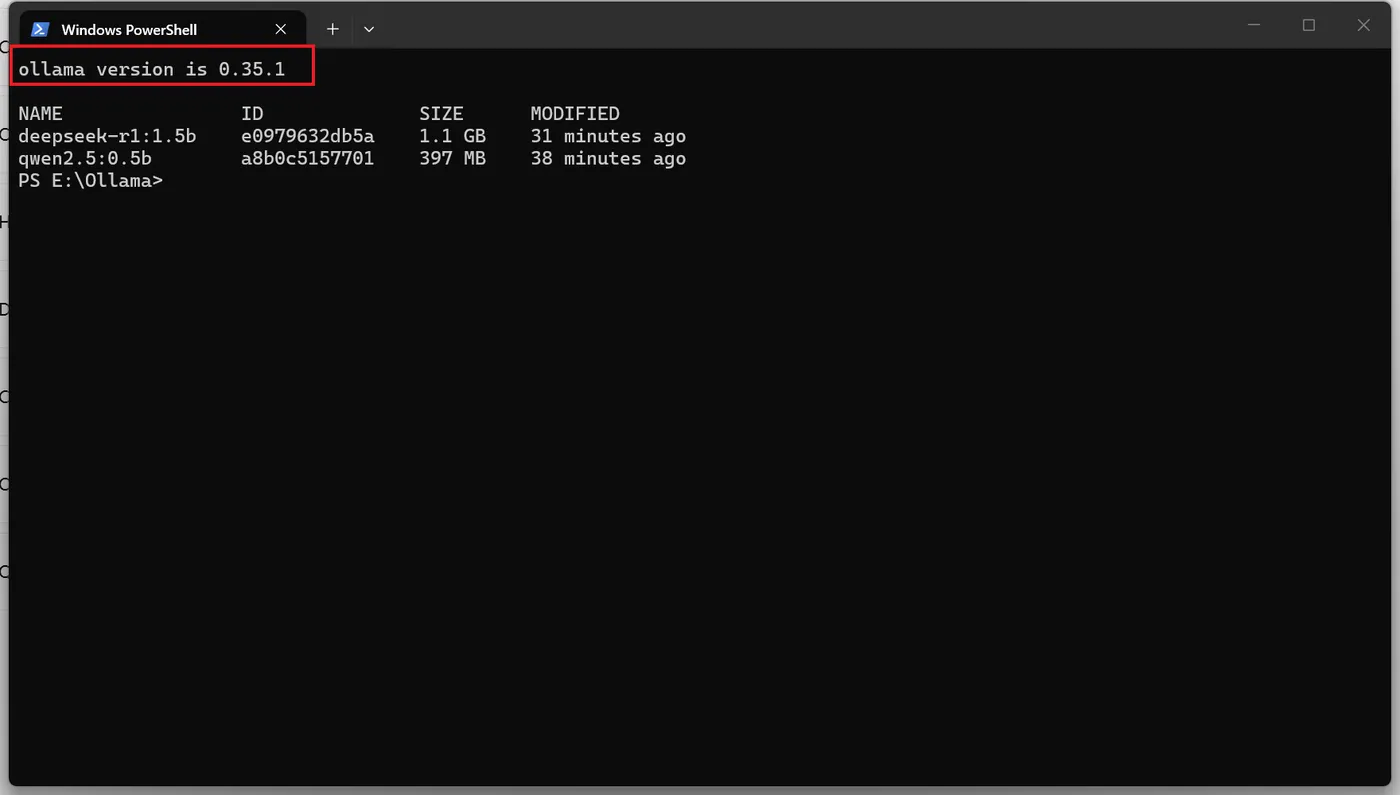
ollama version is 0.35.1 下方 ollama list 显示本机已有的 deepseek-r1:1.5b(1.1 GB)和 qwen2.5:0.5b(397 MB)。
新手提醒:直接裸敲一个
ollama(不带 run/pull 等参数)会进入一个英文的"编码代理启动"菜单(Launch Claude Code / OpenCode 等,那是给开发者接入编程工具用的)。看不懂直接关掉窗口即可,日常使用记住ollama run 模型名这一条就够了。
附:常用命令速查
| 命令 | 作用 |
| ollama pull 模型名 | 只下载模型,不进入对话 |
| ollama run 模型名 | 下载(如未下载)并进入对话 |
| ollama list | 查看已下载的全部模型 |
| ollama ps | 查看正在运行的模型(是否走 GPU、内存占用) |
| ollama rm 模型名 | 删除已下载的模型(释放磁盘) |
| /bye | 在对话中退出,回到终端 |
想找更多模型,打开 Ollama 官网的 Models(模型库) 页面,DeepSeek-R1、Qwen2.5、Llama 3.2、Gemma 等都在里面,页面上直接给了对应的 ollama run 命令,复制即可。
七、模型存在哪?C 盘不够用怎么改到 D 盘?
1) 默认位置:用户目录下的 .ollama 文件夹
Ollama 程序本体不大,但模型默认全部下载在 C 盘用户目录:
C:\Users\你的用户名\.ollama\models
把这个路径粘贴到资源管理器地址栏回车即可打开。里面有三个文件夹:blobs、manifests、metadata:
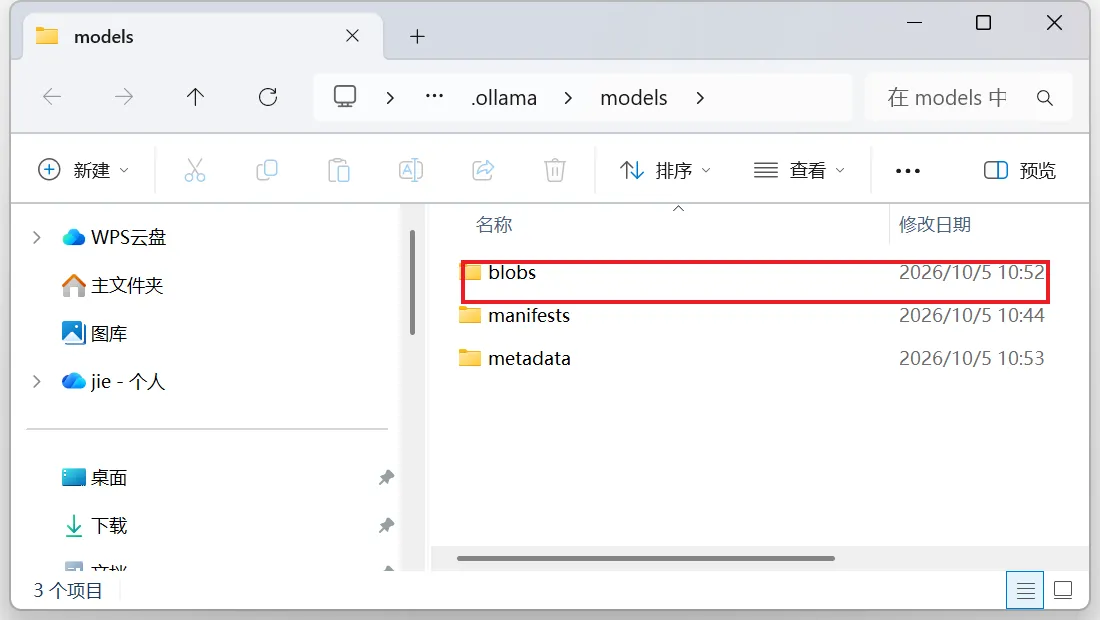
红框:blobs 文件夹里就是模型的真实数据(按 sha256 校验值命名),manifests 是模型清单,metadata 是元数据。
打开 blobs 可以看到,两个模型实际由 10 个数据文件组成,共约 1.41 GB;其中最大的单个文件有 1,091,134 KB(约 1.06 GB,就是 1.1B 模型的主体):
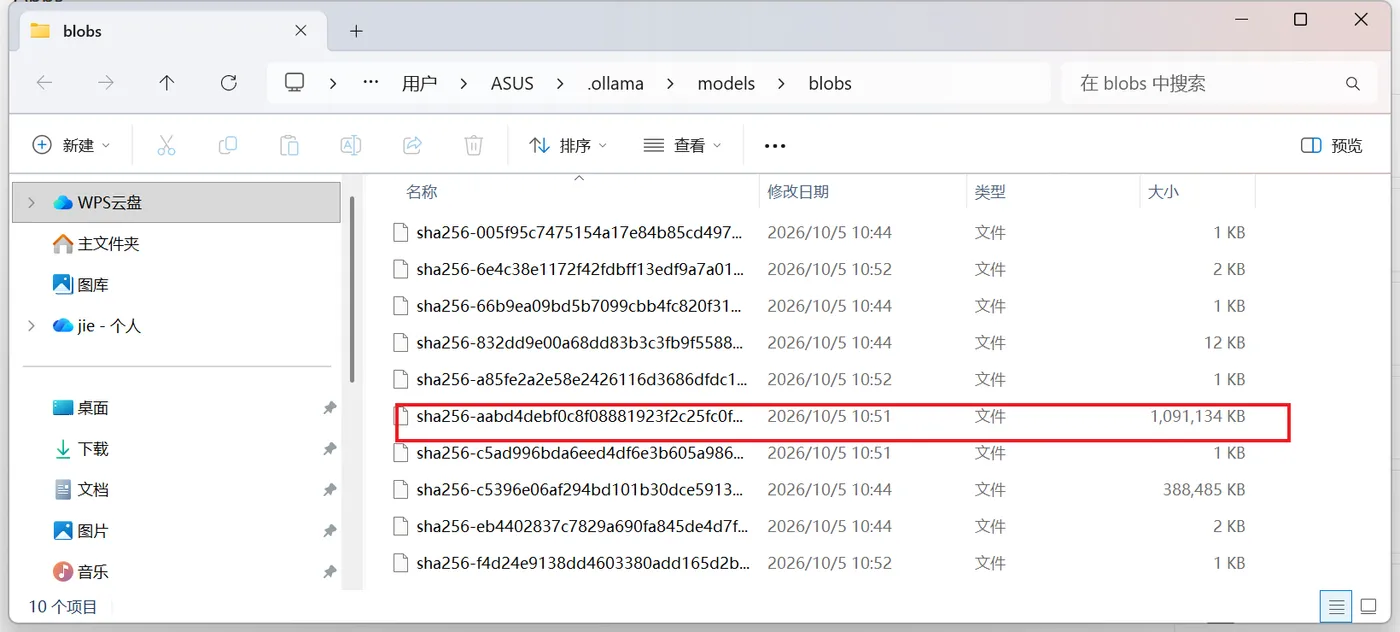
红框:最大的数据文件 1,091,134 KB。这些文件名不要手动改、不要单独删——删除模型请用
ollama rm 模型名,Ollama 会自动清理关联文件。
2) 把模型目录改到 D 盘(设置 OLLAMA_MODELS 环境变量)
C 盘空间紧张的话,通过一个叫 OLLAMA_MODELS 的环境变量改位置,三步搞定。本例演示改到 D:\ollama\models(请先在 D 盘手动建好这个文件夹)。
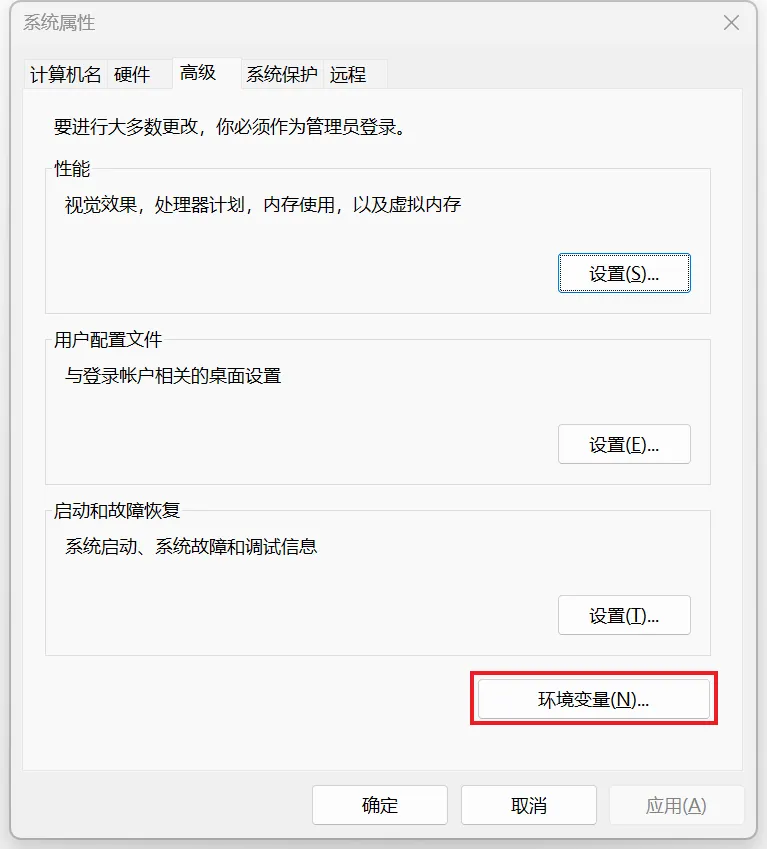
第 1 步:打开"环境变量"设置。 按 Win + R,输入 sysdm.cpl 回车,打开"系统属性",切到"高级"选项卡,点右下角的"环境变量(N)...":
第 2 步:新建用户变量。 在"环境变量"窗口上半部分("你的用户名 的用户变量"),点"新建(N)...":
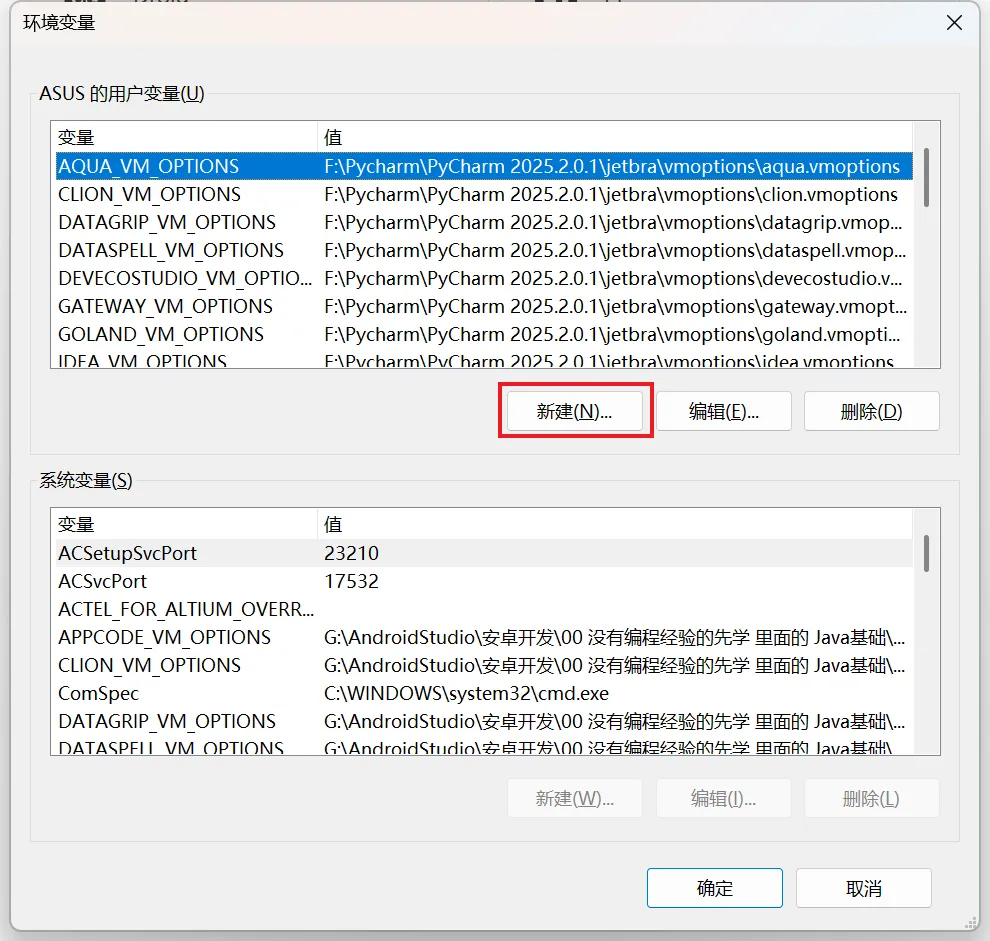
红框:在上半部分"用户变量"区域点新建(N)...(不用动下面的系统变量,也不需要管理员权限)
第 3 步:填写变量名和变量值。 变量名填 OLLAMA_MODELS,变量值填你想存放模型的文件夹完整路径(本例为 D:\ollama\models),然后一路点"确定"关掉所有窗口:
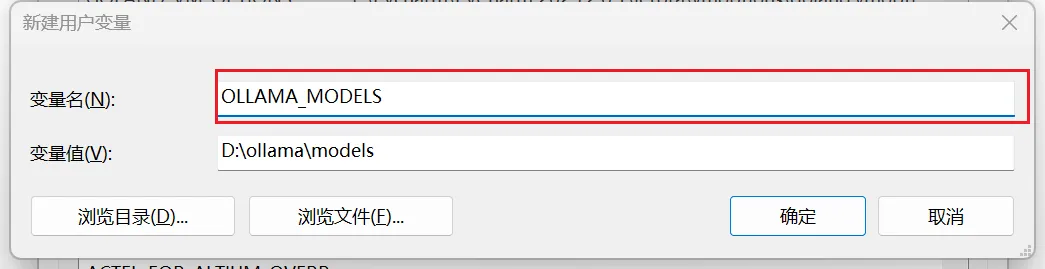
变量名必须一字不差填 OLLAMA_MODELS;变量值填目标文件夹路径,如 D:\ollama\models(文件夹要提前建好)
最后一步(必须做):右键托盘羊驼 → Quit Ollama 完全退出,再从开始菜单重新打开 Ollama,新路径才会生效。此后 ollama pull 的新模型都会存到 D 盘。
已有模型想一起搬走? 先 Quit Ollama,把
C:\Users\你的用户名\.ollama\models里的 blobs、manifests、metadata 整个剪切到新目录(如D:\ollama\models),再按上面三步设置环境变量、重启 Ollama 即可,已下载的模型不用重下。
顺带认识一个地址:Ollama 服务运行时,用浏览器访问 http://127.0.0.1:11434,看到 "Ollama is running" 就说明后台服务正常。第三方图形界面、编程插件都是通过这个本地接口连接 Ollama 的。
八、下载慢/报错?常见问题对照表
| 现象 | 原因 | 怎么办 |
| 终端输入 ollama 提示 "无法将 ollama 识别为 cmdlet…" | 安装前打开的旧终端没刷新 PATH 环境变量 | 关掉终端重新打开即可;临时修复:在当前 PowerShell 执行 $env:Path += ';' + $env:LOCALAPPDATA + '\Programs\Ollama' |
ollama pull 长期卡在 0%、速度只有几 KB/s、报 timeout |
当前网络到官方模型服务器连接不畅 | ① 直接重新执行同一条 pull 命令,支持断点续传,多试几次;② 切换网络(如手机热点)或关闭/开启代理后重试;③ 可在网上检索社区维护的 Ollama 国内镜像地址,通过 OLLAMA_DOMAIN 环境变量指定后再拉取(镜像地址以社区最新可用的为准)。本文实测官方源直连可达 16~19 MB/s,大部分网络无需镜像 |
| 对话时报 out of memory / 显存不足 | 模型太大,显存装不下 | Ollama 会自动把装不下的部分交给 CPU/内存(会明显变慢但通常仍能跑);想流畅就换小模型(如 0.5b / 1.5b),先 ollama rm 大模型名 释放空间 |
| 启动报错 端口 11434 被占用 / address already in use | 其他程序占用了 11434 端口(或已有一个 Ollama 在跑) | 先看托盘是否已有羊驼图标(说明已在运行);确实被别的程序占用时,可新建用户变量 OLLAMA_HOST,值设为 127.0.0.1:11435 等其他端口后重启 Ollama |
| 桌面 App 里找不到聊天输入框 | v0.35.1 本地模式主页本身就只是命令引导页,属正常设计 | 按第六章在 PowerShell 里用 ollama run 模型名 对话;想要图形聊天界面,可另装 Open WebUI 等第三方界面连接本机 11434 接口 |
| 模型想删掉、释放磁盘 | — | 终端执行 ollama rm 模型名(先 ollama list 看准确名字);不要手动删 blobs 里的文件 |
| 回答速度很慢、风扇狂转 | 当前在纯 CPU 上运行大模型 | ollama ps 看 PROCESSOR 列;没显卡或显卡太老就换更小的模型,0.5b/1.5b 在 CPU 上也能较快 |
| 模型下到一半中断了 | 网络波动 | 重新执行同一条 ollama pull,自动断点续传 |
| 杀毒软件报毒/拦截 | 个别杀软对未见过签名的安装包误报 | OllamaSetup.exe 带有 Ollama Inc. 数字签名,确认文件来自本文网盘或官方发布页后,在杀软中加信任即可 |
| 想确认后台服务是否正常 | — | 浏览器访问 http://127.0.0.1:11434,显示 "Ollama is running" 即正常 |
| Mac / Linux 怎么装 | 本文以 Windows 为例 | 官网下载对应安装包(Mac 区分 Intel/Apple 芯片,Linux 可用官方一键脚本),pull/run/list 等命令完全相同 |
九、Ollama 的几个相关问题
Q1:Ollama 安全吗?
我的对话内容会不会被上传? 不会。模型文件全部下载在本机,推理计算也在本机完成,使用过程中对话数据不出你的电脑,断网照样能聊——这也是它和在线 ChatGPT、DeepSeek 网页版最大的区别。软件本身是 MIT 协议开源的,安装包带 Ollama Inc. 官方数字签名,可放心使用。
Q2:本地跑的模型,和 ChatGPT、DeepSeek 网页版比谁厉害?
论"聪明程度",7B 级别的本地小模型通常打不过 GPT、DeepSeek 的云端旗舰大模型;但 Ollama 胜在免费、无额度、不排队、完全离线、数据不外传。日常问答、写邮件、改代码、处理私密资料完全够用,而且随着开源模型快速迭代,本地模型的效果一直在逼近云端。
Q3:我没有独立显卡、电脑配置一般,能玩吗?
能。先从 qwen2.5:0.5b(397 MB)、deepseek-r1:1.5b(1.1 GB)这种小模型入手,8 GB 内存的普通办公本用 CPU 就能跑动,只是回答速度比带显卡的机器慢一些。对照第二章的配置表选模型即可。
Q4:Ollama 和 LM Studio 有什么区别?
两者都是本地跑开源模型的热门工具。LM Studio 主打图形界面,搜索、下载、聊天全程点鼠标,适合完全不想碰命令的用户;Ollama 以命令行为主、程序更轻、后台常驻,并且生态接入最广——大量第三方客户端、编辑器插件、编程助手都默认支持连接 Ollama。新手可以先用 Ollama 跑通,再按需尝试图形界面。


