

通义妙谈 -图像模型玩转更多可能!通义万相新升级 一个包罗万象的“应用广场”!
“买家秀”秒变“卖家秀”,AI一键更换商品模特,虚拟模特功能等你解锁🔒 “小草图”秒变“大制作”,AI涂鸦作画让你的草图“一秒”成画🖌️ “2-4图”生成“个人写真”,AI虚拟分身在线创作,在家也是巴厘岛🏖️ 阿里云的微博视频 全网征集灵魂画手,几笔生成精美大作,精美礼物等你来拿


通义妙谈-阿里云图像生成大模型通义万相,Composer算法实现绘图精准可控
通义妙谈-阿里云图像生成大模型通义万相,Composer算法实现绘图精准可控
facechain人物写真生成工业级开源
facechain人物写真应用自8月11日开源了第一版证件照生成后。目前在github(GitHub - modelscope/facechain: FaceChain is a deep-learning toolchain for generating your Digital-Twin.)上已有5.7K的star,论文链接:FaceChain: A Playground for Identity-Preserving Portrait Generation:https://arxiv.org/abs/2308.14256。

【IJCAI 2023】流感知优化之 DAMO-StreamNet 论文解读
传统视频目标检测(Video Object Detection, VOD)是离线(offline)的检测任务,即仅考虑算法的检测精度,未考虑算法的延时。流感知(Streaming Perception)任务作为VOD的一个细分方向,采用流平均精度(Streaming Average Precision, sAP)指标,衡量算法的在线(online)检测能力,即同时衡量算法的精度和延时。本文针对现有的流感知工作在训练方式和模型感受野两方面的不足,提出了DAMO-StreamNet,在保证算法实时性的前提下,实现了SOTA的性能。

ChatGPT最强专业学习资料集锦
本文旨在整理一份可供参考和学习的专业ChatGPT相关资料,包括ChatGPT相关论文、Github项目、以及当前市场上出现的ChatGPT相关产品等。
【阿里云OpenVI-人脸感知理解系列之人脸识别】基于Transformer的人脸识别新框架TransFace ICCV-2023论文深入解读
本文介绍 阿里云开放视觉智能团队 被计算机视觉顶级国际会议ICCV 2023接收的论文 "TransFace: Calibrating Transformer Training for Face Recognition from a Data-Centric Perspective"。TransFace旨在探索ViT在人脸识别任务上表现不佳的原因,并从data-centric的角度去提升ViT在人脸识别任务上的性能。

【阿里云OpenVI-视觉生产系列之图片上色】照片真实感上色算法DDColor ICCV2023论文深入解读
图像上色是老照片修复的一个关键步骤,本文介绍发表在 ICCV 2023 上的最新上色论文 DDColor

AIGC视频生成/编辑技术调研报告
随着图像生成领域的研究飞速发展,基于diffusion的生成式模型取得效果上的大突破。在图像生成/编辑产品大爆发的今天,视频生成/编辑技术也引起了学术界和产业界的高度关注。该分享主要介绍视频生成/编辑的研究现状,包括不同技术路线的优劣势,以及该领域当下面临的核心问题与挑战。
AIGC玩转卡通化技术实践
伴随着持续不断的AIGC浪潮,越来越多的AI生成玩法正在被广大爱好者定义和提出,图像卡通化(动漫化)基于其还原效果高,风格种类丰富等特点而备受青睐。早在几年前,伴随着GAN网络的兴起,卡通化就曾经风靡一时。而今,伴随着AIGC技术的兴起和不断发展,扩散生成模型为卡通化风格和提供了更多的创意和生成的可能性。本文就将详细介绍达摩院开放视觉团队的卡通化技术实践。
AIGC图像分辨率太低?快来试试像素感知扩散超分模型,你想要的细节都在这里
阿里巴巴最新自研的像素感知扩散超分模型已经开源,它把扩散模型强大的生成能力和像素级控制能力相结合,能够适应从老照片修复到AIGC图像超分的各种图像增强任务和各种图像风格,并且能够控制生成强度和增强风格。这项技术的直接应用之一是AIGC图像的后处理增强和二次生成,能够带来可观的效果提升。
OpenVI-感知理解系列之GAP骨骼点动作识别 ICCV23顶会论文深入解读
本文介绍了ICCV23中稿论文 GAP: Generative Action Description Prompts for Skeleton-based Action Recognition
本地生活技术雷达——生成式AI(Generative AI)在阿里本地生活的应用与思考
本地生活技术雷达是由本地生活技术中心战略管理&PMO团队开展的,定期扫描和评估新兴技术的战略研究工作。目的是对技术趋势进行前瞻性预判,提出新技术布局建议,在技术驱动业务创新和业务增长、践行社会责任等方面有一些实质性探索。 本篇尝试探讨 1)理解AI范式——从分析型(Analytical AI)到生成式(Generative AI)的拐点在2022年,其对人类社会以及商业模式的长期影响; 2)生成式AI(文生文、文生图、图生图等)在本地业务目前场景的应用和未来的方向。 欢迎技术、产品、运营、战略、管理层、国内国际等各种视角的指点和碰撞!
核验留档技术方案:团队交接中的证据选择与复查约束
文件处理核验进入团队交接后,难点是让没有参与操作的人理解材料能说明什么。本文按协作需求、证据选择、记录字段与复查约束,整理一套留档方案,说明页面截图、HAR与处理条件各自的边界;未包含实测数据。
从零实现中文车牌识别:YOLOv8 + LPRNet 训练、ONNX 部署与云端 API 接入实践
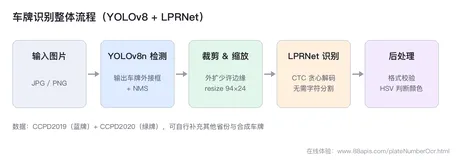
本文基于开源的 YOLOv8 和 LPRNet,完整实现一套中文车牌检测与识别流程,内容包括 CCPD 数据集处理、检测模型训练、CTC 字符识别原理、ONNX 推理部署和车牌颜色判断,并对比了自建模型与调用云市场 API 两种落地方式,给出各自适用的场景。文中代码均可直接运行。
AI生成口播数字人越来越方便了
阿里数字人服务:输入文案/录音/照片/PPT,秒生成开口说话的数字人视频。支持克隆形象、照片驱动、PPT讲解三模式,自选模板、背景、字幕与方言,按分钟计费(0.5元起)。所有参数均源自真实技术限制,非宣传口径。(240字)
宠物面部识别鲁棒性优化:多策略融合与边缘部署实践
本文探讨智慧养宠中宠物面部识别的鲁棒性提升策略,聚焦非合作场景下的光照多变、姿态随意等核心挑战。系统梳理数据增强、光照归一化、姿态校正、模型优化、多任务学习等关键技术路径,兼顾精度与边缘部署需求,助力实现“任意角度、任意光照下精准识宠”。
实战复盘:用AI做AI漫剧亏损归因分析,从扒数据到出可视化报告全流程
这是一份用AI完成的AI漫剧亏损归因实战报告:涵盖数据采集、建模分析(Python量化回本门槛)、五重挤压归因、多载体交付(HTML/PDF/Word)及6条可复用运营规律,全程开源可验证。(239字)
技术方案:从HAR线索还原端侧推理会话边界
收到一份HAR记录时,如何还原端侧推理会话的边界?本文按请求方向、响应体积、Timing、Mime Type以及Request Body、Response Body是否可见逐项说明能判断什么、不能判断什么,区分模型资源与用户文件流向,并说明缓存推断需要的处理条件。相关方法为建议流程,未包含实测数据。
高效率办公PDF批量处理:批量合并多文件夹中相同文件名为独立PDF,咕嘎同名文件合并系统应用案例
咕嘎批量合并系统专为办公归档设计,支持跨多级文件夹扫描PDF/图片,按文件名完全相同或关键字自动分组,一键合并为单个PDF。适配合同、发票、课件、图纸等场景,效率提升10倍以上。
想把几个动作片段接起来给 AI 参考,怎么做?
先把各段统一到相同尺寸、帧率和像素格式,再按顺序拼接,核对接点后提取控制素材。本文给出 ffmpeg 命令、时间表与合成素材 CPU 验证。
没有网络的电脑,怎样准备动作提取环境?
先按目标机器的系统、架构、Python 和运行设备准备完整 wheelhouse、两份 ONNX 模型、ffmpeg 与 SHA 清单,再断网安装并分别验收依赖、模型加载和动作输出。本文为固定版本的准备方案。
茶叶采摘点识别 嫩芽图像识别 机器人采茶点识别 AI图像数据集
# 茶叶实例分割数据集 | 项目 | 详情 | | -------- | ---------------------- | | 任务类型 | 实例分割 | | 图片总量 | 13000张 | | 分类数量 | 1类 | | 标注格式 | YOLO txt | |
动作参考换了设置,怎样查清结果为什么不同?
把参考片、提取配置、原始深度、控制片与生成请求关联归档,再用只改一个因素的对照追查结果差异。提供 ReShot 0.5.0 命令与实验记录模板。
Windows 下 YOLO26 的 TensorRT C++ 部署
本文详解Windows下基于TensorRT 10.16的YOLO26 C++部署全流程:涵盖VS2022/CUDA 12.9/OpenCV 4.8.1环境搭建、FP32/FP16/INT8模型导出与Engine序列化、命令行推理及自训练模型部署。实测单帧推理仅约1.4ms,速度较ultralytics Python提升14倍。
给AI视频准备的动作参考抖动、慢半拍,怎么办?
给 AI 视频准备动作参考时,先用同一片段的稳定版与原始版区分关节抖动、动作跟随迟滞和显隐闪烁。本文给出 ReShot 0.5.0 对照命令、动作时点记录表与已有实验的正确读法。
做AI视频时,线稿太乱、主体看不清怎么办?
AI视频线稿杂乱或主体轮廓断裂时,可固定同一参考片和输出设置,分别调整Canny阈值,记录轮廓、干扰线与播放稳定性,选出适合交接的控制素材。
怎么把图片一键转成视频?完整流程与可复用结论
本文详解图片一键转视频的完整方法论:覆盖5大高频场景(活动预热、商品展示、内容复用等),提炼可复用的“五步流程”与“七项质检清单”,总结5条核心结论——强调素材质量决定上限、动效宜缓不宜快、先定渠道再定参数。无需剪辑软件,AI赋能实现“一句话生成动态视频”,大幅提升轻量视频生产效率。(239字)
保洁有没有在 “真干活”?YOLO 行为检测让清洁过程看得见、算得清
该方案基于YOLO模型,专注识别保洁人员“是否正在清洁”这一核心状态(如拖地、扫地、擦拭等),将监控画面转化为可统计的作业时长、频次等客观数据,助力物业实现从“人盯人”到“AI盯行为”的精细化、可追溯管理。
给AI视频准备动作参考时,手脚为什么时有时无?
给 AI 视频提取动作参考时,骨架手脚忽隐忽现应先查原片遮挡、人物检测与关节分数,再比较默认稳定和原始输出。本文给出 ReShot 0.5.0 的对照命令、关键点观察方法及已有实验的适用范围。
给AI视频准备动作参考时,手脚为什么时有时无?
给 AI 视频提取动作参考时,骨架手脚忽隐忽现应先查原片遮挡、人物检测与关节分数,再比较默认稳定和原始输出。本文给出 ReShot 0.5.0 的对照命令、关键点观察方法及已有实验的适用范围。
给AI Agent接入联网搜索:一个可落地的检索流水线
为AI Agent添加联网搜索,远不止调用API:需构建完整检索链路——精准判断搜索必要性、多轮查询改写、结果标准化去重、权威来源排序、正文精读与引用校验,才能确保答案既实时又可靠。(239字)
图片去背景技术深度解析
本文系统梳理图片去背景技术从传统图像处理(阈值分割、GrabCut)到深度学习(U-Net、Mask R-CNN、SAM)的演进脉络,剖析算法原理与工程落地难点,对比主流方案优劣,并探讨Alpha Matting、端侧推理、生成式填充等前沿趋势,展现“像素级剥离”如何从美工苦力活蜕变为智能创作基础设施。(239字)
企业宣传片ai怎么做?生成前的素材资产清单YAML与授权、AI标识核对表
本文回答:用 AI 做企业宣传片前,LOGO、产品图、场景照片、人物肖像、声音和音乐这些素材资产各进不进模型、按什么规格准备和命名、提示词里怎么引用,肖像、声音、委托拍摄作品和音乐的授权要留哪些记录,发布时 AI 生成内容怎么标识;附一份可照填的资产清单 YAML 和发布前合规核对表。
千川素材怎么做?AI母版到上传的六段流水线YAML与裁切判定表(2026)
本文回答:千川素材怎么做——把 AI 做千川视频素材拆成六段处理流水线(卖点入库、母版生成、画幅重构、逐版压字幕、AI 生成标识、读素材评估标签回填),给出可照填的流水线配置 YAML、母版提示词约束模板、各画幅裁切保留比例与产品框判定表,以及按评估标签决定从哪一段重跑的回退规则。
错误无误公理——错误正确本同源都迭代定律——逆转有价值
本篇提出“错误无误公理”与“错误正确本同源都迭代定律”:错误无本体之“误”,仅为关系重组态(B=C);正确与错误同源(皆为A×B→C产物),且均须迭代——稳态暂存,失配可转。由此解构权威双罪(贬错+崇对)、资社对立、官民等级幻觉,主张“用错迭对”,恢复迭代通道。本篇亦自适用此律,终将被迭代。(239字)
【开源项目推荐】Rebucca 视频分析模型/平台调研报告
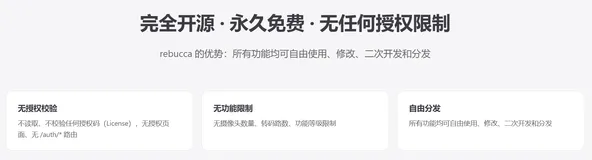
本文详细介绍并全方位调研了开源热门视频分析平台Rebucca。Rebucca 是一款开源免费的智能视频分析平台,基于 Python + ZLMediaKit + YOLO,支持 GB28181/RTSP/RTMP/ONVIF 接入、多模型推理(PyTorch/ONNX/OpenVINO)、小模型检测+大模型语义复核,以及区域入侵、越线、滞留、密度等6类布控规则。适用于园区、工地、仓库等中小规模AI布控验证与二次开发,但大规模生产需压测加固。
从自然语言到可编辑视频:Timeline Studio 的 AI 剪辑实现思路
本文介绍 Timeline Studio 如何构建可靠、可验、可续的 AI 视频编辑执行机制:通过分层工程模型、结构化 JSON 计划、语义预览、stateToken 状态校验、双时钟映射等设计,确保用户一句话指令能精准转化为可检查、可修改、不冲突的编辑操作,真正实现浏览器端对话式视频制作。
文案变成视频怎么做?先转成镜头表:提示词模板与9项校验清单
本文回答:文案变成视频怎么做——把一段文案转成镜头表的规则(文案句子怎么改成看得见的动作、每镜时长怎么估、旁白和画面怎么分轨),一份可直接复制的「文案 → 镜头表」提示词模板和示例输出,9 项校验清单,镜头表字段怎么落进生成提示词,以及几种做法里镜头表由谁来出。
投放素材怎么批量做?1条母版出10个版本的变量矩阵与追踪YAML
本文回答:投放素材怎么批量做——用一份变量矩阵把一条无字幕母版按开头三秒、卖点顺序、画幅、字幕裂变成 10 个版本;母版由 AI 生成时要交出什么、替换开头怎么写提示词;版本编码与追踪 YAML 怎么写;出版本前的核对清单;上线后怎么把巨量引擎素材评估标签回写到矩阵。