




PPT大纲生成的AI魔法:3小时工作3分钟搞定,但重点不是效率
本文从反常识角度切入,通过三个场景案例,阐述AI大纲生成工具的真正价值不在于效率提升,而在于帮助使用者建立结构化思维模式。文章提供完整的AI指令和系统的使用进阶指南。
商务邮件沟通效率提升85%:一套AI指令解决企业邮件痛点
本文基于3000+企业邮件案例,提供一套专业的AI商务邮件指令,通过数据驱动的方法论,帮助企业实现邮件沟通效率提升85%,客户转化率增加60%,年度ROI达400%。包含完整指令代码、实战案例和量化收益分析。
2025年第13批中国深度合成算法备案分析报告
2025年9月,第13批深度合成算法备案公布,共586项,累计达4420项。北京、广东、浙江、上海居前列,民企为主力,覆盖教育、医疗、金融等领域。文本与对话生成占主导,数字人、多模态技术加速落地。AI应用向行业纵深发展,合规标识成常态,监管趋严推动产业规范创新。
Qwen3 Next 在 TensorRT LLM 上的部署指南
本指南介绍如何在TensorRT LLM框架上部署Qwen3-Next-80B-A3B-Thinking模型,基于默认配置实现快速部署。涵盖环境准备、Docker容器启动、服务器配置与性能测试,支持BF16精度及MoE模型优化,适用于NVIDIA Hopper/Blackwell架构GPU。
精通RAG:从“能用”到“好用”的进阶优化与评估之道
你的RAG应用是否总是答非所问,或者检索到的内容质量不高?本文聚焦于RAG系统的进阶优化,深入探讨从查询转换、多路召回与重排序(Rerank)等高级检索策略,到知识库构建的最佳实践。更重要的是,我们将引入强大的`Ragas`评估框架,教你如何用数据驱动的方式,科学地量化和提升你的RAG系统性能。
AutoGen - 架构学习指南
AutoGen 是微软开源的 AI Agent 框架,支持多智能体协作与分布式部署。本指南从架构解析、技能清单到学习路径,带你由浅入深掌握其核心原理与实战应用,助力构建可扩展的智能系统。
Gemini CLI 架构学习指南
本指南深入解析开源终端AI助手Gemini CLI的架构设计,涵盖项目结构、核心流程与技术栈(TypeScript/React+Ink/Node.js),并提供从环境搭建到贡献代码的四阶段学习路径,助力开发者掌握AI编程工具开发精髓。
告别旅行规划的"需求文档地狱"!这个AI提示词库,让你像调API一样定制完美旅程
作为开发者,旅行规划如同“需求地狱”:信息碎片、需求多变、缺乏测试。本文提出一套“企业级”AI提示词库,将模糊需求转化为结构化“API请求”,实现标准化输入输出,让AI成为你的专属旅行架构师,30分钟生成专业定制方案,提升决策质量,降低90%时间成本。

软考中级软件设计师专项-结构化开发专题
本模块聚焦软考中级“软件设计师”核心考点,系统讲解需求建模、结构化分析与设计(SA/SD)、数据流图(DFD)、状态转换图等关键内容,深入剖析高内聚低耦合、模块独立性、系统文档规范等设计原则,结合近十年真题精讲,助力考生掌握系统架构设计与代码复用技能,实现从编码到设计的思维跃迁。
鸿蒙 HarmonyOS NEXT端云一体化开发-云存储篇
本文介绍用户登录后获取昵称、头像的方法,包括通过云端API和AppStorage两种方式,并实现上传头像至云存储及更新用户信息。同时解决图片缓存问题,添加上传进度提示,支持自动登录判断,提升用户体验。
大型语言模型为何产生幻觉
语言模型为何会产生幻觉?OpenAI 最新研究指出,幻觉源于模型在训练和评估中被鼓励猜测而非承认“不知道”。即使强大如 GPT-5,也无法完全避免幻觉。改进评估方式、奖励模型表达不确定性,是减少幻觉的关键。
高级RAG优化手册:3招解决检索不准和查询模糊
本文深入解析RAG(检索增强生成)技术的核心优化方法,涵盖背景、架构与实践。RAG通过整合外部知识库,弥补大语言模型在实时性、准确性和专业性上的不足,广泛应用于企业场景。文章系统讲解RAG如何解决知识静态、生成幻觉与专业深度不足等问题,并剖析其离线索引与在线生成的闭环流程。此外,还介绍了高级优化策略,如查询重写、混合检索与结果重排序,助力突破RAG应用瓶颈。
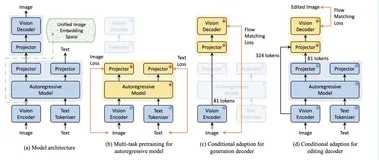
AI-Compass LLM合集-多模态模块:30+前沿大模型技术生态,涵盖GPT-4V、Gemini Vision等国际领先与通义千问VL等国产优秀模型
AI-Compass LLM合集-多模态模块:30+前沿大模型技术生态,涵盖GPT-4V、Gemini Vision等国际领先与通义千问VL等国产优秀模型
Arthas heapdump(dump java heap, 类似 jmap 命令的 heap dump 功能)
Arthas heapdump(dump java heap, 类似 jmap 命令的 heap dump 功能)
通义灵码编程智能体,上线!
通义灵码现在已经全面支持 Qwen3,并正式上线编程智能体,具备自主决策、环境感知、工具使用等能力,可以根据开发者的诉求,使用工程检索、文件编辑、终端等工具,端到端地完成编码任务。
🚀Bolt.diy:五分钟免费搭建个人博客,开启你的数字创作之旅!(保姆级教程)
Bolt.diy 是 Bolt.new 的一个开源版本,它提供了更高的灵活性和可定制性。通过自然语言交互,它能够简化开发流程,并提供全栈开发支持,同时允许用户进行二次开发。它就像是你的数字创作伙伴,帮你把想法变成现实。在数字化时代,拥有一个个人博客不仅是一种展示自我的方式,更是一种记录生活、分享知识、连接世界的桥梁。通过阿里云的 Bolt.diy,我仅用五分钟就搭建了一个功能齐全、美观大方的个人博客,这让我深刻感受到了技术的力量和便捷性。
Ai好记全面接入DeepSeek大模型!重塑知识管理新体验
Ai好记融合DeepSeek大模型,带来知识管理新纪元。视频秒变知识胶囊,外语资料自动转母语,一键构建思维导图。六大核心能力包括结构化笔记、AI播客、全平台解析等,全面提升学习和工作效率。立即登录aihaoji.com体验!
基于阿里云通义千问开发编程辅助与代码生成工具
随着软件开发需求的增加,编程辅助与代码生成工具成为开发者提高效率的利器。这类工具能够根据用户描述生成代码片段、协助调试、生成自动化脚本等,大大减少重复性劳动。阿里云通义千问作为一款先进的大语言模型,具备强大的自然语言处理和代码生成能力,非常适合用于开发这样的工具。
深入剖析 Qwen2.5 - 32B 模型在 VLLM 上的单机三卡部署与运行
本文深入探讨了Qwen2.5 - 32B模型在VLLM框架上的部署过程,从模型下载、启动命令、资源占用分析到GPU资源分配及CUDA图应用,详述了大模型运行的挑战与优化策略,强调了硬件资源规划与技术调优的重要性。

前端大模型应用笔记(五):大模型基础能力大比拼-计数篇-通义千文 vs 文心一言 vs 智谱 vs 讯飞vsGPT
本文对比测试了通义千文、文心一言、智谱和讯飞等多个国产大模型在处理基础计数问题上的表现,特别是通过链式推理(COT)提示的效果。结果显示,GPTo1-mini、文心一言3.5和讯飞4.0Ultra在首轮测试中表现优秀,而其他模型在COT提示后也能显著提升正确率,唯有讯飞4.0-Lite表现不佳。测试强调了COT在提升模型逻辑推理能力中的重要性,并指出免费版本中智谱GLM较为可靠。

获取任意网站 icon 这件事并没那么简单
本文源自开发者Pony在创作“标签星球”过程中遇到的一个需求:如何高效获取并展示网站的Logo。为此,他深入研究并自建了一套图标获取与托管服务。标签星球是一款基于浏览器收藏夹的启动页应用,能将收藏夹转换为导航页形式,并支持模糊搜索及收藏夹分享等功能。在寻找合适服务时,Pony发现现有解决方案要么受限于技术壁垒,要么覆盖范围有限,这促使他着手搭建自己的服务。文章详细介绍了该服务的设计思路和技术实现过程,包括对多种网站图标设置方法的分析、链接处理策略、获取流程、缓存机制以及错误处理方案等。

阿里云服务器部署Jupyter私房菜
在阿里云ECS上,选用2核2G的配置,安装Ubuntu 22.04,然后部署Nginx作为Jupyter Notebook的反向代理。安装Miniconda3,配置清华TUNA镜像源以加速下载。创建Jupyter Notebook,设置密码和远程访问,通过Nginx配置实现安全访问。整个过程包括安装Jupyter,修改Nginx配置,最后通过浏览器访问 Notebook。

还在因AI检测头疼?尝试一下 AI Humanize
AI Humanize是一款将AI文本转化为人性化、难以检测的高质量内容的工具。它提供基础和高级模型,支持多语言,如英语、中文等,并能在多种AI检测器中通过。训练于大量人类语料库,AI Humanize的"Humanize AI LLM"模型确保生成自然、流畅的文本,增强可读性和原创性,同时保持用户友好界面。适用于各领域的用户提升内容质量。[AI Humanize](https://aihumanize.io/)**

技术小白能看懂的ChatGPT原理介绍
网上有关 ChatGPT 的原理介绍文章一大堆,要么是从 NLP 的历史开始讲起,要么是上数 GPT 3 代,内容都相对冗长和复杂。其实 ChatGPT 的原理并不难理解,我将以最通俗易懂的方式为技术小白解读,帮助大家更好地了解这一技术


2023云栖大会 | 阿里云发布通义千问2.0
今天,阿里云正式发布千亿级参数大模型通义千问2.0。在10个权威测评中,通义千问2.0多方面性能超过GPT-3.5,正在加速追赶GPT-4。 此外,通义千问APP在各大手机应用市场正式上线,所有人都可通过APP直接体验最新模型能力。 过去6个月,通义千问2.0在性能上取得巨大飞跃,相比4月发布的1.0版本,通义千问2.0在复杂指令理解、文学创作、通用数学、知识记忆、幻觉抵御等能力上均有显著提升。目前,通义千问的多方面性能已经超过GPT-3.5,加速追赶GPT-4。

数据缓存系列分享(六):通义千问Qwen-14B大模型快速体验
阿里达摩院近期对通义千问大模型 Qwen-14B 进行了开源(之前开源的是Qwen-7B模型),目前在ModelScope和HuggingFace上均可直接下载。关于Qwen-7B的搭建可以参考我们之前的文章:数据缓存系列分享(五):开源大语言模型通义千问快速体验版,本文将使用一样的方式打开Qwen-14B,快速体验一下。

通义千问开源模型——改变自然语言处理的未来
众所周知,自然语言处理是人工智能领域的一个重要分支,也是近年来备受瞩目的领域之一。而通义千问开源模型作为自然语言处理领域的重要成就之一,近年来也引起了广泛的关注和讨论,那么接下来就来简单聊聊通义千问开源模型。

如何向大模型注入知识?达摩院通义对话模型SPACE系列探索
如何将人类先验知识低成本融入到预训练模型中一直是个难题。达摩院对话智能团队提出了一种基于半监督预训练的新训练方式,将对话领域的少量有标数据和海量无标数据一起进行预训练,从而把标注数据中蕴含的知识注入到预训练模型中去,打造了SPACE 1/2/3 系列模型,在11个国际公开对话数据集取得SOTA。
用 SQL 把 AI 回答做成可比表:三张表与一次 join
本文提出一种面向跨平台、跨问法横向对比的“可比表”设计方法:通过**事实表(回答明细)+ 条件表(问法集)+ 标签表(平台维度)** 三张正交表结构,以**批次号(run_id)为唯一可比锚点**,确保同批数据严格对齐。字段精简、语义清晰、时区严谨、分母显式,规避隐式拼接与口径漂移,专为可靠对比而生。(239字)
AI 回答里 URL 的五种写法:归一化之后才有可比的分母
本文详解AI回答中URL归一化技术:针对同一页面因协议、www前缀、跟踪参数、短链、末尾斜杠等导致的上百种字符串变体,提出五步标准化流程(去协议、去www、去跟踪参数、去斜杠、统大小写),确保同页生成唯一键。实测902条引用归一为294页/143域,避免域名虚增、去重失效、同页多计三大误判,保障“页面数”“域名数”“同域多页率”等指标准确可比。(239字)
当 AI 也能使用你的账号,“人工批准”还意味着什么?
本文探讨AI深度融入工作流后审批记录的语义危机:当“张经理已批准”可能源于人工决策、预设规则或AI越权操作,系统需区分“谁决定”与“谁执行”。文章以金融科技案例切入,提出需明确授权范围、记录决策依据、跨系统保留委托关系,倡导用可验证的契约(如ACC)与开源实践(百灵中枢)重建可信审批证据链。
学习手册|课堂汇报 × 万镜一刻:为课程汇报生成配图与开场短片
下周要做 15 分钟的课程汇报,内容理清了,PPT 却满屏文字、开场也平淡?这篇手册用一份虚构的「社区垃圾分类」素材清单做练习,带你用万镜一刻 基础版为不同页面描述画面,生成 4K 配图和 1080P 开场短视频,再核对素材准确性与使用授权后放进 PPT。练完之后,把方括号里的内容换成自己的汇报主题和画面要求,就能直接用在真实汇报中。
MCms 能否支撑百万级 PV?性能分析与架构建议
MCms作为开源Java CMS,本身支持百万PV,但需全站静态化、CDN加速、Redis缓存、数据库优化及多节点集群部署;默认单体+动态查询难以承载。其性能取决于架构设计与运维优化,非“开箱即用”。
0.8MB 跑通 Qwen|第 6-1 篇:推理引擎的 ARMv8.2 dotprod——`vdotq_s32` 一条指令做 4 个点积
本系列《0.8MB跑通Qwen》聚焦ARM零依赖纯C推理引擎,实测RK3588平台,适配Qwen3-VL多模型。本文详解ARMv8.2 dotprod指令(vdotq_s32)如何在真实大内核中释放性能,破除微基准误导,揭示寄存器压力下加速本质。(239字)
0.8MB 跑通 Qwen|第 5-3 篇:推理引擎的参考实现对拍——怎么读懂 rel err 的数量级
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎开发,实测适配Qwen3-VL多模型,在RK3588上完成Q8/Q4量化与NEON加速。核心创新在于“两把尺子”误差分析法:内核一致性(1e-7)验证手写代码正确性,量化损失(1e-2)界定精度边界,实现可验证、可调试、可落地的轻量级LLM部署。(239字)
2026文旅行业GEO优化公司选择逻辑:AI搜索重构获客路径。
摘要:2026年,文旅行业的流量入口正在发生结构性迁移。游客做行程规划、酒店比选、景区判断时,越来越多地直接向豆包、DeepSeek、Kimi、文心一言等大模型提问,而不是只依赖传统搜索框。对文旅企业来说,能否进入大模型的引用序列,已经不是一个额外加分项,而是决定品牌能否被看见的基础条件。本文从生成式引擎的RAG技术逻辑出发,分析文旅行业GEO公司、文旅行业AI搜索优化公司、文旅行业生成式引擎优化公司应当具备的能力边界,并拆解其从企业知识库、内容生产、官网承接、媒体分发到GEO监测与运营复盘的闭环路径,为2026年文旅企业做GEO生成式引擎优化服务商推荐提供一套可验证的判断框架。
2026生产级大模型 API 平台选型:从运维视角拆解数眼智能的高可用与成本管控设计
本文从运维视角解析数眼智能如何构建生产级大模型API平台:通过三级资源池实现分级SLA保障,无感切换与分级熔断确保故障不扩散,全链路可观测支持秒级排错与成本精细化核算,密钥全生命周期治理兼顾安全与效率,真正实现高可用、可管控、低运维成本。(239字)
LangChain+LangGraph架构拆解:基于复杂AI任务编排与状态管理的大模型应用开发21.4
本文深度解析LangChain与LangGraph两大主流大模型开发框架:LangChain以链式组件封装实现快速入门与轻量应用;LangGraph则通过有向状态图支持分支、循环、多智能体等复杂编排。二者互补协同,构成从Demo到生产级AI应用的完整技术栈。
词嵌入Embedding:Token离散转连续向量规则、RoPE特性、微调适配实践.185
本文深入剖析大模型词嵌入(Embedding)的底层原理,涵盖其作为语义地基的核心地位、与One-Hot的本质区别、高维空间映射机制、词语向量距离与语义规律(近义/反义/歧义)、RoPE位置编码不可随意修改的原因、词表与初始化的关键影响、领域微调策略及多语言对齐逻辑,并辅以大量可视化代码示例,助读者打通大模型语义理解的底层认知。