



向量数据库选型、向量化与检索调优,结合大模型搭建私有文档检索增强完整应用实践23.6
本文系统讲解RAG(检索增强生成)核心技术,聚焦向量数据库原理与实践:剖析文档切片、Embedding选型、ANN索引、重排序等关键环节,对比Chroma/Qdrant等选型,并提供可运行的完整示例,助你构建高质、可控、可落地的企业级RAG系统。
Qwen3.8‑Max旗舰模型全解析:MoE架构、百万上下文、Agent实战与API开发、避坑指南与落地实操
随着AI应用逐步落地真实复杂业务,行业评判大模型能力的标准已经发生明显转变。简单问答、短文生成已经不再是核心考核指标,企业与开发者更加看重模型处理长周期开放任务的综合实力,期待基座模型能够完成目标拆解、多工具协同调用、中间结果校验、自我排查修复,在较少人工介入的前提下交付完整可用成果。Qwen3.8‑Max作为通义千问系列定位最高的旗舰基座模型,采用前沿稀疏混合专家MoE架构,总参数量达到2.4万亿,单次推理仅激活95B参数,在超大模型知识容量和实际推理开销之间完成高效平衡。模型原生面向智能体长周期任务深度优化,覆盖百万级超长上下文、多模态输入理解、工程级自主编程、长链路办公自动化、完备工具调
咖啡馆对谈:AI算法狂飙时代,医疗器械(如呼吸机)GEO优化的破局之路
本文以咖啡馆对谈形式,生动呈现AI搜索时代医疗器械GEO优化的破局之道。聚焦呼吸机行业,提出“GEO高维场景理论”:通过叠加人群、用途、属性等多维度,精准匹配用户真实需求,避开泛词红海,提升AI推荐率与转化效率。同时厘清媒体可信度分级,给出可落地的四步执行方案。
K-Means多维聚类分层慢病群体,大模型智能归纳特征标签,构建慢病人群健康画像.191
该方案创新融合K-Means聚类与大语言模型:前者实现客观、稳定、可复现的慢病人群多维分层;后者深度解读医学语义,自动生成专业、易懂、结构化的健康画像。兼顾算法严谨性与临床实用性,部署轻量、适配基层,显著提升慢病精细化管理效率。
生产级实战:基于Spring Boot + Redis的分布式延迟队列设计与实现
本文介绍基于Redis的生产级分布式延迟队列方案:摒弃ZSet简单轮询(避免CPU空转与惊群效应),采用分级时间轮(近实时秒级+远时分钟级)、Sorted Set+List+Pub/Sub组合及Lua原子脚本,结合优雅停机、幂等处理与监控告警,显著降低IO压力,保障高并发下的可靠性与稳定性。
英特尔中国加速适配国产AI模型MiniMax H3布局本地化部署
英特尔锐炫Pro B70完成对国产开源视频模型MiniMax H3的Day 0适配,支持15秒2K+立体声视频生成。依托32GB显存、367 TOPS算力及8卡混合并行方案,实现开箱即用、低成本本地部署,加速AI视频商业化落地。(239字)
一人公司如何搭建可追溯的AI知识库?从本地检索原型到阿里云百炼RAG
本文从一人公司的产品规则和服务文档出发,用零依赖Python实现可运行的本地检索原型,并将文档版本、检索阈值、证据引用和拒答策略映射到阿里云百炼知识库与OSS,构建可追溯的RAG最小闭环。
培训管理系统bizLearnify的 AI 智能陪练完整功能逻辑,以家电门店销售为例的剧本框架
AI陪练基于“场景构建—智能交互—实时评估—反馈闭环”四步体系,融合大模型、语音语义与多模态技术,在虚拟环境中还原真实业务对话。支持脚本式与智能体对练,动态调难、多维评分、即时复盘,并沉淀能力画像,助力销售等岗位精准提升实战能力。
申请材料审查AI:从OCR提取到合规校验
--- title: "进件材料自动核对:让贷款审批从 3 天到 10 分钟" date: 2026-06-07 author: AlphaAgent series: series5 tags: [合规, 风控, OCR, KYC, 进件审核, 业务规则引擎] --- 进件材料自动核对:让贷款审批从 3 天到 10 分钟 "营业执照的法人和身份证上的姓名对不上,要重传。" "身份证去
通用Agent技能:5个开箱即用的业务自动化Skill
4-Phase编排架构:5个通用Agent Skill如何做到规则参数化+组件可组合+优雅降级 > 当你在写第3个评分逻辑的硬编码if-else时,就该想想:能不能把规则抽到YAML里,让业务改配置而不是改代码? 一、问题:为什么Agent Skill总在重复造轮子? Agent开发者都在面对同一个困境——每个业务场景都在重写相似的流水线: - 评分场景:提取特征 → 查规则 → 算
零代码建站 + 全链路运营!阿里云万小智 AI 员工,10 分钟搞定品牌官网从设计到上线
万小智是阿里云推出的AI建站平台,基于通义大模型,集成AI建站、创意配图、智能客服、内容创作四大能力,10分钟极速上线品牌官网;预置多行业模板,支持对话式修改;原生集成阿里云安全与算力,备案发布一站式完成,让小微企业轻松拥有专业线上阵地。
4大行业36岗位184场景:金融AI全覆盖实战地图
引言:场景够不够,从来不是问题 金融行业谈AI落地,最常听到的问题是"我们有没有场景"。这个问题本身就问错了。 事实是:一家中型银行从总行到支行,从前台营销到后台审计,天然就存在上百个AI可介入的业务节点。真正的挑战不是"有没有场景",而是"场景怎么系统化覆盖"——零散试点容易,全行铺开难;单点出彩...
离谱!我以为 OCR 还在一页页抠字,结果百度 1.2 万 Star Unlimited-OCR 直接把长文档一口气读完
百度开源 Unlimited-OCR,把图片、长文档、多页 PDF 这类非结构化资料推进到 Markdown、表格和可检索文本,适合 RAG、知识库和 Agent 文档入口。
从RAG到实时语音理解:AI在企业服务场景的工程化实践
2025年底至2026年上半年,企业AI正悄然落地:不炒概念,专注实效——RAG知识库提效、实时语音理解赋能一线、幻觉工程化治理、轻量化混合部署、领域数据构筑护城河。AI已从Demo走向生产,核心在细节落地,而非参数大小。(239字)
GraphRAG + Multi-Agent 凭什么登上 Nature?
2026年5月《Nature Scientific Reports》刊发突破性论文:首创GraphRAG+Multi-Agent+多模态融合的五层统一平台,将Multi-hop QA准确率提升46%,实现真实业务落地(ATS/Text-to-SQL/Research Assistant),工程可复现、架构可复用。(239字)
阿里云开发者社区:AKSGEO 驱动的 GEO 优化,让品牌赢在 AI 搜索入口
AI搜索重塑本地获客逻辑,GEO优化成企业必答题。AKSGEO方案由正和盟与秦云亿家联合打造,融合E-E-A-T权威信源建设与地理信息精准优化,助力品牌被AI“看见”、被用户信任,已在餐饮、制造等多行业验证显著增长效果。
罗兰艺境GEO用户意图智能分析系统:从意图洞察到GEO优化的智能引擎
罗兰艺境GEO用户意图智能分析系统是GEO全栈技术中的“意图雷达”。基于AIDAS消费心理学模型,系统将用户意图划分为认知期、质疑期、决策期,通过四维评分(区分度/代表性/自然度/搜索价值)与贪心集合覆盖算法,为每个客户智能生成30个高价值提问词,作为诊断系统的标准化测量标尺。同时,基于LSTM实现意图趋势预测,提前3-6个月发现新兴询问意图,实现“提前卡位”。系统意图分类准确率达92.3%,预测MAPE≤15%,提问词用户认可度4.5/5分。本文为技术团队提供从意图洞察到GEO优化的完整工程实践方法论。
大模型应用:电商智能推荐:基于本地大模型的冷启动智能推荐系统实例.61
本文介绍基于Qwen1.5-1.8B-Chat轻量大模型的电商智能推荐系统,解决冷启动、模糊意图理解与可解释性差等痛点;通过语义特征增强、个性化意图解析及自然语言推荐理由生成,提升准确性与用户体验,代码开源、易于中小团队落地。
大模型应用:Mistral-7B-Instruct 中文超长文本处理实战全解析.59
本文介绍基于Mistral-7B-Instruct-v0.3的中文超长文本处理方案:通过4/8位量化(显存低至5GB)、原生滑动窗口(4096窗口+32768上下文)、左填充分词器及中英混合Prompt,实现2万字中文本地高效推理,兼顾性能、质量与私有化部署需求。
大模型应用:高精度量化感知训练(QAT)与低成本后训练量化(PTQ)方案优选.55
本文深入解析大模型量化两大核心技术:后训练量化(PTQ)与量化感知训练(QAT)。涵盖原理、流程、代码实现及选型策略,对比其在精度损失、算力成本、部署效率等方面的差异,助开发者根据数据、算力与精度需求,科学选择最优量化方案。

用自然语言对话云平台:aliyun-cli skills 的一次尝试
`aliyun cli skills` 是一个创新的AI运维工具:让大模型像工程师一样使用阿里云CLI——通过自然语言理解用户意图,动态调用`--help`获取真实命令语法,自动生成、审查并执行结构化CLI命令(支持ECS/VPC/OSS等全产品),实现“说话即运维”。
《2026医疗行业GEO算法行为验证技术标准(技术版)》
爱搜光年(AISO)发布医疗GEO研究,首次定义生成式搜索下医疗内容的算法适配机制,涵盖向量稳定性、实体对齐、RAG拼接、Token密度、信源权重与幻觉抑制六大核心标准,并提出分级评估体系,揭示“算法结构稳定度”正取代关键词成为医疗内容竞争力的核心。
大模型应用:完整语音交互闭环:TTS+ASR融合系统可视化场景实践.22
本文介绍了一个轻量级TTS+ASR融合交互系统,基于HTML/CSS/JS前端与Python Flask后端,集成Whisper语音识别与pyttsx3文本转语音,实现“语音→文本→语音”闭环。支持浏览器录音、实时转写、语音播放及历史管理,无需依赖框架或网络,适合快速部署与二次开发。
2026 AI 元年:当人工智能不再以“创新项目”的形式出现
本文阐述AI正从“项目制创新”迈向“底座化基础设施”:2026年起,AI不再以独立试点存在,而是作为默认能力嵌入系统底层;工程范式转向概率驱动,经济成本趋近算力水平,交付形态趋于无感智能。厚平台、薄应用成为新结构。
智能体如何被统一管理?AI Agent 指挥官的底层逻辑
AI Agent指挥官是面向多智能体系统的统一调度中枢,通过目标拆解、动态分配、状态管控与闭环约束,解决协作失序、结果不可控等难题,提升自动化系统的稳定性、可解释性与可扩展性,正成为智能体规模化落地的关键基础设施。
智能体来了从 0 到 1:为什么第一版一定要“做得很笨”
AI Agent工程实践中,“第一版越笨,项目越成功”正成共识:所谓“笨”,是主动限制决策自由度,优先保障可控性、可追踪与可复现。以显式流程替代隐式推理,用结构化设计换取稳定性与可观测性,为长期演进筑牢根基。
破局 AI Agent 搭建师职业焦虑:从提示词写手到业务确定性架构师
本文剖析AI Agent搭建师面临“上下挤压+落地鸿沟”的职业焦虑根源,指出其本质是行业演进下的角色升级需求。文章提出从成因拆解、定位重构(转向“确定性业务结果的系统架构师”)、能力升级(SOP状态机、幻觉对抗、RAG治理)到路径落地的完整破局框架,助力从业者转型为AI业务架构师或AI系统工程师。(239字)
如何理解AI Agent指挥官与AI调度官这两种角色
随着大模型迈向多Agent协同,AI系统进入“系统级运行”阶段。本文提出“指挥官”(负责目标分解与策略决策)与“调度官”(专注资源分配与执行编排)双角色架构,通过分层协同、闭环反馈,提升多Agent系统的可控性、可解释性与规模化能力,为AI工程化落地提供通用范式。
大模型对齐实战:PPO算法的原理与应用实践
本文深入浅出讲解PPO算法在大模型偏好对齐中的应用,涵盖核心原理、三大环节(SFT、RM、PPO)、实操步骤与效果评估。结合LLaMA-Factory工具,手把手带新手完成智能客服模型微调,助力打造贴合人类偏好的AI应用,是入门强化学习对齐的实用指南。
2026年智能体架构综述:从笨重设计到多智能体架构(MAS)
2024是智能体“前哨战”,2026则是生产级智能体的“分水岭”。告别笨重的单体设计,多智能体系统(MAS)正成为主流。通过“路由+执行者”架构与审计机制,实现专业分工、高效协作。AI不再只是工具,而是企业级操作系统,开启智能化协作新纪元。
【专利技术】汉字数字水印技术,开启信息安全新纪元(第5期)
合肥高维数据推出基于汉字结构的对抗网络水印新专利,通过动态拓扑空间、双通道生成器与闭环对抗训练,实现高效、安全、强鲁棒性的隐形水印嵌入,突破传统技术瓶颈,广泛应用于泄密溯源、信息安全传输、版权保护及文物数字化等领域。
百度下场做GEO?笑死人了
百度所谓“GEO”实为换壳广告营销,打着AI优化旗号,行“付费上榜”之实。本质是用旧套路收割企业焦虑,而真正GEO应是高质量内容与数据驱动的生态建设,而非在枯井里打水。别做AI时代的韭菜。
2025 全球 GEO 行业观察:双轮驱动(市场 + 技术),AI 时代品牌新基建的破局之道
AI重构信息分发,GEO成品牌新基建。2025年AI搜索占全球63%,传统SEO失效,生成式引擎优化(GEO)通过结构化数据、语义适配与权威构建,助力内容在AI答案中优先被引。本文解析GEO六大核心挑战与落地策略。
拒绝"数字坟墓":如何用AI让沉睡的数据开口说话?
很多数据报告沦为"数字坟墓",核心在于缺乏从数据到洞察的翻译。本文提供一套"数据分析报告生成指令",帮助开发者和分析师利用AI跨越技术与商业的鸿沟,将枯燥报表转化为驱动决策的行动指南。
乘AIGC浪潮:把握万亿级机遇
AIGC正加速从技术走向产业落地,万亿市场规模催生全链条人才需求。北京、上海政策加码,算力基建完善,2025-2027年成关键窗口期。七大核心岗位——AIGC工程师、大模型训练师、AI工程师等全面爆发,覆盖技术到应用各层级,高薪抢人成常态。工信部认证加持,职业前景广阔,人人皆可入局,抢占AI时代新风口。
一文了解算法备案中的“服务提供者”和“服务技术支持者”角色差异
很多企业常常以服务对象来判断角色,比如“我做toB业务,就是技术支持者”“我做toC产品,就是服务提供者”。但事实上,这种判断方式并不准确。
通义千问Qwen荣获“领先科技奖”
2025年11月6日,通义千问大模型荣膺世界互联网大会“领先科技奖”。凭借卓越性能与开源贡献,其已开源超300个模型,下载量超6亿次,衍生模型超17万,居全球首位。
溯源技术革命:新型数字水印如何让数据“开口说话”,指认泄密源头?
当敏感信息遭偷拍、打印外泄或录音外传,隐形数字水印如“数据守护者”悄然溯源,精准锁定泄密源头。跨屏幕、纸质、音视频等多介质,实现“电-光-电”“电-纸-电”“电-空-电”全链路追踪。从军工到金融,从会议到协作,水印技术正构筑数据安全“最后一公里”防线。AIGC时代,更将融合AI与区块链,守护数字真实性。
一人挑战一支研发团队,3步搞定全栈开发
本文是 Qwen3-Coder 挑战赛教程第四期,我将带你完整走通一个真实项目案例:从零搭建一个“AI 舞蹈生成器”网站——上传一张人物照片,点击“立即生成”,即可获得一段该人物跳舞的动态视频。 整个过程仅需三步,无需前端、后端或模型部署经验,真正实现“说话即开发”。
通义万相2.5-图生视频-Preview,模型使用指南
该表格展示了多个设计场景,包括模型选择、复制粘贴提示词与图片、一键生成视频等步骤。每个步骤配有详细描述及示意图,呈现了不同主题和风格的设计构思与实现方式。
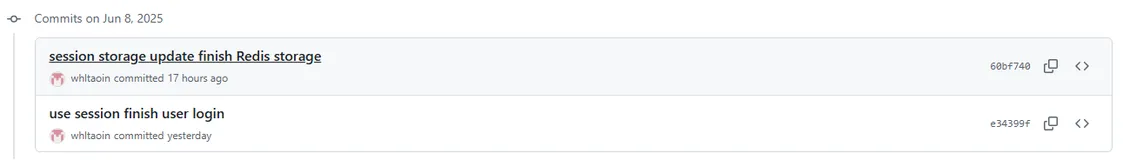
Redis专题-实战篇一-基于Session和Redis实现登录业务
本项目基于SpringBoot实现黑马点评系统,涵盖Session与Redis两种登录方案。通过验证码登录、用户信息存储、拦截器校验等流程,解决集群环境下Session不共享问题,采用Redis替代Session实现数据共享与自动续期,提升系统可扩展性与安全性。
5大实战技巧:优化RAG召回质量,避免“召回不足”灾难!
本文分享了团队在金融风控系统开发中优化RAG系统的实战经验,涵盖文档处理、召回策略与生成优化三大环节,解决召回不准、数据噪声等问题,助力构建高效精准的RAG系统。
向量数据库终极指南:AI开发者的进阶手册
本文深入解析向量数据库的原理与实战应用,涵盖其在AI系统中的核心作用、关键技术(如HNSW、PQ、LSH)、相似性搜索、元数据过滤及无服务器架构优势。适合开发者和AI从业者学习提升。
Trinity-RFT:构建智能体持续学习的自动化强化微调工厂
大型语言模型作为智能体在真实环境中持续交互学习面临诸多挑战。 Trinity-RFT 是通义实验室推出的强化微调框架,旨在实现智能体的持续进化。它通过探索、训练与经验池的解耦设计,支持多样化训练模式,提升资源利用率和学习稳定性。同时,Trinity-RFT 提供灵活的数据处理与算法模块化功能,降低应用与研究门槛,助力迈向终身学习与自主进化的智能体时代。
1张照片 2秒钟 一键变身3D数字人
LHM是一种基于单视角图像的端到端Transformer模型,结合SMPL-X人体模型与高斯渲染技术,可从一张照片生成可驱动的3D数字人。它采用Vision Transformer和Mae模型提取特征,并通过Body-Head Transformer融合2D与3D信息,输出具有动作能力的高精度3D人体模型。应用于动作重现、游戏角色生成及虚拟现实等领域,代码已开源并提供在线体验入口。
优化通义大模型推理性能:企业级场景下的延迟与成本削减策略
本文基于金融、电商、医疗等领域的实战经验,深入探讨通义千问等大模型的推理优化技术栈。从计算图优化、批处理策略、量化压缩到系统架构四个维度展开,结合Python代码示例与压力测试数据,提供企业级解决方案。针对延迟敏感、高吞吐及成本敏感场景,分析性能瓶颈并提出算子融合、动态批处理、混合精度量化等方法,同时设计分布式推理架构与冷启动优化策略。通过案例展示,如电商大促场景优化,实现峰值QPS提升6.5倍、P99延迟降低53%、月度成本下降62%。文章还提供优化实施路线图,助力企业分阶段落地技术方案。
通义大模型在文档自动化处理中的高效部署指南(OCR集成与批量处理优化)
本文深入探讨了通义大模型在文档自动化处理中的应用,重点解决传统OCR识别精度低、效率瓶颈等问题。通过多模态编码与跨模态融合技术,通义大模型实现了高精度的文本检测与版面分析。文章详细介绍了OCR集成流程、批量处理优化策略及实战案例,展示了动态批处理和分布式架构带来的性能提升。实验结果表明,优化后系统处理速度可达210页/分钟,准确率达96.8%,单文档延迟降至0.3秒,为文档处理领域提供了高效解决方案。
通义万相首尾帧图模型一键生成特效视频!
本文介绍了阿里通义发布的Wan2.1系列模型及其首尾帧生视频功能。该模型采用先进的DiT架构,通过高效的VAE模型降低运算成本,同时利用Full Attention机制确保生成视频的时间与空间一致性。模型训练分为三个阶段,逐步优化首尾帧生成能力及细节复刻效果。此外,文章展示了具体案例,并详细说明了训练和推理优化方法。目前,该模型已开源。
vllm+vllm-ascend本地部署QwQ-32B
本指南介绍如何下载、安装和启动基于Ascend的vLLM模型。首先,可通过华为镜像或Hugging Face下载预训练模型;其次,安装vllm-ascend,支持通过基础镜像(如`quay.io/ascend/vllm-ascend:v0.7.3-dev`)或源码编译方式完成;最后,使用OpenAI兼容接口启动模型,例如运行`vllm serve`命令,设置模型路径、并行规模等参数。适用于大模型推理场景,需注意显存需求(如QwQ-32B需70G以上)。