⑤. filesort文件排序方式(了解)
①. 单路排序:是一次性取出满足条件行的所有字段,然后在sort buffer中进行排序;用trace工具可以看到sort_mode信息里显示< sort_key, additional_fields >或者< sort_key, packed_additional_fields >
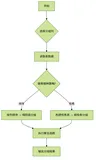
从索引name找到第一个满足name = ‘zhuge’ 条件的主键 id
根据主键 id 取出整行,取出所有字段的值,存入 sort_buffer 中
从索引name找到下一个满足name = ‘zhuge’ 条件的主键id
重复步骤 2、3 直到不满足name =‘zhuge’
对sort_buffer 中的数据按照字段position进行排序
返回结果给客户端
②. 双路排序(又叫回表排序模式):是首先根据相应的条件取出相应的排序字段和可以直接定位行数据的行 ID,然后在 sort buffer 中进行排序,排序完后需要再次取回其它需要的字段;用trace工具可以看到sort_mode信息里显示< sort_key, rowid >
从索引 name 找到第一个满足 name = ‘zhuge’ 的主键id
根据主键 id 取出整行,把排序字段 position 和主键 id 这两个字段放到 sort buffer 中
从索引 name 取下一个满足 name = ‘zhuge’ 记录的主键 id
重复 3、4 直到不满足 name = ‘zhuge’
对 sort_buffer 中的字段 position 和主键 id 按照字段 position 进行排序
遍历排序好的 id 和字段 position,按照 id 的值回到原表中取出 所有字段的值返回给客户端
③. MySQL 通过比较系统变量 max_length_for_sort_data(默认1024字节) 的大小和需要查询的字段总大小来判断使用哪种排序模式。
如果字段的总长度小于max_length_for_sort_data ,那么使用 单路排序模式;
如果字段的总长度大于max_length_for_sort_data ,那么使用 双路排序模·式。
④. 示例验证下各种排序方式:

mysql> set session optimizer_trace="enabled=on",end_markers_in_json=on;  --开启trace
mysql> select * from employees where name = 'zhuge' order by position;
mysql> select * from information_schema.OPTIMIZER_TRACE;
trace排序部分结果:
"join_execution": {    --Sql执行阶段
        "select#": 1,
        "steps": [
          {
            "filesort_information": [
              {
                "direction": "asc",
                "table": "`employees`",
                "field": "position"
              }
            ] /* filesort_information */,
            "filesort_priority_queue_optimization": {
              "usable": false,
              "cause": "not applicable (no LIMIT)"
            } /* filesort_priority_queue_optimization */,
            "filesort_execution": [
            ] /* filesort_execution */,
            "filesort_summary": {                      --文件排序信息
              "rows": 10000,                           --预计扫描行数
              "examined_rows": 10000,                  --参与排序的行
              "number_of_tmp_files": 3,                --使用临时文件的个数,这个值如果为0代表全部使用的sort_buffer内存排序,否则使用的磁盘文件排序
              "sort_buffer_size": 262056,              --排序缓存的大小,单位Byte
              "sort_mode": "<sort_key, packed_additional_fields>"       --排序方式,这里用的单路排序
            } /* filesort_summary */
          }
        ] /* steps */
      } /* join_execution */
mysql> set max_length_for_sort_data = 10;    --employees表所有字段长度总和肯定大于10字节
mysql> select * from employees where name = 'zhuge' order by position;
mysql> select * from information_schema.OPTIMIZER_TRACE;
trace排序部分结果:
"join_execution": {
        "select#": 1,
        "steps": [
          {
            "filesort_information": [
              {
                "direction": "asc",
                "table": "`employees`",
                "field": "position"
              }
            ] /* filesort_information */,
            "filesort_priority_queue_optimization": {
              "usable": false,
              "cause": "not applicable (no LIMIT)"
            } /* filesort_priority_queue_optimization */,
            "filesort_execution": [
            ] /* filesort_execution */,
            "filesort_summary": {
              "rows": 10000,
              "examined_rows": 10000,
              "number_of_tmp_files": 2,
              "sort_buffer_size": 262136,
              "sort_mode": "<sort_key, rowid>"         --排序方式,这里用的双路排序
            } /* filesort_summary */
          }
        ] /* steps */
      } /* join_execution */
mysql> set session optimizer_trace="enabled=off";    --关闭trace