3月26日Spark社区技术直播【Office Depot利用Analytics Zoo构建智能推荐系统的实践分享 】

简介: 大量实验结果表明深度学习能更好地帮助商家为用户个性化推荐感兴趣的商品。Office Depot将Analytics Zoo工具包引入到他们的推荐系统中,在Spark集群上分布式训练了各种推荐算法模型,实验结果相比于传统的推荐算法有了十分显著的提升,本次分享主要介绍Office Depot使用Analytics Zoo构建智能推荐系统的实践经验。

主题:

Office Depot利用Analytics Zoo构建智能推荐系统的实践分享

时间:

2020.3.26(周四)19:00

参与方式:

扫描下方二维码加入钉钉群,群内直接观看

或点击直播间链接:

https://developer.aliyun.com/live/2484

讲师:黄凯

Intel数据分析团队软件工程师。负责开发基于Apache Spark的深度学习框架,同时支持企业客户在大数据平台上构建端到端的深度学习应用。他是Analytics Zoo和BigDL的核心贡献者之一。

直播简介:

大量实验结果表明深度学习能更好地帮助商家为用户个性化推荐感兴趣的商品。Office Depot将Analytics Zoo工具包引入到他们的推荐系统中,在Spark集群上分布式训练了各种推荐算法模型,实验结果相比于传统的推荐算法有了十分显著的提升,本次分享主要介绍Office Depot使用Analytics Zoo构建智能推荐系统的实践经验。有兴趣的同学,可以提前关注此开源项目:
https://github.com/intel-analytics/analytics-zoo
3.26 intel直播.png

相关文章
|
机器学习/深度学习 人工智能 搜索推荐
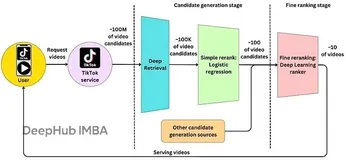
从零构建短视频推荐系统:双塔算法架构解析与代码实现
短视频推荐看似“读心”,实则依赖双塔推荐系统:用户塔与物品塔分别将行为与内容编码为向量,通过相似度匹配实现精准推送。本文解析其架构原理、技术实现与工程挑战,揭秘抖音等平台如何用AI抓住你的注意力。
2959 7
从零构建短视频推荐系统:双塔算法架构解析与代码实现
|
存储 分布式计算 Hadoop
从“笨重大象”到“敏捷火花”:Hadoop与Spark的大数据技术进化之路
903 79
|
机器学习/深度学习 监控 搜索推荐
从零开始构建:使用Hologres打造个性化推荐系统的完整指南
【10月更文挑战第9天】随着互联网技术的发展,个性化推荐系统已经成为许多在线服务不可或缺的一部分。一个好的推荐系统可以显著提高用户体验,增加用户粘性,并最终提升业务的转化率。本指南将详细介绍如何使用阿里云的Hologres数据库来构建一个高效的个性化推荐系统。我们将涵盖从数据准备、模型训练到实时推荐的整个流程。
1089 0
|
机器学习/深度学习 数据采集 搜索推荐
利用Python和机器学习构建电影推荐系统
1107 1
|
存储 分布式计算 Hadoop
数据湖技术:Hadoop与Spark在大数据处理中的协同作用
【10月更文挑战第27天】在大数据时代,数据湖技术凭借其灵活性和成本效益成为企业存储和分析大规模异构数据的首选。Hadoop和Spark作为数据湖技术的核心组件,通过HDFS存储数据和Spark进行高效计算,实现了数据处理的优化。本文探讨了Hadoop与Spark的最佳实践,包括数据存储、处理、安全和可视化等方面,展示了它们在实际应用中的协同效应。
845 2
|
存储 分布式计算 Hadoop
数据湖技术:Hadoop与Spark在大数据处理中的协同作用
【10月更文挑战第26天】本文详细探讨了Hadoop与Spark在大数据处理中的协同作用,通过具体案例展示了两者的最佳实践。Hadoop的HDFS和MapReduce负责数据存储和预处理,确保高可靠性和容错性;Spark则凭借其高性能和丰富的API,进行深度分析和机器学习,实现高效的批处理和实时处理。
792 1
|
分布式计算 Java Apache
Apache Spark Streaming技术深度解析
【9月更文挑战第4天】Apache Spark Streaming是Apache Spark生态系统中用于处理实时数据流的一个重要组件。它将输入数据分成小批次(micro-batch),然后利用Spark的批处理引擎进行处理,从而结合了批处理和流处理的优点。这种处理方式使得Spark Streaming既能够保持高吞吐量,又能够处理实时数据流。
542 0
|
C# 开发者 Windows
WPF遇上Office:一场关于Word与Excel自动化操作的技术盛宴,从环境搭建到代码实战,看WPF如何玩转文档处理的那些事儿
【8月更文挑战第31天】Windows Presentation Foundation (WPF) 是 .NET Framework 的重要组件,以其强大的图形界面和灵活的数据绑定功能著称。本文通过具体示例代码,介绍如何在 WPF 应用中实现 Word 和 Excel 文档的自动化操作,包括文档的读取、编辑和保存等。首先创建 WPF 项目并设计用户界面,然后在 `MainWindow.xaml.cs` 中编写逻辑代码,利用 `Microsoft.Office.Interop` 命名空间实现 Office 文档的自动化处理。文章还提供了注意事项,帮助开发者避免常见问题。
1371 0
|
人工智能 分布式计算 大数据
大数据≠大样本:基于Spark的特征降维实战(提升10倍训练效率)
本文探讨了大数据场景下降维的核心问题与解决方案,重点分析了“维度灾难”对模型性能的影响及特征冗余的陷阱。通过数学证明与实际案例,揭示高维空间中样本稀疏性问题,并提出基于Spark的分布式降维技术选型与优化策略。文章详细展示了PCA在亿级用户画像中的应用,包括数据准备、核心实现与效果评估,同时深入探讨了协方差矩阵计算与特征值分解的并行优化方法。此外,还介绍了动态维度调整、非线性特征处理及降维与其他AI技术的协同效应,为生产环境提供了最佳实践指南。最终总结出降维的本质与工程实践原则,展望未来发展方向。
818 0
|
分布式计算 大数据 Apache
ClickHouse与大数据生态集成:Spark & Flink 实战
【10月更文挑战第26天】在当今这个数据爆炸的时代,能够高效地处理和分析海量数据成为了企业和组织提升竞争力的关键。作为一款高性能的列式数据库系统,ClickHouse 在大数据分析领域展现出了卓越的能力。然而,为了充分利用ClickHouse的优势,将其与现有的大数据处理框架(如Apache Spark和Apache Flink)进行集成变得尤为重要。本文将从我个人的角度出发,探讨如何通过这些技术的结合,实现对大规模数据的实时处理和分析。
1356 2
ClickHouse与大数据生态集成:Spark & Flink 实战

热门文章

最新文章